ถ่ายทอดจากบทความต้นทางใน VideoToBlog วันที่ 12 สิงหาคม 2026 และคลิป Intelligence + Continual Learning = Expertise, Yu Su, NeoCognition ของช่อง AI Engineer แนวคิดและตัวอย่างเป็นสิ่งที่ผู้บรรยายนำเสนอในขณะนั้น ไม่ใช่ผลทดสอบอิสระ ตัวอย่างธุรกิจไทยเป็นการประยุกต์ในบทความต้นฉบับ วันที่นี้เป็นวันที่บทความต้นทาง ไม่ใช่วันอัปโหลดวิดีโอซึ่งยังไม่ได้ตรวจยืนยัน · วิดีโอต้นทาง
ปัญหาของ AI ในองค์กรไม่ใช่แค่ตอบผิด แต่คือมันมักต้องเริ่มทำความเข้าใจงานใหม่แทบทุกครั้ง แม้จะเป็นงานเดิมที่ทีมทำซ้ำทุกวันก็ตาม นั่นทำให้ AI ดูฉลาดมากในเดโม แต่เปราะบางเมื่อเจอกระบวนการจริงที่มีข้อยกเว้น ลำดับอนุมัติ และข้อมูลเฉพาะบริษัท
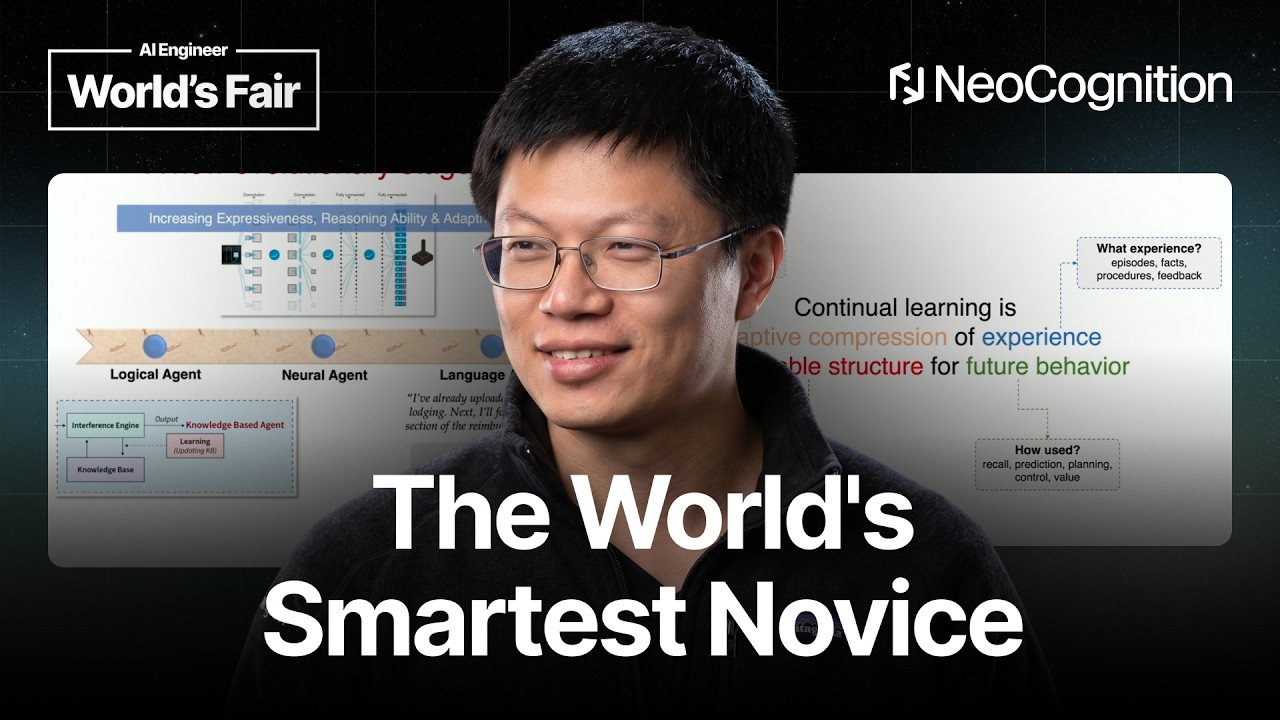
คลิปของ Yu Su จาก NeoCognition บนช่อง AI Engineer เสนอกรอบคิดที่ช่วยอธิบายช่องว่างนี้ได้ชัดเจน คือแยกระหว่าง intelligence กับ expertise และชี้ว่า continual learning คือสะพานที่เปลี่ยน AI จากผู้ช่วยที่คิดเก่ง ให้เป็นผู้ช่วยที่รู้จักงานของเรา บทความนี้จะแปลงแนวคิดดังกล่าวเป็นวิธีออกแบบ AI agent สำหรับธุรกิจไทย
สารบัญ
- Step 1: แยกให้ออกว่า AI ฉลาด ไม่ได้แปลว่า AI เชี่ยวชาญ
- Step 2: เริ่มจากงานที่มีโลกของตัวเองชัดเจน
- Step 3: เปลี่ยนความรู้ของคนเก่งให้เป็นกติกาและสัญญาณ
- Step 4: ออกแบบ continual learning เป็นวงจรเรียนรู้ ไม่ใช่แค่ memory
- Step 5: วัด expertise จากคุณภาพงาน ไม่ใช่จำนวน token หรือจำนวนคำตอบ
- Step 6: ตั้งรั้วความเสี่ยงก่อนให้ AI สะสมประสบการณ์
- Step 7: นำแนวคิดไปใช้ด้วย Actionable Insights
- Step 8: แก้ปัญหาที่พบบ่อยเมื่อสร้าง AI Agent ในธุรกิจ
- Step 9: ต่อยอดจากผู้ช่วยเฉพาะงานสู่ความรู้ขององค์กร
- Step 10: สรุป Checklist ทั้งหมด
Step 1: แยกให้ออกว่า AI ฉลาด ไม่ได้แปลว่า AI เชี่ยวชาญ
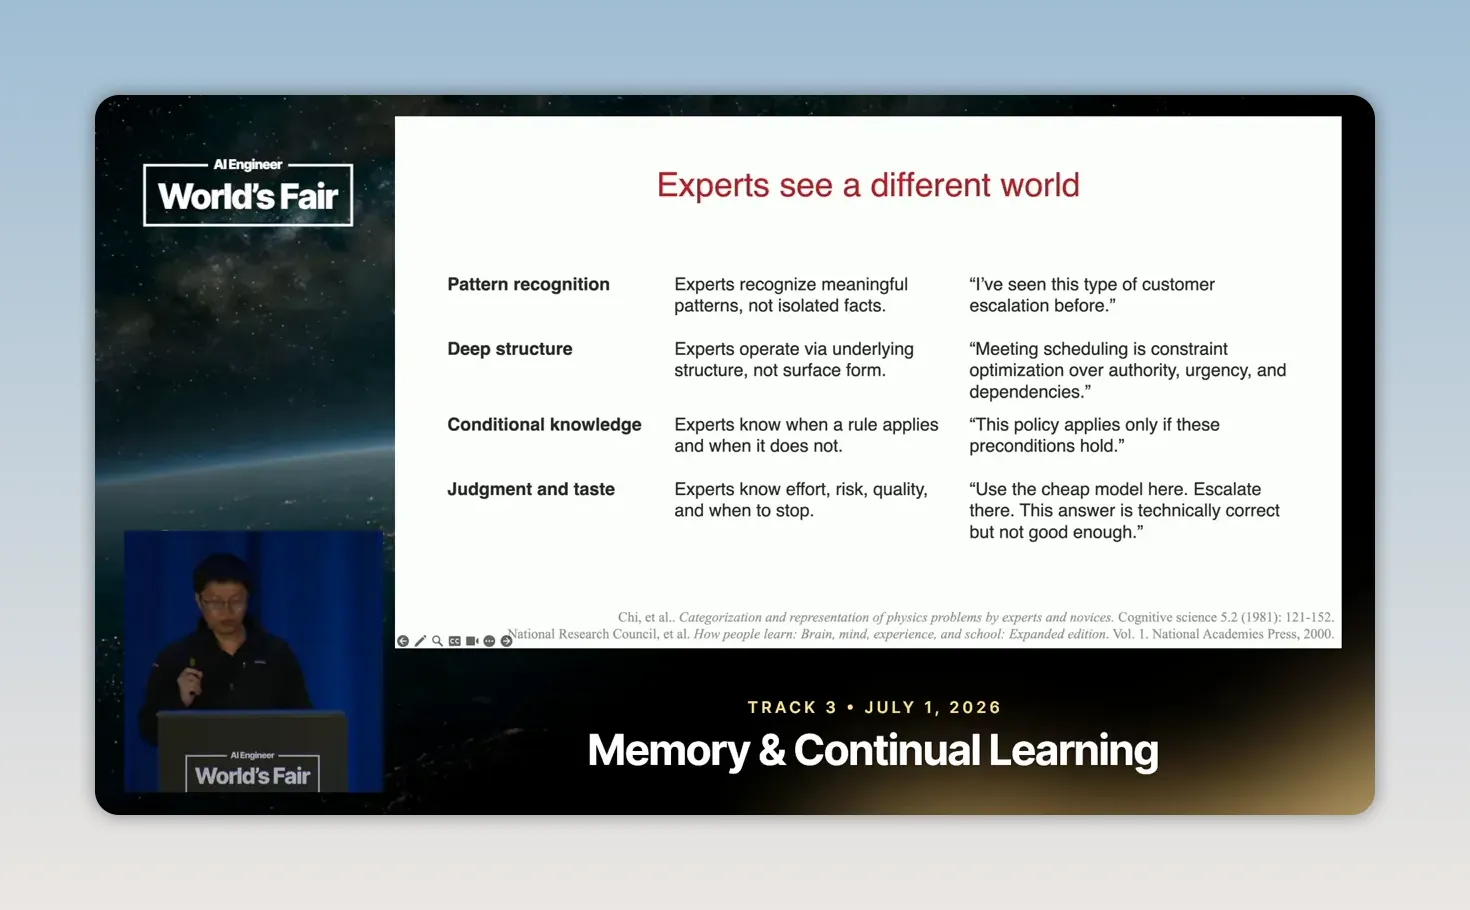
Intelligence คือความสามารถในการใช้ context ที่ได้รับมาเพื่อแก้ปัญหาที่ไม่คุ้นเคย Model ระดับแนวหน้าทำเรื่องนี้ได้ดีขึ้นมาก เราส่งโจทย์ เอกสาร ข้อกำหนด และเครื่องมือให้ แล้ว AI สามารถให้เหตุผล วางแผน หรือเสนอทางออกได้ แม้ไม่เคยเจอโจทย์นั้นมาก่อน
แต่ expertise คือความสามารถที่สะสมจากประสบการณ์ในงานเฉพาะทาง เป็นการทำงานได้อย่างสม่ำเสมอ รู้จังหวะ รู้เงื่อนไข และรู้ว่าเมื่อไรควรหยุด ไม่ใช่แค่หาคำตอบที่เป็นไปได้ แต่เลือกคำตอบที่เหมาะกับองค์กรนั้นจริง
ตัวอย่างง่ายคือการนัดประชุม AI ที่ฉลาดอาจค้นหาช่วงเวลาว่างร่วมกันได้ แต่ผู้ประสานงานที่เชี่ยวชาญรู้ว่างานนี้ไม่ได้มีแค่ปฏิทิน ยังมีอำนาจตัดสินใจ ลำดับความสำคัญ ความเร่งด่วน ลูกค้าที่ต้องให้ความสำคัญ และคนที่ควรเข้าประชุมเฉพาะช่วงแรก
สำหรับธุรกิจไทย ความต่างนี้เกิดขึ้นทุกที่ เช่น AI อาจร่างคำตอบแชตลูกค้าได้ดี แต่ยังไม่รู้ว่าลูกค้ารายนี้เป็นตัวแทนรายใหญ่ มีประวัติรับสินค้าล่าช้า หรืออยู่ในช่วงเจรจาสัญญาใหม่ สิ่งที่ขาดไม่ใช่ภาษา แต่คือความจำและกติกาของธุรกิจ
Step 2: เริ่มจากงานที่มีโลกของตัวเองชัดเจน
เหตุผลที่ coding agent ไปได้ไกลกว่างานสำนักงานทั่วไป ไม่ได้แปลว่างานเขียนโค้ดง่ายกว่า แต่โลกของโค้ดมีโครงสร้างที่เหมาะกับ AI มาก โค้ดเป็นภาษาที่เป็นสัญลักษณ์อยู่แล้ว มีไฟล์ มีเวอร์ชัน มีคำสั่ง และมีชุดทดสอบที่บอกได้ค่อนข้างตรงไปตรงมาว่าคำตอบใช้ได้หรือไม่
งานธุรกิจกลับเป็น “micro worlds” จำนวนมาก แต่ละแผนก แต่ละบริษัท และแม้แต่การตั้งค่า software เดียวกัน ล้วนมีกติกาไม่เหมือนกัน ฝ่ายขายอาจใช้ CRM เดียวกัน แต่เกณฑ์การจัด lead ความหมายของสถานะดีล และส่วนลดที่อนุมัติได้ต่างกันโดยสิ้นเชิง
นี่สอดคล้องกับแนวคิด Moravec's paradox ในรูปแบบใหม่ งานเชิงสัญลักษณ์อย่างคณิตศาสตร์หรือโค้ดอาจทำได้ดี แต่งานดิจิทัลประจำวันที่เต็มไปด้วยข้อยกเว้นกลับยากกว่า
ดังนั้น จุดเริ่มต้นที่ดีไม่ใช่สร้าง agent ที่ “ทำได้ทุกอย่าง” แต่คือเลือกงานแคบที่มีขอบเขตชัด มีข้อมูลย้อนหลัง และมีผลลัพธ์ตรวจสอบได้ เช่น
- คัดแยกอีเมลสอบถามสินค้าและส่งต่อทีมที่เกี่ยวข้อง
- สรุปเหตุผลที่ลูกค้าต่อรองราคา พร้อมดึงข้อมูลดีลเก่า
- เตรียมร่างใบเสนอราคาตามสินค้ามาตรฐานและเงื่อนไขส่วนลด
- ตรวจเอกสารก่อนส่งอนุมัติ โดยชี้ช่องข้อมูลที่ขาด
- ตอบคำถามพนักงานจากคู่มือและนโยบายฉบับที่อนุมัติแล้ว
งานแบบนี้ทำให้เราเห็น “โลก” ที่ AI ต้องเรียนรู้ได้ชัดเจน และสร้างวงจรพัฒนาได้โดยไม่เสี่ยงให้ AI ไปแตะงานสำคัญเกินขอบเขต
Step 3: เปลี่ยนความรู้ของคนเก่งให้เป็นกติกาและสัญญาณ
ผู้เชี่ยวชาญไม่ได้แค่จำข้อเท็จจริงมากกว่า พวกเขามองเห็นรูปแบบที่คนทั่วไปไม่ทันสังเกต เช่น เห็น bug report ยาวหลายหน้าแล้วพุ่งไปดูจุดที่น่าจะผิดก่อน หรือเห็นคำขอของลูกค้าแล้วรู้ทันทีว่าควรถามคำถามอะไรเพิ่ม
ความเชี่ยวชาญนี้ประกอบด้วยอย่างน้อยสี่ชั้น ได้แก่ การเห็น pattern การเข้าใจเงื่อนไข การใช้ดุลยพินิจ และการรู้ว่า “ดีพอแล้ว” เมื่อไร กติกาหนึ่งข้อจึงใช้ไม่ได้กับทุกสถานการณ์ เพราะทุกกติกามีเงื่อนไขก่อนใช้และข้อยกเว้น
การเก็บ knowledge base แบบรวมไฟล์ PDF อย่างเดียวจึงไม่พอ เราควรดึงความรู้ที่ฝังอยู่ในคนออกมาเป็นโครงสร้างที่ AI ใช้ตัดสินใจได้ เช่น
- ข้อเท็จจริง: ราคา สเปกสินค้า เงื่อนไขบริการ นโยบายอนุมัติ
- ขั้นตอน: งานเริ่มจากอะไร ต้องตรวจอะไร และส่งต่อใคร
- เงื่อนไข: หากยอดเกินระดับหนึ่ง ต้องขออนุมัติจากใคร
- ข้อยกเว้น: ลูกค้ากลุ่มไหนใช้เงื่อนไขแตกต่าง หรือกรณีใดห้าม AI ตัดสินใจเอง
- ตัวอย่างงานดี: คำตอบที่ทีมยอมรับ พร้อมเหตุผลที่เลือกแนวทางนั้น
มุมที่สำคัญคือ อย่าถามพนักงานว่า “ช่วยเขียนคู่มือทั้งหมดให้หน่อย” เพราะงานนี้ใหญ่เกินและมักได้เอกสารที่ใช้ไม่ได้จริง ให้เริ่มจากเคสที่ทีมทำทุกวัน แล้วถามทีละจุดว่า “อะไรทำให้เลือกทางนี้” “มีกรณีไหนที่ห้ามทำแบบนี้” และ “สัญญาณไหนบอกว่างานจบแล้ว”
Step 4: ออกแบบ continual learning เป็นวงจรเรียนรู้ ไม่ใช่แค่ memory
Yu Su ให้นิยาม continual learning ว่าเป็นการบีบอัดประสบการณ์แบบปรับตัว เพื่อนำไปสร้างโครงสร้างที่นำกลับมาใช้กับพฤติกรรมในอนาคต แก่นสำคัญคือ AI ไม่ควรแค่เก็บบทสนทนายาวขึ้นเรื่อย ๆ แต่ต้องเปลี่ยนประสบการณ์ให้กลายเป็นความรู้ที่ค้นหาและใช้ซ้ำได้
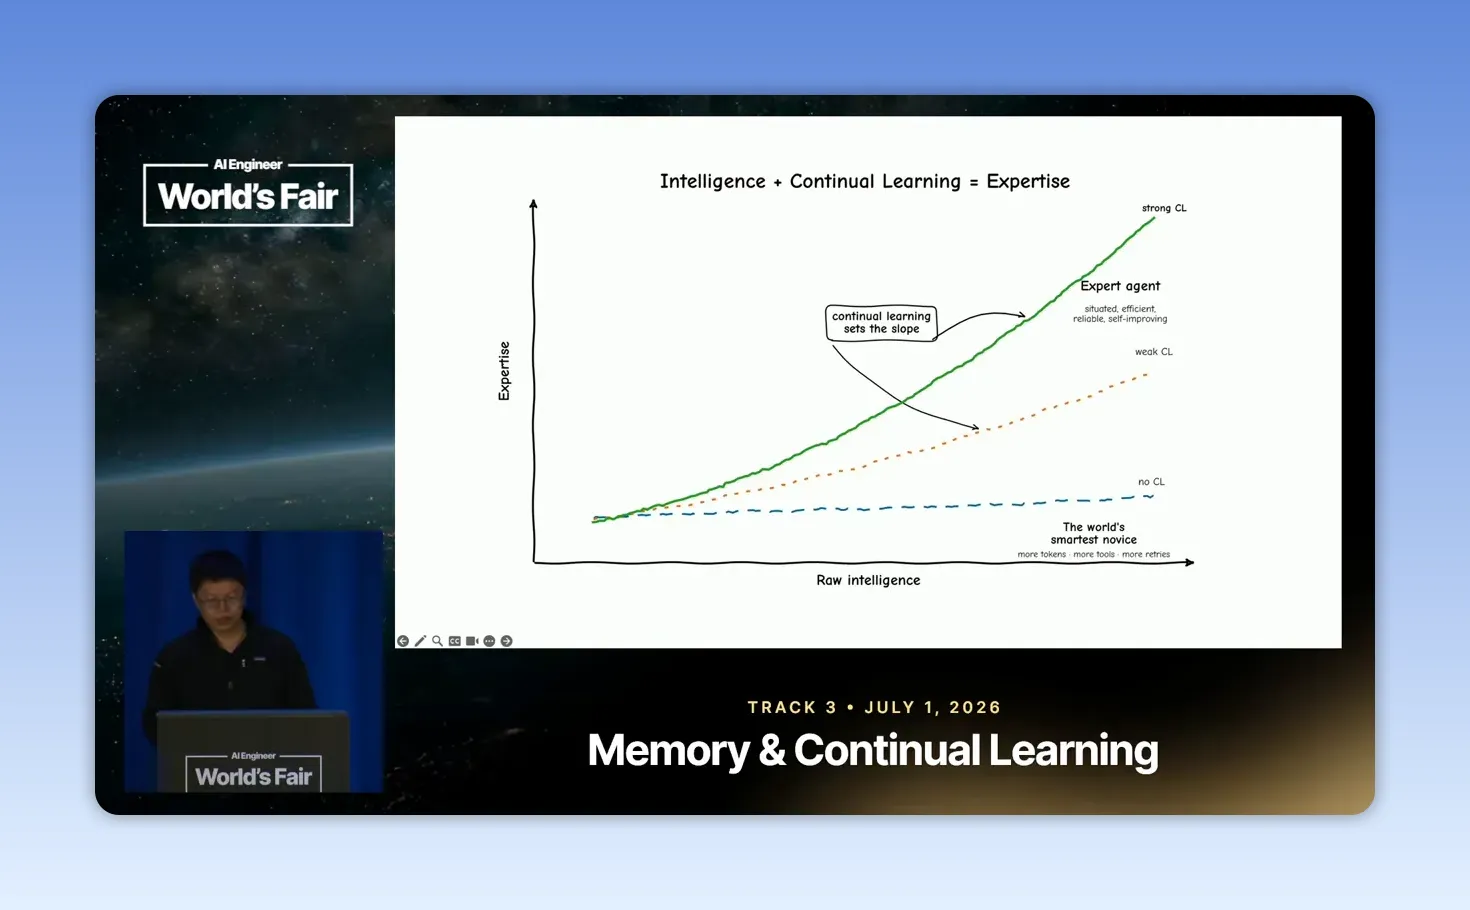
สำหรับเจ้าของธุรกิจ เราไม่จำเป็นต้องเริ่มจากการฝึก model ใหม่ ระบบใช้งานจริงอาจเริ่มด้วยการเก็บ feedback และสรุปเป็น knowledge ที่ผ่านการตรวจสอบ โดยวางวงจรแบบนี้
- รับงาน: AI ทำงานในขอบเขตที่กำหนดและระบุแหล่งข้อมูลที่ใช้
- ตรวจผล: คนในทีมแก้ไข ยืนยัน หรือปฏิเสธผลลัพธ์
- บันทึกเหตุผล: ไม่เก็บแค่คำตอบที่ถูก แต่บันทึกว่าผิดเพราะอะไร
- สกัดกติกา: เปลี่ยนเคสซ้ำเป็น checklist, template หรือเงื่อนไขใหม่
- ทดสอบก่อนใช้: นำเคสเก่ามาวัดว่า AI ดีขึ้นจริงหรือไม่
การเรียนรู้มีได้หลายรูปแบบ บางอย่างเป็นความจำภายนอก เช่น คู่มือ ฐานความรู้ ตัวอย่าง และกรณีศึกษา บางอย่างคือการปรับพฤติกรรมผ่าน prompt, workflow หรือ model ในระยะยาว ประเด็นเชิงธุรกิจคือไม่ต้องรอเทคโนโลยีสมบูรณ์ เราสร้าง learning loop ระหว่างคนกับ AI ได้ตั้งแต่วันนี้
Step 5: วัด expertise จากคุณภาพงาน ไม่ใช่จำนวน token หรือจำนวนคำตอบ
กับดักของการใช้ AI ในองค์กรคือมองแค่ความเร็ว จำนวนงานที่สร้าง หรือจำนวน token ที่ใช้ ทั้งหมดมีประโยชน์ แต่ยังไม่ตอบว่า AI “เก่งงาน” ขึ้นหรือไม่
AI ที่มี intelligence สูงมักขยายพื้นที่ค้นหา มันลองคิดได้หลายทาง สร้างหลายทางเลือก และใช้ context จำนวนมาก ขณะที่ expertise ทำตรงข้าม คือบีบพื้นที่ค้นหาให้แคบลง เพราะรู้แล้วว่าอะไรสำคัญและอะไรไม่ต้องเสียเวลาทำ
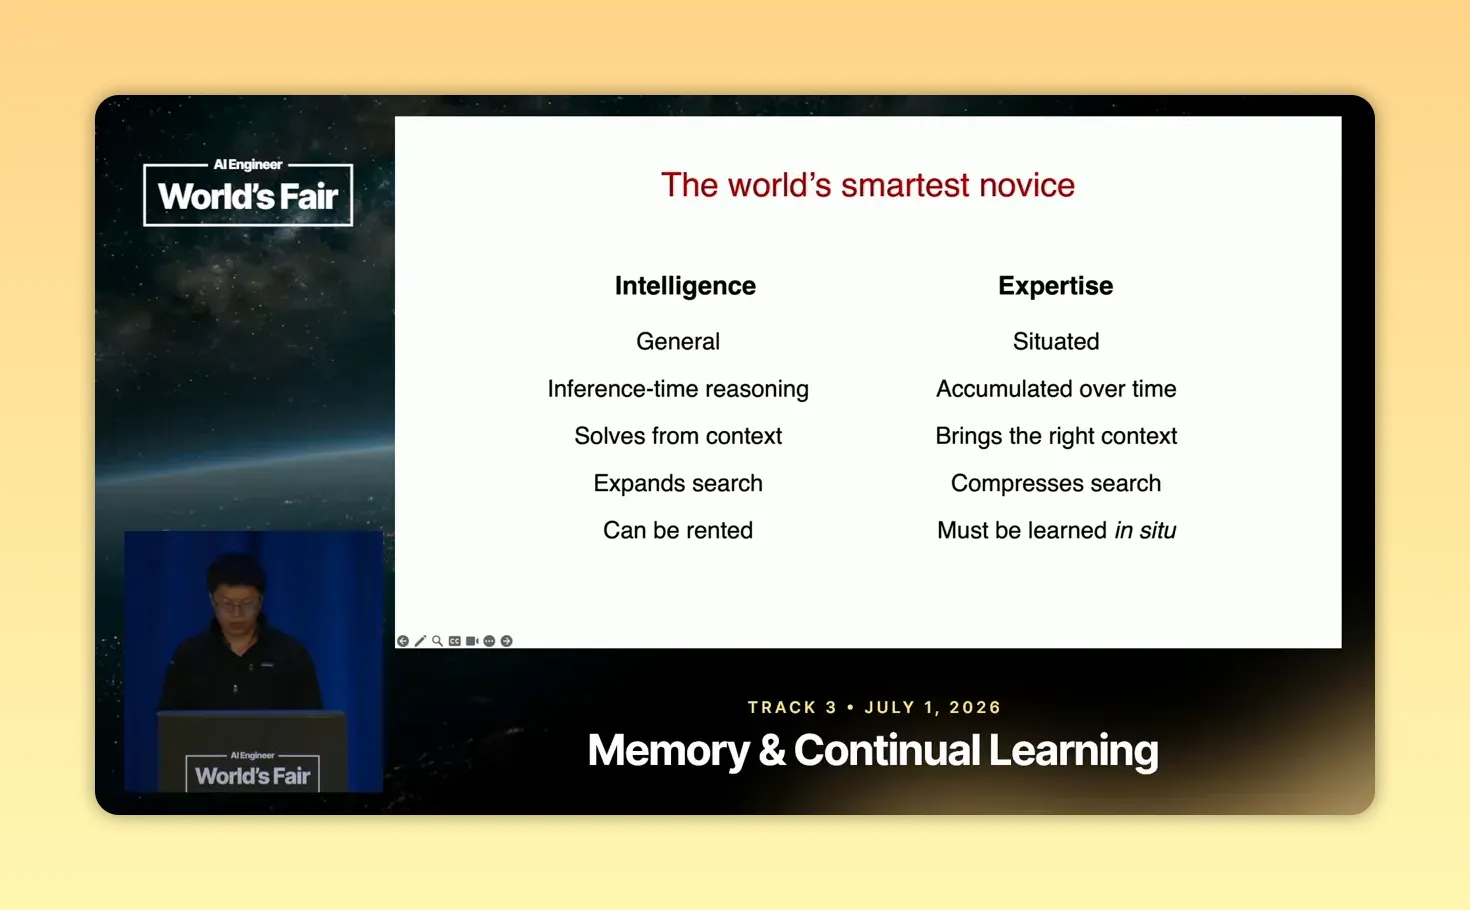
ถ้าเพิ่มขนาด model อย่างเดียวโดยไม่มีการเรียนรู้ต่อเนื่อง ผลที่ได้อาจเป็น “ผู้เริ่มต้นที่ฉลาดที่สุดในโลก” คือคิดเก่งในทุกโจทย์ แต่ไม่สะสมทางลัดเฉพาะงานของเราเลย
ตัวชี้วัดที่ควรใช้จึงต้องผูกกับผลลัพธ์ของงาน เช่น
- อัตราคำตอบที่ทีมยอมรับโดยไม่ต้องแก้
- เวลาตั้งแต่รับเรื่องจนปิดงาน
- จำนวนครั้งที่ส่งต่อผิดทีม หรือเลือกขั้นตอนผิด
- อัตราการเจอข้อยกเว้นที่ AI แจ้งขอความช่วยเหลือได้ถูกจังหวะ
- ความสม่ำเสมอของผลลัพธ์เมื่อเจอเคสลักษณะเดิม
จุดที่ควรเห็นต่างกับความตื่นเต้นเรื่อง agent คือ agent ไม่ควรถูกปล่อยให้เรียนรู้เองแบบไร้ขอบเขต เพราะการเปลี่ยนแปลงอาจทำให้มันจำสิ่งผิด หรือทำงานไม่เหมือนเดิมโดยไม่มีใครรู้ ระบบที่ดีต้องรักษาสมดุลระหว่าง reliability กับความสามารถในการปรับตัว
Step 6: ตั้งรั้วความเสี่ยงก่อนให้ AI สะสมประสบการณ์
การสร้าง expertise ต้องเปิดโอกาสให้ AI รับ feedback แต่ไม่ใช่ทุก feedback มีคุณภาพเท่ากัน และไม่ใช่ทุกงานควรให้ระบบตัดสินใจเอง งานที่เกี่ยวกับเงิน การอนุมัติสัญญา สุขภาพ หรือข้อมูลส่วนบุคคล ควรมีคนรับผิดชอบขั้นสุดท้ายเสมอ
วิธีที่ใช้ได้จริงคือแบ่งงานเป็นสามระดับ
- ระดับแนะนำ: AI สรุป วิเคราะห์ และเสนอทางเลือก คนตัดสินใจทั้งหมด
- ระดับร่าง: AI สร้างเอกสารหรือดำเนินขั้นตอนแรก คนตรวจแล้วกดยืนยัน
- ระดับอัตโนมัติ: AI ทำเองได้เฉพาะงานที่มีขอบเขตชัด ผลกระทบต่ำ และย้อนกลับได้
ควรกำหนด escalation rule ให้ชัด เช่น ถ้าข้อมูลไม่ครบ เจอคำขอนอกนโยบาย ยอดเงินเกินเพดาน หรือความเชื่อมั่นต่ำกว่าเกณฑ์ ให้ AI หยุดและส่งเรื่องให้คน ไม่ใช่เดาคำตอบเพื่อให้งานจบ
Step 7: นำแนวคิดไปใช้ด้วย Actionable Insights
- เลือกหนึ่ง workflow ที่มีปริมาณมาก: เริ่มจากงานซ้ำที่ใช้เวลาคนมาก แต่ผลกระทบของความผิดพลาดยังควบคุมได้
- เก็บเคสผิดเป็นทรัพย์สิน: ทุกครั้งที่ทีมแก้ AI ให้บันทึกประเภทข้อผิดพลาดและแนวทางที่ถูกต้อง
- ให้ผู้เชี่ยวชาญเป็นคนออกแบบเกณฑ์: ทีมปฏิบัติงานควรกำหนดว่าอะไรคือคำตอบดี ไม่ใช่ให้ฝ่ายเทคนิคตัดสินฝ่ายเดียว
- วัดผลด้วยงานจริง: ใช้เคสย้อนหลังชุดเดิมทดสอบทุกครั้งที่เปลี่ยน prompt, knowledge หรือ workflow
- สร้าง institutional memory: เปลี่ยนคำแนะนำของคนเก่งให้เป็น checklist และฐานความรู้ที่คนใหม่กับ AI ใช้ร่วมกันได้
Step 8: แก้ปัญหาที่พบบ่อยเมื่อสร้าง AI Agent ในธุรกิจ
- ปัญหา: AI ตอบได้ดีบางครั้ง แต่คุณภาพแกว่งมาก
สาเหตุ: context ที่ส่งเข้าไปไม่ครบ หรือไม่มีรูปแบบการทำงานที่ตายตัว
วิธีแก้: แยกงานเป็นขั้นตอน กำหนดข้อมูลบังคับ และสร้าง template สำหรับเคสหลักก่อน - ปัญหา: AI จำข้อผิดพลาดเดิมซ้ำ
สาเหตุ: มี feedback แต่ไม่ได้แปลงเป็นกติกาหรือ knowledge ที่เรียกใช้ได้
วิธีแก้: ทำรายการข้อผิดพลาดรายสัปดาห์ จัดหมวด และเพิ่มตัวอย่างแก้ไขเข้า workflow - ปัญหา: ทีมไม่เชื่อผลลัพธ์ของ AI
สาเหตุ: AI ให้คำตอบโดยไม่อธิบายที่มา และเคยพลาดในเรื่องสำคัญ
วิธีแก้: บังคับให้แสดงแหล่งข้อมูล เหตุผล และระดับความมั่นใจ พร้อมมีจุดส่งต่อให้คน - ปัญหา: ใช้ token มาก แต่ยังไม่ลดเวลางาน
สาเหตุ: AI ต้องค้นและคิดใหม่ทุกครั้งเหมือนผู้เริ่มต้น
วิธีแก้: สกัดทางลัดจากเคสเดิม เช่น กฎการคัดกรอง แบบฟอร์ม และคลังคำตอบที่ผ่านการอนุมัติ - ปัญหา: AI ทำตามกฎจนไม่รับมือข้อยกเว้น
สาเหตุ: ระบบมีแต่คำสั่งว่าให้ทำอะไร แต่ไม่มีเงื่อนไขว่าเมื่อไรต้องหยุด
วิธีแก้: เพิ่มรายการข้อยกเว้นและ escalation rule ให้ชัดในทุก workflow
Step 9: ต่อยอดจากผู้ช่วยเฉพาะงานสู่ความรู้ขององค์กร
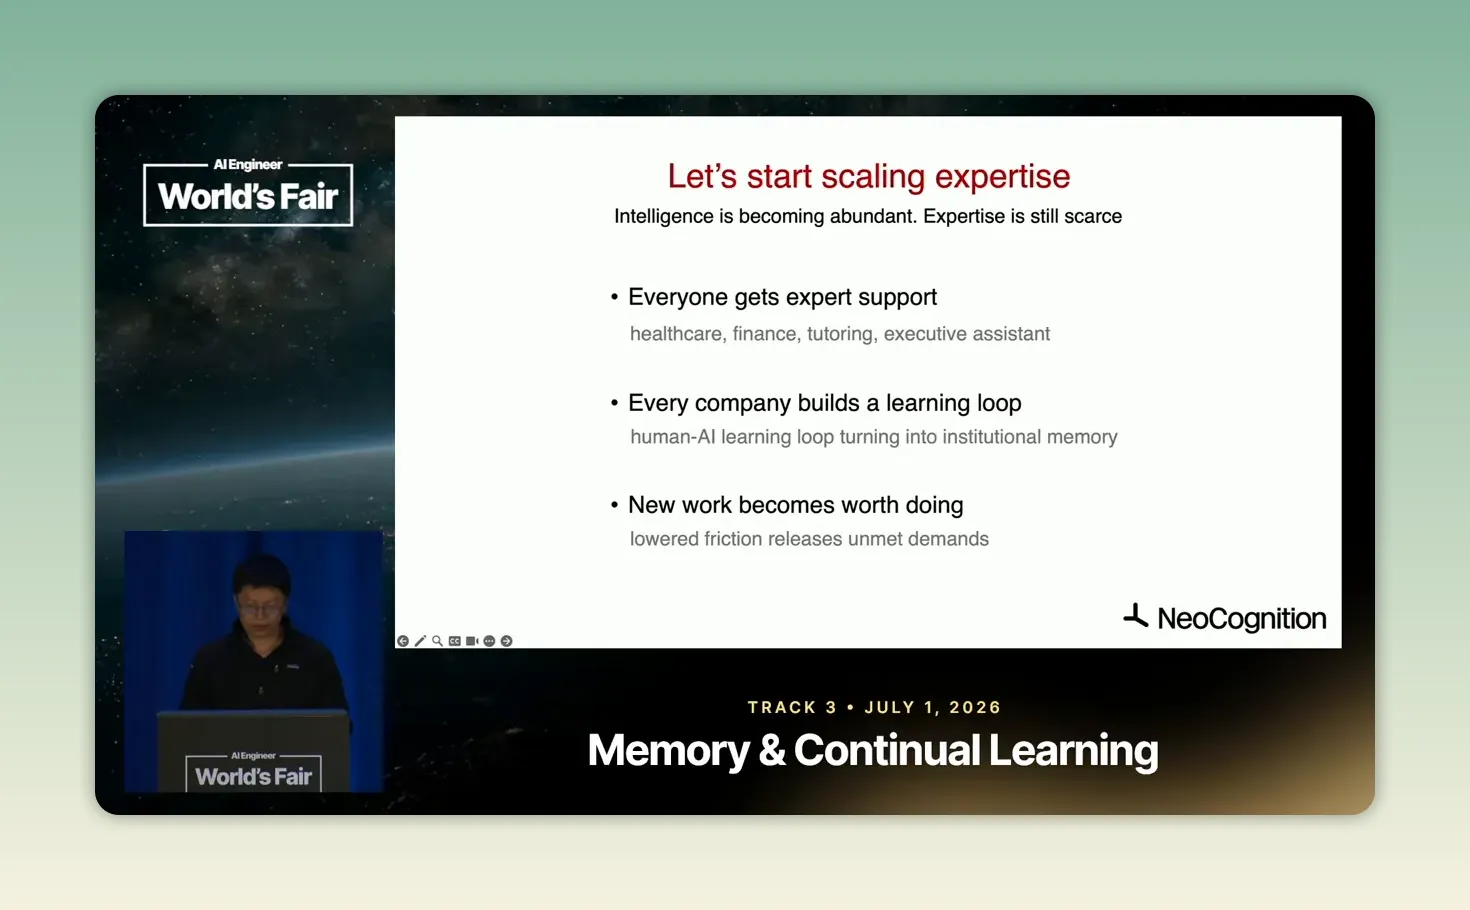
แนวคิดแรกคือสร้าง agent เฉพาะแผนกก่อน เช่น ฝ่ายขาย บริการลูกค้า หรือจัดซื้อ แต่ให้ใช้มาตรฐานการเก็บ feedback ชุดเดียวกัน เมื่อแต่ละทีมเริ่มมี knowledge ที่เป็นระบบ องค์กรจะเห็นจุดเชื่อมระหว่างงานมากขึ้น
แนวคิดที่สองคือเปลี่ยน onboarding ให้เป็นพื้นที่เรียนรู้ร่วมกัน พนักงานใหม่มักถามคำถามเดิมที่ผู้เชี่ยวชาญตอบซ้ำ หากคำตอบผ่านการยืนยันแล้ว AI สามารถช่วยตอบคำถามพื้นฐาน และเก็บช่องว่างของคู่มือที่ยังไม่ชัดได้
แนวคิดสุดท้ายคือใช้ข้อมูลเฉพาะองค์กรเป็นความได้เปรียบ การแข่งขันในระยะต่อไปอาจไม่อยู่ที่ใครเข้าถึง model ใหญ่กว่า แต่อยู่ที่ใครสร้างวงจรเรียนรู้จากงานจริงได้ดีกว่า โดยยังรักษาสิทธิ์ควบคุมข้อมูลและวิธีทำงานของตัวเองไว้
Step 10: สรุป Checklist ทั้งหมด
- ☐ แยกเป้าหมายของ AI ว่าต้องการ intelligence หรือ expertise
- ☐ เลือก workflow แคบที่ทำซ้ำและตรวจผลได้
- ☐ รวบรวมข้อมูล ขั้นตอน เงื่อนไข และข้อยกเว้นจากคนทำงานจริง
- ☐ กำหนดว่าเคสใด AI แนะนำ เคสใดต้องให้คนอนุมัติ
- ☐ เก็บ feedback พร้อมเหตุผล ไม่เก็บแค่ผลว่าถูกหรือผิด
- ☐ แปลงเคสที่เกิดซ้ำเป็นกติกา template หรือ knowledge ที่ใช้ซ้ำได้
- ☐ ทดสอบกับเคสย้อนหลังและวัดผลจากคุณภาพงานจริง
- ☐ ตั้ง escalation rule สำหรับข้อมูลไม่ครบ งานเสี่ยง และข้อยกเว้น
- ☐ ทบทวน knowledge และ workflow เป็นรอบ ไม่ปล่อยให้ AI เรียนรู้แบบไร้การควบคุม
- ☐ ขยายจาก agent เฉพาะงานไปสู่ institutional memory ขององค์กร
หัวใจของ continual learning ไม่ใช่การทำให้ AI จำได้มากที่สุด แต่คือทำให้มันเรียนรู้สิ่งที่ควรจำ นำกลับมาใช้ในเวลาที่ถูกต้อง และรู้เมื่อไรควรส่งต่อให้คน หากเราสร้างวงจรนี้ได้ AI จะไม่ใช่แค่เครื่องมือที่ตอบเก่ง แต่จะค่อย ๆ กลายเป็นผู้ช่วยที่เข้าใจวิธีทำงานของธุรกิจเราเอง