วันที่บทความต้นทางใน VideoToBlog: 2026-03-11 ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว บทความกล่าวถึง Gemini Embedding 2 ช่วง preview รายละเอียดรุ่น ขีดจำกัด ความเร็วและผล benchmark เป็นข้อมูลที่ต้นทางนำเสนอ ไม่ใช่ผลทดสอบซ้ำหรือการรับประกันคุณภาพกับทุกชุดข้อมูล ควรทดสอบกับข้อมูลที่มีสิทธิ์ใช้และตรวจการส่งข้อมูลถึงผู้ให้บริการก่อนใช้งานจริง · แหล่งอ้างอิงในบทความต้นทาง
คำเตือนก่อนใช้โค้ด: โค้ดในหัวข้อ “ตัวอย่างโค้ดพื้นฐาน” เป็น pseudocode เพื่ออธิบายแนวคิดเท่านั้น ไม่ใช่โค้ดที่รันได้ และไม่ใช่คำแนะนำให้ติดตั้งแพ็กเกจ google-ai-library ชื่อคลาส เมธอด โครงสร้างคำขอ และค่าที่ส่งกลับไม่ได้ตรงกับ SDK ทางการ ให้ใช้ เอกสาร embeddings ของ Google ซึ่งตัวอย่าง JavaScript ใช้ GoogleGenAI จาก @google/genai และ models.embedContent พร้อมตรวจรุ่นโมเดลและรูปแบบข้อมูลในเอกสารก่อนเขียนโค้ดจริง
หมายเหตุเรื่องรุ่นและมิติ: ข้อมูลโมเดลทางการที่ตรวจเมื่อ 13 ตุลาคม 2026 ระบุรุ่น stable gemini-embedding-2 ซึ่งอัปเดตเดือนเมษายน 2026 และรองรับมิติ 128–3072 โดยแนะนำ 768, 1536 หรือ 3072 ตัวเลข 1500 ในต้นทางจึงอยู่ในช่วงที่รองรับ แต่ไม่ใช่หนึ่งในสามค่าที่เอกสารแนะนำ คุณภาพเมื่อย่อมิติต้องวัดกับข้อมูลจริง การค้นหาข้ามสื่อยังต้องมีขั้นตอนจัดเก็บดัชนี ค้นคืนและกำกับสิทธิ์ ไม่ได้สร้างระบบค้นหาหรือความจำครบชุดโดยอัตโนมัติ
บทนำ
เพิ่งดูคลิปอัพเดตล่าสุดเกี่ยวกับ Gemini Embedding 2 แล้วรู้สึกว่าเป็นจุดเปลี่ยนจริงๆ เรารู้สึกว่าข้อมูลที่ปล่อยออกมามีทั้งความชัดและโอกาสเชิงปฏิบัติที่จับต้องได้มากกว่าแค่สโลแกนทางการตลาด เรื่องหลักคือโมเดลนี้ทำให้การค้นหาและการเชื่อมข้อมูลข้ามรูปแบบสื่อ—ข้อความ ภาพ วิดีโอ เสียง และเอกสาร—เป็นเรื่องเดียวกันได้ และนั่นเปิดทางให้ระบบ AI ทำงานได้ฉลาดและครอบคลุมขึ้นอย่างชัดเจน
embeddings คืออะไร ทำไมถึงสำคัญ
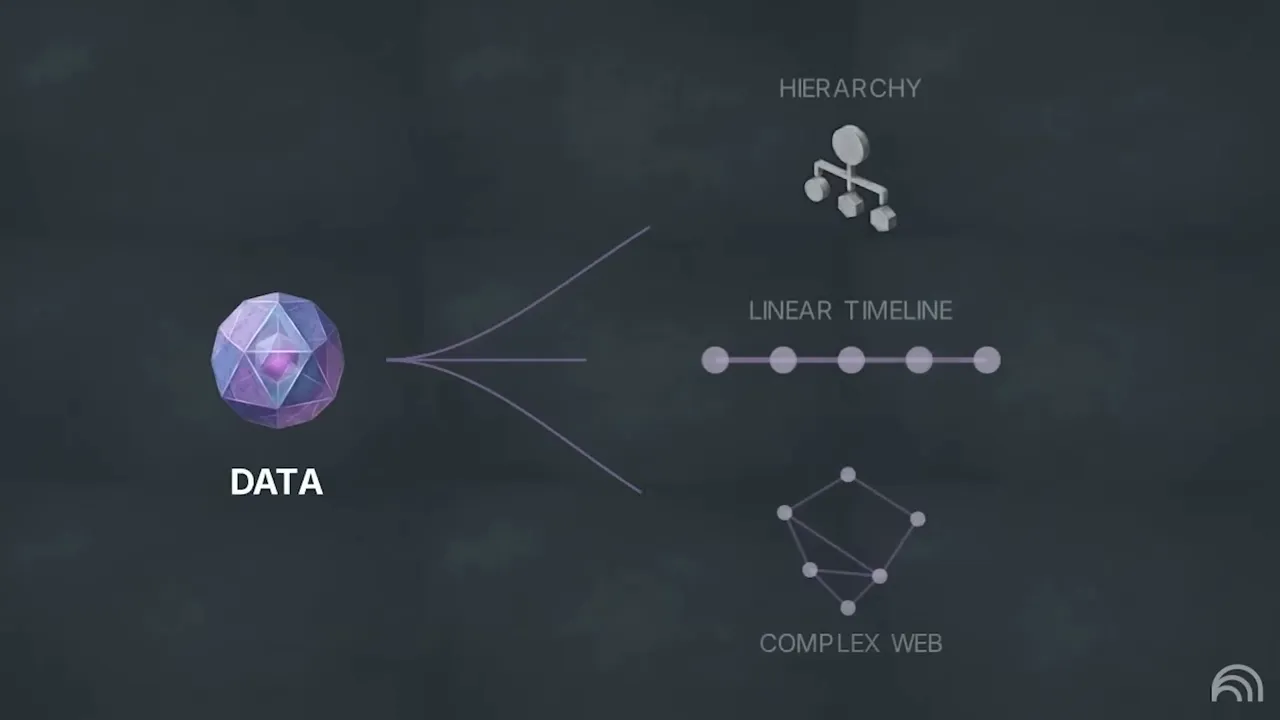
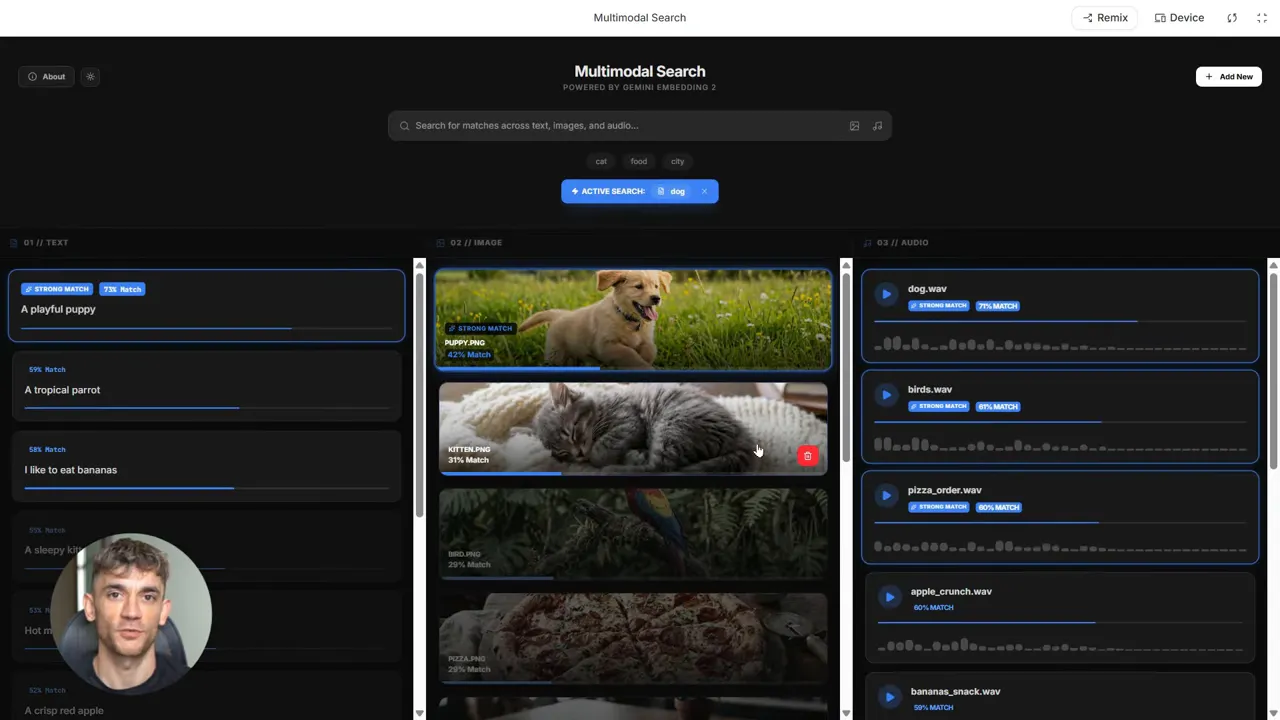
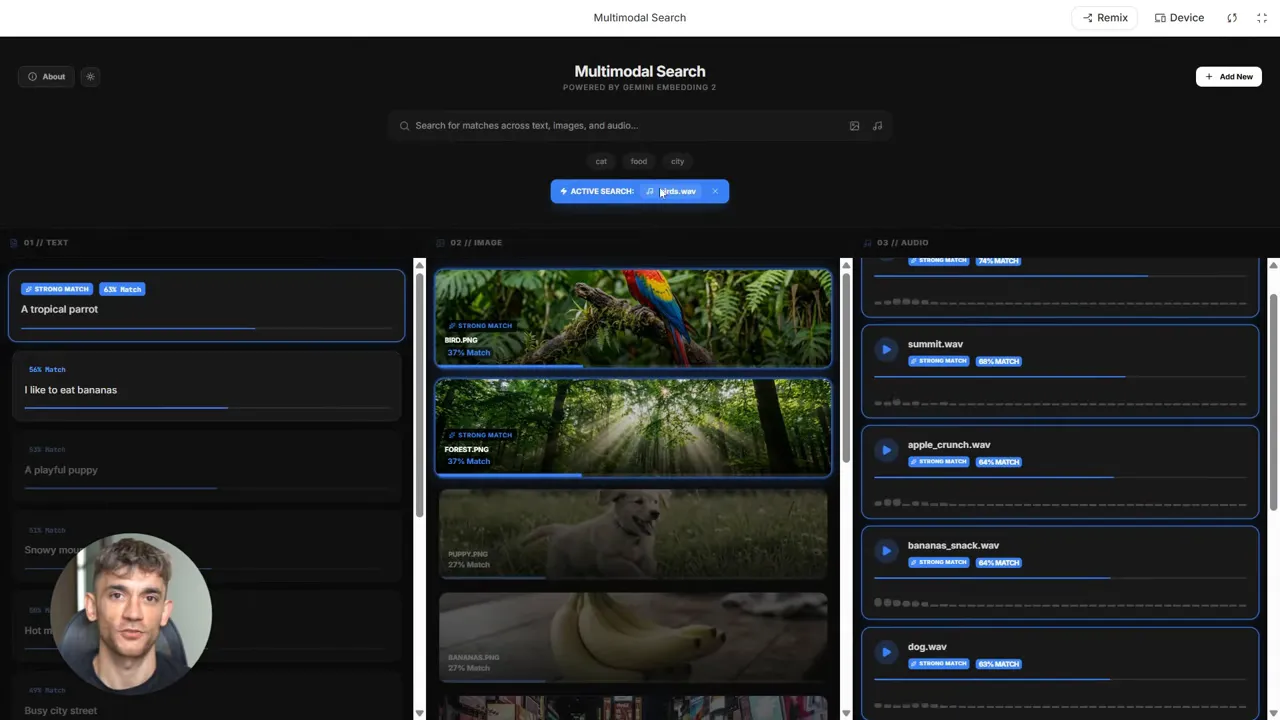
คำว่า embedding ในบริบทของ AI หมายถึงการแทนความหมายของข้อมูลเป็นเวกเตอร์ตัวเลข ความคิดง่ายๆ คือการแปลงสิ่งที่เข้าใจได้ด้วยมนุษย์ให้กลายเป็นภาษาที่คอมพิวเตอร์จับต้องได้ เมื่อข้อมูลถูกแปลงเป็นเวกเตอร์แล้ว ระบบสามารถคำนวณความใกล้เคียงของความหมาย เช่น ค้นหาสิ่งที่มีความหมายใกล้เคียงกับคำว่า "สุนัข" ได้แม้ว่าจะไม่มีคีย์เวิร์ดตรงตัวในไฟล์นั้น
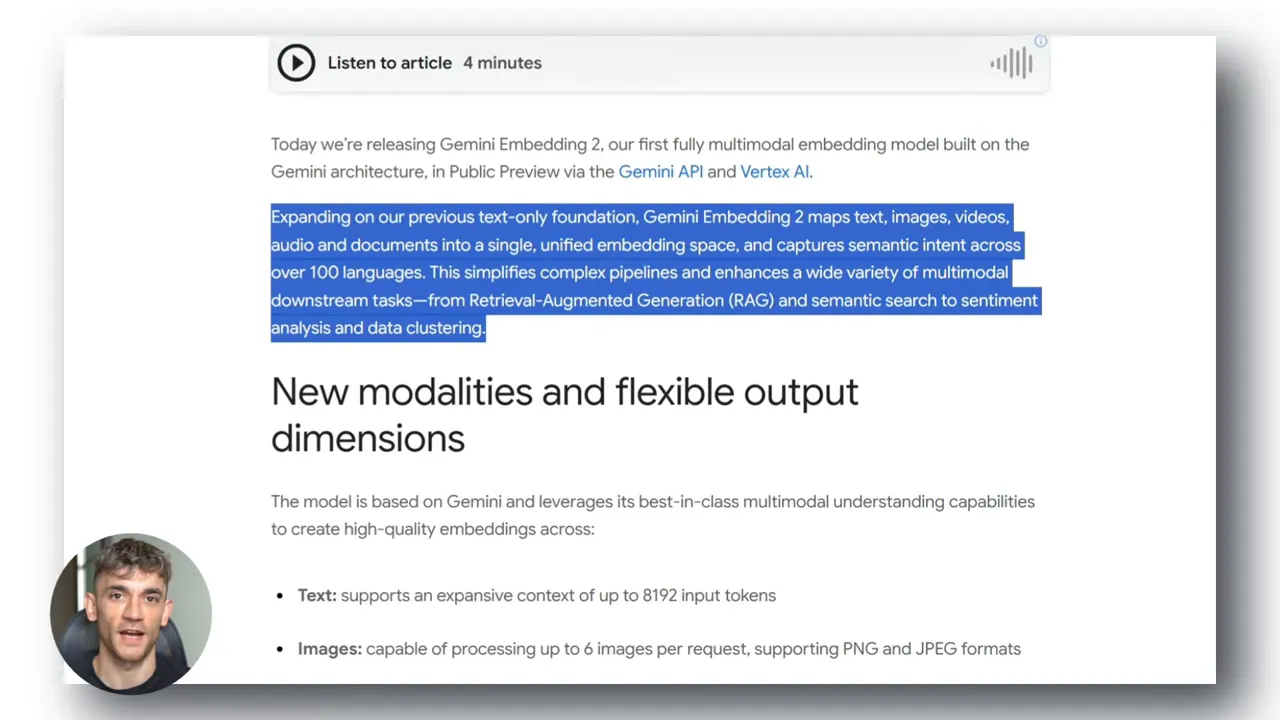
เดิม embeddings ส่วนใหญ่รองรับเฉพาะข้อความ ทำให้ต้องแยกระบบสำหรับรูปภาพ วิดีโอ หรือเสียง แต่ Gemini Embedding 2 ขยายขอบเขตนี้เป็นหลายรูปแบบพร้อมกัน จึงสามารถวางเนื้อหาทุกชนิดลงใน "แผนที่ความหมาย" เดียวได้
จุดเด่นสำคัญของ Gemini Embedding 2
สรุปฟีเจอร์หลักที่ควรรู้ก่อนลงมือทดลอง
Native multimodal embeddings
โมเดลรับข้อความได้ถึงประมาณ 8,000 tokens รองรับรูปภาพสูงสุด 6 ภาพต่อคำขอ วิดีโอได้ถึง 2 นาที เสียงแบบ native และ PDF ประมาณ 6 หน้า แล้วรวมทุกอย่างเป็น embedding เดียว นั่นหมายถึงค้นหาเดียว เจอข้อมูลข้ามสื่อทั้งหมด
Interleaved input
ส่งข้อมูลผสมกันได้ เช่น ข้อความประกอบภาพ หรือภาพกับวิดีโอในคำขอเดียว โมเดลเข้าใจความสัมพันธ์ระหว่างองค์ประกอบเหล่านั้น ซึ่งสะดวกมากเมื่อต้องวิเคราะห์คอนเทนต์ที่มีหลายชั้น
Flexible dimensions และ Matryoshka representation
ค่าเริ่มต้นของ embedding เป็นเวกเตอร์ 3,072 มิติ แต่เลือกย่อได้เป็น 1,500 หรือ 768 มิติ แนวคิด Matryoshka คล้ายตุ๊กตารัสเซียคือสามารถแยกชั้นย่อยออกมาโดยยังคงรักษาความหมายสำคัญไว้ ทำให้ประหยัดพื้นที่จัดเก็บและค้นหาเร็วขึ้น
หลายภาษาและผลทดสอบชั้นนำ
รองรับมากกว่า 100 ภาษาและในเบนช์มาร์กเบื้องต้นได้คะแนนนำในงาน text, image และ video retrieval ซึ่งยืนยันว่าไม่ใช่แค่ฟีเจอร์ที่สวย แต่มาตรฐานผลลัพธ์ใช้ได้จริง
ภาพรวมการใช้งานเชิงธุรกิจ
โมเดลนี้ไม่ได้เป็นของเล่นทดลองเท่านั้น แต่มีแอปพลิเคชันที่ชัดเจนสำหรับธุรกิจหลายประเภท มาดูกรณีใช้งานที่มีประโยชน์จริง
Multimodal search
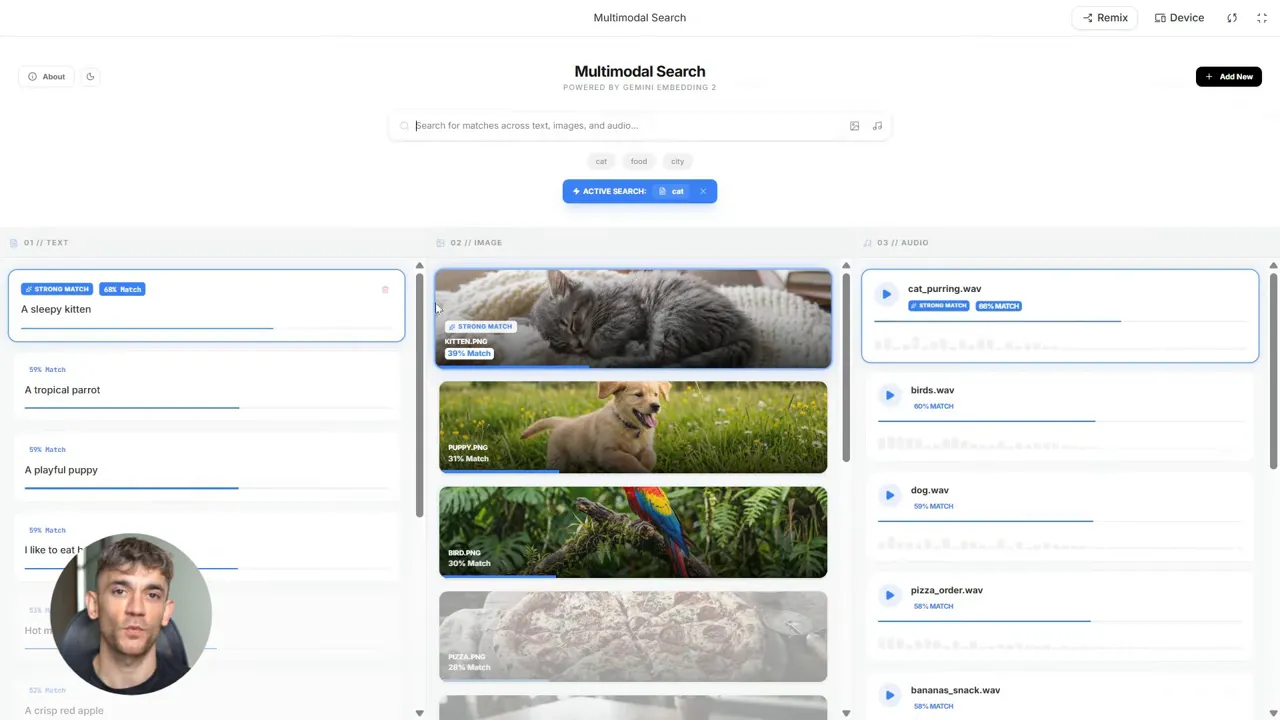
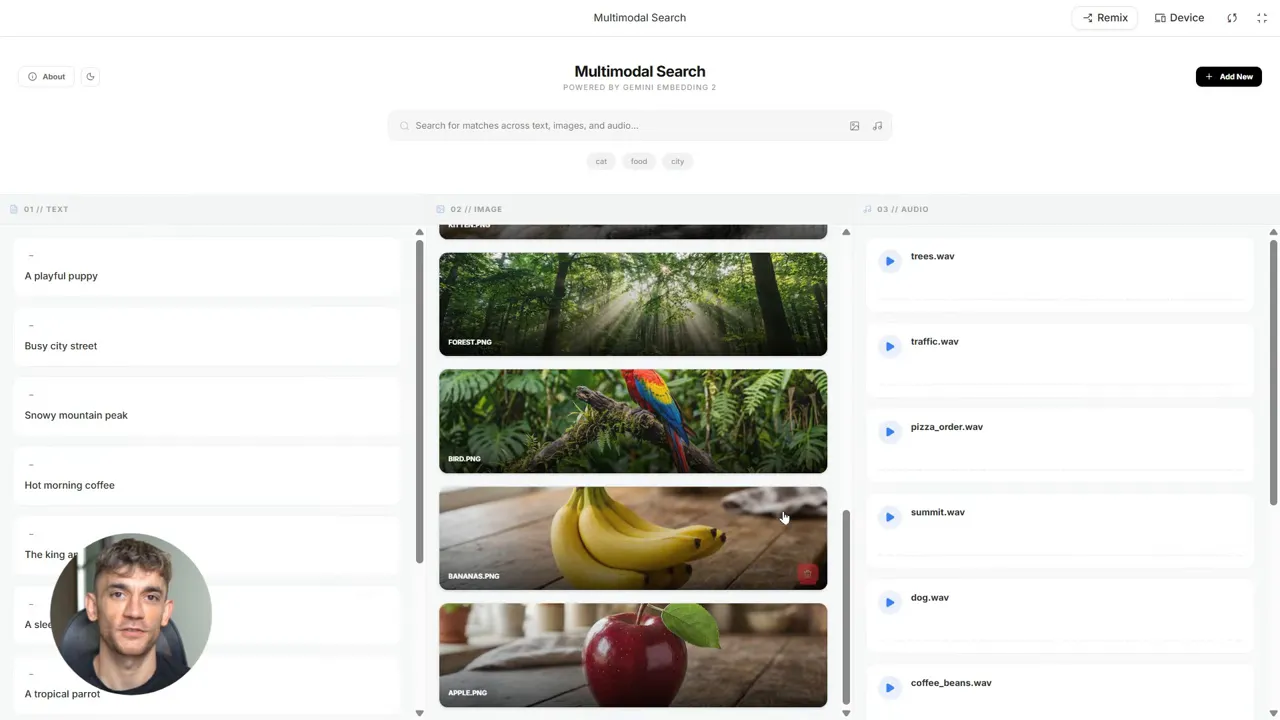
แพลตฟอร์มที่มีคลังวิดีโอ ข้อความ หรือไฟล์เสียงจำนวนมาก สามารถให้ผู้ใช้ค้นหาด้วยข้อความและได้คลิปวิดีโอหรือรูปภาพที่เกี่ยวข้องทันที เรารู้สึกว่านี่จะเปลี่ยนการจัดการคอนเทนต์วิดีโอขององค์กรได้อย่างมาก เหมาะทั้งสำนักข่าว บริษัทผลิตคอนเทนต์ และสถาบันการศึกษา
RAG systems (Retrieval Augmented Generation)
RAG เป็นวิธีทำให้โมเดลใหญ่ตอบคำถามบนฐานข้อมูลเฉพาะขององค์กร โดยปกติฝากข้อมูลเป็น embedding แล้วค้นหาเมื่อนำไปสู่การสร้างคำตอบ Gemini Embedding 2 ทำให้ RAG ไม่จำกัดแค่ข้อความอีกต่อไป เพราะสามารถเก็บวิดีโอ ภาพ หรือเสียงเป็น embedding แล้วเรียกมาอ้างอิงได้
Knowledge base รวมทุกสื่อ
บริษัทที่มีเอกสาร การอบรมแบบวิดีโอ และบันทึกเสียงกระจัดกระจาย สามารถรวบรวมเป็นฐานความรู้เดียวที่ค้นหาข้ามสื่อได้ทันที ช่วยลดเวลาในการค้นข้อมูลและฝึกพนักงานได้เร็วขึ้น
ระบบแนะนำคอนเทนต์
แพลตฟอร์มที่มีคอนเทนต์หลากรูปแบบจะได้คำแนะนำที่เชื่อมโยงได้ลึกขึ้น เช่น ผู้ชมดูวิดีโอหนึ่งระบบแนะนำบทความหรือพอดแคสต์ที่เกี่ยวข้อง เพราะโมเดลเข้าใจความหมายข้ามสื่อ
ตัวอย่างโค้ดพื้นฐาน
การเริ่มต้นใช้งานกับ API ค่อนข้างตรงไปตรงมา ตัวอย่างสั้นๆ ที่ใช้แนวคิดที่อธิบายไว้ในคลิป เรียก embed content และรับเวกเตอร์กลับมา
import GoogleAI from 'google-ai-library';
const client = new GoogleAI({ apiKey: 'YOUR_API_KEY' });

const response = await client.embedContent({
  model: 'gemini-embedding-2-preview',
  content: {
    text: 'whale jumping in ocean',
    images: ['image1.jpg']
  }
});

console.log(response.embedding);
โค้ดตัวอย่างข้างต้นเป็นแนวทาง ส่วนจริงๆ แล้วไลบรารีหรือ SDK ต่างกันไปตามภาษาที่เลือก แต่แนวคิดหลักคือส่งข้อมูลผสมกลับเป็น embedding แล้วนำไปจัดเก็บในฐานข้อมูลเวกเตอร์ เช่น ChromaDB, Qdrant, หรือ Pinecone
คำแนะนำเชิงปฏิบัติ
เมื่อจะนำไปใช้งานจริง ควรคิดเรื่องโครงสร้างข้อมูลและต้นทุนก่อน
- ออกแบบ pipeline ว่าอะไรเป็นแหล่งข้อมูลหลัก วิดีโอหรือเอกสาร ควรมีขั้นตอน preprocessing เช่น ตัดวิดีโอเป็นคลิปสั้นและสกัดแทร็กเสียงก่อนฝัง
- เลือกมิติของ embedding ตามงบประมาณที่ต้องการจัดเก็บและความเร็วในการค้น ถ้าต้องการความแม่นยำสูงสุดใช้ 3072 แต่ถ้าต้องการความหน่วงต่ำและเก็บข้อมูลมากขึ้นให้ใช้ 1500 หรือ 768
- ตั้งค่า retrieval เช่น การหาน้ำหนักความใกล้เคียงหรือ reranking ด้วยโมเดลภาษาเพื่อให้คำตอบสอดคล้องกับบริบท
- พิจารณาความเป็นส่วนตัวและการควบคุมสิทธิ์ โดยเฉพาะเมื่อจัดเก็บเสียงหรือวิดีโอที่อาจมีข้อมูลส่วนบุคคล
ข้อจำกัดและเรื่องที่ควรระวัง
แม้จะมีประสิทธิภาพสูง แต่ก็ยังมีเรื่องต้องระวัง เช่น ค่าใช้จ่ายในการประมวลผลและจัดเก็บข้อมูลขนาดใหญ่ ความแม่นยำอาจลดลงกับวิดีโอยาวหรือคุณภาพเสียงต่ำ การตีความวิดีโอที่ต้องใช้บริบทกว้างก็ยังเป็นงานท้าทาย
อีกประเด็นคือการจัดการกับข้อมูลหลายภาษาหรือภาษาท้องถิ่นที่มีสำนวนเฉพาะ โมเดลรองรับ 100+ ภาษาแต่การทดสอบในภาษาเฉพาะบางภาษาอาจยังต้องตรวจสอบเพิ่ม
คำศัพท์เฉพาะที่น่าสนใจ
- Embedding: การแปลงข้อมูลเป็นเวกเตอร์ตัวเลขเพื่อเก็บความหมาย
- Multimodal: การรองรับข้อมูลหลายรูปแบบ เช่น ข้อความ ภาพ วิดีโอ เสียง
- RAG (Retrieval Augmented Generation): การผสมการค้นคืนข้อมูลกับการสร้างข้อความของโมเดลใหญ่
- Vector database: ฐานข้อมูลที่ออกแบบมาเพื่อจัดเก็บและค้นหาเวกเตอร์
- Matryoshka representation: แนวคิดเวกเตอร์หลายชั้นที่ย่อลงได้โดยยังคงความหมายสำคัญ
สิ่งที่ได้จากคลิปนี้
Gemini Embedding 2 ไม่ใช่แค่การเพิ่มฟีเจอร์ แต่เป็นการรวมโลกของข้อมูลหลายรูปแบบเข้าด้วยกันในระดับ embedding นั่นหมายถึงระบบค้นหา recommendation และ RAG จะฉลาดและยืดหยุ่นขึ้น เรารู้สึกว่าโอกาสทางธุรกิจมีทั้งการสร้างประสบการณ์ค้นหาใหม่ๆ การปรับปรุงการบริการลูกค้า และการจัดระเบียบความรู้ขององค์กร
ท้ายที่สุด แนะนำให้ลงมือทดสอบกับข้อมูลจริงในระบบเล็กๆ ก่อน เพื่อวัดผลด้านความแม่นยำ ค่าใช้จ่าย และการตอบสนอง แล้วค่อยขยายเป็นโปรดักชันเมื่อมั่นใจ