วันที่บทความต้นทางใน VideoToBlog: 2026-03-04 ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว เนื้อหากล่าวถึง Mercury 2 ณ เวลานั้น แก้ตัวเลขบริบท 108,000 เป็น 128,000 และหน่วยราคา input/output เป็น 0.25/0.75 ดอลลาร์สหรัฐต่อหนึ่งล้านโทเคนตามประกาศรุ่นเดียวกัน โดยคงข้อความอื่นของต้นทาง · แหล่งอ้างอิงในบทความต้นทาง
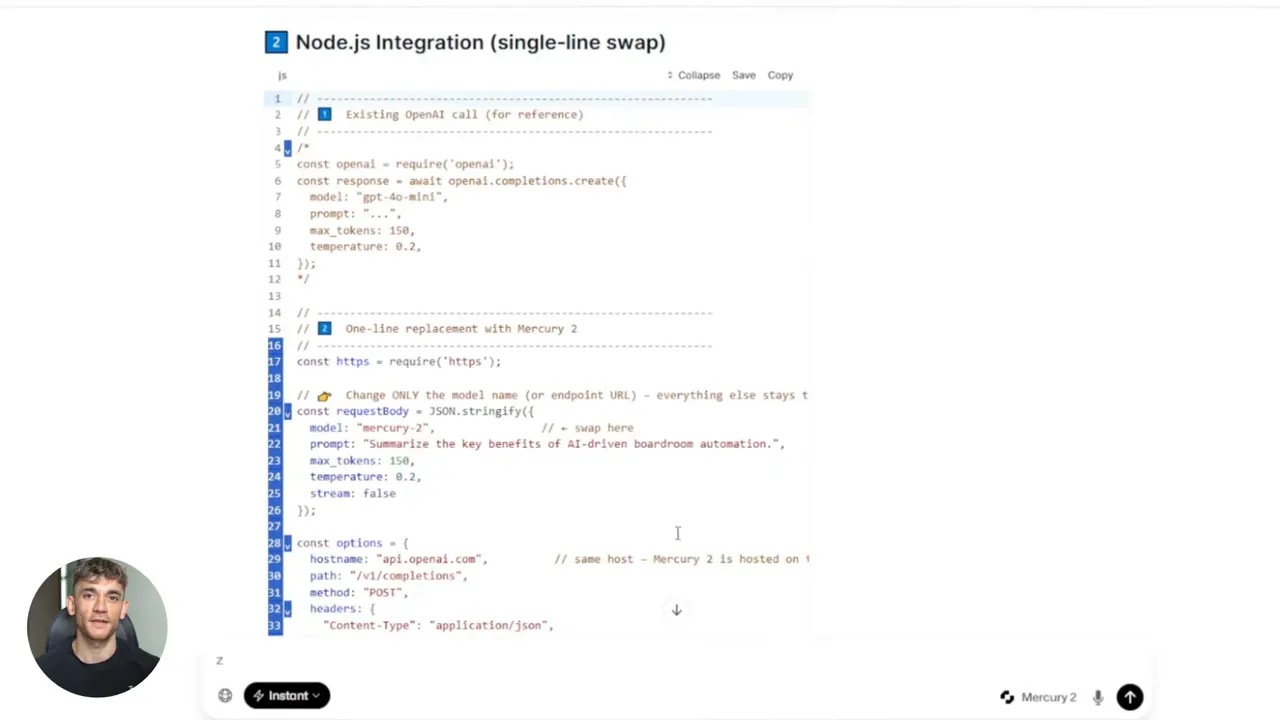
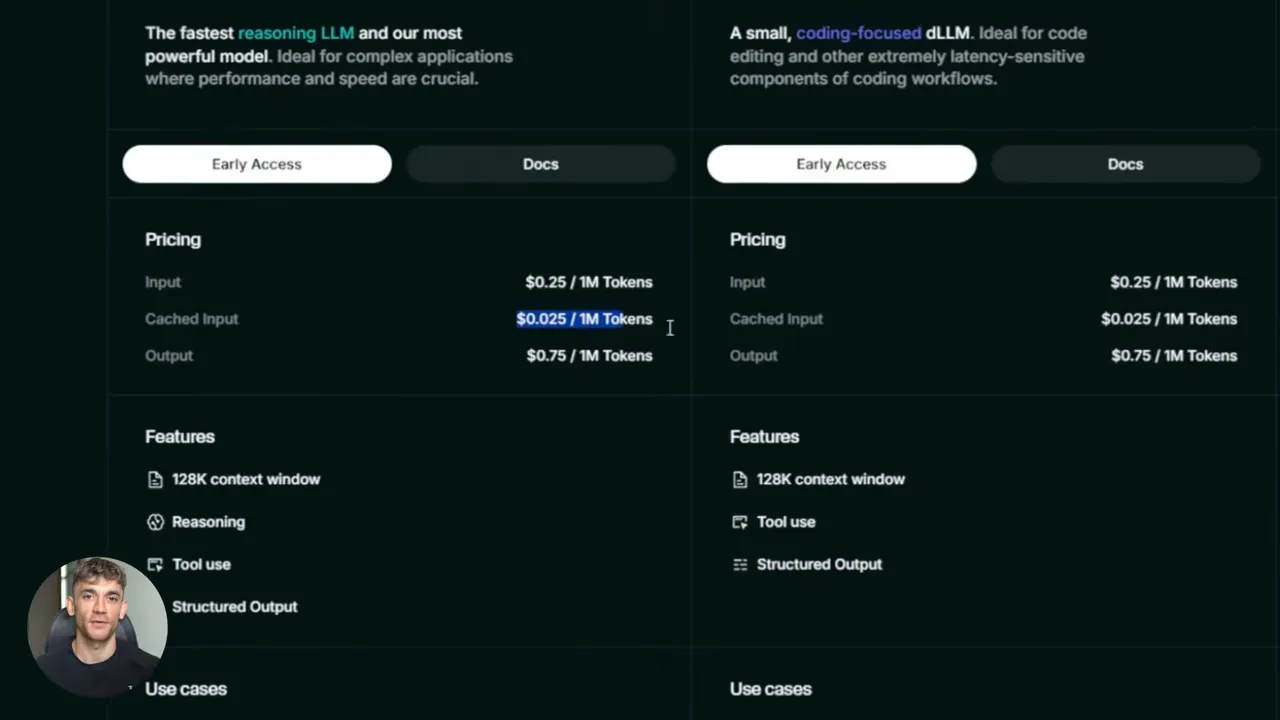
ขอบเขตประสิทธิภาพและโค้ด: ประกาศ Mercury 2 ของ Inception ระบุ 1,009 โทเคนต่อวินาทีบน NVIDIA Blackwell, บริบท 128K และราคา $0.25/$0.75 ต่อหนึ่งล้านโทเคน ตัวเลขความเร็วและข้อเปรียบเทียบเป็นข้อมูลผู้ให้บริการ/การสาธิต ไม่ใช่การรับประกันทุกงาน ภาพที่ 3 เป็นโค้ดที่โมเดลสร้างและระบุ api.openai.com เป็นโฮสต์ของ Mercury อย่างไม่ถูกต้อง จึงไม่ควรคัดลอกไปรันเป็นคู่มือตั้งค่า การรองรับรูปแบบ OpenAI API ไม่ได้หมายถึงใช้โฮสต์หรือคีย์ของ OpenAI ดู เอกสาร Inception สำหรับ endpoint api.inceptionlabs.ai และข้อกำหนดล่าสุด; เอกสารปัจจุบันอาจใช้รุ่นใหม่กว่า ตัวอย่าง curl ในบทความไม่ได้ผ่านการรันทดสอบในการย้ายเนื้อหาครั้งนี้
บทนำ – คลิปที่เพิ่งชมและเหตุผลที่ต้องสนใจ
เมื่อดูคลิปสรุปนี้แล้ว รู้สึกได้ทันทีว่าเทคโนโลยีบางอย่างกำลังเคลื่อนจากกรอบเดิมไปสู่สถาปัตยกรรมใหม่ Mercury 2 ถูกวางตำแหน่งเป็นโมเดลข้อความแบบ diffusion ตัวแรกที่มีความสามารถในการ "reasoning" และอ้างว่าเร็วกว่าระบบเกือบทั้งหมดในตลาดถึงห้าเท่า ข้อเรียกร้องเรื่องความเร็วและขนาดของ context ทำให้เกิดคำถามสำคัญว่า แล้วเราจะใช้มันอย่างไรให้เกิดประโยชน์ในงานธุรกิจจริง
ภาพรวมสั้นๆ ของ Mercury 2
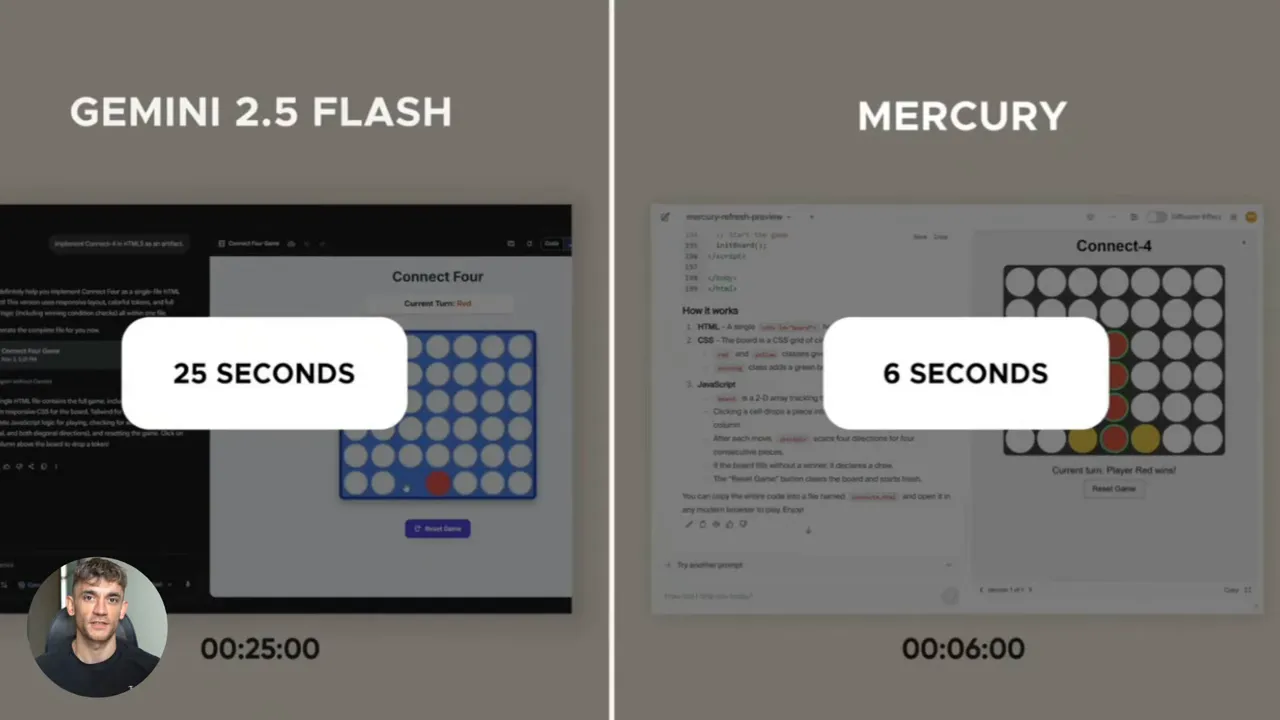
Mercury 2 แตกต่างจากโมเดลภาษาทั่วไปอย่าง ChatGPT, Claude หรือ Gemini ตรงที่ไม่สร้างข้อความทีละโทเคนจากซ้ายไปขวาอีกต่อไป แต่ใช้วิธีที่คล้ายกับ image diffusion คือเริ่มจากข้อมูลสุ่มและปรับข้อความทั้งหมดพร้อมกันในหลายรอบ ผลลัพธ์เป็นการสร้างข้อความที่เร็วขึ้นมาก ความเร็วที่ยกขึ้นคือประมาณ 1,000 โทเคนต่อวินาที บนฮาร์ดแวร์สมัยใหม่ เทียบกับโมเดลแบบออโต้รีเกรสซีฟที่มักอยู่ที่ 100–200 โทเคนต่อวินาที
ทำไมสถาปัตยกรรม diffusion กับข้อความจึงสำคัญ
แนวทางออโต้รีเกรสซีฟที่สร้างทีละโทเคนมีข้อจำกัดเชิงลำดับ ทุกโทเคนต้องรอผลของโทเคนก่อนหน้า ดังนั้นความเร็วจะถูกจำกัดโดยความล่าช้าเชิงลำดับ Mercury 2 ใช้วิธีที่สร้างและปรับข้อความเป็นชิ้นเป็นรอบ ทำให้สามารถประมวลผลแบบขนานได้มากขึ้น นี่ไม่ใช่แค่การเพิ่มความเร็ว แต่เป็นการเปลี่ยนกรอบคิดในเชิงสถาปัตยกรรม
สิ่งที่ได้รับจากแนวทางนี้
ความเร็วสูงขึ้นช่วยให้เกิดการนำไปใช้งานแบบเรียลไทม์ เช่น แชตบอตที่ตอบแทบจะทันที หรือผู้ช่วยเสียงที่ต้องการตอบกลับภายในวินาทีเดียว อีกด้านหนึ่งความเร็วยังเปิดโอกาสให้ต่อสายกระบวนการหลายขั้นตอน (chaining) แบบมี latency ต่ำ ซึ่งทำให้สามารถใช้งานหลายเอเยนต์พร้อมกันได้โดยไม่เพิ่มค่าใช้จ่ายเป็นสัดส่วนเท่ากับโมเดลช้า
สเปคที่ควรสนใจ
จากข้อมูลหลักที่สำคัญ:
- ความเร็ว: ประมาณ 1,000 โทเคนต่อวินาที
- context window: ประมาณ 128,000 โทเคน (บางครั้งระบุว่า 128K ในการสาธิตการใช้งาน)
- รองรับการเรียกใช้เครื่องมือภายนอก: native tool use และทำงานแบบ multi-step agents
- output เป็น JSON: เหมาะกับการเชื่อมต่อเข้ากระบวนการอัตโนมัติและแอปพลิเคชัน
- OpenAI API compatible: หากใช้งาน OpenAI อยู่แล้ว สามารถสลับมาใช้ Mercury 2 ได้โดยแทบไม่ต้องแก้โครงสร้างโค้ด
กรณีใช้งานจริงที่เปลี่ยนได้ทันที
แนวคิดต่อไปนี้ช่วยเห็นภาพว่า Mercury 2 จะให้ประโยชน์แบบจับต้องได้อย่างไรในงานธุรกิจ
1) สร้างคอนเทนต์จำนวนมากในเวลาอันสั้น
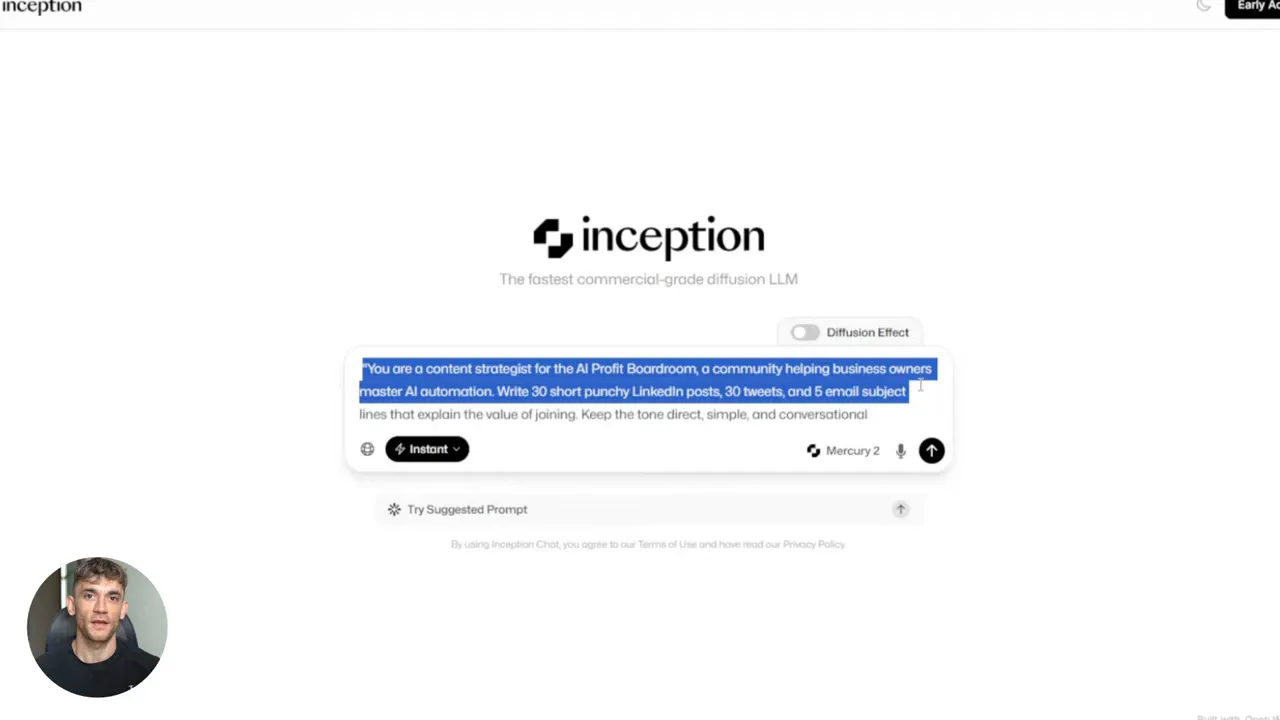
เมื่อจำเป็นต้องผลิตโพสต์ LinkedIn, ทวีต หรือหัวข้ออีเมลจำนวนมาก การได้ผลลัพธ์ในระดับวินาทีแทนที่จะรอเป็นนาทีน่าจะช่วยเปลี่ยนกระบวนการทำงานให้เป็นระบบอัตโนมัติจริงจัง ตัวอย่างคำสั่งเช่น ให้โมเดลสร้าง 30 โพสต์สั้นสำหรับ LinkedIn, 30 ทวีต และ 5 หัวข้ออีเมลแบบน้ำเสียงตรงไปตรงมา Mercury 2 จะตอบกลับทันที ทำให้สามารถทดลองหลายเวอร์ชันได้อย่างรวดเร็ว
2) เอเยนต์คัดกรองลีด (Lead Qualification Agent)
แชตบอตที่ติดตั้งบนหน้าแลนดิ้งเพจสามารถตอบคำถามลีดได้แทบจะทันที เมื่อ latency ต่ำ การโต้ตอบจะให้ความรู้สึกเหมือนคุยกับคนจริง และสามารถนำการตอบกลับเหล่านั้นไปต่อยอด เช่น กำหนดระดับความสนใจ ส่งนัดหมาย หรือส่งข้อเสนอแบบอัตโนมัติ
3) ฐานความรู้สำหรับชุมชนหรือซัพพอร์ต
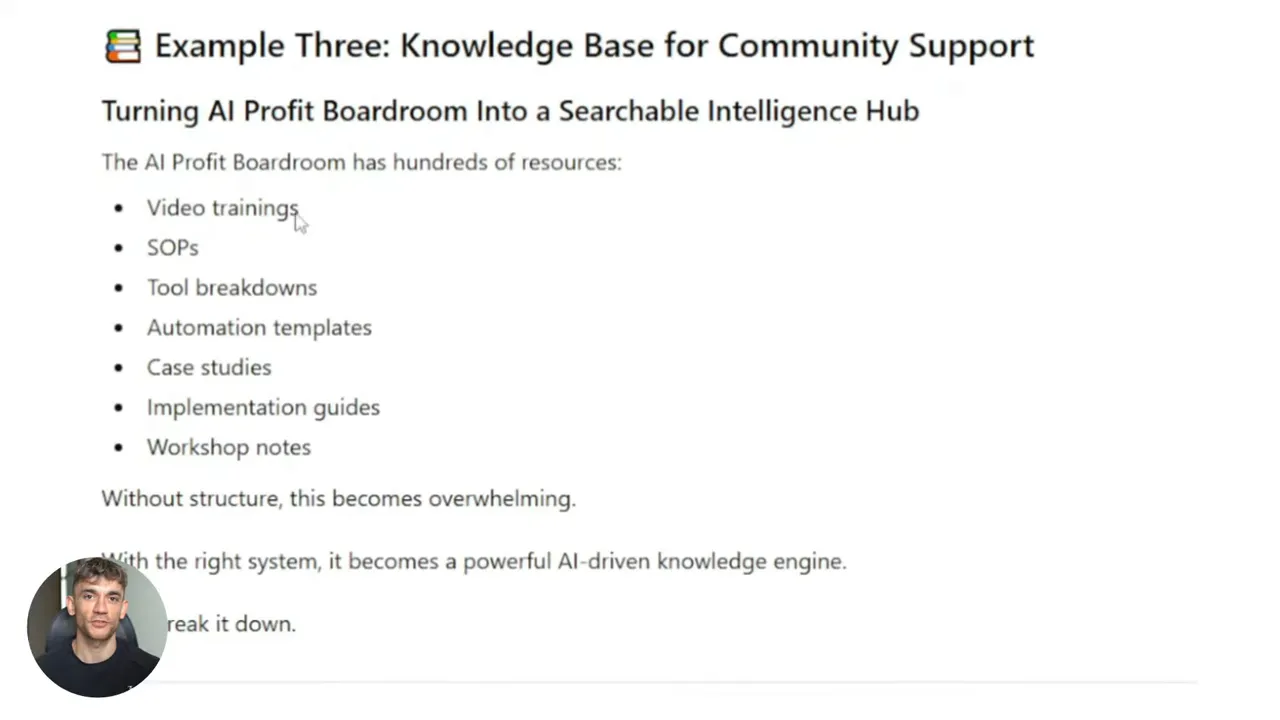
เมื่อมีเอกสารจำนวนมาก เช่น SOP, โน้ตวิดีโอ, กรณีใช้งาน ทั้งหมดสามารถใส่เข้าไปใน pipeline แบบ RAG (Retrieval-Augmented Generation) และใช้ Mercury 2 ดึงบริบททั้งหมดมาใช้พร้อมกัน ผลคือคำตอบที่แม่นยำขึ้น และลดปัญหาการลืมบริบทหรือ hallucination ได้มากขึ้น
ทำไมความเร็วเปลี่ยนสิ่งที่เป็นไปได้ได้
ความเร็วไม่ใช่แค่ "ประหยัดเวลา" แต่โดยแท้จริงคือการขยายขอบเขตของระบบอัตโนมัติ เมื่อโมเดลตอบภายในวินาที การทำคู่การประมวลผลหลายขั้นตอนก็ไม่ใช่เรื่องยุ่งยาก เราสามารถรันเอเยนต์หลายตัวคู่ขนาน สร้างโฟลว์ที่มีหลายสเต็ป และรวมการโต้ตอบแบบเสียงได้โดยไม่รู้สึกหน่วง
ตัวอย่างที่น่าสนใจ: Voice AI
ผู้ช่วยเสียงที่รู้สึกเป็นธรรมชาติต้องตอบกลับภายในช่วงเวลาย่อม (sub-second) เพื่อให้ปฏิสัมพันธ์ราบรื่น Mercury 2 สามารถเข้ามาตอบโจทย์นี้ได้ ทำให้การสร้างผู้ช่วยเสียงสำหรับชุมชน, ทีมซัพพอร์ต หรือฝ่ายขายเป็นไปได้ในเชิงปฏิบัติ
การเริ่มต้นใช้งานและค่าใช้จ่าย
การเข้าถึง Mercury 2 ผ่าน Inception Labs โดยระบุว่าระบบเป็น OpenAI API compatible จึงสามารถสลับ endpoint และชื่อโมเดลได้ง่าย ค่าใช้จ่ายที่อ้างถึงคือประมาณ 0.25 ดอลลาร์สหรัฐต่อหนึ่งล้านโทเคน (input) และ 0.75 ดอลลาร์สหรัฐต่อหนึ่งล้านโทเคน (output) — นี่ทำให้ค่าใช้จ่ายสำหรับงานสร้างคอนเทนต์หรือเอเยนต์โต้ตอบกลายเป็นราคาย่อมเยาเมื่อเทียบกับมูลค่าที่ได้
ตัวอย่างสลับ endpoint แบบง่าย (illustrative)
curl https://api.inceptionlabs.ai/v1/chat/completions \
  -H "Authorization: Bearer $INCEPTION_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mercury-2",
    "messages": [{"role":"user", "content":"สรุปประเด็นสำคัญจากเอกสารนี้"}]
  }'
โค้ดข้างต้นเป็นตัวอย่างแสดงหลักการ: เปลี่ยน endpoint และชื่อโมเดลแทนการเรียก OpenAI ปกติได้เลย
ข้อควรพิจารณาด้านคุณภาพและความแม่นยำ
ความเร็วสูงไม่ควรแลกมาด้วยความแม่นยำ หากอ้างอิงจากเบนช์มาร์ก Mercury 2 มีระดับ reasoning ที่ใกล้เคียงกับ Claude Haiku 4.5 ดังนั้นประสิทธิภาพด้าน reasoning อยู่ในระดับแข่งขันได้ แต่ยังคงต้องทดสอบกับงานจริง เช่น การแปลเชิงเทคนิค การอ่านเอกสารกฎหมาย หรือการสรุปเชิงวิชาการ เพื่อวัดความแม่นยำต่อบริบทเฉพาะ
เทคนิคในการใช้งานให้คุ้มค่าที่สุด
เราคิดว่าวิธีใช้งาน Mercury 2 อย่างเป็นระบบต้องคำนึงถึง:
- ออกแบบ prompt ให้ชัดเจนและเน้นการส่งคืนข้อมูลในรูปแบบ JSON เมื่อจะนำผลไปใช้ต่อ
- ใช้ความสามารถ context ขนาดใหญ่สำหรับ RAG ที่ต้องการบริบทหลายเอกสาร
- ตั้งมาตรฐานการทดสอบด้าน hallucination ด้วยชุดข้อมูลจริงของธุรกิจ
- วางโครงสร้างการเรียกใช้งานแบบคู่ขนานสำหรับงานที่สามารถกระจายภาระได้
ความเสี่ยงและข้อจำกัดที่ต้องคำนึง
แม้ Mercury 2 จะให้สัญญาเรื่องความเร็วและ context ที่ใหญ่ แต่มีประเด็นที่ควรพิจารณา:
- การประยุกต์ใช้ diffusion กับ reasoning ยังใหม่ การค้นคว้าและการทดสอบในเชิงปฏิบัติยังจำเป็น
- ผลลัพธ์อาจมีความแตกต่างตามฮาร์ดแวร์และสเปคเซิร์ฟเวอร์
- ต้องบริหารจัดการข้อมูลที่ใส่เข้าไปใน context window อย่างระมัดระวังเพื่อหลีกเลี่ยงข้อมูลล้นหรือข้อมูลล้าสมัย
คำศัพท์เฉพาะที่น่าสนใจ
- Diffusion model: โมเดลที่เริ่มจากสัญญาณสุ่มและปรับให้เข้าใกล้ผลลัพธ์ที่ต้องการผ่านการย้อนกลับของ noise
- Autoregressive: วิธีสร้างข้อความทีละโทเคนจากซ้ายไปขวา ตัวอย่างเช่น GPT-3/4
- Token: หน่วยข้อมูลที่โมเดลประมวลผล อาจเป็นคำหรือส่วนของคำ
- Context window: จำนวนโทเคนที่โมเดลสามารถ "เห็น" และนำมาพิจารณาในคำตอบเดียว
- RAG (Retrieval-Augmented Generation): กระบวนการดึงเอกสารภายนอกเข้ามาช่วยในการสร้างคำตอบ
- OpenAI API compatible: โครงสร้างคำสั่งและการเรียกใช้งานคล้าย OpenAI ทำให้สลับโมเดลได้ง่าย
ตัวอย่างการใช้งานที่นำไปใช้จริงได้ทันที
ตัวอย่างเชิงปฏิบัติที่แนะนำให้ทดสอบเป็นสองขั้นตอน:
- ทดลอง prompt สั้นๆ สำหรับสร้างซีรีส์โพสต์คอนเทนต์ เพื่อวัดเวลาและคุณภาพที่ได้เทียบกับโมเดลเดิม
- สร้างเอเยนต์ทดสอบในหน้าแลนดิ้งเพจที่ทำหน้าที่คัดกรองลีดและส่งข้อมูลไปยัง CRM ในรูปแบบ JSON
การทดลองสองแบบนี้ให้ภาพชัดว่า Mercury 2 เหมาะกับงานใดจริงๆ และช่วยปรับโมเดลการคำนวณค่าใช้จ่ายได้เร็วขึ้น
สิ่งที่ได้จากคลิปนี้
สรุปใจความที่ควรจดจำ เราได้รับมุมมองว่ามีโมเดลข้อความสถาปัตยกรรมใหม่ที่ให้ความเร็วสูงและ context ใหญ่ การเปลี่ยนมาใช้ diffusion กับข้อความอาจเป็นจุดเปลี่ยนเชิงเทคนิคที่เปิดประตูให้กับผู้ช่วยเสียงเรียลไทม์ เอเยนต์ที่ตอบกลับทันที และระบบอัตโนมัติที่มีการเชื่อมต่อหลายขั้นตอนโดยไม่รู้สึกหน่วง ค่าใช้จ่ายต่อโทเคนที่ต่ำทำให้การทดลองนำไปใช้งานเชิงธุรกิจน่าสนใจมากขึ้น
แนะนำขั้นตอนถัดไปสำหรับทีมงาน
เราแนะนำลำดับการเริ่มต้นดังนี้
- เริ่มจากการทดสอบโปรโตไทป์สำหรับงานคอนเทนต์และแชตบอต
- ทดสอบ RAG กับฐานความรู้ขององค์กรเพื่อประเมิน hallucination
- ตั้ง KPI ที่วัด latency และความแม่นยำของคำตอบ
- ออกแบบการตอบกลับในรูปแบบ JSON เพื่อให้ต่อเข้ากระบวนการอัตโนมัติได้ง่าย
บทสรุปท้ายบทความ
Mercury 2 เสนอแนวทางใหม่ในโลกของโมเดลภาษา ด้วยความเร็วและบริบทที่ใหญ่กว่าเดิม มันเปิดโอกาสให้เอเยนต์เรียลไทม์และระบบอัตโนมัติที่เคยเป็นไปได้ยากก่อนหน้านี้ เราควรทดลองใช้ในงานที่ได้ประโยชน์ชัดเจน เช่น คอนเทนต์จำนวนมาก ระบบคัดกรองลีด และฐานความรู้ขององค์กร แล้วประเมินผลด้านความแม่นยำและค่าใช้จ่ายอย่างเป็นระบบ การนำเทคโนโลยีใหม่มาใช้เร็วหน่อยแต่มีการทดสอบที่ดีจะช่วยให้ได้เปรียบในการออกแบบผลิตภัณฑ์และกระบวนการภายใน