ถ่ายทอดจากบทความต้นทางใน VideoToBlog วันที่ 12 สิงหาคม 2026 และคลิป Scaling up Continual Learning, Ronak Malde, Trajectory ของช่อง AI Engineer คำอธิบายวิธีฝึก ผลทดลอง และสถานะระบบเป็นข้อมูลที่ผู้บรรยายนำเสนอในขณะนั้น ยังไม่ได้ทดสอบซ้ำ ตัวอย่างธุรกิจไทยเป็นการประยุกต์ในบทความต้นฉบับ วันที่นี้เป็นวันที่บทความต้นทาง ไม่ใช่วันอัปโหลดวิดีโอซึ่งยังไม่ได้ตรวจยืนยัน · วิดีโอต้นทาง
AI ที่ตอบคำถามได้ดีในเดโม อาจยังทำงานจริงไม่ได้ดีพอ เพราะโลกธุรกิจไม่ได้ให้โจทย์เดิมซ้ำไปมา แต่เต็มไปด้วยลูกค้าหลายรูปแบบ ข้อยกเว้น ระบบที่เปลี่ยนตลอด และข้อมูลที่ไม่เคยสะอาดสมบูรณ์
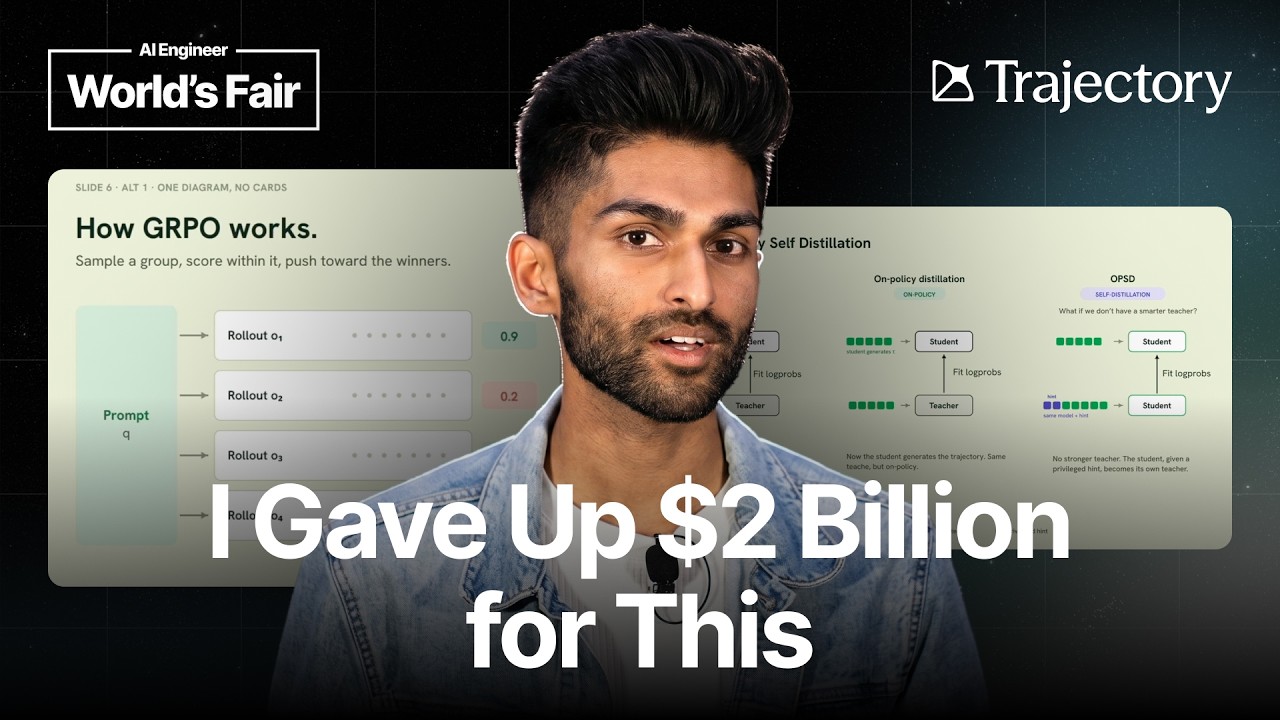
ประเด็นนี้คือแกนกลางของคลิปจากช่อง AI Engineer ที่ Ronak Malde แห่ง Trajectory อธิบายเรื่อง continual learning หรือการทำให้โมเดลเรียนรู้จากการใช้งานต่อเนื่อง แนวคิดสำคัญไม่ใช่การฝึก AI ให้เก่งขึ้นด้วย benchmark เพียงอย่างเดียว แต่คือการนำร่องรอยจากงานจริงมาเปลี่ยนเป็นวงจรพัฒนาระบบอย่างมีวินัย
สำหรับเจ้าของธุรกิจและคนทำงานไทย นี่ไม่ใช่เรื่องของการสร้างโมเดลขนาดมหาศาลเอง ประเด็นที่นำไปใช้ได้ทันทีคือ เราควรออกแบบ AI workflow ให้เก็บสัญญาณความสำเร็จ ความผิดพลาด และจุดที่ต้องให้คนเข้ามาช่วย เพื่อทำให้ระบบดีขึ้นในรอบถัดไป
สารบัญ
- ขั้นตอนที่ 1: เลิกมอง benchmark เป็นคำตอบสุดท้ายของ AI
- ขั้นตอนที่ 2: ใช้กรอบ 4 ข้อประเมินว่า AI เรียนรู้จากงานจริงได้แค่ไหน
- ขั้นตอนที่ 3: เข้าใจข้อแลกเปลี่ยนของ SFT, RLHF และ GRPO ก่อนเลือกแนวทาง
- ขั้นตอนที่ 4: ใช้แนวคิด Self-Distillation เพื่อเปลี่ยนความช่วยเหลือเป็นการเรียนรู้
- ขั้นตอนที่ 5: ระวัง 2 จุดพังของ AI agent ที่ทำงานยาว
- ขั้นตอนที่ 6: สร้างวงจร continual learning แบบที่ธุรกิจเริ่มได้จริง
- ขั้นตอนที่ 7: Actionable Insights สำหรับเจ้าของธุรกิจและคนทำงาน
- ขั้นตอนที่ 8: Troubleshooting เมื่อ AI เรียนรู้จากงานจริงแล้วเริ่มมีปัญหา
- ขั้นตอนที่ 9: การต่อยอดจาก AI chatbot ไปสู่ระบบที่ดีขึ้นทุกเดือน
- ขั้นตอนที่ 10: สรุป Checklist ทั้งหมด
ขั้นตอนที่ 1: เลิกมอง benchmark เป็นคำตอบสุดท้ายของ AI
การพัฒนา AI ที่ผ่านมาอาศัย benchmark เป็นตัววัดความก้าวหน้าอย่างมาก ปัญหาคือ benchmark รุ่นใหม่ยากขึ้น แพงขึ้น และใช้เวลาประเมินนานขึ้นเรื่อย ๆ ที่สำคัญกว่านั้นคือ คะแนนที่สูงขึ้นไม่ได้แปลว่า AI จะทำงานได้ดีในสถานการณ์จริงขององค์กร
ลองนึกถึง AI ช่วยตอบแชตลูกค้า ร้านค้าอาจทดสอบว่ามันตอบคำถามสินค้าได้ถูกต้อง 90% แต่ในงานจริงยังมีเคสที่ต้องตรวจเลขคำสั่งซื้อ เช็กสถานะจัดส่ง ขอเปลี่ยนสินค้า ประสานทีมบัญชี หรือรับมือกับข้อความที่พิมพ์ไม่ครบ ถ้าเก็บแค่คะแนนรวม เราจะไม่รู้เลยว่าระบบพลาดตรงไหนและควรแก้ก่อนหลัง
Ronak ชี้ให้เห็นว่า ทุกวันมีการใช้ token จำนวนมหาศาลเพื่อให้โมเดลตอบงานจริง การใช้งานเหล่านี้สร้างข้อมูลว่าโมเดลทำอะไรได้ดีและล้มเหลวอย่างไร แต่หลายองค์กรปล่อยสัญญาณนี้ทิ้งไปพร้อมกับจบแชตหนึ่งครั้ง
มุมที่น่าสนใจคือ ธุรกิจไม่จำเป็นต้องรอให้มีข้อมูลระดับล้านรายการก่อน เริ่มจากการระบุว่า “งานจริงที่ AI ทำอยู่” คืออะไร และเก็บผลลัพธ์ของงานนั้นให้เป็นระบบก็พอ เช่น คำตอบนี้ถูกส่งต่อให้พนักงานแก้หรือไม่ ลูกค้าต้องถามซ้ำหรือไม่ งานจบในครั้งเดียวหรือไม่
ขั้นตอนที่ 2: ใช้กรอบ 4 ข้อประเมินว่า AI เรียนรู้จากงานจริงได้แค่ไหน
คลิปเสนอเกณฑ์ 4 ข้อสำหรับมองระบบฝึก AI ซึ่งแม้ชื่อจะดูเทคนิค แต่แปลเป็นภาษาธุรกิจได้ตรงไปตรงมา
- Online task distribution: งานที่ใช้ฝึกควรมาจากงานจริง ไม่ใช่ชุดโจทย์ที่สร้างขึ้นเพื่อสอบเท่านั้น
- On-policy sampling: ต้องเรียนรู้จากพฤติกรรมที่โมเดลเวอร์ชันปัจจุบันทำจริง ไม่ใช่ข้อมูลเก่าที่อาจไม่สะท้อนวิธีทำงานตอนนี้
- ไม่ต้องพึ่ง parallel rollouts จำนวนมาก: การเรียนรู้จากหนึ่งเหตุการณ์ควรมีค่า ไม่ควรต้องจำลองหลายทางเลือกจนต้นทุนโครงสร้างสูงเกินไป
- Feedback ระดับ token: ระบบควรเห็นสัญญาณละเอียดตลอดกระบวนการ ไม่ใช่ได้แค่คะแนนสุดท้ายว่า “ผ่าน” หรือ “ไม่ผ่าน”
ถ้าเทียบกับงานคน การบอกว่าอีเมลฉบับหนึ่งได้ 87 คะแนนจาก 100 อาจช่วยได้เพียงเล็กน้อย คนเขียนยังไม่รู้ว่าควรแก้หัวข้อไหน เหตุผลส่วนใดไม่ชัด หรือประโยคใดทำให้ลูกค้าเข้าใจผิด AI ก็เจอปัญหาเดียวกันเมื่อได้รับรางวัลเพียงก้อนเดียวหลังทำงานจบ
องค์กรจึงควรเปลี่ยนจากการถามว่า “AI ตอบถูกไหม” เป็น “AI ทำขั้นตอนไหนพลาด และผลกระทบของความผิดพลาดนั้นคืออะไร” การเปลี่ยนคำถามนี้ทำให้การปรับ prompt, ฐานความรู้ และ workflow มีเป้าหมายชัดขึ้นมาก
ขั้นตอนที่ 3: เข้าใจข้อแลกเปลี่ยนของ SFT, RLHF และ GRPO ก่อนเลือกแนวทาง
วิธีฝึก AI หลายแบบต่างซื้อข้อดีด้วยข้อเสียคนละด้าน SFT หรือ instruction fine-tuning เก่งเรื่องสอนรูปแบบคำตอบที่ต้องการ และให้ feedback ได้ละเอียดระดับคำ แต่ข้อมูลฝึกมักเป็นชุดข้อมูลที่คัดมาแล้ว จึงอาจห่างจากงานจริง
ต่อมาคือ DPO และ RLHF ที่นำความชอบของมนุษย์เข้ามาใช้มากขึ้น เช่น เลือกคำตอบ A ดีกว่า B แม้ระบบจะใกล้กับสิ่งที่คนต้องการขึ้น แต่ feedback มักกลับไปเป็นคะแนนระดับทั้งคำตอบ และโครงสร้างการฝึกซับซ้อนกว่าเดิม
GRPO เป็นแนวทางที่ใช้ให้โมเดลสร้างคำตอบหลายชุดแบบ parallel แล้วเปรียบเทียบผลลัพธ์กับค่าเฉลี่ย วิธีนี้มีพลังเพราะโมเดลเรียนรู้จากพฤติกรรมของตัวเอง แต่ต้องใช้การจำลองหลายเส้นทาง และมักได้รางวัลเมื่อจบทั้งลำดับงานเท่านั้น
นี่คือเหตุผลที่ Ronak เปรียบ GRPO ว่าเหมือนนักเรียนที่ส่งเรียงความแล้วได้รับแค่คะแนน 87 จาก 100 นักเรียนรู้ว่าผลงานยังไม่ดีพอ แต่ไม่รู้ชัดว่าต้องแก้ประโยคใดก่อน ระบบ AI ที่ต้องเรียกเครื่องมือหลายสิบครั้งก็เผชิญปัญหาเดียวกัน
สำหรับธุรกิจไทย บทเรียนไม่ใช่ต้องเลือกอัลกอริทึมเหล่านี้เอง แต่คืออย่ารีบวัด AI agent จากผลลัพธ์ปลายทางเพียงอย่างเดียว หาก agent ทำเรื่องคืนเงินไม่สำเร็จ ต้องตรวจได้ว่าเริ่มผิดที่การอ่านเจตนาลูกค้า การค้นหานโยบาย การเรียกข้อมูลคำสั่งซื้อ หรือการสรุปคำตอบ
ขั้นตอนที่ 4: ใช้แนวคิด Self-Distillation เพื่อเปลี่ยนความช่วยเหลือเป็นการเรียนรู้
หัวใจของแนวคิด on-policy self-distillation คือ โมเดลไม่จำเป็นต้องมี teacher model ที่ฉลาดกว่าเสมอไป แทนที่จะหาโมเดลภายนอกมาสอน ให้ใช้โมเดลเดียวกันในสองบทบาท
บทบาทแรกคือ student ที่ทำงานจากข้อมูลตามปกติ ส่วนบทบาท teacher จะได้รับ “hint” หรือข้อมูลช่วยคิดเพิ่ม เช่น คำแนะนำจาก environment แนวทางแก้ปัญหา หรือข้อมูลที่ทีมปฏิบัติการตรวจพบ แล้วฝึกให้ student เรียนรู้ที่จะเข้าใกล้การตัดสินใจของ teacher โดยไม่เห็น hint นั้นในงานจริง
ตัวอย่างเชิงธุรกิจคือ AI ฝ่าย support พบเคสล็อกอินไม่ได้ ระบบตรวจพบภายหลังว่า SSO token หมดอายุ แทนที่จะสอน AI ให้ตอบเฉลยทันทีว่า “token หมดอายุ” เราควรสอนขั้นตอนที่สมเหตุผล เช่น ตรวจบันทึกการเข้าสู่ระบบ ตรวจสถานะการยืนยันตัวตน และตรวจเวลาหมดอายุของสิทธิ์
ข้อดีของแนวทางนี้คือ feedback มีความละเอียดขึ้น เพราะไม่ได้ปรับแค่คำที่โมเดลเลือกไปแล้ว แต่ปรับการกระจายความน่าจะเป็นของคำทางเลือกจำนวนมาก โมเดลจึงมีโอกาสเรียนรู้วิธีเลือกแนวทางใหม่ แทนที่จะเพียงมั่นใจขึ้นกับคำตอบเดิม
ผลที่นำเสนอคือ งานระยะสั้น เช่น chatbot หรือโจทย์ที่มีขั้นตอนจำกัด สามารถได้ผลดีและใช้ token เพื่อแก้ปัญหายากลดลง นี่มีนัยสำคัญต่อธุรกิจ เพราะต้นทุน AI ไม่ได้มาจากค่ารายเดือนของ platform เท่านั้น แต่ยังมาจากจำนวนครั้งที่ระบบคิดยาว เรียกเครื่องมือ และวนกลับไปแก้คำตอบ
ขั้นตอนที่ 5: ระวัง 2 จุดพังของ AI agent ที่ทำงานยาว
ปัญหาแรก: But wait problem
เมื่อ task ยาวขึ้นและมีการเรียก tool 50 หรือ 100 ครั้ง student model อาจเดินออกจากเส้นทางที่ teacher มองว่าถูกต้องมากขึ้นเรื่อย ๆ Teacher จึงพยายามดึงกลับทุกจุด สุดท้ายโมเดลติดอยู่ระหว่างการตัดสินใจสองชุดที่ห่างกันมาก
อาการที่พบคือโมเดลเริ่มใช้คำลังเลมากเกินไป เช่น “เดี๋ยวก่อน” “แต่” “อาจจะ” หรือคิดวนโดยไม่ตัดสินใจ ในภาษาธุรกิจ นี่คือ agent ที่สร้างข้อความยาวขึ้น เริ่มตรวจสิ่งเดิมซ้ำ และไม่ยอมปิดงาน
แนวทางแก้ที่นำเสนอคือ step-level divergence weighting กล่าวคือวัดว่าพฤติกรรมของ student และ teacher ต่างกันมากเพียงใดในแต่ละขั้นตอน แล้วให้น้ำหนักการแก้ไขเฉพาะจุดที่เหมาะสม ถ้า agent เริ่มหลุดตั้งแต่ขั้นแรก ให้แก้รากของปัญหาก่อน ไม่ใช่บังคับแก้ทุกการตัดสินใจช่วงท้ายที่เป็นผลตามมา
ปัญหาที่สอง: Hint leakage
Hint leakage คือรูปแบบหนึ่งของ reward hacking ถ้า hint เฉลยคำตอบมากเกินไป โมเดลอาจเรียนรู้ที่จะพูดคำตอบก่อน แล้วค่อยสร้างเหตุผลย้อนหลังให้ดูสมจริง ผลลัพธ์ดูถูกต้องบนข้อมูลฝึก แต่ใช้ไม่ได้เมื่อเจอเคสจริงที่ไม่มีคำใบ้
วิธีรับมือระดับปฏิบัติการคือใช้ AI หรือกฎช่วยกรอง hint ให้เหลือข้อมูลที่สมเหตุผลต่อการเข้าถึงของ agent เช่น อนุญาตให้รู้ว่าต้องตรวจ log แต่ไม่ให้เห็นผลสรุปจาก log ตั้งแต่ต้น อีกแนวคิดคือ residual guidance ซึ่งแยก hint เป็นส่วนย่อยและส่วนเต็ม เพื่อลดแรงผลักให้โมเดลกระโดดไปยังคำตอบที่ไกลเกินความสามารถเดิม
มุมมองของเราคือ หลายทีมพลาดเรื่องนี้ตั้งแต่ยังไม่ถึงขั้นฝึกโมเดลด้วยซ้ำ เพราะใส่ “คำตอบที่ถูก” ไว้ใน prompt, knowledge base หรือชุดตัวอย่างโดยไม่ตั้งใจ แล้วตีความว่า AI ฉลาดขึ้น ทั้งที่จริง AI เพียงลอกข้อมูลที่อยู่ใกล้มือ
ขั้นตอนที่ 6: สร้างวงจร continual learning แบบที่ธุรกิจเริ่มได้จริง
Ronak ย้ำชัดว่าโลกยังอยู่ในช่วง pseudo-continual learning คือยังมีการรวบรวมข้อมูลเป็นรอบ ปรับระบบแบบ offline แล้วค่อยนำเวอร์ชันใหม่ขึ้นใช้งาน ไม่ใช่ AI เปลี่ยนน้ำหนักโมเดลทันทีทุกครั้งที่คุยกับลูกค้า
ข้อจำกัดนี้เป็นเรื่องดีสำหรับธุรกิจ เพราะการให้ระบบเรียนรู้ทันทีจากทุก interaction มีความเสี่ยงสูง ทั้งข้อมูลผิด ความพยายามหลอกระบบ และความไม่สม่ำเสมอของงาน แนวทางที่ปลอดภัยกว่าคือทำเป็นรอบการเรียนรู้ที่ตรวจสอบได้
- เก็บ trace ของงาน AI เช่น prompt, เอกสารที่อ้างอิง, tool call, คำตอบ และผลลัพธ์
- จัดกลุ่มเคสที่สำเร็จ เคสล้มเหลว และเคสที่ต้องให้คนแก้
- ให้ทีมผู้เชี่ยวชาญตรวจเฉพาะเคสที่มีผลกระทบสูง
- ปรับ prompt, ฐานความรู้, สิทธิ์การใช้ tool หรือกติกา workflow
- ทดสอบกับชุดเคสจริงที่กันไว้ ก่อนปล่อยให้ใช้งานกว้างขึ้น
- ติดตามตัวชี้วัดหลังปรับ และย้อนกลับไปเก็บเคสใหม่
แนวคิดนี้ตรงกับสิ่งที่ Trajectory ต้องการสร้าง คือ platform ที่รับ agent traces จาก production นำมาปรับปรุงโมเดลและ harness หรือชุดเครื่องมือ กติกา และ workflow รอบโมเดล แล้ว deploy กลับเป็นระบบที่เรียนรู้ต่อเนื่อง
ขั้นตอนที่ 7: Actionable Insights สำหรับเจ้าของธุรกิจและคนทำงาน
- เริ่มจากงานเดียว: เลือกงานที่เกิดซ้ำและวัดผลได้ เช่น คัดแยก lead, ตอบคำถามหลังการขาย หรือสรุปเอกสาร ไม่ควรเริ่มจาก agent ที่ทำทุกอย่าง
- เก็บเหตุผลที่คนแก้: เมื่อพนักงานแก้คำตอบ AI ให้บันทึกประเภทความผิดพลาด ไม่ใช่เก็บแค่เวอร์ชันข้อความที่แก้แล้ว
- วัดผลเป็นขั้นตอน: แยกอัตราค้นข้อมูลถูก อัตราเรียก tool สำเร็จ อัตราส่งต่อให้คน และอัตราปิดงาน ไม่วัดแค่ความพึงพอใจรวม
- ตั้งระบบ review ก่อนปรับ: เคสที่เกี่ยวกับเงิน ข้อมูลส่วนบุคคล หรือสิทธิ์ลูกค้า ต้องมีคนอนุมัติก่อนนำมาใช้เป็นตัวอย่างการเรียนรู้
- ลด token ที่สูญเปล่า: ตรวจหา agent ที่คิดวน เรียกเครื่องมือซ้ำ หรือเขียนคำตอบยาวผิดปกติ เพราะปัญหาเหล่านี้สะท้อนทั้งต้นทุนและคุณภาพ
ขั้นตอนที่ 8: Troubleshooting เมื่อ AI เรียนรู้จากงานจริงแล้วเริ่มมีปัญหา
- ปัญหา: AI ตอบได้ดีตอนทดสอบ แต่พลาดบ่อยหลังเปิดใช้จริง
สาเหตุ: ชุดทดสอบไม่สะท้อนคำถามและข้อยกเว้นที่เกิดขึ้นจริง
วิธีแก้: ดึงเคสจริงที่ผ่านการปกปิดข้อมูลส่วนบุคคล จัดหมวดข้อผิดพลาด แล้วสร้างชุดทดสอบจากเคสเหล่านั้นทุกสัปดาห์ - ปัญหา: AI ใช้เวลานานและเรียก tool ซ้ำ
สาเหตุ: workflow ไม่มีจุดหยุด ไม่มีเงื่อนไขส่งต่อ หรือคำสั่งเปิดให้ค้นหาแบบกว้างเกินไป
วิธีแก้: กำหนดจำนวน tool call สูงสุด ตั้งเงื่อนไขหยุด และบังคับให้สรุปสิ่งที่ตรวจแล้วก่อนเรียกเครื่องมือรอบใหม่ - ปัญหา: AI รู้คำตอบ แต่ให้เหตุผลไม่น่าเชื่อถือ
สาเหตุ: เกิด hint leakage หรือมีเฉลยหลุดเข้าไปในตัวอย่างและ prompt
วิธีแก้: ตรวจแหล่งข้อมูลช่วยตอบ ตัดส่วนที่เฉลยผลลัพธ์ออก และให้ AI อธิบายจากหลักฐานที่เข้าถึงได้จริง - ปัญหา: ทีมเก็บ log มาก แต่ไม่รู้ว่าจะปรับอะไร
สาเหตุ: ไม่มี taxonomy ของความผิดพลาดและไม่มีเจ้าของตัวชี้วัด
วิธีแก้: เริ่มจาก 5 หมวด เช่น เข้าใจคำถามผิด ค้นข้อมูลผิด เรียก tool ผิด รูปแบบคำตอบผิด และต้องส่งต่อคน แล้วทบทวนรายสัปดาห์
ขั้นตอนที่ 9: การต่อยอดจาก AI chatbot ไปสู่ระบบที่ดีขึ้นทุกเดือน
- ทำคลังเคสทองคำ: เก็บเคสที่ยากแต่ทีมแก้ได้ดี เพื่อใช้เป็นมาตรฐานสำหรับ prompt และการทดสอบเวอร์ชันใหม่
- แยกการพัฒนาโมเดลออกจาก harness: บางปัญหาไม่ต้องเปลี่ยน model แค่ปรับลำดับ tool, สิทธิ์เข้าถึงข้อมูล หรือแบบฟอร์มส่งต่องานก็แก้ได้
- สร้าง dashboard คุณภาพ: ติดตามงานที่จบเอง งานที่คนแก้ เวลาต่อเคส และต้นทุน token เพื่อเห็นผลของการปรับระบบในภาษาธุรกิจ
ขั้นตอนที่ 10: สรุป Checklist ทั้งหมด
- ☐ เลือก AI workflow หนึ่งงานที่มีปริมาณงานและผลลัพธ์ชัดเจน
- ☐ เก็บ trace ของ prompt, tool call, คำตอบ และผลลัพธ์ปลายทาง
- ☐ กำหนดหมวดความผิดพลาดที่ทีมใช้ร่วมกัน
- ☐ วัดคุณภาพรายขั้นตอน ไม่ใช้คะแนนรวมเพียงตัวเดียว
- ☐ ตรวจหาอาการคิดวน ใช้ token สูง และเรียก tool ซ้ำ
- ☐ กรองข้อมูลที่เป็นเฉลยออกจาก hint และตัวอย่างฝึก
- ☐ ให้คนตรวจเคสความเสี่ยงสูงก่อนนำไปปรับระบบ
- ☐ ทดสอบกับเคสจริงที่กันไว้ก่อน deploy เวอร์ชันใหม่
- ☐ ปรับทั้ง model, prompt, ฐานความรู้ และ harness ตามต้นเหตุ
- ☐ ทำรอบเรียนรู้แบบ batch ที่ตรวจสอบย้อนกลับได้
บทสรุปของ continual learning ไม่ได้อยู่ที่การทำให้ AI เรียนรู้เองทันทีทุกวินาที แต่อยู่ที่การสร้างระบบที่ไม่ปล่อยให้ทุกความผิดพลาดสูญหายไปกับงานหนึ่งครั้ง ธุรกิจที่เก็บสัญญาณจากงานจริงได้ดี แยกสาเหตุของปัญหาเป็น และปรับ workflow เป็นรอบ จะมี AI ที่เข้าใจงานของตัวเองมากขึ้นเรื่อย ๆ แทนที่จะมีเพียง chatbot ที่ดูฉลาดในวันแรกเท่านั้น