ถ่ายทอดจากบทความต้นทางใน VideoToBlog วันที่ 12 สิงหาคม 2026 และคลิป Beyond Static Intelligence: Evaluating Continual Learning, Parth Asawa, UC Berkeley ของช่อง AI Engineer นิยาม Gain รายละเอียด benchmark และผลเปรียบเทียบเป็นข้อมูลจากการนำเสนอ ไม่ใช่ผลทดสอบอิสระหรือข้อสรุปว่าแนวทางหนึ่งชนะทุกงาน ตัวอย่างธุรกิจไทยคงจากบทความต้นฉบับ วันที่นี้เป็นวันที่บทความต้นทาง ไม่ใช่วันอัปโหลดวิดีโอซึ่งยังไม่ได้ตรวจยืนยัน · วิดีโอต้นทาง
AI ที่ตอบคำถามได้เก่งในครั้งแรก ไม่ได้แปลว่า AI นั้น “เรียนรู้” จากการทำงานได้ดี เมื่อถูกใช้งานกับธุรกิจจริง ความต่างนี้สำคัญมาก เพราะงานไม่ได้เป็นโจทย์เดี่ยวที่เริ่มใหม่ทุกครั้ง แต่เต็มไปด้วยข้อมูลลูกค้า กฎการทำงาน ยอดขาย และข้อผิดพลาดเดิมที่ระบบควรนำไปใช้ให้ดีขึ้น
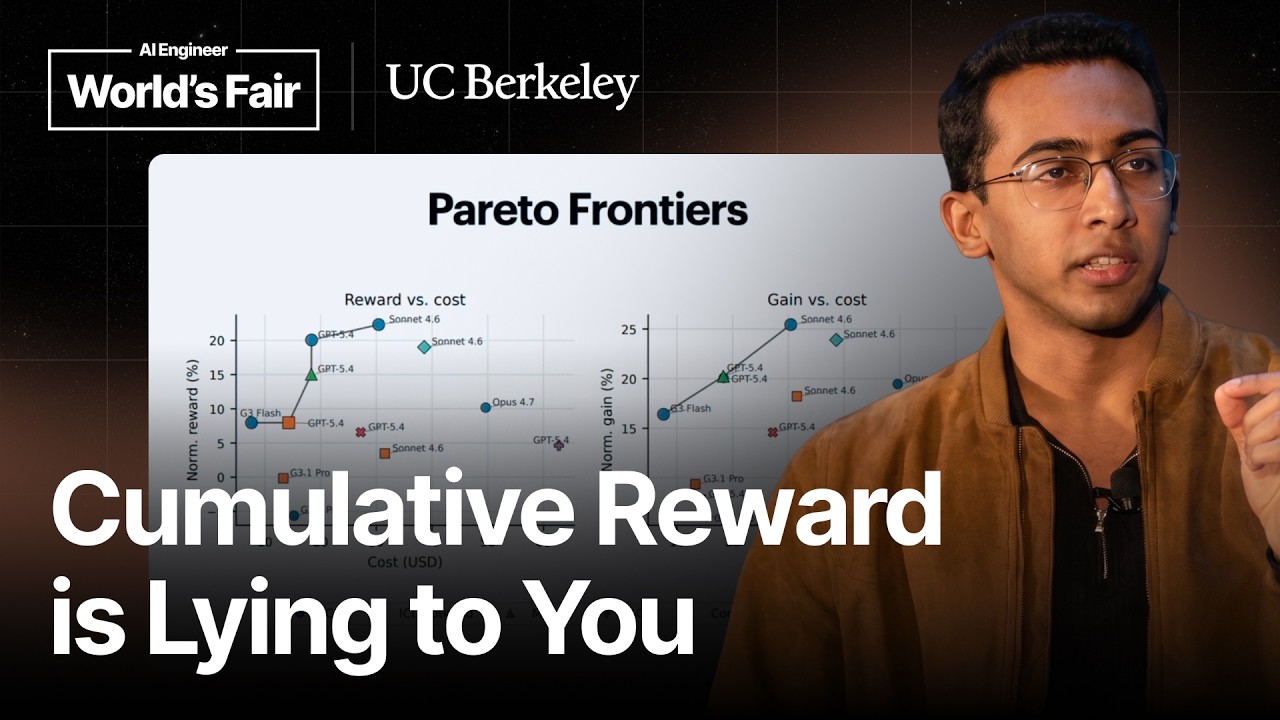
คลิปของ Parth Asawa จาก UC Berkeley บนช่อง AI Engineer ตั้งคำถามที่ตรงจุดว่า การประเมินโมเดลส่วนใหญ่ในวันนี้ให้ AI ทำโจทย์หนึ่งข้อ แล้วล้างความจำก่อนเริ่มข้อถัดไป จึงวัดเพียงความสามารถ ณ จุดหนึ่ง ไม่ได้วัดว่า AI เก็บบทเรียน ปรับตัว และรับมือกับความเปลี่ยนแปลงได้แค่ไหน
แก่นของเรื่องนี้ใช้ได้กับเจ้าของธุรกิจไทยทันที: ก่อนซื้อ AI agent หรือสร้าง workflow ที่มี memory เราต้องเลิกถามแค่ว่า “มันตอบถูกไหม” แล้วหันมาถามว่า หลังใช้งานไป 30 วัน มันทำงานเร็วขึ้น แม่นขึ้น และแก้พลาดดีขึ้นหรือไม่
สารบัญ
- Step 1: แยก AI ที่เก่งตั้งต้น ออกจาก AI ที่เรียนรู้ได้ต่อเนื่อง
- Step 2: เลือกกลไกความจำให้เหมาะกับงาน ไม่ใช่เลือกเพราะดูซับซ้อน
- Step 3: ออกแบบการทดสอบที่ AI มีโอกาสเรียนรู้จริง
- Step 4: วัด Gain ไม่ใช่ดูแค่คะแนนรวม
- Step 5: ทดสอบ AI ด้วยงานที่เหมือนชีวิตจริงและมีการเปลี่ยนแปลง
- Step 6: เข้าใจจุดล้มเหลวระหว่างการจำกับการปรับตัว
- Step 7: เริ่มสร้างวงจรเรียนรู้ของ AI ในงานธุรกิจ
- Step 8: แก้ปัญหาที่มักเจอเมื่อให้ AI เรียนรู้จากงานจริง
- Step 9: ต่อยอดจาก AI ที่ตอบเก่ง ไปสู่ AI ที่พัฒนา workflow ของเรา
- Step 10: สรุป Checklist ทั้งหมด
Step 1: แยก AI ที่เก่งตั้งต้น ออกจาก AI ที่เรียนรู้ได้ต่อเนื่อง
การทดสอบ AI แบบมาตรฐานมักแยกโจทย์ออกจากกันอย่างอิสระ เช่น ให้แปลภาษา ทำคณิตศาสตร์ เขียนโค้ด แล้วนำคะแนนมาจัดอันดับ แนวทางนี้มีประโยชน์สำหรับเทียบความสามารถพื้นฐานของ model แต่มีข้อสมมติซ่อนอยู่ คือให้ระบบลืมทุกอย่างหลังจบแต่ละงาน
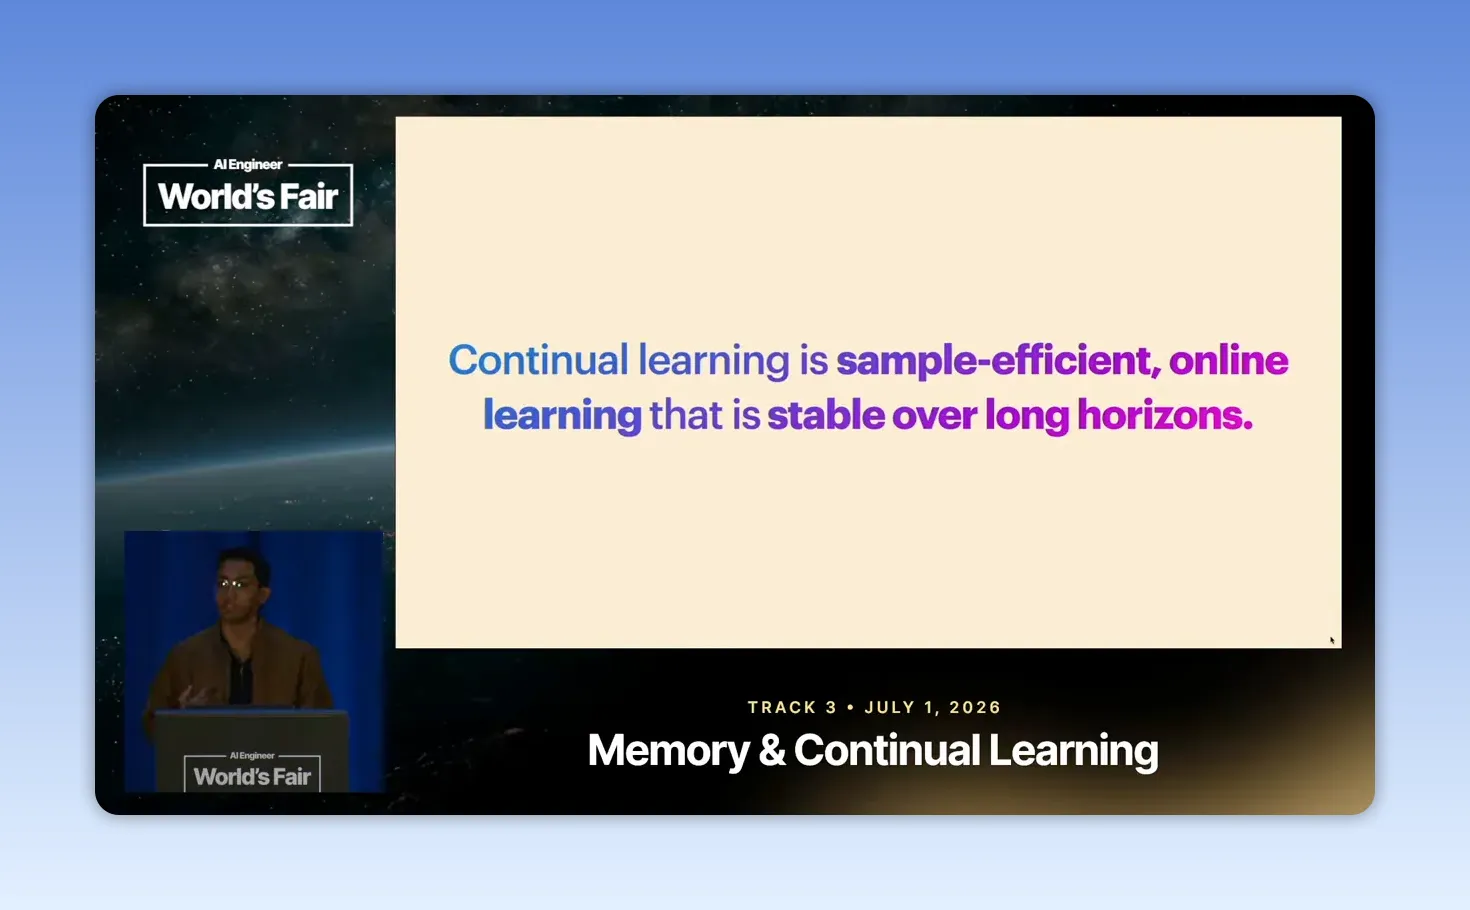
Parth Asawa เสนอว่า AI ที่มีคุณค่าต่อการทำงานระยะยาวควรทำได้มากกว่านั้น หรือที่เรียกว่า continual learning: การเรียนรู้แบบออนไลน์ที่ใช้ตัวอย่างไม่มากนัก และยังคงเสถียรเมื่อเวลาผ่านไปนาน
นิยามนี้มีสองด้านที่ต้องเกิดพร้อมกัน
- Stability คือการเก็บสิ่งที่เคยเรียนรู้ไว้ ไม่ลืมบทเรียนที่ยังสำคัญ
- Plasticity คือความสามารถในการรับข้อมูลใหม่ ปรับความเข้าใจ และทิ้งความรู้ที่ล้าสมัย
ลองนึกถึง AI ช่วยตอบแชตสำหรับร้านค้าออนไลน์ ช่วงแรกระบบอาจยังไม่รู้ว่าลูกค้าชอบถามเรื่องไหน ต้องใช้เวลาค้นหา SKU นาน หรือใช้คำตอบที่ไม่เหมาะกับนโยบายร้าน แต่หลังเจอคำถามเดิมและได้รับคำแก้ไขจากทีมหลายครั้ง ระบบควรตอบได้ตรงขึ้นโดยใช้ขั้นตอนน้อยลง นั่นจึงเป็น “การเรียนรู้” ที่มีความหมายทางธุรกิจ ไม่ใช่แค่ส่ง prompt เดิมให้ model เดิมซ้ำไปมา
Step 2: เลือกกลไกความจำให้เหมาะกับงาน ไม่ใช่เลือกเพราะดูซับซ้อน
สำหรับ Language Model มีแนวทางหลักสามแบบเพื่อทำให้ระบบเก็บประสบการณ์ข้ามงานได้
- In-context learning เก็บสิ่งที่เกิดขึ้นก่อนหน้าไว้ใน context ของการสนทนาหรือ workflow เดียวกัน
- External memory บันทึกความรู้ไว้ภายนอก เช่น โน้ต ฐานข้อมูล หรือ key-value store แล้วดึงกลับมาใช้เมื่อต้องการ
- Parametric learning ปรับ weights ของ model ระหว่างใช้งาน เพื่อให้ความรู้อัปเดตเข้าไปในตัว model
สำหรับธุรกิจส่วนใหญ่ การเริ่มจาก context และ external memory เป็นทางเลือกที่จับต้องได้กว่า เพราะควบคุมง่าย ตรวจสอบได้ และไม่ต้องเปลี่ยน model โดยตรง ตัวอย่างเช่น AI ฝ่ายขายอาจเก็บคู่มือราคา กติกาส่วนลด และสรุปเหตุผลที่ลูกค้าปฏิเสธไว้ในฐานความรู้ที่อ้างอิงแหล่งข้อมูลได้
แต่มีข้อควรระวัง: การมี memory ไม่เท่ากับการเรียนรู้ ระบบอาจจำข้อมูลผิด จำข้อมูลเก่า หรือหยิบความจำที่ไม่เกี่ยวข้องมาใช้ ดังนั้น memory ต้องมีวงจรตรวจสอบ ไม่ใช่แค่สะสมโน้ตไปเรื่อยๆ
Step 3: ออกแบบการทดสอบที่ AI มีโอกาสเรียนรู้จริง
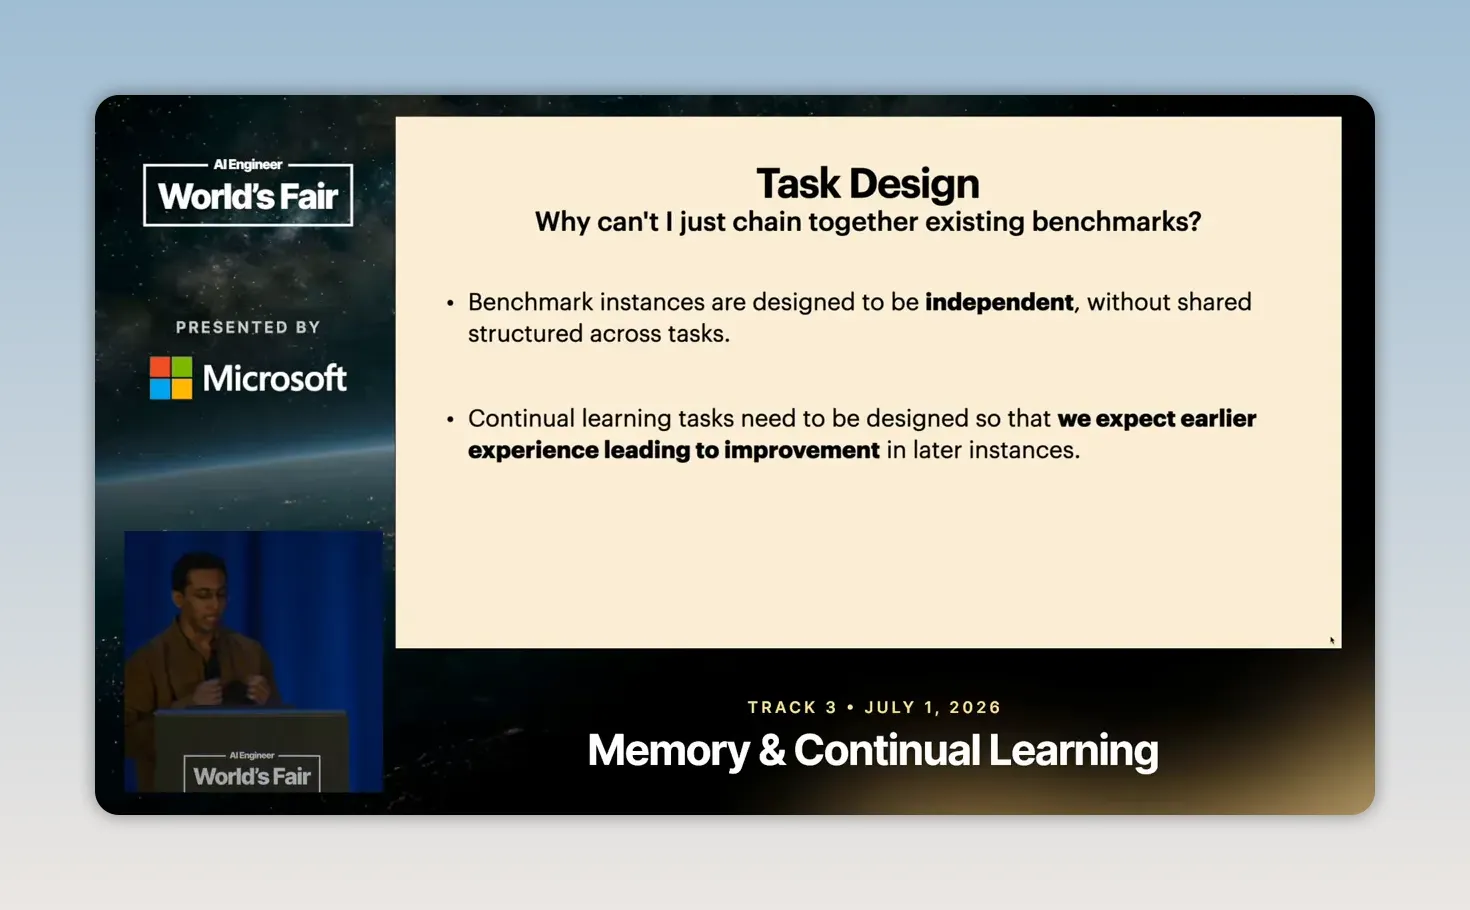
การนำ benchmark หลายชุดมาต่อกันเป็นลำดับไม่ได้ทำให้วัด continual learning ได้โดยอัตโนมัติ เหตุผลคือโจทย์ benchmark ทั่วไปถูกออกแบบให้เป็นอิสระต่อกัน ความรู้จากข้อแรกจึงแทบไม่ช่วยให้ข้อที่สิบทำได้ดีขึ้น
Continual Learning Bench เสนอเกณฑ์สำคัญสามข้อสำหรับสร้างงานทดสอบที่วัดการเรียนรู้ได้จริง
1. ต้องมีช่องว่างให้พัฒนา หรือ Headroom
โจทย์ต้องไม่เป็นสิ่งที่ model รู้คำตอบอยู่แล้วจากการ pre-training หาก AI ทำได้ดีด้วยความรู้เดิมตั้งแต่ต้น คะแนนที่สูงขึ้นไม่ได้บอกว่าระบบเรียนรู้จากประสบการณ์ระหว่างทาง
สำหรับธุรกิจไทย ตัวอย่างที่มี headroom คือข้อมูลเฉพาะบริษัท เช่น โครงสร้างราคาเฉพาะสาขา ระบบรหัสสินค้า กฎอนุมัติค่าใช้จ่าย หรือรูปแบบรายงานที่ไม่มีอยู่ทั่วไปบนอินเทอร์เน็ต
2. งานแต่ละรอบต้องมี shared structure
งานในลำดับต้องมีรูปแบบร่วมกัน เพื่อให้บทเรียนจากงานก่อนส่งผลต่องานหลังได้ เช่น คำถามต่อเนื่องบนฐานข้อมูลเดียวกัน หรือคำร้องเรียนลูกค้าที่มีหมวดปัญหาซ้ำๆ แม้รายละเอียดของแต่ละเคสจะต่างกัน
3. ต้องมีสัญญาณให้เรียนรู้
AI ต้องได้รับ feedback ที่ชัด เช่น คะแนนความถูกต้อง ข้อความ error คำแก้ไขจากพนักงาน หรือผลลัพธ์ทางธุรกิจอย่างยอดขายและเวลาที่ใช้จบงาน ถ้าไม่มีสัญญาณย้อนกลับ ระบบก็ไม่มีพื้นฐานที่จะรู้ว่าควรเปลี่ยนอะไร
Step 4: วัด Gain ไม่ใช่ดูแค่คะแนนรวม
ปัญหาของคะแนนสะสม หรือ cumulative reward คือมันแยกไม่ออกว่า AI ทำผลงานสูงเพราะเก่งอยู่แล้ว หรือเพราะเรียนรู้เก่งขึ้นจริง ระบบหนึ่งอาจได้คะแนนรวมสูงกว่าเพราะ model ตั้งต้นแข็งแรง แต่ไม่ได้ใช้ความจำหรือ feedback ให้เกิดประโยชน์เลย
แนวคิดที่สำคัญที่สุดในคลิปคือ metric ชื่อ Gain ซึ่งคำนวณจาก:
Gain = ผลลัพธ์เมื่อระบบเก็บ state ได้ − ผลลัพธ์เมื่อรีเซ็ตระบบทุกครั้ง
วิธีทดสอบคือรันระบบเดียวกันสองรอบ รอบแรกอนุญาตให้เก็บ context โน้ต และความจำข้ามงานได้ รอบที่สองล้าง state ทุกครั้งก่อนเริ่มงานใหม่ ส่วนต่างของผลลัพธ์บอกว่า ประสบการณ์ก่อนหน้าช่วยให้งานถัดไปดีขึ้นมากแค่ไหน
หากเอาไปใช้กับธุรกิจ เราไม่จำเป็นต้องสร้าง benchmark ระดับงานวิจัย แต่ทำการทดสอบแบบ A/B ได้ เช่น เปรียบเทียบ AI ตอบแชตที่ใช้ฐานความรู้และบันทึก feedback กับ AI ตัวเดียวกันที่ไม่มีความจำ แล้ววัด:
- เวลาที่ใช้ปิดเคส
- จำนวนครั้งที่พนักงานต้องแก้คำตอบ
- อัตราการส่งต่อให้เจ้าหน้าที่
- ความถูกต้องของการระบุสินค้า ราคา หรือนโยบาย
- ต้นทุน token ต่อเคส
มุมมองที่ควรย้ำคือ ไม่มีตัวเลขเดียวที่พอสำหรับตัดสินระบบ AI เราต้องดูอย่างน้อยสามมิติร่วมกัน ได้แก่ ผลลัพธ์จริง, Gain จากการเรียนรู้, และต้นทุน ระบบที่จำทุกอย่างอาจให้คำตอบดีขึ้น แต่ถ้า context ยาวเกินจนต้นทุนพุ่ง ก็อาจไม่คุ้มสำหรับงานจำนวนมาก
Step 5: ทดสอบ AI ด้วยงานที่เหมือนชีวิตจริงและมีการเปลี่ยนแปลง
ตัวอย่าง database exploration อธิบายภาพได้ชัดเจน AI ได้รับคำถามภาษาธรรมชาติ แล้วต้องใช้ SQL ค้นหาคำตอบจากฐานข้อมูลที่ไม่คุ้นเคย ช่วงแรกระบบอาจต้องลองหลาย query เพื่อทำความเข้าใจตาราง ความสัมพันธ์ของข้อมูล และรูปแบบข้อมูล
หากระบบเรียนรู้ได้จริง เมื่อทำถึงคำถามลำดับที่สิบ มันควรรู้แล้วว่าตารางไหนเชื่อมกันอย่างไร และใช้ query น้อยลงเพื่อหาคำตอบที่ถูกต้อง นี่วัดผลได้ทั้งความเร็วและต้นทุน
โจทย์ยากขึ้นเมื่อเกิด concept drift เช่น ฐานข้อมูลย้ายระบบ ชื่อคอลัมน์เปลี่ยน ตารางเก่าถูกลบ หรือรูปแบบข้อมูลไม่เหมือนเดิม ระบบที่ดีไม่ควรยึดความจำเดิมจนผิดซ้ำ แต่ก็ไม่ควรลืมทุกอย่างจนต้องเริ่มสำรวจใหม่ทั้งหมด
ธุรกิจไทยเจอ concept drift เป็นเรื่องปกติ เช่น การปรับราคา เปลี่ยนโปรโมชัน เปิดสาขาใหม่ เปลี่ยนขั้นตอนอนุมัติ หรืออัปเดตนโยบายคืนสินค้า ดังนั้น AI ที่เชื่อมกับข้อมูลภายในต้องมีวันที่อัปเดต แหล่งอ้างอิง และกติกาว่าเรื่องใดควรถูกแทนที่ ไม่ใช่พึ่ง “ความจำ” แบบไร้ที่มา
Step 6: เข้าใจจุดล้มเหลวระหว่างการจำกับการปรับตัว
Continual Learning Bench 1.0 ครอบคลุมหกโดเมน ได้แก่ การติดตามสเปกตรัมสัญญาณ การปรับ code base งานศึกษา cohort และระบาดวิทยา เกมโป๊กเกอร์เชิงกลยุทธ์ การสำรวจฐานข้อมูล และการคาดการณ์ยอดขาย งานเหล่านี้มีลำดับของประสบการณ์และเกณฑ์ reward ที่ชัดเจน
ผลแรกที่น่าสนใจคือ in-context learning แบบเรียบง่าย ทำผลงานนำระบบจัดการ context ที่ซับซ้อนกว่า ทั้งด้าน reward, gain และต้นทุนในชุดทดสอบนี้ ข้อสรุปเชิงธุรกิจจึงไม่ใช่ว่า “memory system ไม่จำเป็น” แต่คือ อย่าเพิ่ม architecture เพราะคิดว่าซับซ้อนแล้วต้องดีกว่า ต้องพิสูจน์กับงานของเราเอง
ความล้มเหลวมักอยู่ที่ปลายด้านใดด้านหนึ่งของ stability-plasticity trade-off
- พลาดด้าน stability: ระบบคาดการณ์ยอดขายสูงเกินไป ได้ feedback แล้วลดลงมากเกินไป แต่เมื่อได้รับ feedback รอบใหม่กลับกระโดดไปใช้ค่าคาดการณ์สูงเดิม แทนที่จะปรับไปหาจุดกลาง เพราะลืมบทเรียนรอบแรก
- พลาดด้าน plasticity: ระบบมี notepad แต่เจอข้อมูลใหม่ที่เกี่ยวข้องแล้วกลับตัดสินว่าเป็นข้อมูลจาก schema อื่น จึงไม่ยอมอัปเดตความเข้าใจ
บทเรียนสำหรับทีมงานคือ อย่าวัดแค่ว่า AI “จำได้” แต่ต้องวัดว่าเมื่อข้อมูลใหม่ขัดกับข้อมูลเดิม AI รู้หรือไม่ว่าควรเก็บ ปรับ หรือเลิกใช้ข้อมูลใด
Step 7: เริ่มสร้างวงจรเรียนรู้ของ AI ในงานธุรกิจ
แม้การปรับ weights แบบออนไลน์ยังเป็นเรื่องไกลตัวสำหรับองค์กรทั่วไป แต่เราสร้างวงจร continual learning ในระดับ workflow ได้ตั้งแต่วันนี้ โดยให้คนและระบบช่วยกันคัดกรองความรู้ใหม่
Actionable Insights
- เริ่มจากงานซ้ำที่มี feedback: เลือกงานเดียว เช่น ตอบคำถามลูกค้า สรุปใบเสนอราคา หรือวิเคราะห์ยอดขาย อย่าเริ่มจาก agent ที่ทำทุกอย่าง
- สร้าง baseline แบบไม่มี memory: เก็บตัวเลขก่อนเปิดใช้ knowledge base หรือ feedback loop เพื่อวัด Gain ของระบบใหม่ได้จริง
- กำหนด reward ที่ธุรกิจเข้าใจ: ใช้เวลาปิดเคส อัตราแก้งาน ความถูกต้อง หรือต้นทุนต่อธุรกรรม แทนคะแนนเชิงเทคนิคที่ทีมธุรกิจใช้ตัดสินใจไม่ได้
- แยกความรู้ถาวรจากความรู้ชั่วคราว: นโยบายบริษัทและคู่มือสินค้าเก็บเป็นแหล่งกลาง ส่วนโน้ตจากเคสล่าสุดควรมีวันหมดอายุหรือผู้รับผิดชอบตรวจทาน
- บันทึก feedback ให้เป็นโครงสร้าง: แทนที่จะเขียนว่า “ตอบไม่ดี” ให้ระบุประเภทข้อผิดพลาด คำตอบที่ถูก และแหล่งข้อมูลอ้างอิง
Step 8: แก้ปัญหาที่มักเจอเมื่อให้ AI เรียนรู้จากงานจริง
ปัญหา: AI จำคำตอบเก่าและตอบผิดหลังมีนโยบายใหม่
สาเหตุ: ความรู้เก่าและความรู้ใหม่ถูกเก็บปนกัน ไม่มีลำดับความสำคัญหรือวันอัปเดต
วิธีแก้:
- กำหนดเจ้าของข้อมูลของแต่ละหมวด
- ใส่วันที่มีผลและวันที่ทบทวนในทุกเอกสาร
- ให้ระบบเลือกข้อมูลเวอร์ชันล่าสุดก่อน
- ทดสอบด้วยคำถามที่นโยบายเพิ่งเปลี่ยนทุกครั้งหลังอัปเดต
ปัญหา: AI มีโน้ตเยอะ แต่ผลงานไม่ดีขึ้น
สาเหตุ: ระบบเก็บข้อมูลโดยไม่คัดว่าอะไรนำไปใช้กับงานถัดไปได้ หรือดึงความจำผิดเรื่อง
วิธีแก้:
- จำกัดโน้ตให้เก็บเฉพาะกฎ ข้อยกเว้น และ feedback ที่ยืนยันแล้ว
- ติดป้ายหมวดงาน สินค้า สาขา และระดับความน่าเชื่อถือ
- ตรวจตัวอย่างที่ AI อ้างอิงความจำผิด แล้วปรับกติกาการค้นหา
ปัญหา: ตัวเลขผลลัพธ์ดี แต่ไม่รู้ว่าเกิดจาก memory หรือ model เก่งอยู่แล้ว
สาเหตุ: วัดเฉพาะผลลัพธ์รวม ไม่มี baseline เปรียบเทียบ
วิธีแก้:
- ใช้ model และ prompt เดียวกัน
- รันชุดงานหนึ่งรอบโดยให้เก็บ state
- รันอีกครั้งโดยรีเซ็ต state ทุกเคส
- เปรียบเทียบความต่างของคุณภาพ เวลา และต้นทุนในรูปแบบ Gain
ปัญหา: AI ปรับตาม feedback ล่าสุดมากเกินไป
สาเหตุ: ระบบขาด stability และให้น้ำหนักกับข้อมูลล่าสุดโดยไม่พิจารณาประวัติ
วิธีแก้:
- บังคับให้ AI สรุปหลักฐานเดิมและข้อมูลใหม่ก่อนตอบ
- ตั้งเกณฑ์ว่าต้องมี feedback ซ้ำกี่ครั้งจึงเปลี่ยนกฎถาวร
- ให้คนอนุมัติเมื่อเป็นนโยบาย ราคา หรือคำตอบที่กระทบลูกค้า
Step 9: ต่อยอดจาก AI ที่ตอบเก่ง ไปสู่ AI ที่พัฒนา workflow ของเรา
- สร้าง dashboard การเรียนรู้: แสดงความถูกต้อง เวลาทำงาน ต้นทุน และ Gain แยกตามทีม สาขา หรือประเภทเคส
- ทำคลัง feedback กลาง: รวบรวมคำแก้ไขจากฝ่ายขาย ฝ่ายบริการลูกค้า และฝ่ายปฏิบัติการให้กลายเป็นฐานความรู้ที่ตรวจสอบได้
- ทดสอบ concept drift รายเดือน: สร้างชุดคำถามจากนโยบายใหม่ สินค้าใหม่ และเคสผิดปกติ เพื่อดูว่า AI ปรับตัวได้โดยไม่ลืมเรื่องสำคัญหรือไม่
ในระยะยาว แนวคิดของ Parth Asawa ชวนให้เราตั้งคำถามกับวิธีสร้าง AI ทั้งระบบ เพราะ model ส่วนใหญ่ถูกฝึกมาให้เก่งก่อน แล้วค่อยหาทางติด memory ภายหลัง หาก continual learning เป็นข้อกำหนดตั้งแต่ต้น รูปแบบการฝึกและการใช้งานอาจต่างจากที่คุ้นเคยมาก
สำหรับธุรกิจ สิ่งที่ทำได้ทันทีไม่ใช่รอ model รุ่นใหม่ แต่คือออกแบบ workflow ให้มี feedback ที่ดี มีข้อมูลที่อัปเดต และมีวิธีพิสูจน์ว่าระบบดีขึ้นจากประสบการณ์จริง ไม่ใช่แค่ดูคะแนนบน leaderboard
Step 10: สรุป Checklist ทั้งหมด
- ☐ ระบุงานซ้ำที่ AI ควรทำได้ดีขึ้นตามเวลา
- ☐ กำหนดผลลัพธ์ที่วัดได้ เช่น เวลา ความถูกต้อง ต้นทุน หรืออัตราแก้งาน
- ☐ ตรวจว่างานมี shared structure ให้บทเรียนเดิมช่วยงานใหม่ได้
- ☐ เตรียม feedback ที่ชัดเจนจากผลลัพธ์จริงหรือพนักงาน
- ☐ แยกข้อมูลเฉพาะบริษัทที่ AI ต้องเรียนรู้จากความรู้ทั่วไปของ model
- ☐ สร้าง baseline โดยรัน workflow แบบไม่มี memory
- ☐ วัด Gain จากความต่างระหว่างระบบมี state และระบบที่รีเซ็ตทุกครั้ง
- ☐ วัดผลลัพธ์, Gain และต้นทุนร่วมกัน
- ☐ ตั้งกติกาอัปเดต ลบ และตรวจสอบความรู้เก่า
- ☐ ทดสอบ AI เมื่อเกิด concept drift เช่น ราคา นโยบาย หรือ schema เปลี่ยน
- ☐ ตรวจทั้ง stability ว่าระบบไม่ลืม และ plasticity ว่าระบบยอมรับข้อมูลใหม่
สรุป: AI ที่เหมาะกับงานธุรกิจไม่ควรถูกตัดสินจากความสามารถในคำถามเดียว แต่จากความสามารถในการทำงานลำดับต่อเนื่อง เก็บบทเรียนที่ถูกต้อง ปรับเมื่อโลกเปลี่ยน และทำทั้งหมดด้วยต้นทุนที่สมเหตุสมผล นั่นคือมาตรฐานที่ทำให้ continual learning มีความหมายต่อการใช้ AI จริงในองค์กร