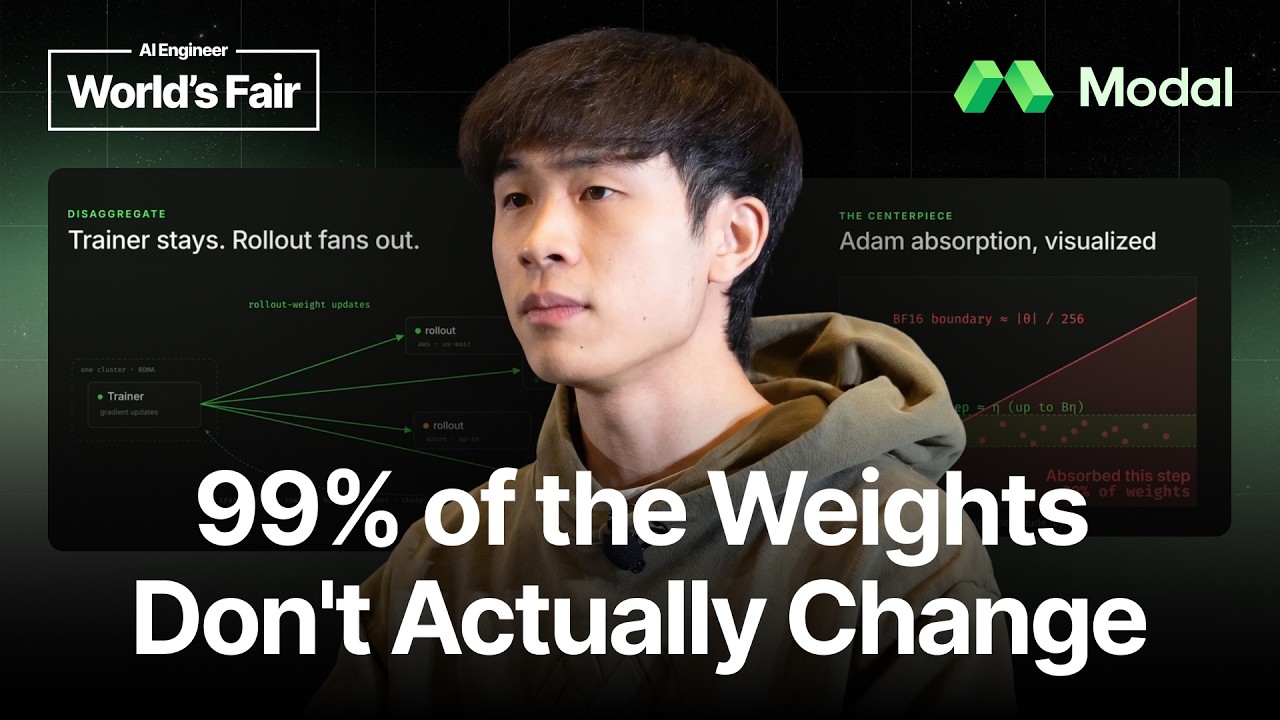
เรียบเรียงจากการบรรยายของ Nan Jiang จาก Modal บนช่อง AI Engineer และบทความ VideoToBlog วันที่2026-08-10 ตัวเลขขนาด checkpoint, patch และสัดส่วนน้ำหนักที่เปลี่ยนเป็นผลที่ผู้บรรยายรายงานในเงื่อนไขของตน ไม่ใช่ผลทดสอบอิสระหรือการรับประกันต้นทุนที่ลดลงสำหรับทุกระบบ ตัวอย่างธุรกิจไทยเป็นการประยุกต์จากบทความต้นฉบับ · วิดีโอต้นทาง
ข้อจำกัดของการพัฒนา AI ระดับสูงไม่ได้อยู่ที่ว่าโลกมี GPU มากพอหรือไม่ แต่อยู่ที่ว่า GPU เหล่านั้นอยู่คนละภูมิภาค คนละผู้ให้บริการ และไม่พร้อมรวมตัวกันในคลัสเตอร์เดียวในเวลาที่ต้องใช้
คลิปจากช่อง AI Engineer ซึ่งนำเสนอโดย Nan Jiang จาก Modal เสนอแนวคิดที่น่าสนใจมากสำหรับงาน Reinforcement Learning หรือ RL post-training: แทนที่จะย้ายโมเดลทั้งก้อนขนาดราว 500 GB ไปยัง GPU ที่อยู่ทั่วโลก เราอาจส่งเฉพาะส่วนของน้ำหนักโมเดลที่เปลี่ยนไป ซึ่งมีขนาดราว 500 MB แล้วประกอบกลับให้เหมือนเดิมทุกบิตได้
แม้แนวคิดนี้จะดูเป็นเรื่องโครงสร้างพื้นฐานสำหรับทีม AI ขนาดใหญ่ แต่บทเรียนสำคัญสำหรับเจ้าของธุรกิจไทยคือ อย่าผูกทุกงานเข้ากับทรัพยากรที่แพงที่สุด งานแต่ละส่วนต้องการความเร็ว ความแม่นยำ และการเชื่อมต่อไม่เท่ากัน หากแยกงานให้ถูก จุดคอขวดด้านต้นทุนและกำลังประมวลผลอาจลดลงมาก
สารบัญ
- Step 1: แยกให้ออกว่างาน AI ส่วนไหนต้องอยู่รวมกัน
- Step 2: มองหาเงื่อนไขที่ทำให้ GPU กลายเป็นทรัพยากรหายาก
- Step 3: เปลี่ยนหน่วยที่ส่งจาก checkpoint ทั้งก้อนเป็น patch ที่เปลี่ยนจริง
- Step 4: เข้าใจ Adam absorption ว่าทำไม 99% ของน้ำหนักที่เห็นจึงไม่เปลี่ยน
- Step 5: สร้างระบบ version-aware ก่อนกระจายงานไปหลายภูมิภาค
- Step 6: แปลงแนวคิดนี้เป็น Actionable Insights สำหรับธุรกิจ
- Step 7: แก้ปัญหาที่พบบ่อยก่อนระบบ AI จะซับซ้อนเกินควบคุม
- Step 8: ต่อยอดจากการลดขนาดไฟล์สู่ AI workflow ที่ยืดหยุ่น
- Step 9: สรุป Checklist ทั้งหมด
Step 1: แยกให้ออกว่างาน AI ส่วนไหนต้องอยู่รวมกัน
ในวงจร RL post-training มีงานหลักสองฝั่ง ฝั่งแรกคือ trainer ซึ่งรับผิดชอบการปรับน้ำหนักของ model ผ่านการคำนวณหนัก เช่น backpropagation และการสื่อสารระหว่าง GPU จำนวนมาก อีกฝั่งคือ rollout หรือการให้ model ลองตอบคำถาม ใช้เครื่องมือ ทำงานใน environment และส่งผลลัพธ์กลับมาเพื่อประเมินรางวัล
ระบบแบบดั้งเดิมมักวางทั้งสองฝั่งไว้ในคลัสเตอร์เดียวกัน เพื่อให้ส่งน้ำหนัก model ระหว่างกันได้เร็วผ่านเครือข่ายความเร็วสูง เช่น RDMA ปัญหาคือ rollout มักต้องการ GPU เพิ่มขึ้นแบบผันผวน แต่จำนวน GPU ในคลัสเตอร์ฝึกถูกกำหนดไว้ล่วงหน้าและขยายได้ยาก
Nan Jiang เปรียบเทียบภาพนี้เป็นสองโลก โลกแรกคือคลัสเตอร์ขนาดใหญ่ที่เชื่อมต่อแน่นหนา เหมือนมหาวิหารที่สร้างอย่างเป็นระบบ โลกที่สองคือ GPU ที่กระจัดกระจายอยู่ตาม cloud และผู้ให้บริการหลายราย เหมือนตลาดขนาดใหญ่ที่มีของอยู่มาก แต่ไม่ได้อยู่ในที่เดียวกัน
สำหรับงานฝึก model ส่วนที่ต้องอยู่ในคลัสเตอร์เดียวคือ trainer เพราะต้องใช้การสื่อสารระหว่าง GPU อย่างต่อเนื่องและหนาแน่น แต่ rollout ไม่ได้ต้องทำ all-reduce ร่วมกันทั่วโลก แต่ละ rollout island เพียงรับ policy version เดียวกัน แล้วส่ง trajectory พร้อม metadata กลับมา
นี่คือหลักคิดที่นำไปใช้กับธุรกิจไทยได้ทันที: งานที่ต้องใช้ข้อมูลลับ การตัดสินใจสำคัญ หรือฐานข้อมูลกลางอาจต้องอยู่ในระบบที่ควบคุมได้ ส่วนงานที่แยกกันได้ เช่น สร้างข้อความสรุปเอกสาร จัดหมวดหมู่ ticket หรือทดสอบ prompt จำนวนมาก สามารถกระจายไปยังทรัพยากรที่ยืดหยุ่นกว่าได้
Step 2: มองหาเงื่อนไขที่ทำให้ GPU กลายเป็นทรัพยากรหายาก
การได้ GPU จำนวนมากสำหรับงาน RL ไม่ใช่แค่เรื่องจำนวนเครื่อง ระบบต้องได้ครบสี่เงื่อนไขพร้อมกัน ได้แก่ GPU เพียงพอ อยู่ภูมิภาคเดียวกัน มีเครือข่ายเชื่อมต่อความเร็วสูง และว่างในเวลาที่ต้องการ
แต่ละเงื่อนไขไม่ยากนักเมื่อพิจารณาแยกกัน ปัญหาเกิดขึ้นเมื่อระบบต้องได้ทุกอย่างพร้อมกัน นี่ทำให้ทีม AI อาจมี budget แต่เริ่มงานไม่ได้ เพราะหาคลัสเตอร์ตามสเปกไม่ทัน หรือเริ่มได้แต่ขยาย rollout ไม่ได้ระหว่างทาง
มุมมองที่น่าสนใจคือ capacity สำหรับ inference ยืดหยุ่นกว่า capacity สำหรับ training มาก GPU สำหรับ serving อาจว่างอยู่ตาม region ต่าง ๆ แต่ไม่เหมาะกับการฝึกที่ต้องประสานงานระดับต่ำตลอดเวลา
สำหรับองค์กรไทย นี่สะท้อนความต่างระหว่างการ “ซื้อโครงสร้างพื้นฐาน” กับการ “ออกแบบ workflow” หากโจทย์คือสร้าง AI assistant ภายในบริษัท ไม่จำเป็นต้องพยายามทำทุกส่วนบน cloud เดียวหรือ model เดียวตั้งแต่ต้น ควรวางก่อนว่างานใดต้องตอบทันที งานใดทำแบบ batch ได้ และงานใดอาจรอคิวเมื่อ GPU ราคาถูกลง
Step 3: เปลี่ยนหน่วยที่ส่งจาก checkpoint ทั้งก้อนเป็น patch ที่เปลี่ยนจริง
อุปสรรคใหญ่ของการกระจาย rollout ไปหลายดาต้าเซ็นเตอร์คือการอัปเดตน้ำหนัก model ทุกครั้ง หลัง trainer ปรับ model แล้ว rollout ต้องใช้ version ใหม่เพื่อให้ผลลัพธ์สอดคล้องกัน
หากส่ง full checkpoint ขนาด 500 GB ผ่านเครือข่ายทั่วไป การอัปเดตอาจใช้เวลาหลายนาทีหรือหลายชั่วโมง ซึ่งทำให้การฝึกแบบต่อเนื่องสะดุดทันที การบีบอัดไฟล์อย่างเดียวไม่พอ เพราะขนาดตั้งต้นใหญ่เกินไป
ข้อเสนอคือเลิกถามว่า “จะส่ง checkpoint ให้เร็วขึ้นได้อย่างไร” แล้วเปลี่ยนคำถามเป็น “มีน้ำหนักส่วนไหนเปลี่ยนในมุมที่ rollout มองเห็นจริงบ้าง” หากเปลี่ยนน้อย ก็ส่งแค่ตำแหน่งที่เปลี่ยนและค่าที่ต้องแทนที่
จุดสำคัญคือ patch นี้ไม่ใช่ delta แบบบวกค่าทศนิยมเพิ่มเข้าไป เพราะการบวกซ้ำหลายครั้งอาจสะสมความคลาดเคลื่อน ระบบใช้การแทนค่าที่ตำแหน่งเฉพาะ หรือการเข้ารหัสระดับบิต เช่น XOR เพื่อให้ rollout engine สร้างน้ำหนัก version เดียวกับ checkpoint เต็มได้แบบ bitwise identical
หลักคิดเชิงธุรกิจคือ เมื่อข้อมูลหรือเอกสารมีขนาดใหญ่ อย่าส่งของทั้งหมดทุกครั้งโดยอัตโนมัติ ตัวอย่างเช่น ระบบจัดการเอกสารบริษัทไม่ควรส่ง knowledge base ทั้งก้อนให้ AI ประมวลผลใหม่ทุกครั้งที่แก้ไขนโยบายหนึ่งบรรทัด ควรใช้ versioning และส่งเฉพาะส่วนที่เปลี่ยน โดยต้องมีวิธีตรวจว่าปลายทางประกอบข้อมูลได้ถูกต้อง
Step 4: เข้าใจ Adam absorption ว่าทำไม 99% ของน้ำหนักที่เห็นจึงไม่เปลี่ยน
คำอธิบายเรื่องนี้ไม่ใช่ว่า gradient ของ model มีน้อย ตรงกันข้าม การวัดพบว่า gradient หนาแน่นมาก ประมาณ 99% ของพารามิเตอร์มี gradient ที่ไม่เป็นศูนย์ และน้ำหนัก master ใน FP32 ก็ถูกอัปเดตอย่างกว้างขวางเช่นกัน
สิ่งที่เปลี่ยนน้อยคือ น้ำหนักในรูปแบบที่ rollout engine ใช้เสิร์ฟจริง เช่น BF16, FP8 หรือ NVFP4 ซึ่งเป็นรูปแบบตัวเลขความละเอียดต่ำกว่าน้ำหนัก master ที่ optimizer เก็บไว้
ลองนึกถึงตัวเลขแบบ BF16 ว่าเป็นขั้นบันได น้ำหนักจะเปลี่ยนค่าที่ rollout มองเห็นได้ ก็ต่อเมื่อการอัปเดตขยับข้ามขอบของขั้นบันไดนั้น ในบริเวณที่น้ำหนักมีค่าราว 1 ระยะถึงจุดเปลี่ยนที่ใกล้ที่สุดอยู่ประมาณ 0.0039 แต่ Adam step สำหรับ RL post-training อาจอยู่ราว 0.000003 เล็กกว่ามากกว่าพันเท่า
น้ำหนัก master จึงขยับอยู่จริง แต่ยังไม่มากพอให้ค่าหลังแปลงเป็น BF16 เปลี่ยน เหตุการณ์นี้เรียกว่า Adam absorption คือการเปลี่ยนแปลงขนาดเล็กถูกกลืนโดยข้อจำกัดความละเอียดของ format ที่ใช้เสิร์ฟ
ผลการวัดในหลาย model พบว่าน้ำหนักที่ rollout เห็นราว 99% ยังเหมือนเดิมในแต่ละ step สำหรับการรันภายในที่เสิร์ฟ GLM 4.7 Air ด้วย FP8 มีน้ำหนักเปลี่ยนเพียง 0.15% ในช่วงแรก และลดลงจนทรงตัวใกล้ 0.05% ต่อ step
อย่างไรก็ดี เราไม่ควรตีความว่านี่เป็นกฎตายตัวกับทุก model ทุก optimizer และทุกการตั้งค่า ผู้บรรยายเองตั้งคำถามต่อว่า หากใช้ optimizer อย่าง Muon แทน Adam ความเบาบางของ patch จะยังอยู่หรือไม่ นี่คือข้อจำกัดที่ทีมเทคนิคต้องวัดจากงานจริง ไม่ใช่คาดเดาจากตัวเลขตัวอย่าง
Step 5: สร้างระบบ version-aware ก่อนกระจายงานไปหลายภูมิภาค
เมื่อ patch มีขนาดเล็กพอ สถาปัตยกรรมใหม่จึงเป็นไปได้ trainer อยู่ในคลัสเตอร์ RDMA เพื่อทำงานฝึกหนักต่อไป แต่ rollout engines กระจายไปยัง cloud, region หรือผู้ให้บริการที่มี GPU ว่างได้
trainer จะเผยแพร่ rollout weight version ไปยังพื้นที่กลางคล้าย bulletin board จากนั้น rollout engine แต่ละแห่งดึง version ที่ต้องการมาประกอบไว้ใน storage ของตัวเอง แล้วใช้เสิร์ฟงานต่อ ระบบต้องระบุ version ชัดเจนทั้งขา request และ response เพื่อให้ trainer รู้ว่า trajectory นั้นสร้างโดย policy version ใด
อีกชิ้นที่ขาดไม่ได้คือ sidecar ซึ่งทำหน้าที่ทำให้ rollout engine รู้จัก version หาก engine มี version ที่ระบบยอมรับอยู่แล้ว ก็ส่งงานต่อได้ทันที หากตามหลังแต่ยังไล่ patch ทัน ก็อัปเดตก่อนทำงาน หากตามไม่ทัน ระบบควรตอบว่าไม่พร้อม แทนที่จะปล่อยให้ส่งผลลัพธ์จาก model คนละ version ปะปนกัน
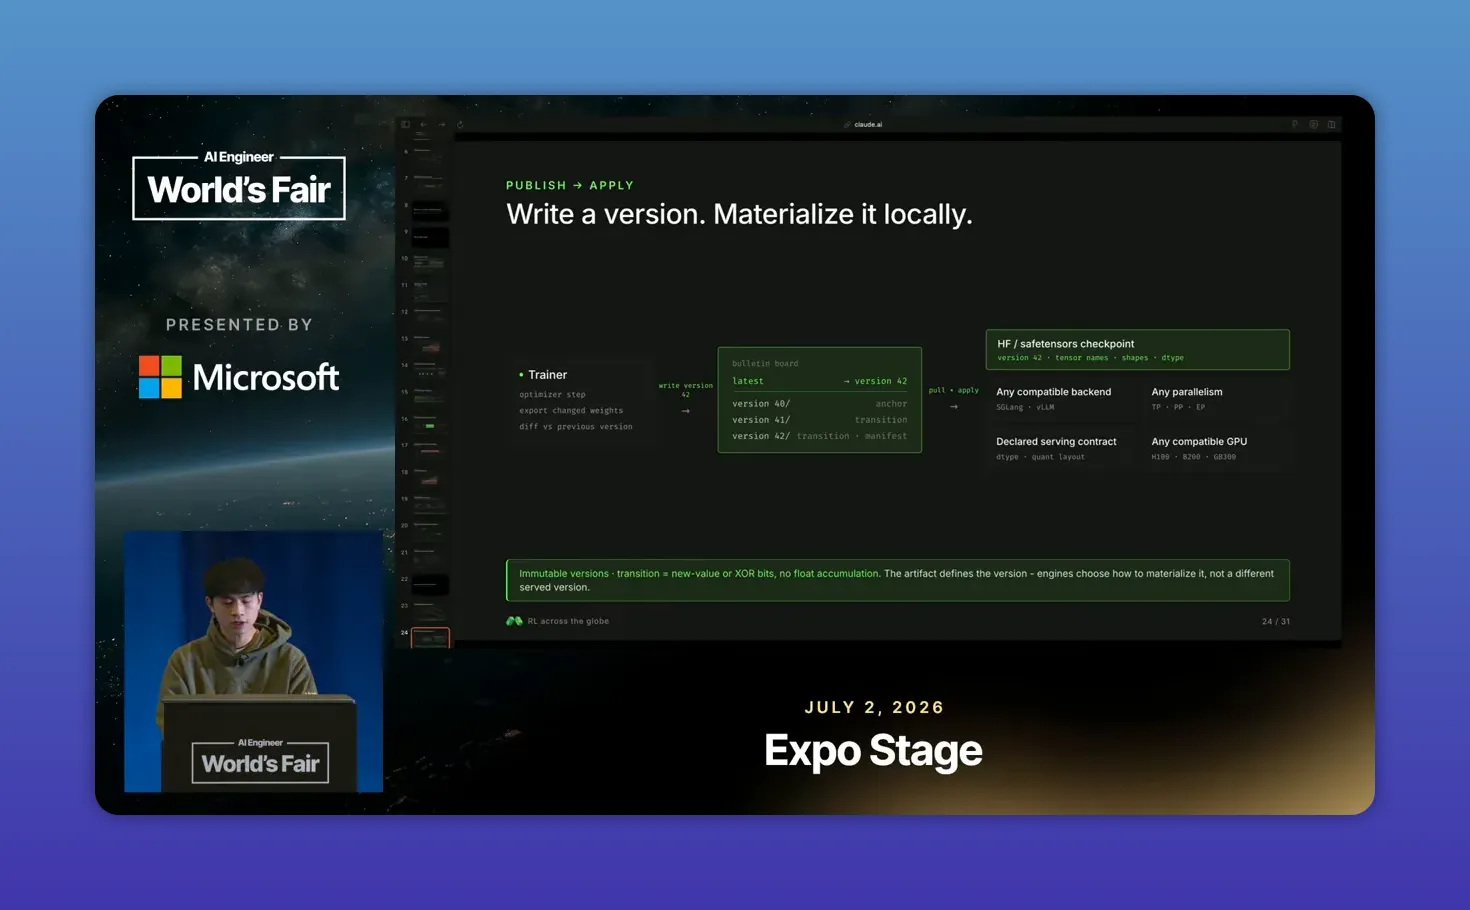
Modal เรียก implementation ของแนวคิดนี้ว่า Stitch โดยออกแบบให้ไม่ยึดติดกับ trainer, engine หรือวิธีขนส่งเพียงแบบเดียว เป้าหมายคือเปลี่ยน GPU สำหรับ inference ที่กระจัดกระจายให้กลายเป็น rollout fleet เดียวที่ขยายและลดขนาดได้ตามงาน
มุมมองของเราคือธุรกิจส่วนใหญ่ยังไม่ต้องสร้างระบบระดับ Stitch แต่ควรนำหลักการ version-aware ไปใช้กับ AI workflow ตั้งแต่ตอนนี้ โดยเฉพาะองค์กรที่มีหลายทีม หลาย prompt หลาย knowledge base หรือใช้หลาย model เพราะความผิดพลาดที่เกิดจาก version ไม่ตรงกัน มักแพงกว่าค่า API เสียอีก
Step 6: แปลงแนวคิดนี้เป็น Actionable Insights สำหรับธุรกิจ
- แยกงาน AI เป็นงานแกนกลางและงานกระจายได้: เก็บข้อมูลสำคัญ การอนุมัติ และฐานความรู้กลางไว้ในระบบหลัก แล้วแยกงานสร้างร่างข้อความ สรุปข้อมูล หรือประเมินจำนวนมากออกไปเป็นคิวงาน
- ใช้ version กับทุกสิ่งที่ AI แตะ: กำหนด version ให้ prompt, policy, knowledge base และ model เพื่อย้อนตรวจได้ว่าคำตอบแต่ละครั้งมาจากชุดข้อมูลใด
- ส่งเฉพาะสิ่งที่เปลี่ยน: ออกแบบการ sync เอกสาร ผลิตภัณฑ์ และข้อมูลลูกค้าแบบ incremental แทนการคัดลอกฐานข้อมูลหรือไฟล์เต็มซ้ำทุกครั้ง
- วัดคอขวดก่อนเพิ่ม budget: แยกให้ชัดว่าระบบช้าเพราะ GPU, เครือข่าย, การโหลดข้อมูล หรือขั้นตอนอนุมัติภายใน แล้วลงทุนที่ต้นเหตุ
- เริ่มจากงานที่ยอมรับความล่าช้าได้: งาน batch เช่น วิเคราะห์รีวิว สรุปรายงาน และจัดหมวดเอกสาร เหมาะกับการทดลองระบบกระจายมากกว่างานที่ต้องตอบลูกค้าแบบทันที
Step 7: แก้ปัญหาที่พบบ่อยก่อนระบบ AI จะซับซ้อนเกินควบคุม
ปัญหา: ผลลัพธ์จาก AI ไม่สม่ำเสมอ ทั้งที่ใช้คำสั่งเดิม
สาเหตุ: model, prompt หรือ knowledge base คนละ version ถูกใช้สลับกันโดยไม่มีบันทึก
วิธีแก้:
- กำหนดรหัส version ให้ model, prompt และแหล่งข้อมูล
- บันทึก version ไว้พร้อมทุกผลลัพธ์ที่สำคัญ
- กำหนดว่า version ใดใช้งานจริง และ version ใดเป็นการทดลอง
ปัญหา: ค่าใช้จ่าย AI โตเร็วเมื่อปริมาณงานเพิ่ม
สาเหตุ: ระบบประมวลผลข้อมูลเดิมซ้ำทั้งหมด หรือใช้ model ราคาแพงกับทุกงาน
วิธีแก้:
- ตรวจว่างานใดเปลี่ยนข้อมูลจริง และงานใดเป็นการประมวลผลซ้ำ
- ทำ cache สำหรับคำตอบหรือผลลัพธ์ที่ใช้ซ้ำได้
- เลือก model ขนาดเหมาะกับงาน ไม่ใช้ model ใหญ่สุดเป็นค่าเริ่มต้น
ปัญหา: ทีมงานเชื่อผลลัพธ์จาก AI ทั้งที่ข้อมูลอาจเก่า
สาเหตุ: ไม่มีสถานะความพร้อมของข้อมูลหรือเวอร์ชันที่ AI ใช้อยู่
วิธีแก้:
- แสดงวันที่อัปเดตและแหล่งที่มาของข้อมูลในระบบภายใน
- ตั้งกติกาว่างานสำคัญต้องหยุดเมื่อข้อมูลยัง sync ไม่ครบ
- มีขั้นตอนอนุมัติโดยคนสำหรับคำตอบที่กระทบลูกค้า การเงิน หรือกฎหมาย
ปัญหา: อยากกระจายงานไปหลาย provider แต่กังวลเรื่องข้อมูล
สาเหตุ: การแยก workload ทำโดยไม่มีชั้นแบ่งข้อมูลและสิทธิ์เข้าถึง
วิธีแก้:
- แยกข้อมูลระบุตัวบุคคลและข้อมูลลับออกจากงานที่ส่งภายนอก
- ส่งเฉพาะข้อมูลขั้นต่ำที่จำเป็นต่อการทำงาน
- กำหนด audit log และข้อตกลงการจัดการข้อมูลกับ provider ให้ชัด
Step 8: ต่อยอดจากการลดขนาดไฟล์สู่ AI workflow ที่ยืดหยุ่น
แนวคิดแรก: สร้างศูนย์กลาง version สำหรับองค์ความรู้บริษัท ไม่ว่าจะเป็นคู่มือสินค้า ราคา นโยบาย หรือคำตอบฝ่ายขาย แล้วให้ AI ทุกช่องทางดึงข้อมูลจากจุดเดียว ลดปัญหาพนักงานและ chatbot ใช้ข้อมูลคนละชุด
แนวคิดที่สอง: จัดคิวงาน AI ตามระดับความเร่งด่วน งานลูกค้าหน้าร้านส่งเข้าระบบตอบเร็ว งานสรุปรายงานรายวันหรือวิเคราะห์ยอดขายส่งไปทำในช่วงที่ต้นทุนต่ำกว่า
แนวคิดที่สาม: วัด “การเปลี่ยนแปลงจริง” ของข้อมูลก่อนออกแบบระบบใหม่ หาก catalog สินค้าเปลี่ยนเพียง 2% ต่อวัน ก็ไม่จำเป็นต้องสร้าง embedding หรือดัชนีใหม่ทั้งก้อนทุกคืน
สาระสำคัญของคลิปนี้จึงไม่ใช่เพียงเทคนิค RL ข้ามดาต้าเซ็นเตอร์ แต่คือการเลิกคิดว่า “ทุกส่วนของระบบต้องขยับพร้อมกัน” เมื่อเราแยกส่วนที่ต้องเชื่อมกันแน่นออกจากส่วนที่ทำงานอิสระได้ ทรัพยากรที่เคยกระจัดกระจายก็กลายเป็นกำลังผลิตของธุรกิจได้มากขึ้น
Step 9: สรุป Checklist ทั้งหมด
- ☐ แยกงาน AI ที่ต้องอยู่ในระบบกลางออกจากงานที่กระจายได้
- ☐ ระบุคอขวดจริงว่าเกิดจาก GPU, เครือข่าย, ข้อมูล หรือขั้นตอนคน
- ☐ หยุดส่งไฟล์หรือข้อมูลทั้งก้อนเมื่อเปลี่ยนเพียงบางส่วน
- ☐ กำหนด version ให้ model, prompt, knowledge base และผลลัพธ์
- ☐ ตั้งสถานะพร้อมใช้งานก่อนให้ระบบรับงานสำคัญ
- ☐ ใช้ cache และการประมวลผลแบบ incremental เพื่อลดต้นทุน
- ☐ เริ่มทดลองกับงาน batch ที่ความเสี่ยงต่ำก่อน
- ☐ วางมาตรการข้อมูลและ audit log ก่อนใช้หลาย provider
- ☐ วัดผลจากต้นทุน เวลา และความถูกต้อง ไม่ใช่ดูแค่จำนวนคำตอบที่ AI สร้างได้