บันทึกจากวิดีโอต้นทาง: บทความนี้ถ่ายทอดคำอธิบายและข้อเสนอทดลองจากคลิปของช่อง Julian Goldie SEO ซึ่งผู้บรรยายแนะนำตัวว่าเป็นอวตารดิจิทัลของ Julian Goldie ข้อมูลชื่อรุ่น การเปิดตัว ความเร็ว และ benchmark เป็นคำกล่าวในคลิป ยังไม่ได้ตรวจยืนยันกับเอกสารทางการหรือทดสอบซ้ำ วันที่ 1 ตุลาคม 2026 เป็นวันที่ในรายการบทความต้นทาง ไม่ใช่วันที่เผยแพร่วิดีโอที่ยืนยันแล้ว
AI ที่ตอบเร็วขึ้นไม่ได้แปลว่างานเสร็จเร็วขึ้นเสมอไป หากยังต้องสั่งซ้ำ ตรวจใหม่ และแก้ผลลัพธ์หลายรอบ สิ่งที่ธุรกิจควรสนใจจึงไม่ใช่แค่ความเร็วในการแสดงคำตอบ แต่คือเวลาตั้งแต่เริ่มมอบหมายงานจนได้ชิ้นงานที่นำไปใช้ต่อได้
คลิปจากช่อง Julian Goldie SEO เล่าถึง Claude Sonnet 5.5 และเสนอแนวทางทดลองผ่านงานเขียนโค้ด หน้าเว็บไซต์ แดชบอร์ด SEO และเอกสารธุรกิจ พร้อมชี้ว่าการใช้เครื่องมือหลายอย่างโดยลดรอบการรออาจสำคัญกว่าความเร็วในการพิมพ์คำตอบ บทความต้นทางแปลงแนวคิดเหล่านั้นเป็นขั้นตอนสำหรับเจ้าของธุรกิจและคนทำงานที่อยากทดลอง AI กับงานจริง โดยแยกให้ชัดระหว่างตัวเลขที่คลิปนำเสนอ กับผลลัพธ์ที่เรายังต้องพิสูจน์ในงานของตัวเอง
เลือกงานให้ตรงกับจุดแข็งของ Claude Sonnet 5.5
คลิปวางตำแหน่ง Sonnet 5.5 เป็น model สำหรับงานประจำที่ต้องเดินหน้าเร็ว เช่น จัดการเอกสาร สร้างสไลด์ ทำตาราง วิเคราะห์งาน SEO และช่วยสร้างหรือแก้เครื่องมือขนาดเล็ก ส่วน Opus 5.5 ถูกอธิบายว่าเหมาะกับงานปลายเปิดที่ต้องใช้ดุลยพินิจมากกว่า
สำหรับธุรกิจไทย จุดเริ่มต้นที่เหมาะไม่ใช่การถามว่า model ไหนเก่งที่สุด แต่คือ งานไหนกินเวลาทีมซ้ำๆ และมีเกณฑ์ตรวจผลชัดเจน การร่างหน้าเสนอขาย การจัดแผนคอนเทนต์หนึ่งสัปดาห์ หรือการสรุปข้อมูลลูกค้าเป็นตัวเลือกที่ดีกว่าการให้ AI ตัดสินใจเรื่องสำคัญแทนคนทันที
คลิประบุว่า Anthropic อ้างว่า Sonnet 5.5 สร้างคำตอบเร็วกว่า Sonnet 5 มากกว่า 30% แต่ตัวเลขนี้ไม่ใช่คำรับประกันว่าทุกงานจะจบเร็วขึ้น 30% ความยาวของ prompt ระดับการคิด และจำนวนเครื่องมือที่ต้องใช้ล้วนเปลี่ยนเวลารวมได้
วัดเวลาจบงาน ไม่ใช่แค่เวลาที่ AI เริ่มตอบ
เหตุผลด้านความเร็วที่น่าสนใจในคลิปคือการลดจำนวนรอบระหว่าง AI กับเครื่องมือ แทนที่จะเรียกเครื่องมือหนึ่งครั้ง รอผล แล้วค่อยเรียกครั้งถัดไป model อาจจัดกลุ่มการเรียกเครื่องมือบางส่วนได้ จึงลดช่วงที่งานหยุดรอ คลิปยังอ้างว่าบางงานใช้ token และจำนวนครั้งในการเรียกเครื่องมือน้อยลง
ผลต่อธุรกิจจะเห็นชัดในงานหลายขั้น เช่น ตรวจไฟล์ข้อมูล สร้างตาราง แล้วสรุปเป็นข้อเสนอ หาก AI ตอบเร็วแต่ทีมยังต้องกลับไปเติมข้อมูลห้ารอบ ความเร็วที่เพิ่มขึ้นแทบไม่มีความหมาย ในทางกลับกัน คำตอบที่ใช้เวลานานขึ้นเล็กน้อยแต่ส่งงานครบตามเงื่อนไขอาจประหยัดเวลาคนได้มากกว่า
วิธีตั้งโจทย์คือระบุผลลัพธ์ปลายทางตั้งแต่แรก เช่น แทนที่จะสั่งว่า “ช่วยดูข้อมูลยอดขาย” ให้ระบุว่า “สรุปยอดขายรายเดือน แยกสินค้าขายดี ชี้ข้อมูลที่ยังขาด และทำตารางสำหรับประชุมทีม” AI จะมีภาพของงานทั้งหมดก่อนเริ่มลงมือ
อ่าน benchmark เป็นสัญญาณ ไม่ใช่คำตัดสินซื้อ
คลิปยก Terminal-Bench 4.0 และ CursorBench มาประกอบการเปรียบเทียบ แต่ชื่อรุ่นที่จับคู่กับคะแนนบางค่าในบทถอดเสียงไม่ตรงกับป้ายบนกราฟที่เก็บไว้ บทความนี้จึงไม่ยกคะแนนที่ยังจับคู่ไม่ได้ สิ่งที่อ่านได้จากภาพคือการเปรียบเทียบคะแนนกับต้นทุนต่อครั้ง และเส้นของแต่ละรุ่นที่เปลี่ยนไปตามระดับ effort
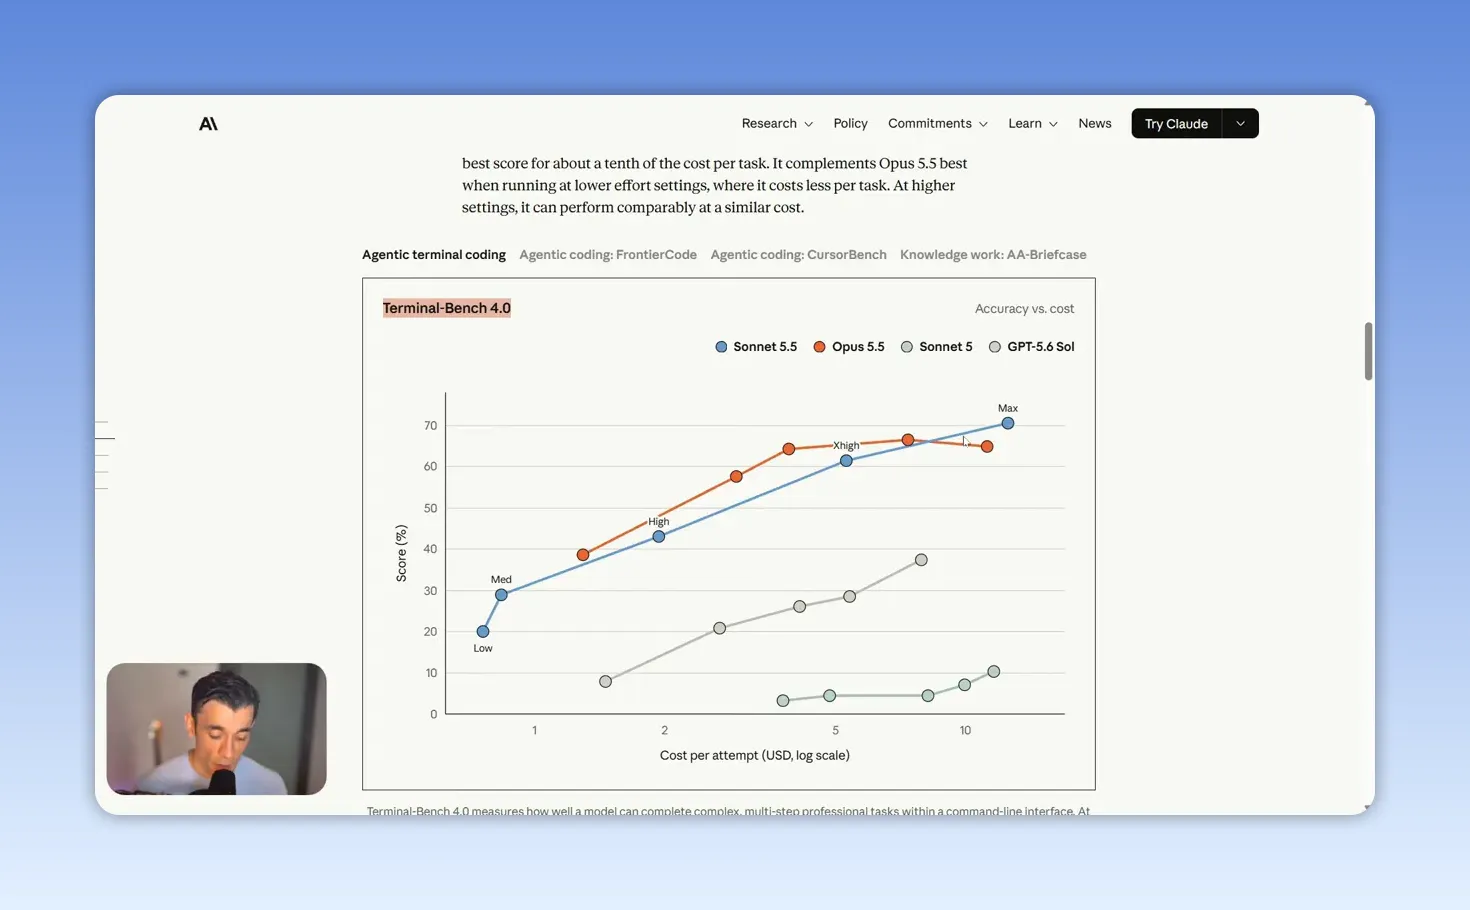
ผู้บรรยายใช้ผลทดสอบชี้ว่างานเขียนโค้ดและงานหลายขั้นเป็นพื้นที่ที่น่าลอง แต่ยังไม่ควรใช้สรุปว่า Sonnet 5.5 เหนือกว่า Opus ในทุกเรื่อง คลิปเองเตือนว่าบางการเปรียบเทียบใช้ระดับ effort ต่างกัน จึงไม่ใช่การแข่งแบบเงื่อนไขเท่ากันทั้งหมด อีกทั้งงานที่ต้องตีความเป้าหมายคลุมเครือหรือใช้การตัดสินใจละเอียดอ่อนยังอาจเหมาะกับ Opus มากกว่าในมุมมองที่คลิปนำเสนอ
เจ้าของธุรกิจจึงควรแปล benchmark เป็นคำถามที่ตรวจได้ว่า งานของทีมใกล้กับโจทย์ทดสอบแค่ไหน คะแนนด้านโค้ดสูงไม่ได้ยืนยันว่าข้อความขายภาษาไทยจะตรงเสียงแบรนด์ หรือแดชบอร์ดที่สร้างขึ้นจะอ่านข้อมูลเว็บไซต์จริงได้ถูกต้อง
ทดลองกับงานหาลูกค้าและ SEO ที่ตรวจผลได้
หน้าเสนอขายที่มีโจทย์ชัด
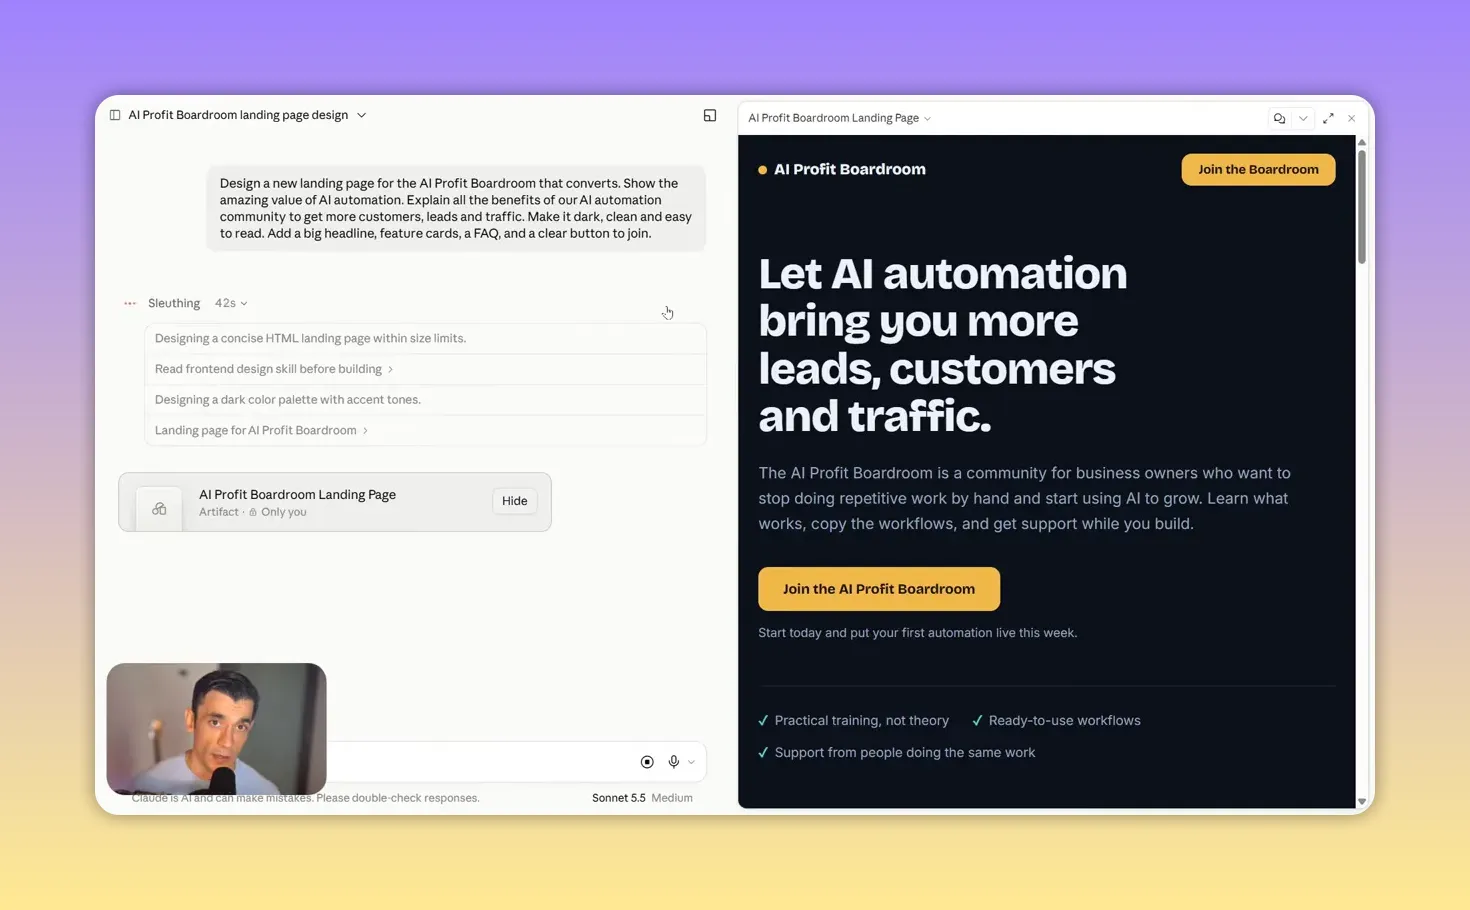
ตัวอย่างแรกในคลิปคือการให้ AI สร้าง landing page สำหรับชุมชน AI Profit Boardroom โดยสื่อประโยชน์ของระบบอัตโนมัติและกระตุ้นให้เกิดลูกค้าใหม่ หากนำมาปรับใช้กับธุรกิจไทย ร้านบริการหรือบริษัท B2B อาจเริ่มด้วยการส่งรายละเอียดสินค้า กลุ่มลูกค้า ข้อเสนอ และคำถามที่ลูกค้าถามบ่อย แล้วให้ AI ร่างโครงหน้าเว็บพร้อมข้อความแต่ละส่วน
ตัวอย่าง prompt ที่นำไปปรับได้คือ “ออกแบบโครงหน้าเสนอขายสำหรับบริการนี้ โดยระบุหัวเรื่อง ประโยชน์หลัก หลักฐานที่มีอยู่จริง คำถามพบบ่อย และปุ่มติดต่อ ห้ามแต่งคำรับรองหรือผลลัพธ์ที่ไม่ได้ให้ข้อมูลไว้” เงื่อนไขท้ายประโยคสำคัญ เพราะหน้าเว็บที่ดูดีแต่มีคำกล่าวอ้างเกินจริงสร้างความเสี่ยงมากกว่ายอดขาย
แดชบอร์ด SEO ที่บอกว่าควรแก้อะไรก่อน
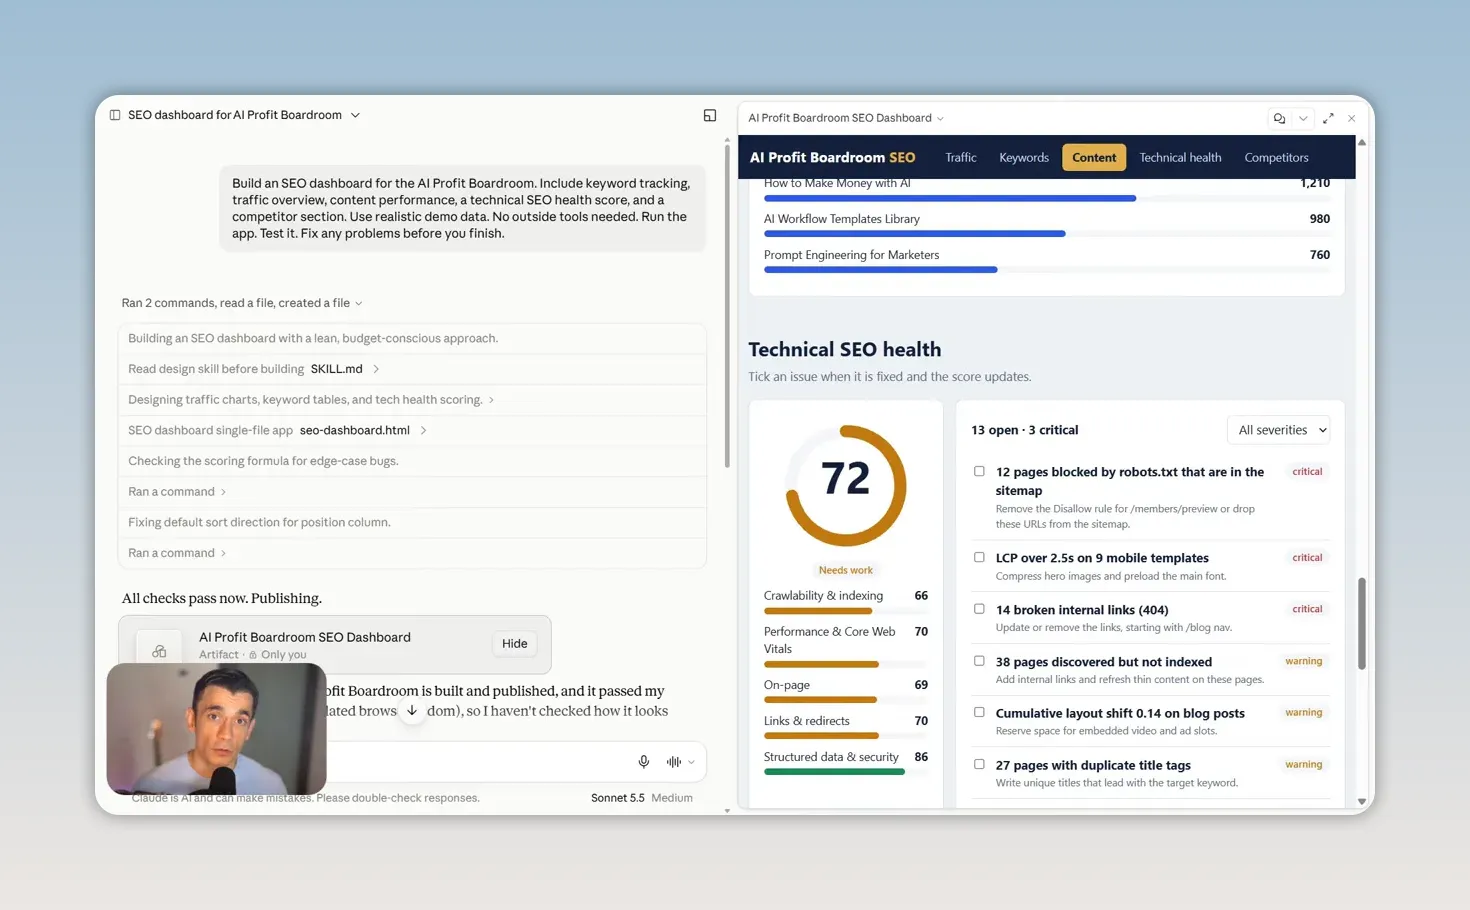
ตัวอย่างถัดมาที่คลิปเสนอให้ลองสร้างคือแดชบอร์ดตรวจ SEO ซึ่งครอบคลุมปัญหาทางเทคนิค เนื้อหา ลิงก์ภายใน และความเร็วหน้าเว็บ พร้อมเรียงรายการแก้ไขจากสำคัญมากไปน้อย บทความต้นทางเสนอว่าวิธีนี้อาจช่วยธุรกิจที่มีรายการปัญหายาว แต่ยังต้องตรวจว่าแดชบอร์ดใช้ข้อมูลจริงหรือข้อมูลตัวอย่าง
อย่างไรก็ตาม หน้าตาแดชบอร์ดไม่เท่ากับการตรวจเว็บไซต์จริง หากไม่ได้ให้ข้อมูลหรือเชื่อมเครื่องมือที่เกี่ยวข้อง คะแนนและกราฟอาจเป็นเพียงข้อมูลตัวอย่าง ก่อนใช้ตัดสินใจควรถามเสมอว่าตัวเลขแต่ละช่องมาจากแหล่งใด เก็บเมื่อไร และรายการแก้ไขข้อไหนตรวจสอบซ้ำได้
ขยายจากชิ้นงานเดียวเป็น workflow ของทีม
คลิปเสนอให้ทดสอบ AI กับการแก้บั๊กทั้งเครื่องมือ แทนการขอให้เขียนฟังก์ชันสั้นๆ คำสั่งหลักคือให้หาปัญหา อธิบายสาเหตุ แก้ไข และตรวจว่าฟีเจอร์กลับมาทำงานได้ สำหรับผู้ที่ไม่เขียนโค้ดเอง บทบาทที่ทำได้คือกำหนดอาการและเกณฑ์รับงาน เช่น “เมื่อเพิ่มลูกค้าใหม่แล้ว รายชื่อไม่อัปเดต” จากนั้นให้ผู้ดูแลระบบตรวจการเปลี่ยนแปลงก่อนนำขึ้นใช้งาน
งานที่ไม่เกี่ยวกับโค้ดก็ใช้หลักเดียวกันได้ คลิปยกตัวอย่างสไลด์อธิบายว่า AI automation ช่วยหาลูกค้าอย่างไร ตารางติดตาม lead ลูกค้าและ traffic แผนหัวข้อวิดีโอหนึ่งสัปดาห์ และแอปติดตาม lead ขนาดเล็ก ทั้งหมดเป็นงานที่มีหลายส่วนประกอบ ไม่ใช่เพียงคำถามหนึ่งข้อแล้วจบ
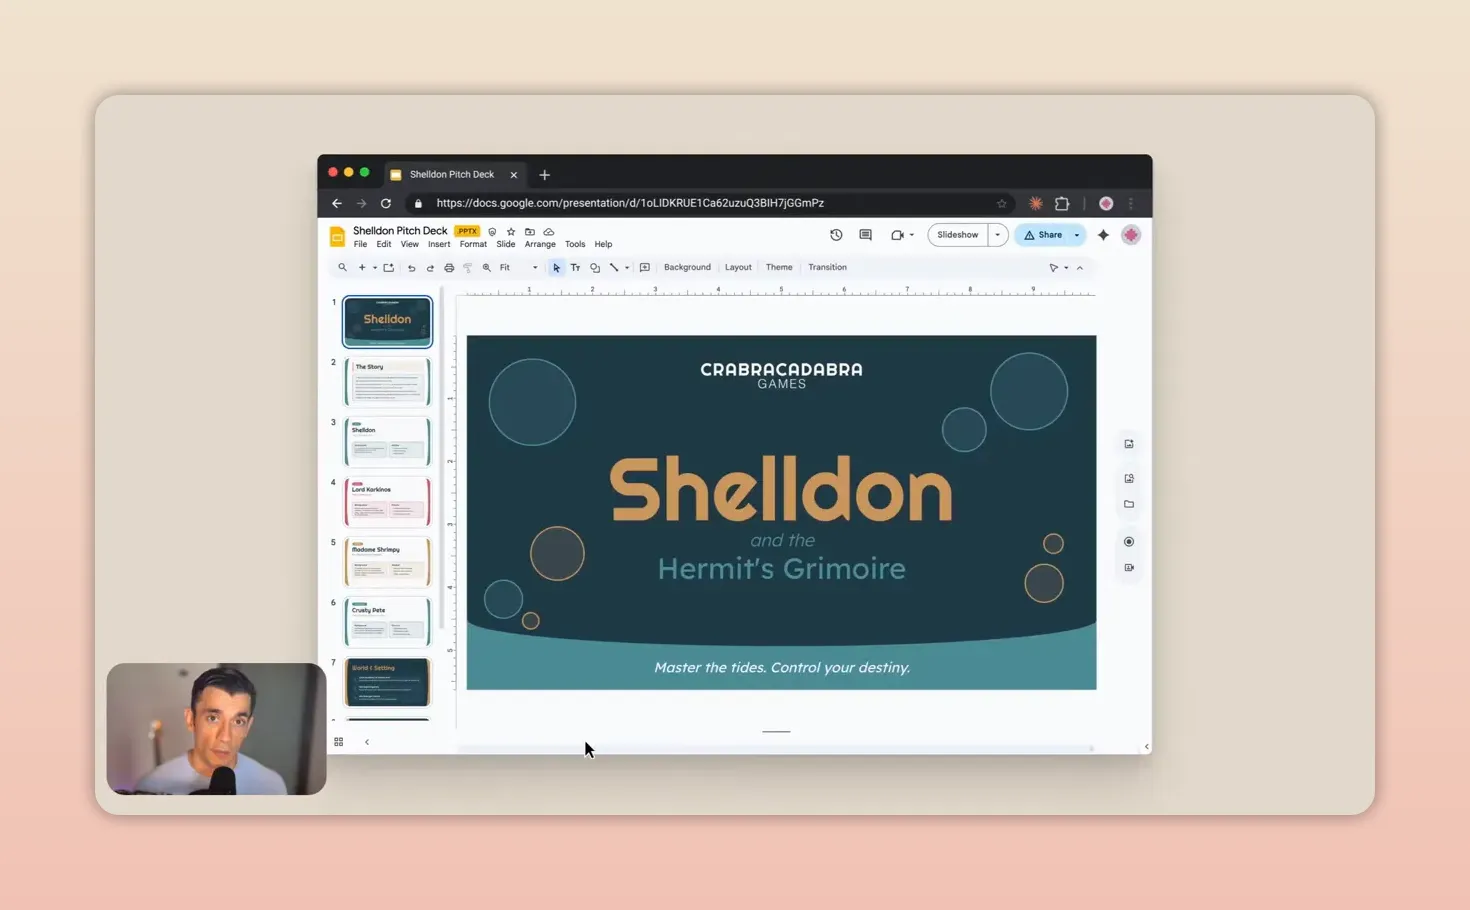
สำหรับทีมไทย ควรเริ่มจาก workflow ที่มีเจ้าของงานชัด เช่น ทีมการตลาดกำหนดหัวข้อและตรวจคำกล่าวอ้าง ทีมขายยืนยันนิยามของ lead ส่วน AI ช่วยจัดโครงร่างและเตรียมไฟล์ การแบ่งหน้าที่เช่นนี้ช่วยไม่ให้ทุกคนเข้าใจว่าไฟล์ที่สร้างเสร็จคือไฟล์ที่พร้อมเผยแพร่แล้ว
คลิปยังเล่าว่า Sonnet 5.5 สามารถเล่น Pokémon Red โดยอาศัยภาพหน้าจอ เพื่อชี้ความสามารถในการอ่านภาพ การประยุกต์กับธุรกิจที่สมเหตุสมผลกว่าคือส่งภาพหน้าเว็บ กราฟ หรือแบบงานให้ AI ช่วยชี้จุดที่สื่อสารไม่ชัด แต่ข้อเสนอจากภาพยังต้องตรวจเทียบกับข้อมูลจริงและความต้องการของลูกค้า
ปรับ effort และทดสอบด้วยงานเดิม
การตั้งค่า effort คืออีกประเด็นที่คลิปเห็นว่าสำคัญ ผู้บรรยายอธิบายว่าระดับต่ำใช้เวลาคิดและ token น้อยกว่า ส่วนระดับสูงเปิดทางให้คิดและตรวจงานมากขึ้น คลิประบุว่าค่าเริ่มต้นในแอป Claude และ Claude Code เป็น medium ขณะที่บน Claude platform เป็น high ซึ่งบทความนี้ยังไม่ได้ยืนยันกับเอกสารผลิตภัณฑ์ หากตัวเลือกที่ปรากฏในบัญชีต่างออกไป ควรยึดค่าที่แสดงในผลิตภัณฑ์ขณะใช้งาน และตรวจ เอกสารของ Anthropic ก่อนปรับ workflow ของทีม
วิธีทดลองไม่ซับซ้อน เลือกงานจริงหนึ่งงาน ใช้ prompt และข้อมูลชุดเดียวกัน แล้วจับเวลาตั้งแต่เริ่มจนได้งานที่ผ่านเกณฑ์ ลองเปรียบเทียบระดับ medium กับ high หรือเปรียบเทียบกับ model ที่ทีมใช้อยู่ บันทึกอย่างน้อยสองอย่างคือ เวลารวม และ คุณภาพที่ตรวจได้ เช่น จำนวนข้อผิดพลาด ส่วนที่ต้องแก้ด้วยคน และความครบของผลลัพธ์
งานร่างหัวข้อคอนเทนต์อาจไม่ต้องใช้ระดับคิดสูงสุด แต่งานแก้เครื่องมือที่กระทบข้อมูลลูกค้าควรให้เวลาตรวจมากขึ้น ประเด็นไม่ใช่ตั้งค่าเดียวให้ทั้งองค์กร แต่เลือกให้เหมาะกับต้นทุนของความผิดพลาดแต่ละงาน
สิ่งที่คลิปชวนให้ทดลอง
ข้อสรุปของผู้บรรยายคือให้ใช้โจทย์เดิมเปรียบเทียบเวลาและคุณภาพของงาน แทนการตัดสินจากความเร็วที่แสดงบนหน้าจอเพียงอย่างเดียว ตัวอย่างหน้าเสนอขาย แดชบอร์ด สไลด์ และตารางในบทความนี้เป็นแนวทางทดลองจากคลิป ไม่ใช่หลักฐานรับรองว่าระบบทำงานสำเร็จหรือช่วยเพิ่มยอดขายแล้ว
แหล่งที่มา: NEW Claude Sonnet 5.5 Is Surprisingly FAST! — Julian Goldie SEO ภาพประกอบและวิดีโอเก็บจากบทความต้นทาง ข้อเสนอเชิงธุรกิจและคำสั่งตัวอย่างที่ขยายความเป็นส่วนหนึ่งของบทความไทยเดิม