บันทึกคำอธิบายจากวิดีโอ: บทความนี้ถ่ายทอดคลิป Gemini 4 Argon: Google’s New AI Model ของ Julian Goldie SEO ชื่อรุ่น ราคา คะแนนทดสอบ และสถานะการเปิดให้บริการเป็นข้อมูลที่ผู้บรรยายกล่าวในคลิป ยังไม่ได้ตรวจยืนยันกับแหล่งทางการ วันที่ 1 ตุลาคม 2026 เป็นวันที่ในรายการบทความต้นทาง ไม่ใช่วันที่เผยแพร่วิดีโอที่ยืนยันแล้ว ข้อเสนอการทดลองในบทความเป็นแนวทางประยุกต์จากต้นฉบับ ไม่ใช่ผลทดลองของผู้เขียน
โมเดล AI รุ่นใหม่อาจทำคะแนนทดสอบได้สูง แต่ถ้ายังเปิดให้คนทั่วไปใช้งานไม่ได้ ตัวเลขเหล่านั้นก็ยังตอบไม่ได้ว่าจะช่วยธุรกิจประหยัดเวลาหรือทำงานได้ดีขึ้นจริงแค่ไหน นี่คือประเด็นสำคัญในคลิปที่ Julian Goldie SEO วิเคราะห์สิ่งที่เขาเรียกว่าการประกาศ Gemini 4 Argon ที่ควรแยกให้ออกระหว่างความสามารถที่รายงานไว้กับผลลัพธ์ที่เราทดลองได้เอง
ในคลิป Julian Goldie SEO หยิบข้อมูลการประกาศ ราคา และคะแนนเปรียบเทียบมาวิเคราะห์ โดยตั้งข้อสังเกตว่า Argon ยังไม่มีตัวอย่างผลลัพธ์ให้ตรวจสอบมากนัก บทความนี้จึงไม่ได้มองว่าโมเดลใดชนะบนตาราง แต่ไล่ทีละขั้นว่าเจ้าของธุรกิจและคนทำงานควรอ่านข่าวนี้อย่างไร เตรียมงานอะไรไว้ก่อน และตัดสินใจเมื่อเปิดให้ใช้งานจริงด้วยเกณฑ์แบบไหน
สารบัญ
- ขั้นที่ 1: แยกสิ่งที่ประกาศแล้วออกจากสิ่งที่ยังพิสูจน์ไม่ได้
- ขั้นที่ 2: อ่านคะแนน benchmark โดยเริ่มจากงานของเรา
- ขั้นที่ 3: ทำความเข้าใจเพดานผลลัพธ์หนึ่งล้าน token ให้ถูก
- ขั้นที่ 4: ประเมินราคาเป็นต้นทุนต่องาน ไม่ใช่ราคาต่อล้าน token
- ขั้นที่ 5: ดูตัวอย่างการใช้งานภายใน แต่อย่าเหมารวมกับทุกธุรกิจ
- ขั้นที่ 6: ตั้งเกณฑ์ทดลองก่อน Argon เปิดให้ใช้งาน
- ขั้นที่ 7: Actionable Insights สำหรับเจ้าของธุรกิจและคนทำงาน
- ขั้นที่ 8: Troubleshooting ปัญหาที่อาจเจอเมื่อเริ่มทดลอง
- ขั้นที่ 9: การต่อยอดหลังได้ผลทดลอง
- ขั้นที่ 10: สรุป Checklist ทั้งหมด
ขั้นที่ 1: แยกสิ่งที่ประกาศแล้วออกจากสิ่งที่ยังพิสูจน์ไม่ได้
ในคำอธิบายของ Julian Goldie SEO Gemini 4 Argon ถูกนำเสนอเป็นโมเดลระดับแนวหน้าสำหรับงานซับซ้อน โดยเน้นงานเขียนโปรแกรมและการใช้ความรู้ภายในองค์กร งานประเภทนี้ไม่ได้จบที่การถามคำถามหนึ่งครั้ง แต่อาจต้องอ่านข้อมูลหลายส่วน เชื่อมโยงเงื่อนไข และทำงานต่อเนื่องหลายขั้น
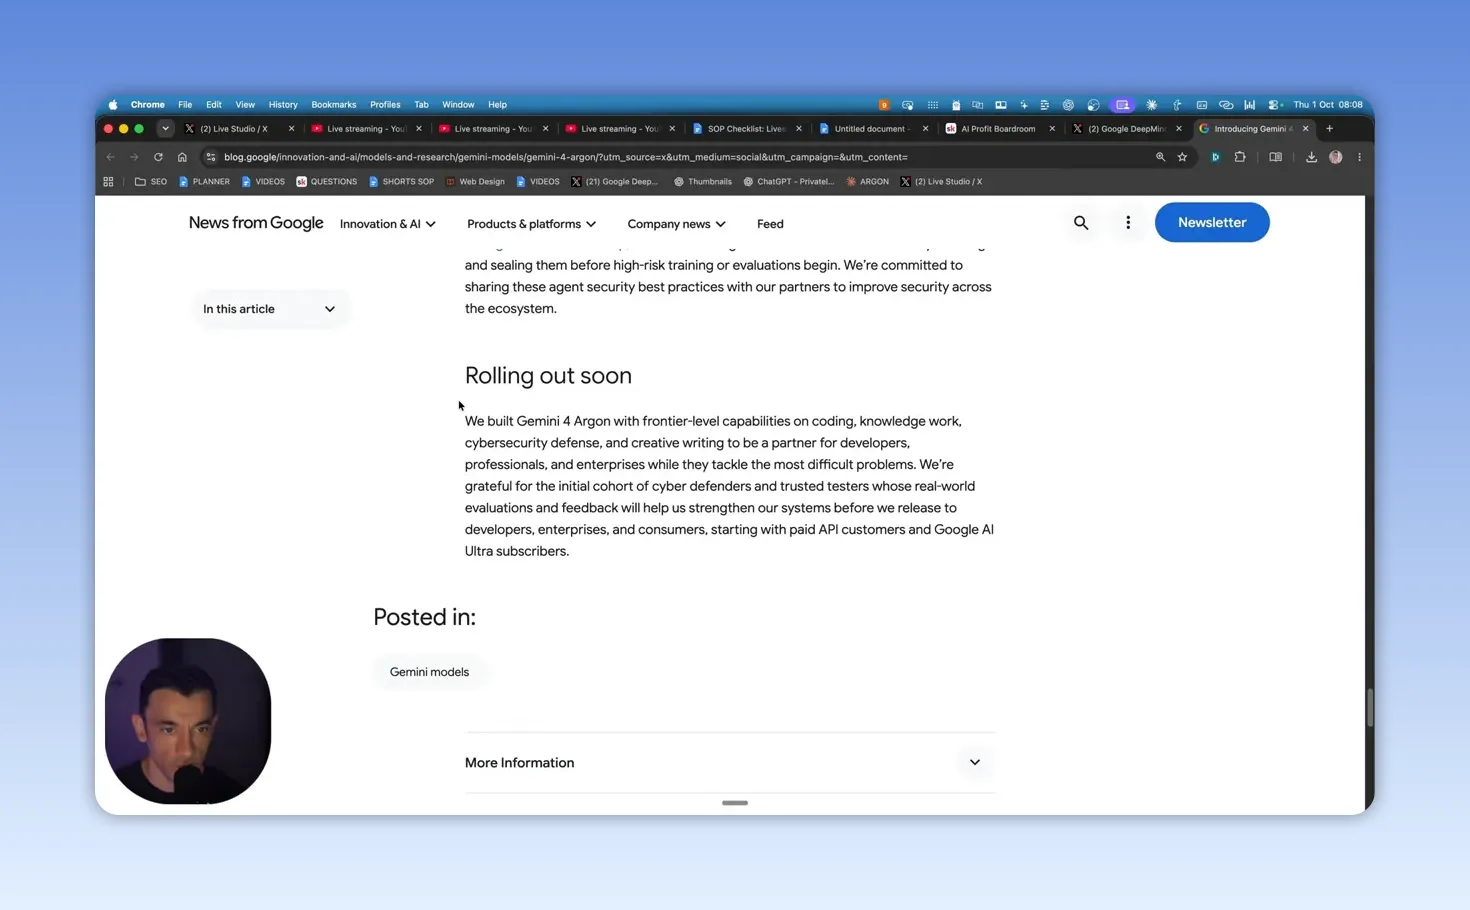
ข้อมูลที่เขาอ่านในคลิปมีทั้งคะแนนทดสอบ ความสามารถในการสร้างผลลัพธ์ยาวขึ้น และราคาเริ่มต้นสำหรับการใช้งานผ่าน token อย่างไรก็ตาม การประกาศความสามารถไม่เท่ากับการเปิดให้ทุกคนทดลอง เขาระบุว่าในช่วงบันทึกคลิป Argon ยังทยอยเปิดให้กลุ่มผู้ทดสอบด้านความปลอดภัยไซเบอร์ที่ได้รับความไว้วางใจก่อน และยังไม่มีกำหนดวันเปิดทั่วไปที่ยืนยันแล้ว
สำหรับธุรกิจไทย ข้อแตกต่างนี้สำคัญมาก หากทีมกำลังเลือก AI เพื่อใช้กับงานลูกค้าในเดือนนี้ การรอโมเดลที่ยังไม่มีกำหนดเปิดใช้อาจทำให้โครงการหยุดโดยไม่จำเป็น ทางที่รอบคอบกว่าคือเดินงานด้วยเครื่องมือที่เข้าถึงได้อยู่แล้ว พร้อมเตรียมชุดงานไว้ทดสอบ Argon เมื่อถึงเวลา
ขั้นที่ 2: อ่านคะแนน benchmark โดยเริ่มจากงานของเรา
ผลทดสอบที่ Julian นำเสนอในคลิปแสดงให้เห็นว่า Argon ทำได้ดีในหลายหมวดเมื่อเทียบกับโมเดลคู่แข่ง แต่คำถามที่ธุรกิจควรถามไม่ใช่เพียง “ได้ที่หนึ่งหรือไม่” คำถามคือ หมวดที่ได้คะแนนสูงเกี่ยวข้องกับงานที่ต้องทำหรือเปล่า
ตัวอย่างที่ถูกเน้นคือการทดสอบงานเขียนโปรแกรมแบบต่อเนื่องระยะยาว ซึ่งสะท้อนความสามารถในการจัดการโจทย์ที่มีหลายขั้นมากกว่าการเขียนโค้ดสั้น ๆ หากธุรกิจกำลังพัฒนาเว็บไซต์หรือดูแลระบบที่มีการแก้ไขต่อเนื่อง คะแนนหมวดนี้อาจมีน้ำหนัก แต่ถ้างานหลักคือสรุปข้อร้องเรียนลูกค้า ร่างอีเมล หรือจัดหมวดเอกสาร คะแนนด้านเขียนโปรแกรมย่อมบอกผลลัพธ์จริงได้จำกัด
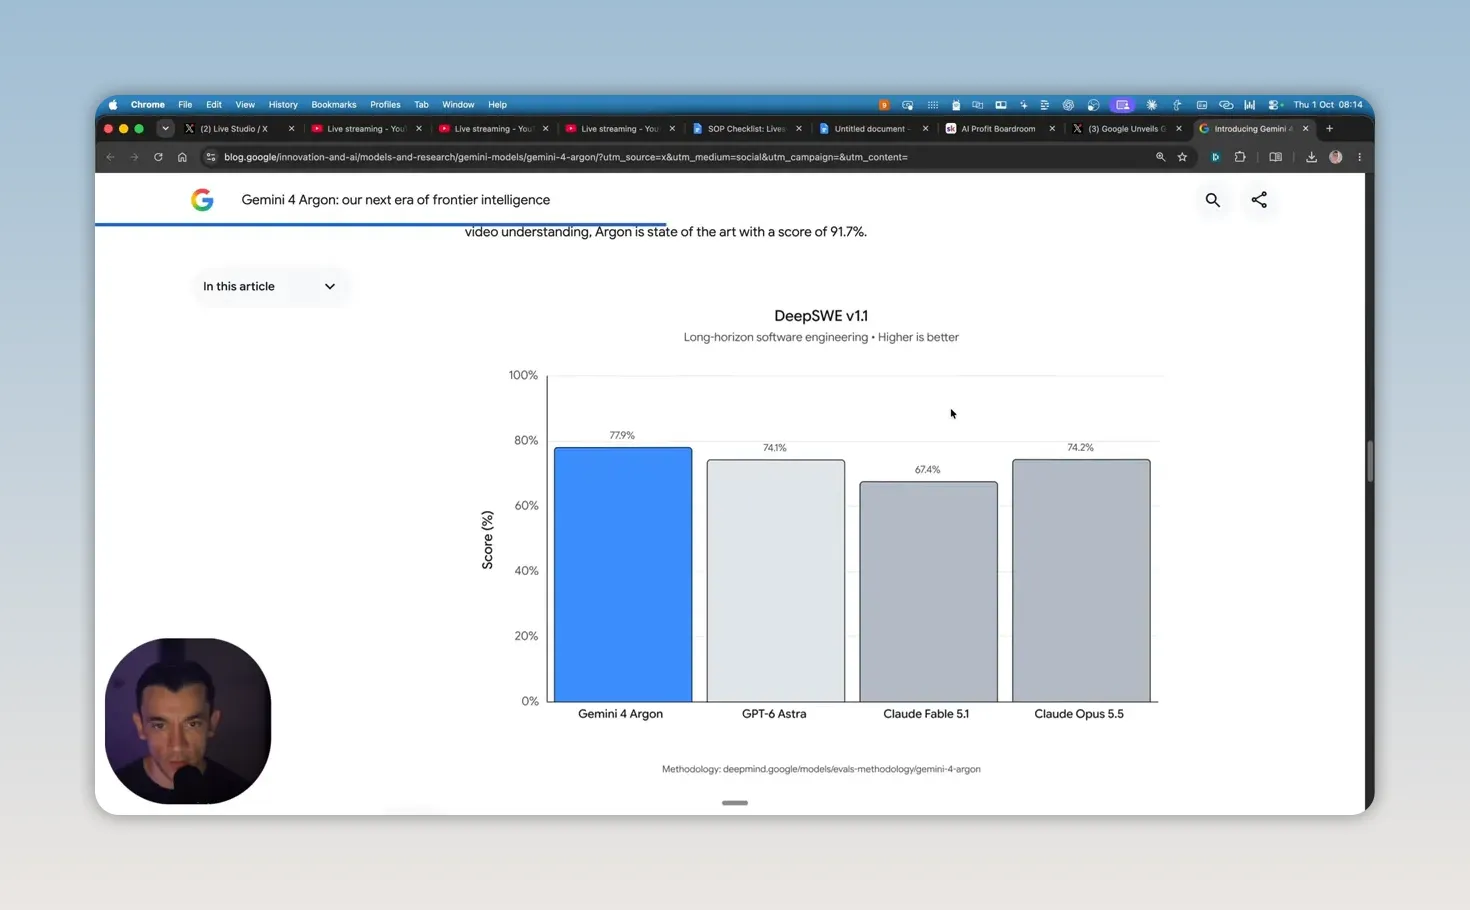
มีอีกจุดที่ต้องอ่านให้ครบ: Argon ไม่ได้เหนือกว่าทุกโมเดลในทุกการทดสอบ ผลบางรายการที่กล่าวถึงแสดงให้เห็นว่าคู่แข่งทำได้ใกล้เคียงหรือดีกว่า และหลายคะแนนที่ถูกพูดถึงเป็นงานด้านความปลอดภัยไซเบอร์ ไม่ใช่งานสำนักงานทั่วไป
มุมมองที่เหมาะกับเจ้าของธุรกิจคือใช้ benchmark เป็นตัวคัดรายชื่อโมเดลที่น่าลอง ไม่ใช่ใช้เป็นคำตัดสินซื้อทันที คะแนนต่างกันเพียงเล็กน้อยอาจไม่มีความหมาย หากอีกโมเดลตอบภาษาไทยได้ตรงกว่า ตรวจทานง่ายกว่า หรือทำงานเข้ากับ workflow เดิมได้ดีกว่า
ขั้นที่ 3: ทำความเข้าใจเพดานผลลัพธ์หนึ่งล้าน token ให้ถูก
ตัวเลขที่สะดุดตาที่สุดคือขีดจำกัด ผลลัพธ์สูงสุดหนึ่งล้าน token ซึ่งข้อมูลในคลิประบุว่าเพิ่มจาก 64,000 token การมีพื้นที่สร้างคำตอบมากขึ้นอาจเหมาะกับงานที่ต้องอธิบายหลายขั้นหรือส่งมอบผลลัพธ์ขนาดใหญ่ในครั้งเดียว
แต่เพดานผลลัพธ์ยาวไม่ได้รับประกันว่าเหตุผลจะถูกต้องกว่าเดิมโดยอัตโนมัติ อีกทั้งยังต้องแยก output token ซึ่งเป็นปริมาณที่โมเดลสร้างตอบ ออกจากปริมาณข้อมูลที่ส่งเข้าไปให้โมเดลอ่าน ทั้งสองส่วนเกี่ยวข้องกับการวางงานและค่าใช้จ่ายคนละแบบ
ถ้าธุรกิจไทยมีเอกสารผลิตภัณฑ์ คู่มือบริการ และคำถามลูกค้าจำนวนมาก โอกาสไม่ได้อยู่ที่การสั่งให้ AI เขียนคำตอบยาวที่สุด แต่อยู่ที่การกำหนดผลลัพธ์ให้เหมาะกับคนใช้ เช่น สรุปประเด็นสำคัญ ระบุเอกสารอ้างอิง และแยกรายการที่ต้องให้พนักงานตรวจต่อ คำตอบยาวมากอาจกลายเป็นภาระใหม่หากไม่มีใครมีเวลาอ่าน
ขั้นที่ 4: ประเมินราคาเป็นต้นทุนต่องาน ไม่ใช่ราคาต่อล้าน token
ราคาช่วงเปิดตัวที่ Julian อ่านในคลิปคือ 2 ดอลลาร์สหรัฐต่อหนึ่งล้าน input token และ 10 ดอลลาร์สหรัฐต่อหนึ่งล้าน output token โดย input ที่ใช้ข้อมูลแคชมีส่วนลด 95% ตัวเลขนี้ช่วยให้เริ่มวางงบได้ แต่ยังไม่พอสำหรับสรุปว่าการใช้งานจริงจะถูกหรือแพง
ต้นทุนขึ้นอยู่กับจำนวนครั้งที่เรียกใช้ ปริมาณข้อมูลที่ส่งเข้าไป และความยาวของคำตอบ หาก workflow หนึ่งเรียก AI หลายรอบเพื่ออ่านเอกสาร ร่างคำตอบ และตรวจแก้ ค่าใช้จ่ายต้องนับทั้งกระบวนการ ไม่ใช่นับเฉพาะคำตอบสุดท้าย ส่วนลดข้อมูลแคชก็น่าสนใจสำหรับงานที่ใช้เนื้อหาชุดเดิมซ้ำ แต่ไม่ควรนำมาคำนวณเป็นส่วนลดของทุกคำขอโดยอัตโนมัติ
วิธีคิดที่ใช้ได้จริงคือกำหนดหน่วยงานก่อน เช่น ต้นทุนต่อการสรุปเคสลูกค้าหนึ่งเรื่อง หรือต่อรายงานหนึ่งฉบับ แล้วเปรียบเทียบกับเวลาที่ทีมใช้และคุณภาพที่ได้รับ ราคาช่วงเปิดตัวควรถูกมองเป็นข้อมูลตั้งต้น และควรตรวจเงื่อนไขล่าสุดอีกครั้งก่อนทำงบระยะยาว
ขั้นที่ 5: ดูตัวอย่างการใช้งานภายใน แต่อย่าเหมารวมกับทุกธุรกิจ
ตัวอย่างที่ Julian อ้างว่ามาจากการใช้งานภายใน Google เป็นงานเฉพาะทาง ได้แก่ การปรับปรุงอัลกอริทึมด้านควอนตัม การใช้หน่วยความจำให้คุ้มขึ้น การปรับโค้ดในฐานโค้ดขนาดใหญ่ และงานกับซอฟต์แวร์โอเพนซอร์ส หนึ่งในตัวอย่างด้านควอนตัมระบุว่าทำได้ดีกว่าค่ามาตรฐานที่เผยแพร่ไว้ 40% ภายในไม่กี่นาที
ตัวอย่างที่คลิปรายงานเหล่านี้บอกทิศทางที่ผู้บรรยายมองว่าโมเดลถูกออกแบบมาสำหรับโจทย์ที่ซับซ้อน แต่ไม่ได้แปลว่าธุรกิจทั่วไปจะได้ผลลัพธ์ระดับเดียวกันทันที งานวิจัยเฉพาะทางมีโจทย์ วิธีวัดผล และข้อมูลที่ต่างจากการทำงานของร้านค้า บริษัทบริการ หรือทีมการตลาด
สิ่งที่นำมาปรับใช้ได้คือ เลือกโจทย์ที่มีผลลัพธ์ตรวจสอบได้ ธุรกิจที่มีงานเอกสารซ้ำ ๆ อาจลองวัดว่า AI ช่วยสรุปข้อมูลได้ครบหรือไม่ ทีมที่มีระบบเว็บไซต์อาจวัดว่า AI เสนอแนวทางแก้ปัญหาที่นำไปใช้ได้กี่ครั้ง การทดลองแบบนี้ให้คำตอบทางธุรกิจชัดกว่าการถามว่าโมเดล “ฉลาดแค่ไหน”
ขั้นที่ 6: ตั้งเกณฑ์ทดลองก่อน Argon เปิดให้ใช้งาน
ข้อจำกัดใหญ่ที่ Julian ตั้งข้อสังเกตในช่วงบันทึกคลิปคือยังไม่มีผลลัพธ์จากการใช้งานทั่วไปให้ตรวจสอบมากนัก จึงเร็วเกินไปที่จะสรุปว่า Argon จะเป็นตัวเลือกดีที่สุดสำหรับทุกงาน ระยะเวลาที่ Julian คาดว่าอาจเปิดให้ใช้ภายในหนึ่งหรือสองสัปดาห์เป็นเพียงการคาดการณ์ ไม่ใช่กำหนดการที่ยืนยันแล้ว
แทนที่จะรอโดยไม่มีแผน ทีมงานสามารถเตรียมการทดลองขนาดเล็กไว้ล่วงหน้าได้:
- เลือกงานจริงหนึ่งอย่างที่ทำบ่อยและวัดผลได้ เช่น สรุปคำขอจากลูกค้า
- รวบรวมตัวอย่างงานที่ไม่เปิดเผยข้อมูลอ่อนไหว พร้อมคำตอบที่ทีมยอมรับได้
- กำหนดเกณฑ์เปรียบเทียบ เช่น ความครบถ้วน ความถูกต้อง เวลาในการตรวจ และต้นทุนต่อชิ้นงาน
- ทดสอบงานชุดเดียวกันกับเครื่องมือที่ใช้อยู่ แล้วเก็บผลไว้เป็นฐานเปรียบเทียบ
- เมื่อ Argon เข้าถึงได้จริง จึงทดสอบซ้ำด้วยโจทย์และเกณฑ์เดียวกัน
หากจะตรวจสถานะการเข้าถึง สามารถดูช่องทางของ Google เช่น Google AI Studio ได้ แต่การไม่พบชื่อโมเดลในบัญชีไม่ได้บอกวันเปิดใช้งานที่แน่นอน
ขั้นที่ 7: Actionable Insights สำหรับเจ้าของธุรกิจและคนทำงาน
- อย่าหยุดโครงการเพื่อรอข่าว: ใช้ AI ที่เข้าถึงได้ตอนนี้กับงานที่เริ่มทำได้ แล้วเก็บผลไว้เทียบกับรุ่นใหม่
- เลือก benchmark ให้ตรงงาน: งานบริการลูกค้าไม่ควรตัดสินจากคะแนนเขียนโปรแกรมเพียงอย่างเดียว
- ตั้งงบต่อชิ้นงาน: นับทั้งข้อมูลที่ส่งเข้า คำตอบที่สร้าง และจำนวนรอบที่ต้องแก้ไข
- กำหนดคนตรวจผล: โดยเฉพาะงานที่กระทบลูกค้า ราคา หรือข้อมูลภายใน
- ติดตามสถานะจากแหล่งทางการ: แยกวันประกาศออกจากวันที่บัญชีของทีมเข้าใช้งานได้จริง
ขั้นที่ 8: Troubleshooting ปัญหาที่อาจเจอเมื่อเริ่มทดลอง
- ปัญหา: ค้นหา Argon ในเครื่องมือของ Google แล้วไม่พบ
สาเหตุที่คลิปรายงานในขณะนั้น: การเปิดให้ใช้งานยังจำกัด และไม่มีกำหนดเปิดทั่วไปที่ยืนยันแล้ว
วิธีแก้: ตรวจประกาศทางการเป็นระยะ ใช้โมเดลที่มีอยู่ทำงานต่อ และหลีกเลี่ยงการตั้งวันเริ่มโครงการโดยอิงจากการคาดเดา - ปัญหา: คะแนน benchmark สูง แต่คำตอบสำหรับงานจริงยังไม่ตรง
สาเหตุ: งานทดสอบอาจวัดทักษะคนละอย่างกับงานของทีม
วิธีแก้: เลือกตัวอย่างงานจริงหลายระดับความยาก กำหนดเกณฑ์ตรวจเดียวกัน แล้วเปรียบเทียบกับโมเดลเดิม - ปัญหา: คำตอบยาวมากจนตรวจไม่ไหว
สาเหตุ: เพดาน output สูงถูกเข้าใจว่าควรใช้ให้เต็ม
วิธีแก้: ระบุรูปแบบคำตอบใน prompt ให้สั้นและตรวจง่าย เช่น ข้อสรุป หลักฐาน และจุดที่ยังไม่แน่ใจ - ปัญหา: ประมาณงบจากราคาต่อ token แล้วค่าใช้จ่ายจริงสูงกว่า
สาเหตุ: ไม่ได้นับการเรียกซ้ำและการแก้คำตอบหลายรอบ
วิธีแก้: บันทึกจำนวนรอบและต้นทุนต่องานตั้งแต่ช่วงทดลอง ก่อนขยายไปทั้งทีม
ขั้นที่ 9: การต่อยอดหลังได้ผลทดลอง
หาก Argon เปิดให้ใช้งานและผ่านเกณฑ์ของทีมแล้ว ยังมีทางต่อยอดโดยไม่ต้องเปลี่ยนทุก workflow พร้อมกัน:
- สร้างชุดงานทดสอบประจำทีม: เก็บโจทย์และเกณฑ์ตรวจชุดเดิมไว้ใช้เปรียบเทียบโมเดลรุ่นต่อไป
- แยกงานตามความเสี่ยง: ให้ AI ช่วยร่างหรือตรวจเบื้องต้นในงานทั่วไป แต่คงขั้นอนุมัติของคนในงานที่กระทบลูกค้า
- ทบทวนต้นทุนรายเดือน: ดูว่าคุณภาพที่เพิ่มขึ้นคุ้มกับค่าใช้จ่ายและเวลาตรวจงานหรือไม่
ขั้นที่ 10: สรุป Checklist ทั้งหมด
- ☐ แยกข้อมูลที่ประกาศแล้วออกจากความสามารถที่ยังไม่ได้ทดลองเอง
- ☐ ตรวจว่า Argon เปิดให้บัญชีของทีมใช้งานจริงหรือยัง
- ☐ เลือกคะแนน benchmark ที่เกี่ยวกับงานของธุรกิจ
- ☐ แยก input token ออกจาก output token เมื่อวางแผนงานและงบ
- ☐ คำนวณต้นทุนต่อชิ้นงาน รวมการเรียกใช้ซ้ำ
- ☐ เตรียมตัวอย่างงานจริงและเกณฑ์วัดผลก่อนทดลอง
- ☐ เปรียบเทียบกับเครื่องมือที่ใช้อยู่ภายใต้โจทย์เดียวกัน
- ☐ กำหนดผู้ตรวจคำตอบก่อนนำผลไปใช้กับลูกค้าหรืองานสำคัญ
จากมุมมองในคลิป Gemini 4 Argon น่าจับตา แต่ยังไม่ใช่เหตุผลให้เปลี่ยนระบบทันที คะแนนที่ดี ราคาเริ่มต้น และเพดานผลลัพธ์ขนาดใหญ่เป็นสัญญาณว่าควรเตรียมทดลอง ส่วนคำตอบว่าจะคุ้มกับธุรกิจไทยหรือไม่ ต้องมาจากงานจริงที่วัดคุณภาพ เวลา และต้นทุนได้ครบ