วันที่บทความต้นทางใน VTB: 16 กันยายน 2026 (2026-09-16) · วันที่อัปโหลดวิดีโอยังไม่ได้รับการยืนยัน
บทความนี้เรียบเรียงจากต้นฉบับที่อ้างอิงคลิป Elon Musk's NEW Grok 4.8 is COMING! ของช่อง Julian Goldie SEO รายละเอียดรุ่น ฟีเจอร์ ตัวเลข และผลลัพธ์เป็นสิ่งที่แหล่งต้นทางกล่าวถึงในขณะนั้น ไม่ใช่การยืนยันสถานะล่าสุดหรือผลทดสอบของผู้เขียน ตัวอย่างสำหรับธุรกิจไทยเป็นแนวทางประยุกต์
คลิปที่กล่าวถึงการประกาศ Grok 4.8 ทั้งที่ Grok 4.7 ยังไม่เปิดตัวในช่วงที่ผู้เล่าพูดถึง สะท้อนว่าโลก AI ไม่ได้แข่งกันแค่ “model ไหนฉลาดกว่า” อีกต่อไป แต่แข่งกันที่ความเร็วในการสร้าง ปรับจูน และนำ model ไปใช้งานจริงด้วย
คลิปจากช่อง Julian Goldie SEO ชี้ให้เห็นประเด็นที่น่าสนใจกว่าเลข 2.5 ล้านล้านพารามิเตอร์ นั่นคือ xAI กำลังเปลี่ยนชุดซอฟต์แวร์สำหรับฝึก AI มาใช้ C++ และกำลังเดินเข้าสู่ช่วง reinforcement learning หรือ RL สำหรับ Grok 4.8 แต่สิ่งที่เกิดกับ Grok 4.7 ทำให้เราต้องระวังการเชื่อคำประกาศก่อนเห็นผลทดสอบจริง
สำหรับเจ้าของธุรกิจและคนทำงานไทย บทเรียนไม่ใช่การรอ model ใหม่เพื่อหวังปาฏิหาริย์ แต่คือการออกแบบ workflow ที่เปลี่ยนเครื่องมือได้ง่าย วัดผลได้ และไม่ปล่อยให้ AI ตัดสินใจแทนคนในงานที่มีความเสี่ยงสูง
ชมคลิป Elon Musk's NEW Grok 4.8 is COMING! · Julian Goldie SEO
สารบัญ
- Step 1: แยก “ข่าวประกาศ” ออกจาก “ของที่ใช้ได้จริง”
- Step 2: เข้าใจว่าทำไม C++ training stack จึงน่าสนใจกว่าเลขพารามิเตอร์
- Step 3: อย่าตีความ 2.5 ล้านล้านพารามิเตอร์ว่าเก่งกว่าโดยอัตโนมัติ
- Step 4: เรียนรู้จากปัญหา Grok 4.7 ว่าการปรับจูนผิดอาจทำให้ model แย่ลง
- Step 5: สร้าง workflow ที่พร้อมทดสอบ Grok 4.8 โดยไม่ต้องรอวันเปิดตัว
- Step 6: แก้ปัญหาที่มักเจอเมื่อเอา AI ไปใช้ในงานธุรกิจ
- Step 7: ต่อยอดจาก chatbot ไปสู่ระบบทำงานที่วัดผลได้
- Step 8: สรุป Checklist ทั้งหมดก่อนทดลองใช้ Grok 4.8
Step 1: แยก “ข่าวประกาศ” ออกจาก “ของที่ใช้ได้จริง”
ตามลำดับเหตุการณ์ที่คลิปเล่า Grok รอบนี้ต่างจากที่หลายคนคุ้นเคย Grok 4.6 เปิดตัวก่อนด้วยขนาด 1.5 ล้านล้านพารามิเตอร์ จากนั้นมีการประกาศ Grok 4.7 ที่ 2.1 ล้านล้านพารามิเตอร์ พร้อมกำหนดเปิดตัวในวันที่ 12 กันยายน
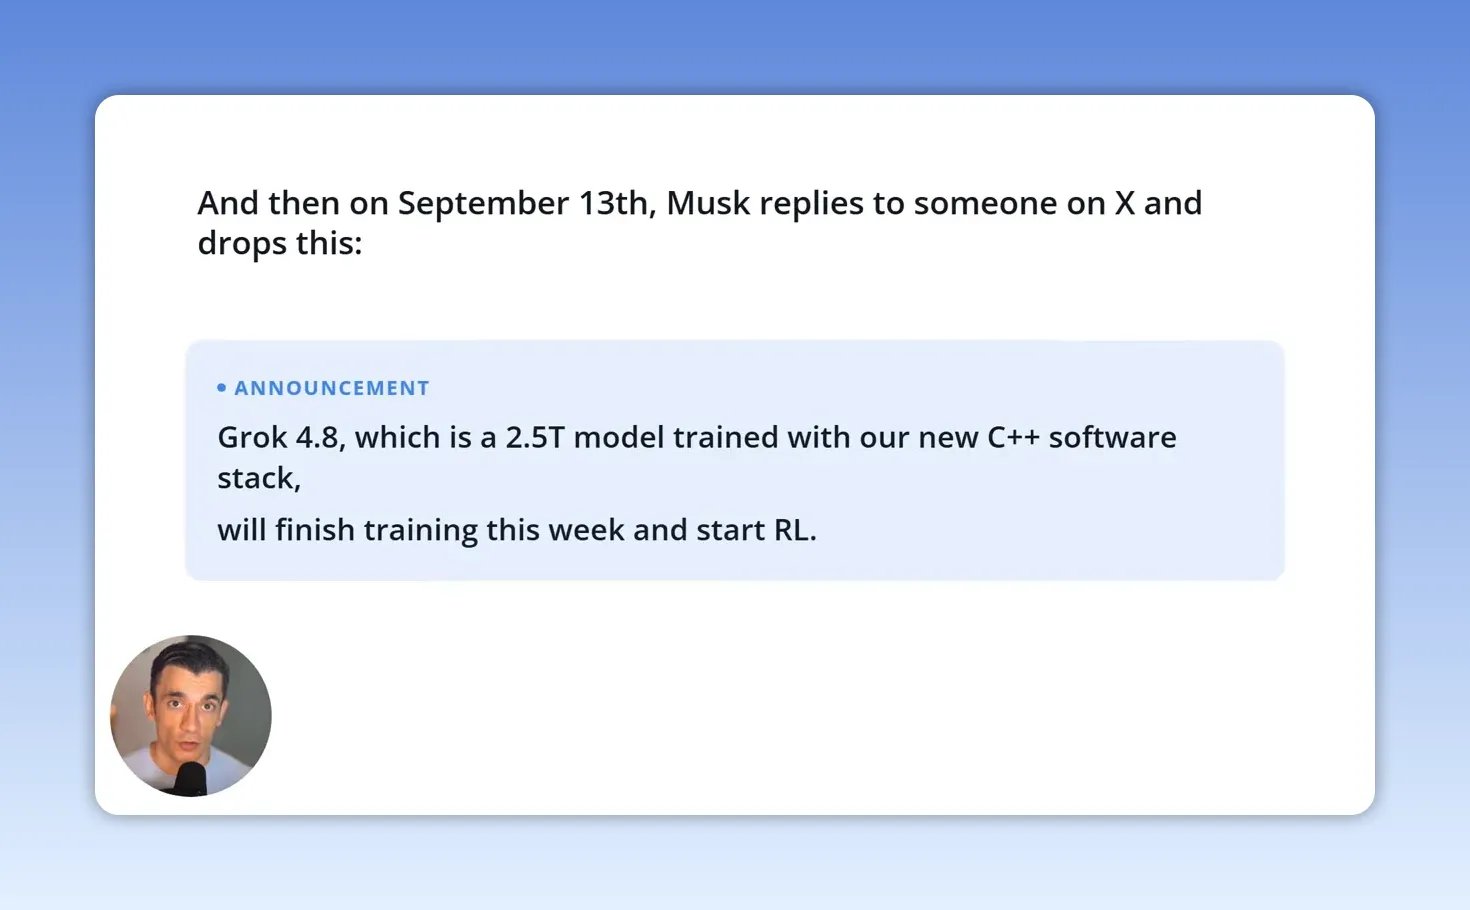
แต่เมื่อถึงช่วงเวลาที่คลิปพูดถึง Grok 4.7 ยังไม่มีการเปิดใช้งานอย่างเป็นทางการ ไม่มี model card ไม่มี API identifier และไม่มีผล benchmark ที่ xAI เผยแพร่ ขณะเดียวกัน Elon Musk กลับประกาศ Grok 4.8 ที่ 2.5 ล้านล้านพารามิเตอร์ และระบุว่ากำลังจบการฝึกหลักก่อนเข้าสู่ขั้น RL
จุดนี้สำคัญมาก เพราะคำว่า “ประกาศ” ไม่เท่ากับ “พร้อมใช้งานในธุรกิจ” ต่อให้ model มีศักยภาพบนกระดาษสูงเพียงใด ธุรกิจยังต้องรอคำตอบอย่างน้อย 4 เรื่อง คือ เข้าใช้ผ่านช่องทางใด ราคาเท่าไร ทำงานภาษาไทยดีแค่ไหน และให้ผลลัพธ์ที่เสถียรกับงานจริงหรือไม่
มุมมองของเรา: การเปิดตัวถี่ขึ้นไม่ใช่เหตุผลให้ย้ายระบบถี่ขึ้น ธุรกิจที่เปลี่ยน AI ทุกครั้งตามกระแส มักเสียเวลากับการย้าย prompt ทดสอบผลใหม่ และอบรมทีมซ้ำ โดยยังไม่ได้เพิ่มยอดขายหรือลดเวลางานเป็นรูปธรรม
Step 2: เข้าใจว่าทำไม C++ training stack จึงน่าสนใจกว่าเลขพารามิเตอร์
ผู้เล่าอ้างว่า xAI ระบุว่า Grok 4.8 ได้รับการฝึกด้วยชุดซอฟต์แวร์ C++ ใหม่ แก่นของเรื่องนี้ไม่ใช่ว่า C++ เป็นภาษาที่ “ดีกว่า” Python สำหรับทุกอย่าง แต่เป็นเรื่องการควบคุม hardware ที่ละเอียดขึ้นในงานฝึก model ขนาดใหญ่มาก
โดยทั่วไป งานพัฒนา AI มักใช้ framework ที่มี Python เป็นชั้นควบคุม เพราะยืดหยุ่นและพัฒนาเร็ว แต่ทุกชั้นของซอฟต์แวร์ย่อมมีต้นทุนเพิ่มขึ้น เมื่อขนาดระบบใหญ่ระดับ GPU หลายแสนตัว ความล่าช้าเพียงเล็กน้อยจะกลายเป็นค่าใช้จ่ายและเวลาที่สูงมาก
แนวคิดของ C++ stack คือ ลด overhead ของชั้นซอฟต์แวร์ เปิดทางให้จัดการหน่วยความจำ การสื่อสารระหว่าง GPU และการรันงานได้ตรงกับ hardware มากขึ้น หากทำได้จริง ผลที่ตามมาคือ:
- รอบการทดลองระหว่างฝึก model อาจทำได้เร็วขึ้น
- ทีมอาจแก้ปัญหาระหว่างการฝึกได้เร็วขึ้น
- ทรัพยากร GPU เดิมอาจรองรับงานได้มากขึ้น
- การให้บริการ model หลังเปิดตัวอาจตอบสนองเร็วขึ้น
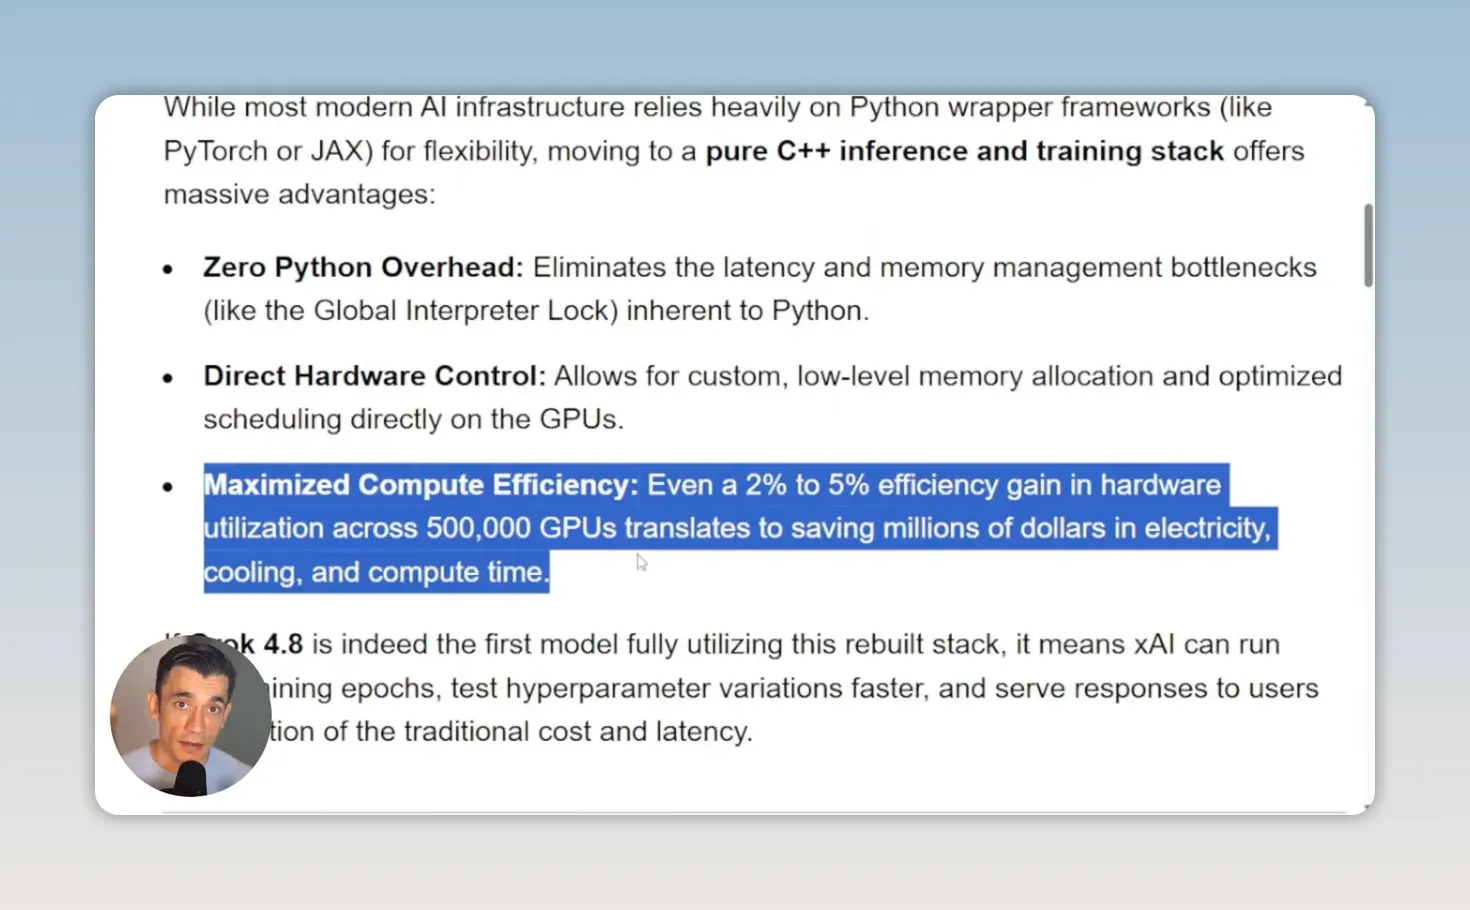
คลิปกล่าวถึงการทำงานของ xAI บน Colossus cluster ที่มี GPU มากกว่า 500,000 ตัว และอ้างถึงความเป็นไปได้ที่ C++ inference stack จะเพิ่มความเร็วการให้บริการได้มากถึงสองเท่าหรือมากกว่า อย่างไรก็ตาม นี่ควรถูกมองเป็นทิศทางและคำกล่าวจากฝั่งบริษัท ไม่ใช่ผลยืนยันจากการทดสอบอิสระ
ถ้าแปลเป็นภาษาธุรกิจ เรื่องนี้มีผลเมื่อความเร็วและต้นทุนถูกส่งต่อมาที่ผู้ใช้จริง เช่น งานสรุปเอกสารนับร้อยชิ้นทำเสร็จเร็วขึ้น chatbot ตอบลูกค้าได้ลื่นขึ้น หรือ API มีต้นทุนเหมาะกับการนำไปทำ automation แต่จนกว่าจะมีราคา ความหน่วง และข้อจำกัดการใช้งานจริง เราไม่ควรตั้งงบประมาณจากความคาดหวังเพียงอย่างเดียว
Step 3: อย่าตีความ 2.5 ล้านล้านพารามิเตอร์ว่าเก่งกว่าโดยอัตโนมัติ
พารามิเตอร์คือค่าภายใน neural network ที่ model เรียนรู้ระหว่างการฝึก สามารถมองเป็นโครงข่ายความสัมพันธ์ที่ช่วยให้ AI เข้าใจภาษา เหตุผล รูปแบบ และการแก้ปัญหา Grok 4.8 ที่ถูกกล่าวถึงมีขนาด 2.5 ล้านล้านพารามิเตอร์ เทียบกับ Grok 4.6 ที่ 1.5 ล้านล้าน และ Grok 4.7 ที่ 2.1 ล้านล้าน
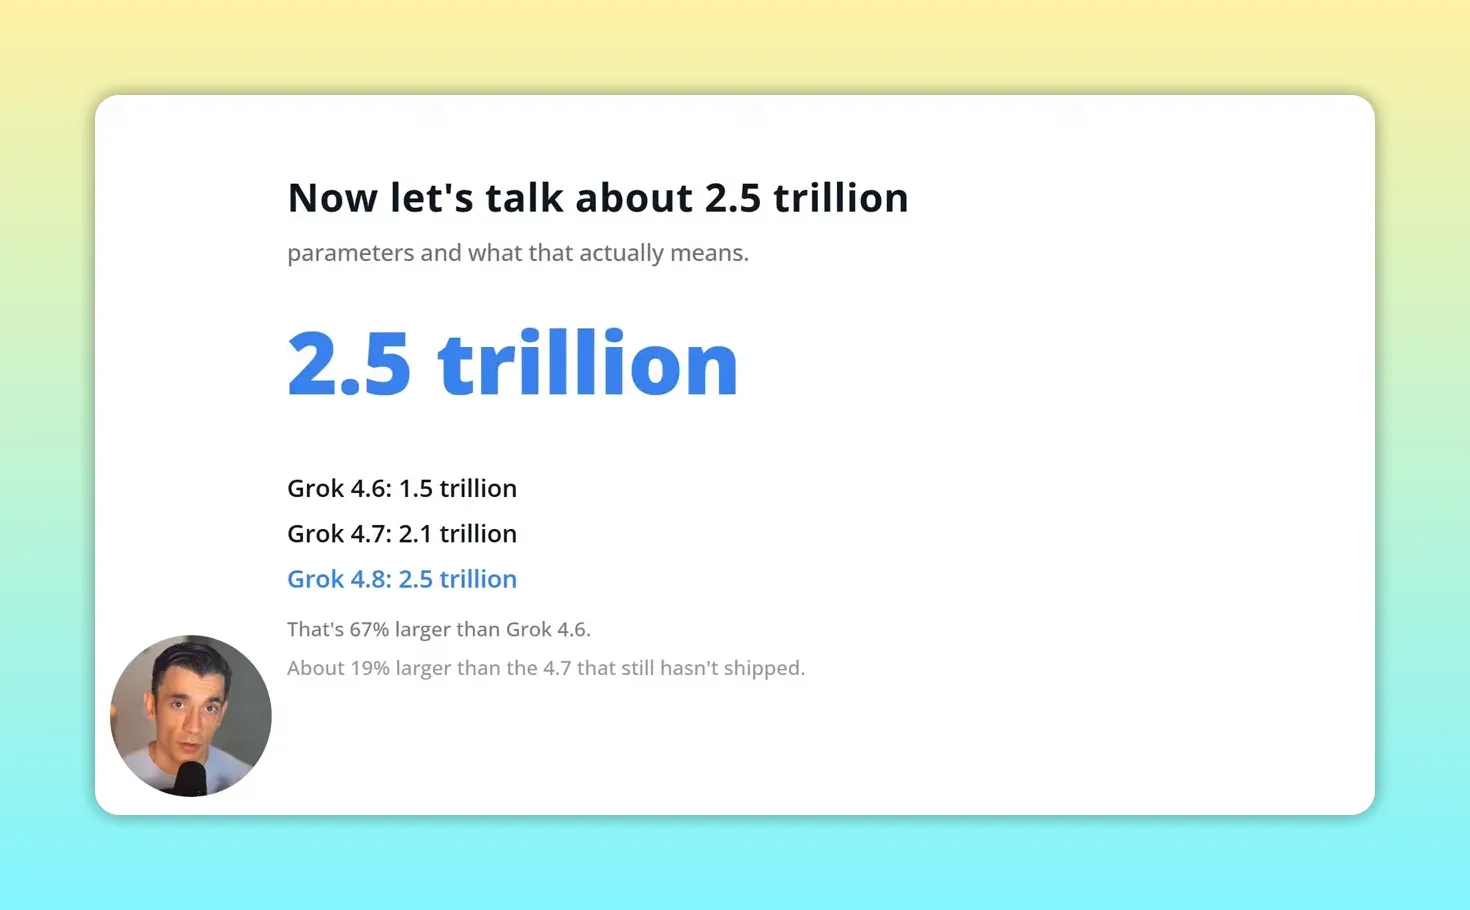
ตัวเลขนี้ทำให้ Grok 4.8 ใหญ่กว่า Grok 4.6 ราว 67% และใหญ่กว่า Grok 4.7 ราว 19% แต่ “ใหญ่” ไม่ได้แปลว่า “ฉลาดกว่า” เสมอไป คุณภาพข้อมูล วิธีฝึก การปรับพฤติกรรมหลังฝึก และการประเมินผล ล้วนมีน้ำหนักไม่แพ้กัน
ลองเทียบกับทีมขาย พนักงานที่อ่านคู่มือมากขึ้นไม่ได้ปิดการขายเก่งขึ้นเสมอไป หากอ่านข้อมูลผิด ได้รับ feedback ไม่ตรงจุด หรือถูกวัดผลจากจำนวนสายโทรมากกว่าคุณภาพการสนทนา AI ก็เช่นเดียวกัน
ดังนั้น เวลาประเมิน Grok 4.8 หรือ AI รุ่นใหม่ เราควรดูเกณฑ์ที่ใกล้งานของเรา ไม่ใช่ดูแค่ parameter หรือ benchmark รวม เช่น
- ร่างข้อความขายที่สอดคล้องกับน้ำเสียงแบรนด์ได้หรือไม่
- สรุปข้อมูลลูกค้าโดยไม่ตกหล่นสาระสำคัญหรือไม่
- ตอบคำถามหลายเงื่อนไขได้ครบและตรวจสอบย้อนกลับได้หรือไม่
- ใช้ภาษาไทย ชื่อสินค้า และข้อมูลเฉพาะของธุรกิจได้แม่นเพียงใด
- ต้นทุนต่อชิ้นงานและเวลาที่คนต้องเข้ามาแก้ ลดลงจริงหรือไม่
Step 4: เรียนรู้จากปัญหา Grok 4.7 ว่าการปรับจูนผิดอาจทำให้ model แย่ลง
ประเด็นที่มีค่าที่สุดในคลิป คือคำอธิบายความเสี่ยงของ reinforcement learning หลังจาก model ผ่านการฝึกหลักแล้ว ทีมพัฒนาจะให้ feedback กับคำตอบ เพื่อสอนว่าแบบใดควรทำซ้ำและแบบใดควรหลีกเลี่ยง
กรณี Grok 4.7 ที่คลิปวิเคราะห์ คือ model อาจถูกลงโทษกับคำตอบที่ยาวเกินไปมากเกินควร ผลคือมันเรียนรู้ว่า “ตอบสั้น” สำคัญกว่า “คิดให้จบ” เมื่อเจอโจทย์ยาก จึงอาจหยุดก่อน ตรวจทานเหตุผลน้อยลง หรือยอมแพ้ในงานที่เดิมทำได้
แม้รายละเอียดเชิงเทคนิคนี้ยังไม่ได้มีเอกสารทางการจาก xAI ออกมายืนยันครบถ้วน ประเด็นนี้จึงควรอ่านเป็นคำอธิบายของผู้เล่า ไม่ใช่ข้อสรุปยืนยันสาเหตุของ Grok 4.7 การจูน model ไม่ใช่แค่เก็บรายละเอียดท้ายงาน เพราะมันปรับพฤติกรรมของ model ได้ถึงระดับพื้นฐาน
นี่คือจุดที่เราเห็นต่างกับความตื่นเต้นเรื่อง model ใหม่เพียงอย่างเดียว หากธุรกิจบังคับ AI ให้ “สั้นที่สุด” “ตอบเร็วที่สุด” หรือ “ผลิตได้มากที่สุด” โดยไม่กำหนดจุดตรวจคุณภาพ สุดท้ายอาจได้งานที่ดูเรียบร้อย แต่ผิดข้อมูล สำคัญไม่ครบ หรือใช้ไม่ได้จริง
ตัวอย่างกับธุรกิจไทย
ร้านค้าออนไลน์อาจใช้ AI ตอบแชตลูกค้า หาก prompt เน้นว่า “ตอบสั้นที่สุดเพื่อปิดการขาย” AI อาจตอบราคาทันทีแต่ลืมถามรุ่น สี จำนวน หรือพื้นที่จัดส่ง ผลคือทีมต้องตามแก้ในภายหลัง
ทางที่ดีกว่า คือให้ workflow แยกงานเป็นขั้นตอน เริ่มจากเก็บข้อมูลที่ต้องใช้ ตรวจสอบสต็อกหรือเงื่อนไขที่เกี่ยวข้อง สร้างคำตอบ แล้วส่งต่อให้คนอนุมัติในเคสที่มีส่วนลดสูง การคืนสินค้า หรือคำร้องเรียนรุนแรง AI ช่วยเร่งงานได้ แต่ไม่ควรถูกบังคับให้เร็วเสียจนข้ามขั้นคิด
Step 5: สร้าง workflow ที่พร้อมทดสอบ Grok 4.8 โดยไม่ต้องรอวันเปิดตัว
สิ่งที่ควรทำตอนนี้ไม่ใช่เขียนระบบผูกกับ Grok 4.8 แต่คือจัดงานของเราให้เป็นระบบที่ทดสอบ model ได้ง่าย เมื่อมีช่องทางใช้งานจริง ไม่ว่าจะเป็นหน้าเว็บหรือ API จาก xAI เราจะเปรียบเทียบกับเครื่องมือเดิมได้ทันที
เริ่มจากเลือกงานหนึ่งงานที่ทำซ้ำบ่อยและมีผลลัพธ์ชัดเจน เช่น การสรุป lead จากแชต การร่างโพสต์ขาย การจัดหมวดคำถามลูกค้า หรือการสรุปรายงานประชุม อย่าเริ่มพร้อมกันสิบงาน เพราะจะไม่รู้ว่าอะไรคือสาเหตุของผลลัพธ์ที่ดีหรือแย่
จากนั้นเตรียมชุดตัวอย่างจริง 20 ถึง 30 เคส โดยลบข้อมูลส่วนบุคคลและข้อมูลอ่อนไหวก่อน แล้วให้ model หลายตัวทำงานชุดเดียวกัน วัดจากเกณฑ์ธุรกิจ ไม่ใช่ความรู้สึกเพียงอย่างเดียว
Actionable Insights
- เลือก use case เดียวก่อน: เริ่มจากงานที่เสียเวลาซ้ำทุกสัปดาห์และวัดเวลาได้ เช่น สรุป lead หรือร่างคำตอบ FAQ
- เขียนเกณฑ์ตรวจงาน 5 ข้อ: ความถูกต้อง ความครบถ้วน น้ำเสียง ขั้นตอนถัดไป และจุดที่ต้องส่งต่อคน
- เก็บ prompt เป็นทรัพย์สินทีม: บันทึก prompt เวอร์ชันที่ใช้ได้ พร้อมตัวอย่าง input และ output แทนการเก็บไว้กับคนใดคนหนึ่ง
- ทำ A/B test แบบเล็ก: ให้ AI เดิมและ Grok รุ่นใหม่ทำงานชุดเดียวกัน แล้วเทียบเวลาที่ต้องแก้และคุณภาพผลลัพธ์
- กำหนด human approval: งานที่เกี่ยวกับราคา สัญญา การเงิน ข้อมูลลูกค้า และคำมั่นสัญญาต่อสาธารณะ ต้องมีคนตรวจเสมอ
Step 6: แก้ปัญหาที่มักเจอเมื่อเอา AI ไปใช้ในงานธุรกิจ
ปัญหา: AI ตอบสั้น แต่ตกหล่นรายละเอียดสำคัญ
สาเหตุ: prompt เน้นความกระชับโดยไม่กำหนดข้อมูลขั้นต่ำที่ต้องมี
วิธีแก้: ระบุ checklist ใน prompt เช่น ชื่อสินค้า ราคา เงื่อนไข ข้อควรถามเพิ่ม และขั้นตอนถัดไป แล้วให้ AI ตรวจรายการก่อนส่งคำตอบ
ปัญหา: ผลลัพธ์ดูดี แต่ทีมต้องแก้แทบทุกครั้ง
สาเหตุ: ใช้คำสั่งกว้างเกินไป และไม่ได้ใส่ตัวอย่างงานที่ดีของแบรนด์
วิธีแก้: ให้ตัวอย่างก่อนและหลังแก้ 3 ถึง 5 ชิ้น ระบุกลุ่มลูกค้า น้ำเสียง คำต้องห้าม และรูปแบบผลลัพธ์ที่ต้องการ
ปัญหา: เปลี่ยน model แล้ว workflow พัง
สาเหตุ: ขั้นตอนงานผูกกับคำสั่งหรือรูปแบบ output ของเครื่องมือเดียว
วิธีแก้: แยก prompt ออกจากระบบหลัก บังคับ output เป็นหัวข้อหรือโครงสร้างตายตัว และมีขั้นทดสอบก่อนเปลี่ยน model ในงานจริง
ปัญหา: ทีมเชื่อคำตอบ AI มากเกินไป
สาเหตุ: ไม่มีการแบ่งระดับความเสี่ยงของงาน และไม่มีคนรับผิดชอบผลลัพธ์สุดท้าย
วิธีแก้: กำหนดงานสีเขียวสำหรับเผยแพร่ได้หลังตรวจเบา งานสีเหลืองต้องตรวจโดยเจ้าของงาน และงานสีแดงห้ามให้ AI ตัดสินใจเอง
Step 7: ต่อยอดจาก chatbot ไปสู่ระบบทำงานที่วัดผลได้
แนวคิดจาก Grok 4.8 ชวนให้มองไกลกว่าแค่การพิมพ์ถามตอบ เพราะหาก model เร็วขึ้นและเข้าถึงผ่าน API ได้พร้อมขึ้น ธุรกิจสามารถต่อยอด workflow ให้เชื่อมกับข้อมูลและขั้นตอนการทำงานจริงได้มากขึ้น
- ศูนย์รวมเสียงลูกค้า: รวบรวมคำถามจาก LINE, Facebook และอีเมล แล้วให้ AI จัดกลุ่มปัญหา สรุปหัวข้อที่ถูกถามซ้ำ และเสนอเนื้อหาสำหรับ FAQ
- ระบบเตรียม lead ก่อนส่งเซลส์: ให้ AI สรุปความต้องการ งบประมาณ ความเร่งด่วน และข้อกังวลจากบทสนทนา เพื่อให้ทีมขายเริ่มคุยจากข้อมูลที่ครบขึ้น
- คลังความรู้ภายใน: ใช้คู่มือการทำงาน นโยบายสินค้า และคำตอบมาตรฐานเป็นฐานให้ทีมค้นหา โดยต้องกำหนดสิทธิ์เข้าถึงข้อมูลให้รอบคอบ
การต่อยอดที่ดีไม่ใช่การใส่ AI ทุกจุด แต่คือการเลือกจุดที่ความเร็วของ AI ช่วยลดงานซ้ำ ขณะที่คนยังได้ใช้เวลาไปกับการตัดสินใจ ความสัมพันธ์ลูกค้า และงานที่ต้องอาศัยความรับผิดชอบ
Step 8: สรุป Checklist ทั้งหมดก่อนทดลองใช้ Grok 4.8
- ☐ แยกให้ชัดว่าอะไรคือข่าวประกาศ และอะไรคือ feature ที่เปิดใช้จริง
- ☐ ไม่ตัดสิน model จากจำนวนพารามิเตอร์เพียงตัวเดียว
- ☐ รอผลทดสอบ ราคา ช่องทางเข้าถึง และความสามารถด้านภาษาไทยก่อนลงทุน
- ☐ เลือก workflow เดียวที่มีปัญหาชัดเจนเพื่อเริ่มทดสอบ
- ☐ เตรียมตัวอย่างงานจริงโดยปกปิดข้อมูลอ่อนไหว
- ☐ กำหนดเกณฑ์วัดความถูกต้อง ความครบถ้วน เวลา และต้นทุน
- ☐ เขียน prompt เป็นมาตรฐานของทีม พร้อมตัวอย่าง output ที่ต้องการ
- ☐ เปรียบเทียบ Grok 4.8 กับ AI เดิมบนชุดงานเดียวกัน
- ☐ วางจุด human approval สำหรับงานเสี่ยง
- ☐ เก็บผลการทดสอบและค่อยขยายเฉพาะ workflow ที่พิสูจน์แล้วว่าคุ้มค่า
Grok 4.8 น่าสนใจเพราะ xAI กำลังเดิมพันทั้งกับ model ขนาด 2.5 ล้านล้านพารามิเตอร์และโครงสร้าง C++ ที่อาจเร่งรอบพัฒนาได้มากขึ้น แต่บทเรียนจาก Grok 4.7 เตือนเราว่า AI ที่ใหญ่ขึ้นหรือเร็วขึ้นไม่ได้รับประกันงานที่ดีกว่า ธุรกิจที่ได้เปรียบจึงไม่ใช่ธุรกิจที่วิ่งตามทุกข่าว แต่เป็นธุรกิจที่มี workflow ชัด วัดผลเป็น และพร้อมเลือก model ที่พิสูจน์คุณค่าได้จริง