ถ่ายทอดจากบทความต้นทางลงวันที่ 15 กันยายน 2026 และคลิป Your Voice Agent is Just a Walkie Talkie โดย Neil Zeghidour แห่ง Gradium บนช่อง AI Engineer เป็นมุมมองและตัวอย่างของผู้บรรยายต่อสถาปัตยกรรมเสียงในช่วงที่บันทึกคลิป ไม่ใช่ผลจัดอันดับหรือข้อจำกัดถาวรของโมเดลทุกตัว ยังไม่ได้ทดสอบซ้ำ ตัวอย่างธุรกิจไทยคงจากบทความเดิม วันที่นี้เป็นวันที่บทความต้นทาง ไม่ใช่วันอัปโหลดวิดีโอซึ่งยังไม่ทราบ
เสียงที่ฟังเป็นธรรมชาติไม่เท่ากับระบบที่ทำงานให้ธุรกิจได้จริง และระบบที่ทำงานเก่งก็อาจยังคุยติดขัดเหมือนกดปุ่มผลัดกันพูด ประเด็นนี้สำคัญมากสำหรับธุรกิจที่กำลังลงทุนกับ AI รับสาย, AI ฝ่ายขาย, หรือผู้ช่วยตอบคำถามลูกค้า
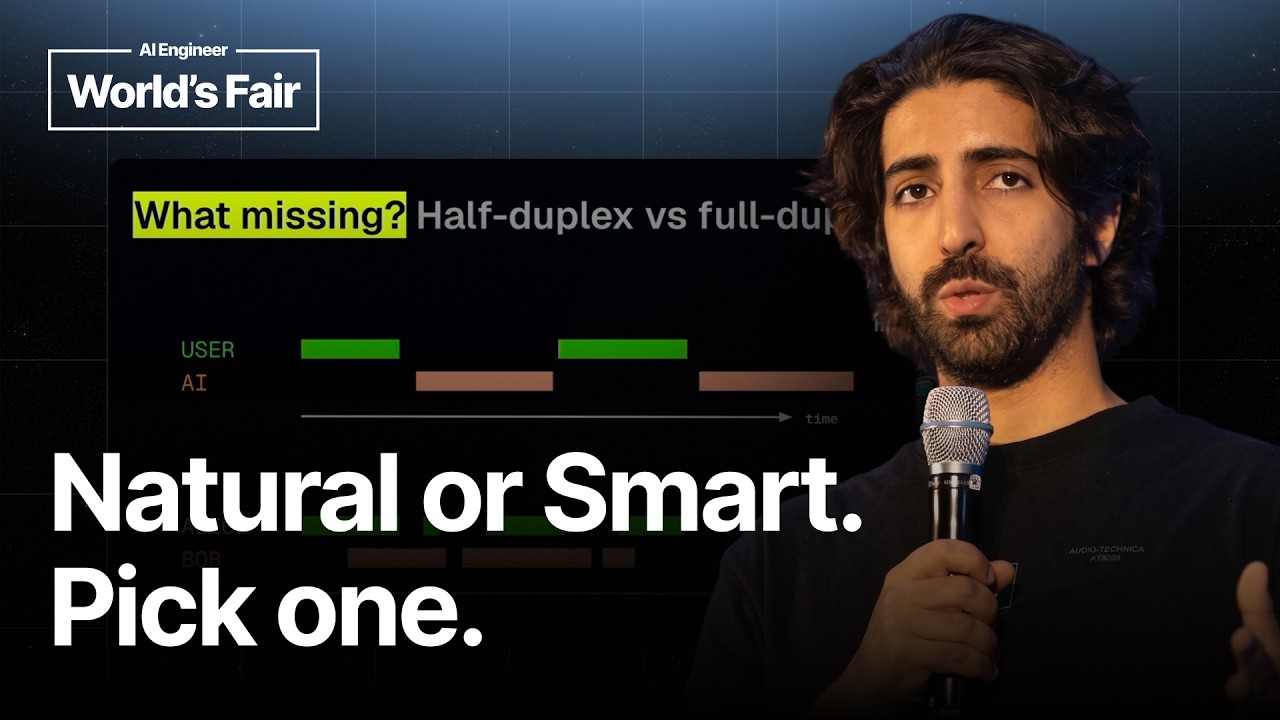
เนื้อหาจาก Neil Zeghidour แห่ง Gradium บนช่อง AI Engineer เสนอข้อสังเกตจากช่วงที่บันทึกคลิปว่า Voice Agent ส่วนใหญ่ยังทำงานแบบ half-duplex คือ AI จะฟังหรือพูดได้ทีละอย่าง คล้ายวอล์กกี้ทอล์กกี้ ไม่ใช่บทสนทนาแบบมนุษย์ที่มีการตอบรับสั้น ๆ พูดทับ หรือเว้นจังหวะตามธรรมชาติ
แต่บทเรียนที่มีค่าที่สุดสำหรับเจ้าของธุรกิจไทยไม่ใช่การรีบไล่หาโมเดลเสียงที่ใหม่ที่สุด แต่คือการเลือก architecture ให้ตรงกับงาน ระหว่างความลื่นไหลของบทสนทนา ความฉลาดในการใช้ข้อมูลและเครื่องมือ ต้นทุนต่อสาย และความสามารถในการเปลี่ยน provider ในอนาคต
Step 1: แยกให้ออกระหว่าง AI ที่คุยได้ กับ AI ที่ทำงานได้
วิวัฒนาการของ Voice Agent เริ่มจากผู้ช่วยแบบ Siri ในช่วงแรก ระบบรับเสียง แปลงเป็นข้อความ ตีความว่าเป็นคำสั่งประเภทใด แล้วส่งต่อไปยังแอปหรือบริการที่เกี่ยวข้อง เช่น เช็กอากาศหรือหุ้น จุดเด่นคือทำคำสั่งที่กำหนดไว้ได้ แต่บทสนทนาถูกจำกัดมาก
เมื่อ LLM เข้ามา ระบบสามารถคุยเรื่องปลายเปิดได้ดีขึ้นมาก ตัวอย่างเช่น เล่านิทาน แต่งเรื่อง หรือช่วยระดมไอเดียได้ ทว่าความสามารถนี้ยังไม่เท่ากับการเป็น agent เพราะการสนทนาที่ดีไม่ได้แปลว่า AI เชื่อมระบบหลังบ้าน ตรวจข้อมูล หรือดำเนินการแทนเราได้
จุดแบ่งที่ธุรกิจต้องใช้วัดผลจึงไม่ใช่เพียงคำถามว่า “เสียงเหมือนคนไหม” แต่คือคำถามต่อไปนี้
- AI ตรวจข้อมูลสินค้าคงเหลือได้หรือไม่
- AI เปิดเคสบริการลูกค้า หรือนัดหมายในปฏิทินได้หรือไม่
- AI ทวนรายละเอียดก่อนทำรายการสำคัญได้หรือไม่
- AI ส่งต่อพนักงานพร้อมข้อมูลสรุปได้หรือไม่
- AI บันทึกผลลัพธ์เข้าสู่ CRM, POS หรือระบบจองได้หรือไม่
ตัวอย่างในเนื้อหาคือ agent รับออร์เดอร์แบบ drive-through ที่ถามประเภทแซนด์วิช รับรายการเพิ่ม สรุปคำสั่งซื้อ และคำนวณราคา นี่คือ Voice Agent ที่มีความหมายต่อธุรกิจ เพราะมันเก็บ state ของรายการและเตรียมทำขั้นตอนถัดไป ไม่ได้เพียงตอบกลับด้วยน้ำเสียงลื่นไหล
หากนำมาใช้กับธุรกิจไทย ภาพนี้อาจเป็น AI รับโทรศัพท์ร้านอาหารที่รับออร์เดอร์และส่งเข้าครัว, คลินิกที่ตรวจคิวแพทย์, โรงแรมที่เช็กห้องว่าง หรือทีมขายที่คัดกรองลูกค้าก่อนนัดหมาย การเริ่มต้นควรเลือกงานที่มีขั้นตอนชัดเจนและข้อมูลหลังบ้านพร้อมก่อนเสมอ
Step 2: เข้าใจข้อจำกัดของระบบเสียงแบบต่อท่อ
Voice Agent ที่ใช้งานเชิงธุรกิจส่วนมากยังเป็นระบบแบบต่อท่อ หรือ cascaded system โดยมีลำดับหลักคือ Speech-to-Text แปลงเสียงเป็นข้อความ, LLM ตีความและตัดสินใจ, จากนั้น Text-to-Speech สร้างเสียงตอบกลับ โครงสร้างนี้มีข้อดีชัดเจน คือใช้ text model ระดับแนวหน้าได้เต็มความสามารถ และเชื่อม tool call กับระบบธุรกิจได้ง่ายกว่า
ข้อแลกเปลี่ยนคือเวลา ทุกขั้นตอนเพิ่มความหน่วง เมื่อมีลูกค้าพูดจบ ระบบต้องรอถอดเสียง คิดคำตอบ เรียกข้อมูล และสร้างเสียงก่อนตอบ การรอเพียงไม่กี่วินาทีอาจทำให้การโทรรู้สึกติดขัด โดยเฉพาะงานที่มีคำถามสั้นต่อเนื่อง เช่น รับออร์เดอร์หรือคัดกรองลูกค้า
อีกปัญหาคือข้อมูลบางส่วนหายไประหว่างแปลงเป็นข้อความ น้ำเสียง ความลังเล ความเร่งรีบ อารมณ์ หรือเจตนาที่ซ่อนอยู่ในจังหวะพูด อาจไม่เหลืออยู่ในข้อความที่ส่งให้ LLM ตัวอย่างเช่น ประโยค “ได้ครับ” ที่มีน้ำเสียงประชด กังวล หรือยืนยันจริง มีความหมายต่อการบริการไม่เท่ากัน
อย่างไรก็ตาม ไม่ควรสรุปว่าระบบต่อท่อเป็นของล้าสมัย สำหรับงานที่ต้องการความแม่นยำในการเรียกข้อมูล ใช้กฎอนุมัติ ทำรายการ หรือบันทึกผลลงระบบ นี่มักเป็นตัวเลือกที่เหมาะกว่า เพราะธุรกิจยังควบคุม logic, tool และ model ฝั่งข้อความได้
แนวทางประเมินที่รอบคอบคือแยก KPI เป็นสองชุด ได้แก่ คุณภาพบทสนทนา เช่น เวลาตอบกลับ การขัดจังหวะ และอัตราการหลุดสาย กับ คุณภาพงาน เช่น อัตราการบันทึกออร์เดอร์ถูกต้อง การนัดหมายสำเร็จ และจำนวนเคสที่ต้องแก้ไขโดยพนักงาน
Step 3: วัดปัญหา turn-taking ก่อนตัดสินว่าเสียง AI ไม่ดี
แม้โมเดล speech-to-speech จะลดขั้นตอนผ่านข้อความและตอบได้เร็วขึ้น แต่ส่วนใหญ่ยังมีข้อจำกัดเรื่อง turn-taking ระบบจะแบ่งบทสนทนาเป็นรอบชัดเจน คือฝ่ายหนึ่งพูด อีกฝ่ายฟัง เมื่อ AI ตรวจพบเสียงแทรกเพียงเล็กน้อย ก็อาจหยุดพูดทันทีหรือคิดว่าอีกฝ่ายต้องการขัดจังหวะ
สำหรับมนุษย์ การพูดว่า “อือ”, “ครับ”, “ใช่เลย” ระหว่างอีกฝ่ายพูด เป็น backchanneling หรือสัญญาณว่ากำลังฟังอยู่ ไม่ได้แปลว่าต้องการยึดบทสนทนา แต่ AI แบบ half-duplex มักตีความผิด จึงเกิดประสบการณ์ที่ทั้งช้าและน่าหงุดหงิด แม้ความหน่วงเชิงเทคนิคจะต่ำมากแล้วก็ตาม
งานนำเสนอชี้ว่า ในการคุยโทรศัพท์ระหว่างคนสองคน อาจมีช่วงที่พูดทับกันได้มากถึง 20 เปอร์เซ็นต์ของเวลา นี่ทำให้คำว่า “ตอบไว” ไม่พอสำหรับวัดประสบการณ์เสียง เราต้องดูด้วยว่า AI รู้จักสัญญาณตอบรับสั้น ๆ รู้ว่าควรหยุดเมื่อไร และรับมือกับเสียงรบกวนหรือการพูดแทรกได้ดีเพียงใด
สำหรับธุรกิจไทย ปัญหานี้ยิ่งควรทดสอบกับภาษาจริง เพราะการพูดภาษาไทยมีคำลงท้ายและคำตอบรับถี่ เช่น “ค่ะ”, “ครับ”, “อ๋อ”, “ได้ ๆ” หากระบบตีทุกคำเป็นการขัดจังหวะ สายสนทนาจะสะดุดตั้งแต่เริ่ม
ก่อนซื้อ platform ใด ควรเตรียมชุดทดสอบเสียงจริงอย่างน้อย 20 ถึง 30 สถานการณ์ เช่น ลูกค้าพูดเร็ว พูดซ้อนกับคนข้าง ๆ เปลี่ยนใจกลางประโยค ถามซ้ำ มีเสียงรถหรือร้านค้า และตอบรับสั้น ๆ ระหว่าง AI อธิบาย ระบบที่สาธิตได้ดีในห้องเงียบอาจยังไม่เหมาะกับสายใช้งานจริง
Step 4: รู้จัก full-duplex โดยไม่หลงกับคำโฆษณา
แนวคิด full-duplex คือ AI ฟังและพูดได้พร้อมกัน คล้ายการคุยระหว่างคนสองคน แนวทางที่ Neil อธิบายใช้ multi-stream language model ที่ประมวลผล token เสียงของผู้ใช้และ AI เป็นคนละ stream จึงรองรับช่วงที่ทั้งสองฝ่ายพูด พร้อมเงียบ หรือมีฝ่ายใดฝ่ายหนึ่งพูดได้
เทคโนโลยีนี้ต้องอาศัยการแปลงเสียงให้เป็น audio token ก่อน เพราะเสียงดิบมีข้อมูลมหาศาล ประโยคเพียงไม่กี่คำอาจกลายเป็นข้อมูลหลายหมื่นช่วงเวลา การนำเสียงดิบเข้า LLM ตรง ๆ จึงแพงเกินจริงเนื่องจากต้นทุน attention แบบเต็มโตขึ้นตามความยาวของลำดับข้อมูลแบบกำลังสองในสถาปัตยกรรมที่ผู้บรรยายอธิบาย
Neural codec หรือ audio tokenizer จึงเข้ามาบีบอัดเสียงให้เป็นตัวแทนที่กระชับ แล้วให้โมเดลเรียนรู้จาก token เหล่านั้นแทน ผู้ที่ไม่ใช่สายเทคนิคไม่จำเป็นต้องสร้างสิ่งนี้เอง แต่ควรเข้าใจว่าเหตุใด AI เสียงจึงมีต้นทุนและข้อจำกัดต่างจาก chatbot ข้อความ
full-duplex เหมาะกับงานที่ความรู้สึกของการคุยเป็นสินค้า เช่น ผู้ช่วยสอนภาษา ผู้ช่วยโค้ช เกม ตัวละครดิจิทัล หรือการสนทนาเพื่อสร้างความสัมพันธ์ แต่สำหรับงานรับชำระเงิน เปลี่ยนที่อยู่ จองบริการ หรือรับคำสั่งซื้อ ความลื่นไหลต้องไม่แซงความถูกต้องและการยืนยันรายการ
มุมมองที่ควรระวังคือ full-duplex ไม่ใช่ใบรับรองว่า AI ฉลาดกว่า มันแก้ปัญหาวิธีการคุย ไม่ได้แก้ปัญหาความรู้ ข้อเท็จจริง หรือสิทธิ์ในการทำรายการ
Step 5: เลือก architecture จากงาน ไม่ใช่จากความตื่นเต้น
ประเด็นที่ตรงไปตรงมาที่สุดของ Neil Zeghidour คือความตึงเครียดระหว่าง naturalness และ intelligence โมเดลที่รับฟังและสร้างเสียงโดยตรงต้องใช้ความจุของ model เพื่อเข้าใจเสียง น้ำเสียง และการตอบโต้แบบมนุษย์ ความจุส่วนนั้นอาจไม่เหลือให้ reasoning, การใช้เครื่องมือ และความน่าเชื่อถือในการทำงานซับซ้อนเท่า text model ระดับสูง
เส้นทางอนาคตมีสองแบบ แบบแรกคือสร้างโมเดล speech-to-speech ขนาดใหญ่ให้เก่งขึ้นเรื่อย ๆ ข้อดีคือรวมทุกอย่างไว้ในโมเดลเดียว การดูแลระบบอาจเรียบง่าย แต่ต้นทุนการฝึกและการอัปเกรดสูงมาก
แบบที่สองคือ hybrid architecture แยก “หน้าบ้านที่คุยเก่ง” ออกจาก “สมองหลังบ้านที่คิดเก่ง” โมเดลเสียงขนาดเล็กทำหน้าที่รักษาจังหวะการคุย รับสัญญาณทางเสียง และรู้ว่าเมื่อไรควรส่งคำขอไปให้ text LLM ฝั่งหลังบ้านคิด วางแผน เรียก tool หรือค้นฐานความรู้
แนวทาง hybrid น่าสนใจสำหรับธุรกิจ เพราะทำให้เราสลับ text model ได้เมื่อมีตัวเลือกที่ดีกว่า ไม่ติดกับ provider เสียงรายเดียว และไม่ต้องจ่ายค่าระบบ multimodal ขนาดใหญ่ให้กับการทักทายหรือบทสนทนาง่าย ๆ ทุกประโยค
หลักคิดสำหรับการตัดสินใจมีดังนี้
- งานที่ความถูกต้องสูง: ใช้ cascaded หรือ hybrid โดยให้ text LLM และกฎธุรกิจเป็นผู้ตัดสินใจ
- งานสนทนาสบาย ๆ: ให้ความสำคัญกับ speech-to-speech และ full-duplex มากขึ้นได้
- งานปริมาณสายสูง: วัดต้นทุนต่อนาทีและอัตราส่งต่อพนักงาน ไม่ใช่ดูค่าใช้จ่าย API เพียงบรรทัดเดียว
- งานที่เปลี่ยนบ่อย: เลือก architecture ที่เปลี่ยน model และแก้ knowledge base ได้โดยไม่ต้องรื้อระบบเสียง
Step 6: เปลี่ยนแนวคิดเป็น Actionable Insights สำหรับทีมงาน
- เริ่มจากหนึ่ง workflow: เลือกงานรับสายที่ซ้ำและมีปลายทางชัด เช่น เช็กสถานะนัดหมาย แทนการสร้าง AI ที่ตอบได้ทุกเรื่องตั้งแต่วันแรก
- ออกแบบทางหนีให้พนักงาน: กำหนดเงื่อนไขส่งต่อ เช่น ลูกค้าพูดซ้ำเกินจำนวนที่ตั้งไว้ ขอข้อยกเว้น หรือเป็นเรื่องการเงินและข้อร้องเรียน
- บังคับให้ AI ทวนก่อนทำรายการ: ทุกออร์เดอร์ นัดหมาย หรือการแก้ข้อมูลสำคัญควรมีข้อความสรุปและคำยืนยัน
- ทำชุดทดสอบภาษาไทย: รวมสำเนียง คำย่อ ชื่อสินค้า เสียงรบกวน และการพูดแทรกจากการโทรจริงก่อนเปิดใช้
- แยกชั้นเสียงออกจากชั้นธุรกิจ: เก็บข้อมูลสินค้า ราคา โปรโมชัน และกฎอนุมัติไว้ในระบบที่แก้ไขได้ ไม่ฝังทุกอย่างลงใน prompt ของโมเดล
Step 7: แก้ปัญหาที่มักเจอเมื่อเริ่มใช้ Voice Agent
ปัญหา: AI รับออร์เดอร์ผิดเมื่อมีการเปลี่ยนใจกลางประโยค
สาเหตุ: ระบบไม่เก็บ state ของรายการอย่างเป็นระบบ หรือรีบทำ tool call ก่อนลูกค้าพูดจบ
วิธีแก้:
- แยกขั้นตอนรับข้อมูล แก้ไขรายการ และยืนยันรายการให้ชัด
- ให้ AI อ่านสรุปตะกร้าสินค้าทุกครั้งก่อนส่งเข้าระบบ
- บันทึกเหตุการณ์ที่ลูกค้าแก้คำสั่งซื้อ เพื่อนำไปปรับ flow
ปัญหา: AI หยุดพูดทุกครั้งที่ลูกค้าพูดว่า “ครับ” หรือ “อือ”
สาเหตุ: ระบบ half-duplex ตีความ backchanneling เป็นการขัดจังหวะ
วิธีแก้:
- ทดสอบการพูดตอบรับสั้น ๆ กับ provider แต่ละราย
- กำหนดช่วงเวลารอและเกณฑ์ตรวจจับการขัดจังหวะให้เหมาะกับภาษาไทย
- หากงานเน้นการคุยต่อเนื่อง ให้พิจารณา full-duplex หรือ hybrid interface
ปัญหา: AI พูดดีแต่ตอบข้อมูลผิด
สาเหตุ: ใช้ LLM ตอบจากความรู้ทั่วไปแทนการดึงข้อมูลจากระบบจริง
วิธีแก้:
- เชื่อมข้อมูลสินค้า ราคา และสถานะบริการจากแหล่งข้อมูลที่กำหนด
- ห้าม AI เดาราคา สต๊อก หรือเงื่อนไขที่มีผลต่อการซื้อ
- ตั้งให้ AI บอกว่าไม่พบข้อมูลและส่งต่อเมื่อข้อมูลไม่ครบ
ปัญหา: ต้นทุนต่อสายสูงเกินคาด
สาเหตุ: ใช้โมเดลเสียงและ reasoning ขนาดใหญ่กับทุกช่วงของบทสนทนา รวมถึงงานง่าย ๆ
วิธีแก้:
- วัดต้นทุนต่อนาทีแยกตามประเภทสาย
- ใช้ flow หรือระบบที่เบากว่าสำหรับการยืนยันตัวตนและคำถามซ้ำ
- ส่งงาน reasoning หรือ tool call ไปยัง model หลังบ้านเฉพาะเมื่อจำเป็น
Step 8: ต่อยอดจาก AI รับสายสู่ระบบบริการที่เรียนรู้ได้
แนวคิดแรกคือสร้าง คลังบทสนทนาที่ใช้ปรับงาน โดยจัดหมวดคำถามที่ AI รับมือไม่ได้ เหตุผลที่ต้องส่งต่อ และขั้นตอนที่ลูกค้ายกเลิกกลางสาย ข้อมูลนี้จะบอกว่าธุรกิจควรแก้ knowledge base, ปรับ workflow หรือเพิ่มพนักงานตรงจุดใด
แนวคิดที่สองคือใช้ Voice Agent เป็นด่านหน้า แล้วให้พนักงานรับช่วงเฉพาะเคสสำคัญ พร้อมสรุปข้อมูล เช่น ชื่อลูกค้า ความต้องการ รายการที่คุย และจุดที่ติดขัด วิธีนี้ลดเวลาพนักงานถามซ้ำ แต่ยังรักษาการตัดสินใจของมนุษย์ในเรื่องละเอียดอ่อน
แนวคิดที่สามคือเชื่อมเสียงกับช่องทางข้อความและ CRM ให้เป็น customer journey เดียวกัน หลังจบสาย ระบบอาจส่งสรุปการนัดหมายหรือรายการสินค้าไปยังช่องทางที่ธุรกิจใช้อยู่ โดยต้องขอความยินยอมและดูแลข้อมูลส่วนบุคคลตามกฎหมาย PDPC ของไทย เป็นแหล่งอ้างอิงที่ควรศึกษาเมื่อต้องจัดการข้อมูลลูกค้าผ่านระบบอัตโนมัติ
Step 9: สรุป Checklist ก่อนเปิดใช้ Voice Agent
- ☐ ระบุ workflow เดียวที่ AI ต้องทำให้สำเร็จ
- ☐ แยกเป้าหมายเรื่องคุณภาพการคุยออกจากความถูกต้องของงาน
- ☐ เชื่อม AI กับแหล่งข้อมูลจริงและกำหนดสิทธิ์การทำรายการ
- ☐ ออกแบบการยืนยันก่อนสร้างออร์เดอร์ นัดหมาย หรือเปลี่ยนข้อมูล
- ☐ ตั้งเงื่อนไขส่งต่อพนักงานสำหรับเคสซับซ้อนและเคสเสี่ยง
- ☐ ทดสอบสำเนียงไทย เสียงรบกวน คำตอบรับสั้น ๆ และการพูดแทรก
- ☐ วัดเวลาตอบ อัตรางานสำเร็จ อัตราส่งต่อ และต้นทุนต่อนาที
- ☐ เลือก architecture แบบ cascaded, speech-to-speech หรือ hybrid ให้ตรงกับงาน
- ☐ แยกชั้นเสียง ชั้นข้อมูล และกฎธุรกิจ เพื่อเปลี่ยน model ได้ภายหลัง
- ☐ เก็บข้อผิดพลาดจากสายจริงมาปรับ workflow อย่างต่อเนื่อง
บทสรุปคือ Voice Agent ที่ดีไม่จำเป็นต้องเหมือนมนุษย์ที่สุดตั้งแต่วันแรก แต่ต้องคุยในระดับที่ไม่สร้างแรงเสียดทาน และทำงานที่ได้รับมอบหมายได้ถูกต้อง ตรวจสอบได้ และคุ้มต้นทุน ธุรกิจที่ชนะจะไม่ใช่ธุรกิจที่มีเสียง AI น่าตื่นเต้นที่สุด แต่คือธุรกิจที่ออกแบบระบบหลังบ้านให้ AI ช่วยปิดงานได้จริง
แหล่งที่มา: Your Voice Agent is Just a Walkie Talkie — Neil Zeghidour, Gradium · บทความต้นทาง