วันที่ต้นฉบับ: 3 กันยายน 2026 · แหล่งที่มา: วิดีโอต้นทางบน YouTube · รายละเอียดของเครื่องมือและตัวอย่างอ้างอิงตามต้นฉบับในวันที่ระบุ
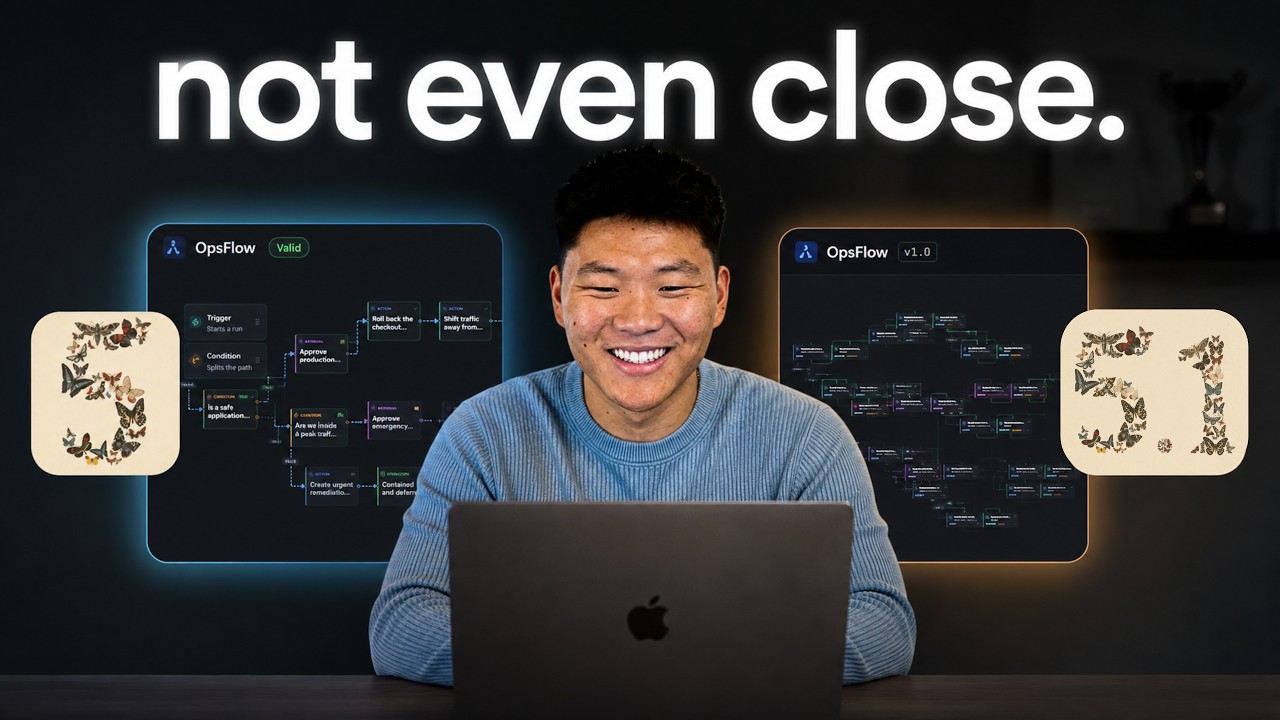
การให้ AI สร้างแอปไม่ใช่แค่เรื่องว่า “ทำได้ไหม” แต่คือ “ได้งานระดับไหนต่อเงินและเวลาที่จ่ายไป” การทดลองจากคลิปของ Nate Herk | AI Automation ให้ Fable 5 และ Fable 5.1 รับ prompt เดียวกัน สร้างแอปเดียวกัน แล้วพบผลต่างที่เจ้าของธุรกิจควรหยุดคิด
Fable 5.1 ได้คะแนนคุณภาพสูงกว่าเล็กน้อย แต่ใช้เงินราว 1,200 ดอลลาร์และเวลา 36 ชั่วโมง ส่วน Fable 5 ใช้ประมาณ 500 ดอลลาร์และเสร็จใน 12 ชั่วโมง คำถามสำคัญจึงไม่ใช่ว่า model ไหน “เก่งกว่า” แต่คือ model ไหนเหมาะกับงานและข้อจำกัดของเรามากกว่า
สารบัญ
- Step 1: ตั้งโจทย์ให้เทียบกันอย่างยุติธรรม
- Step 2: ตรวจงานจากการใช้งานจริง ไม่ใช่หน้าตาแรกเห็น
- Step 3: นิยามคำว่า “งานดี” ด้วยเกณฑ์ที่วัดได้
- Step 4: คิดต้นทุนเป็นผลลัพธ์ ไม่ใช่ดูแค่คะแนน
- Step 5: เลือก model ตามชนิดของงาน ไม่ใช่ตามชื่อเวอร์ชัน
- Step 6: Actionable Insights สำหรับเจ้าของธุรกิจและคนทำงาน
- Step 7: Troubleshooting แก้ปัญหาที่มักเจอเมื่อนำ AI มาสร้างระบบ
- Step 8: การต่อยอดจากการทดลองนี้
- Step 9: สรุป Checklist ทั้งหมดก่อนจ้าง AI สร้างแอป
Step 1: ตั้งโจทย์ให้เทียบกันอย่างยุติธรรม
การทดสอบนี้ใช้ prompt เดียวกันแทบทั้งหมด ต่างกันเพียงระบุให้ agent แต่ละตัวทำงานในโฟลเดอร์ของตนเอง โจทย์คือสร้าง OpsFlow แอปแบบ local-first สำหรับวาดและจำลอง workflow รับมือเหตุขัดข้องในการทำงาน
หน้าที่ของแอปไม่ใช่ platform automation ที่สั่งงานระบบจริงแบบ n8n แต่เป็นพื้นที่ให้ทีมวางแผนเหตุฉุกเฉินเป็นแผนภาพ แล้วจำลองว่าเมื่อเกิดปัญหา ระบบและคนในทีมควรตัดสินใจอย่างไร เช่น API มีปัญหา ต้องขออนุมัติก่อน rollback หรือควรจบเหตุการณ์ด้วยแนวทางใด
จุดที่น่าสนใจคือ prompt ไม่ได้สั่งให้ AI ลงมือเขียนทุกอย่างเอง แต่กำหนดให้ agent ทำหน้าที่เป็นผู้จัดการงาน ประกอบด้วยการวางกลยุทธ์ แบ่งงาน จัดลำดับ คุมมาตรฐาน และตรวจรับงานขั้นสุดท้าย จากนั้นให้กระจายงานไปยัง worker ที่เหมาะสม
- ใช้ Opus สำหรับสถาปัตยกรรมผลิตภัณฑ์ แนวทางออกแบบ และการทบทวนโจทย์ยาก
- ใช้ Sonnet สำหรับการลงมือทำ วิจัย ทดสอบ แก้บั๊ก และปรับงานวนซ้ำ
- กำหนดว่า worker ที่ทำพลาดไม่ใช่ข้ออ้างของ agent หลัก เพราะเจ้าของงานยังต้องรับผิดชอบผลลัพธ์
- ห้ามหยุดแค่เมื่อแอป “ดูเหมือนทำงานได้” ต้องมีหลักฐานว่าผลิตภัณฑ์ทำงานครบและพร้อมนำเสนอ
นี่เป็นบทเรียนแรกที่นำมาใช้กับธุรกิจไทยได้ทันที หากเราสั่ง AI ว่า “ทำระบบจัดการลีดให้หน่อย” ผลลัพธ์มักคลุมเครือ แต่ถ้าเราระบุบทบาท งานที่ต้องส่ง เกณฑ์ผ่าน และกรณีผิดพลาดที่ต้องทดสอบ AI จะทำหน้าที่ใกล้เคียงทีมโปรเจกต์มากขึ้น
Step 2: ตรวจงานจากการใช้งานจริง ไม่ใช่หน้าตาแรกเห็น
แอปทั้งสองเวอร์ชันสร้าง node-based workflow ได้ มี trigger, condition, action, approval และ resolution ลากบล็อกลงบน canvas เชื่อมเป็นเส้นทาง และกดรันเพื่อดูการไหลของเหตุการณ์ได้จริง
Fable 5.1 ให้ความรู้สึกว่าจัดลำดับข้อมูลดี อ่าน canvas ง่าย และมีสถานะระหว่างรันที่มองเห็นชัด เช่น สำเร็จ ล้มเหลว ข้าม และกำลังรอการอนุมัติ หน้าสรุปผลการรันกับไฟล์ log ที่ดาวน์โหลดได้ก็เป็นจุดแข็ง เพราะช่วยให้ทีมย้อนตรวจเหตุการณ์ได้
Fable 5 มีข้อดีอีกแบบ คือมีตัวเลือกการเขียน workflow ที่ลึกกว่า มีเวลา autosave ชัดเจน มี preset สำหรับทดสอบกรณีผิดปกติ เช่น ไม่มีค่า severity และมี live preview เทียบกับ payload ปัจจุบัน จุดเหล่านี้สำคัญมากสำหรับงานที่ต้องรับมือข้อผิดพลาด ไม่ใช่แค่สร้างหน้าจอสวย
แต่มีรายละเอียดที่ควรมองให้ลึกกว่า UI ทั้งสองแบบ Fable 5.1 จำกัด trigger หนึ่งตัวให้เชื่อมได้เพียงเส้นทางเดียวในกรณีที่ทดลอง และทั้งสองแอปรับ schema สำหรับ import JSON ไม่เหมือนกัน ทั้งที่ได้รับโจทย์เดียวกัน
ประเด็น schema นี้ไม่ใช่เรื่องเล็ก หากธุรกิจจะสร้างเครื่องมือภายในหลายตัว ระบบที่ import หรือแลกข้อมูลกันไม่ได้ จะเพิ่มต้นทุนตอนขยายงานเสมอ สิ่งที่ดูเป็นเพียงความต่างของ implementation ในวันแรก อาจกลายเป็นภาระข้อมูลในอีกหกเดือนหลังจากนั้น
Step 3: นิยามคำว่า “งานดี” ด้วยเกณฑ์ที่วัดได้
ผู้จัดทำให้ Codex ประเมินแอปทั้งสองแบบโดยไม่บอกว่าเวอร์ชันใดเป็นของ Fable รุ่นไหน ผลการทดสอบแบบ blind test ให้ Fable 5.1 ได้คะแนนถ่วงน้ำหนัก 9.1 และ Fable 5 ได้ 8.4
Fable 5.1 นำในด้าน visual design, ลำดับชั้นข้อมูล, ความง่ายในการใช้งาน, ประสบการณ์ dry run และการตรวจสอบความปลอดภัย แม้คะแนนรวมต่างกันเพียง 0.7 คะแนน แต่ความต่างเชิงพฤติกรรมมีผลจริง ตัวอย่างหนึ่งคือเมื่อผู้ใช้ปฏิเสธการอนุมัติ เวอร์ชัน 5.1 ทำให้การรันล้มเหลว แทนที่จะบอกอย่างผิดๆ ว่าเหตุการณ์ได้รับการแก้ไขแล้ว
นี่คือแนวคิดที่เจ้าของธุรกิจควรยึดไว้: ระบบที่บอกว่าไม่สำเร็จอย่างถูกต้อง มีค่ามากกว่าระบบที่รายงานว่าสำเร็จแต่ข้อมูลไม่จริง โดยเฉพาะ workflow สำหรับการเงิน การอนุมัติราคา การส่งข้อมูลลูกค้า หรือการตอบแชตที่มีผลต่อยอดขาย
อย่างไรก็ดี คะแนน benchmark ไม่ควรเป็นคำตัดสินสุดท้าย เพราะ rubric สะท้อนน้ำหนักที่ผู้ทดสอบเลือก ธุรกิจร้านค้าออนไลน์อาจให้น้ำหนักกับความเร็วการทำแคมเปญมากกว่า interface ที่ละเอียด ส่วนบริษัทที่มีขั้นตอนอนุมัติอาจให้น้ำหนักกับ audit log และสถานะผิดพลาดมากกว่า
แนวทางที่ปลอดภัยคือเขียนเกณฑ์รับงานของเราเอง เช่น สร้างลูกค้าทดลอง 20 ราย ส่งคำสั่งซื้อซ้ำ จำลองยอดชำระไม่ผ่าน ตรวจสิทธิ์ผู้อนุมัติ และตรวจว่า log อธิบายสิ่งที่เกิดขึ้นได้หรือไม่ หลักคิดนี้สอดคล้องกับแนวทางจัดการความเสี่ยงของ NIST AI Risk Management Framework ที่เน้นการวัดและกำกับความเสี่ยงของ AI ตามกรณีใช้งานจริง
Step 4: คิดต้นทุนเป็นผลลัพธ์ ไม่ใช่ดูแค่คะแนน
Fable 5.1 ใช้เงินมากกว่าเท่าตัว ใช้เวลาประมาณ 36 ชั่วโมง และมีสัดส่วนการใช้ Opus ราว 57% กับ Sonnet ราว 40% ขณะที่ Fable 5 ใช้เวลาประมาณ 12 ชั่วโมง ใช้ Sonnet ราว 80% และใช้ Opus ในสัดส่วนต่ำกว่ามาก
ผลลัพธ์คือ 5.1 ทำงานได้คะแนนดีกว่า แต่ Fable 5 ใช้เงินน้อยกว่าราว 700 ดอลลาร์ ประเด็นที่ Nate Herk สรุปจึงเฉียบคมมาก สำหรับโจทย์นี้ Fable 5 เป็นผู้ชนะเมื่อคิดทั้งคุณภาพ เวลา และต้นทุน ไม่ใช่เพราะมันได้คะแนนสูงสุด แต่เพราะส่วนต่างของคะแนนอาจไม่คุ้มกับส่วนต่างของราคา
หากแปลงเป็นภาษาธุรกิจไทย สมมติเราต้องการเครื่องมือภายในสำหรับสรุปยอดขายและส่งแจ้งเตือนสต๊อก Fable 5 ที่ส่งงานได้ 85 ถึง 90% ของความต้องการภายในวันเดียว อาจคุ้มกว่าเวอร์ชันที่ดูดีกว่าเล็กน้อยแต่ใช้เวลาสามวันและเงินเพิ่มมาก เราอาจนำงบส่วนต่างไปจ้างคนตรวจงาน เพิ่ม test case หรือปรับ workflow รอบสอง ซึ่งมักให้ผลต่อการใช้งานจริงมากกว่า
อีกมุมหนึ่ง งานที่สัมผัสลูกค้าโดยตรง เช่น หน้าเว็บไซต์แบรนด์ ระบบสมัครสมาชิก หรือ dashboard ผู้บริหาร อาจสมเหตุผลที่จะลงทุนกับ model ที่ทำ information hierarchy และประสบการณ์ใช้งานได้ดีกว่า แต่ต้องตั้งเพดานงบและเกณฑ์ตัดสินใจล่วงหน้า
Step 5: เลือก model ตามชนิดของงาน ไม่ใช่ตามชื่อเวอร์ชัน
บทสรุปไม่ได้บอกว่า Fable 5 ดีกว่า Fable 5.1 ในทุกด้าน ผู้จัดทำยังเห็นว่า 5.1 เข้าใจเจตนาและทำงานความรู้ทั่วไปในแต่ละวันได้ดีขึ้น แต่เมื่อเป็นงานสร้างแอปที่ใช้ agent หลายชั้น 5 กลับให้ความคุ้มค่ากว่าในการทดลองนี้
สิ่งนี้เตือนเราว่า model ใหม่กว่าไม่ได้แปลว่าคุ้มกว่าทุก workflow เพราะผลลัพธ์ขึ้นกับการวางแผน การแบ่งงาน tool ที่เรียกใช้ ความถี่ในการวนแก้ และ model ลูกที่ถูกเลือกทำงานย่อยด้วย
ข้อสังเกตจากการทดลองนี้คือ อย่าซื้อความสามารถ AI แบบเหมารวม ให้ซื้อ “ผลลัพธ์ที่พิสูจน์ได้” แยกงานออกเป็นสองกลุ่มก่อนเสมอ
- งานสำรวจและต้นแบบ: เลือกทางที่เร็วและประหยัด เพื่อเรียนรู้ว่าโจทย์มีมูลค่าจริงหรือไม่
- งานสำคัญต่อรายได้หรือความเสี่ยง: ยอมเพิ่มงบกับการทดสอบ การตรวจโดยคน และ log ที่ตรวจย้อนหลังได้
Step 6: Actionable Insights สำหรับเจ้าของธุรกิจและคนทำงาน
- เริ่มจาก workflow เดียว: เลือกงานที่ซ้ำและวัดผลได้ เช่น รับลีดจาก Facebook ไปยัง CRM แล้วแจ้งเซลส์
- เขียน definition of done: ระบุข้อมูลเข้า ผลลัพธ์ที่ต้องได้ คนอนุมัติ และกรณีที่ระบบต้องหยุด
- ตั้งงบการทดลองเป็นรอบ: อย่าปล่อย agent ทำงานยาวโดยไม่มีจุดตรวจ เช่น ตรวจทุก 2 ชั่วโมงหรือเมื่อใช้ถึงงบที่กำหนด
- ทดสอบกรณีล้มเหลวก่อนเปิดใช้: ข้อมูลว่าง ข้อมูลซ้ำ สิทธิ์ไม่พอ และการอนุมัติถูกปฏิเสธ ต้องมีผลลัพธ์ที่คาดเดาได้
- วัดต้นทุนต่อผลลัพธ์: เปรียบเทียบเงิน เวลา จำนวนครั้งที่ต้องแก้ และมูลค่าที่งานช่วยประหยัด ไม่ใช่เทียบเพียงคะแนน AI
Step 7: Troubleshooting แก้ปัญหาที่มักเจอเมื่อนำ AI มาสร้างระบบ
- ปัญหา: แอปเปิดได้ หน้าตาดี แต่ใช้ทำงานจริงไม่ได้
สาเหตุ: เกณฑ์จบงานเน้นการแสดงผลมากกว่าพฤติกรรมจริง
วิธีแก้: เขียน test case ก่อนเริ่ม ระบุข้อมูลเข้า ผลที่คาดหวัง และหลักฐานที่ต้องส่ง เช่น log หรือรายการข้อมูลที่บันทึกสำเร็จ - ปัญหา: ค่าใช้จ่าย AI พุ่งเกินงบ
สาเหตุ: ใช้ model ราคาแพงกับงานย่อยทุกประเภท หรือปล่อยให้แก้ซ้ำโดยไม่จำกัดรอบ
วิธีแก้: กำหนดเพดานงบ แบ่งงานวางแผนกับงานลงมือทำ และให้รายงานความคืบหน้าก่อนเริ่มรอบแก้ใหญ่ - ปัญหา: ระบบเลือกเส้นทางผิดเมื่อเจอข้อมูลผิดปกติ
สาเหตุ: ไม่มี negative test หรือไม่มีเงื่อนไข fallback
วิธีแก้: เพิ่มชุดทดสอบข้อมูลขาดหาย ค่าไม่ตรงรูปแบบ และคำขอซ้ำ พร้อมกำหนดให้หยุดส่งต่อและแจ้งคนรับผิดชอบ - ปัญหา: นำ workflow ไปใช้ต่อในระบบอื่นไม่ได้
สาเหตุ: schema สำหรับ import และ export ไม่สอดคล้องกัน
วิธีแก้: กำหนดรูปแบบข้อมูลกลางตั้งแต่ต้น ทดลอง export แล้ว import กลับทันที และเก็บตัวอย่าง JSON ที่ผ่านการยืนยันแล้ว - ปัญหา: ทีมไม่มั่นใจเมื่อระบบแจ้งว่าทำงานสำเร็จ
สาเหตุ: ไม่มี run summary หรือ audit log ที่อ่านรู้เรื่อง
วิธีแก้: บังคับให้ทุก workflow แสดงสถานะสำเร็จ ล้มเหลว รออนุมัติ และเหตุผลที่ข้ามขั้นตอน พร้อมเก็บ log ดาวน์โหลดได้
Step 8: การต่อยอดจากการทดลองนี้
- สร้างชุด benchmark ของบริษัท: ใช้โจทย์เดียวกันให้ AI หลาย model ทำ แล้วให้ทีมที่ใช้งานจริงให้คะแนนโดยไม่รู้ว่าเป็นผลงานของ model ใด
- ทำ prompt template สำหรับงานซ้ำ: แยกส่วนเป้าหมาย ข้อจำกัด สิทธิ์อนุมัติ รูปแบบข้อมูล และ definition of done เพื่อไม่ต้องเริ่มจากศูนย์ทุกครั้ง
- สร้าง human-in-the-loop: สำหรับงานที่มีผลต่อเงิน ลูกค้า หรือชื่อเสียง ให้ AI เตรียมข้อมูลและร่างการตัดสินใจ แต่กำหนดจุดอนุมัติโดยคนไว้อย่างชัดเจน
Step 9: สรุป Checklist ทั้งหมดก่อนจ้าง AI สร้างแอป
- ☐ ระบุปัญหาธุรกิจหนึ่งเรื่องที่ต้องการแก้ก่อนเลือก model
- ☐ เขียน prompt ที่ระบุขอบเขต ผลลัพธ์ และ definition of done
- ☐ แบ่งงานวางแผน งานสร้าง และงานตรวจสอบออกจากกัน
- ☐ กำหนดงบ เวลา และจุดตรวจความคืบหน้า
- ☐ สร้าง test case ทั้งกรณีปกติและกรณีผิดพลาด
- ☐ ตรวจว่า status, log และการอนุมัติสะท้อนความจริง
- ☐ ทดสอบ import และ export ของข้อมูลหรือ workflow
- ☐ เปรียบเทียบต้นทุนต่อคุณค่าที่ได้ ไม่ตัดสินจากชื่อเวอร์ชัน
- ☐ เปิดใช้กับงานเล็กก่อน แล้วค่อยขยายเมื่อผลลัพธ์นิ่ง
บทเรียนจาก Fable 5 และ Fable 5.1 คือ AI ที่ได้คะแนนสูงสุดไม่จำเป็นต้องเป็นตัวเลือกที่ดีที่สุดเสมอ สำหรับธุรกิจ การตัดสินใจที่ดีคือเลือก AI ที่ส่งมอบงานผ่านเกณฑ์สำคัญภายใต้งบและเวลาที่เรารับได้ แล้วลงทุนส่วนต่างกับการตรวจงานและการพัฒนา workflow รอบถัดไป