ที่มา: วิดีโอต้นทาง และบทความ VideoToBlog วันที่ 2026-08-14 (วันที่แสดงในบทความต้นทาง ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว) รายละเอียดเป็นข้อมูลที่ต้นทางกล่าวไว้ในขณะนั้น ยังไม่ได้ทดสอบซ้ำหรือตรวจยืนยันสถานะล่าสุด PRISM, DigiWorld, 15 แอป, 387 สถานการณ์, 3.2 ล้าน configuration และช่วงความเชื่อมั่นที่ครอบคลุมจริง 17–20% เป็นผลที่ Pierluca D’Oro รายงานตามต้นฉบับ ไม่ใช่ผลทดสอบซ้ำของผู้ย้ายบทความ ตัวอย่างต้นทุนความผิดพลาดเป็นสมมติฐานประกอบการอธิบาย · วิดีโอต้นทาง
AI ที่คลิก กรอกข้อมูล เลื่อนหน้า และทำงานบนระบบแทนคน อาจได้คะแนนทดสอบสูงมาก ทั้งที่ไม่ได้ “เข้าใจ” หน้าจอเลยก็ได้ หากระบบทดสอบเปิดช่องให้จำลำดับการกดเดิมแล้วทำซ้ำ
ประเด็นนี้มาจากคลิปของ Pierluca D’Oro จาก Programma Labs บนช่อง AI Engineer ซึ่งตั้งคำถามสำคัญกับการประเมิน computer use agent หรือ AI ที่ใช้งานคอมพิวเตอร์ผ่านหน้าจอโดยตรง แก่นของเรื่องไม่ได้อยู่ที่ว่า model ไหนได้คะแนนสูงกว่า แต่อยู่ที่ว่า คะแนนนั้นบอกความพร้อมใช้งานจริงได้แค่ไหน
สำหรับเจ้าของธุรกิจและคนทำงานไทย นี่คือบทเรียนที่ควรใช้ก่อนให้ AI แตะระบบหลังบ้าน ระบบขาย ระบบบัญชี หรือข้อมูลลูกค้า เพราะความผิดพลาดที่ซ่อนอยู่ใต้ตัวเลขสวย ๆ อาจกลายเป็นต้นทุนจริงในระดับที่สูงกว่าค่าเครื่องมือหลายเท่า
สารบัญ
- Step 1: แยกให้ออกระหว่าง AI ที่ทำงานเป็น กับ AI ที่จำทางได้
- Step 2: อย่าหลงเชื่อ pass@k หากสภาพแวดล้อมเดิมทุกครั้ง
- Step 3: สร้างชุดทดสอบตามหลัก PRISM ก่อนเปิดใช้ AI จริง
- Step 4: เพิ่มความหลากหลาย แต่ต้องตรวจว่าทุกเคสยังใช้ได้
- Step 5: ทดสอบความทนต่อการเปลี่ยนแปลง ไม่ใช่แค่ค่าเฉลี่ย
- Step 6: วัดความไม่แน่นอนให้ตรงกับความจริงก่อนเลือก model
- Step 7: เปลี่ยนบทเรียนเป็น Actionable Insights
- Step 8: แก้ปัญหาที่พบบ่อยเมื่อเริ่มทดสอบ AI
- Step 9: ต่อยอดจากการทดสอบสู่ workflow ที่ควบคุมได้
- Step 10: สรุป Checklist ทั้งหมดก่อนใช้ AI ทำงานบนคอมพิวเตอร์
Step 1: แยกให้ออกระหว่าง AI ที่ทำงานเป็น กับ AI ที่จำทางได้
ตัวอย่างที่คมที่สุดในคลิปคือ “replay agent” วิธีทำมีความตรงไปตรงมา คือให้ frontier model ทำแต่ละงานจนสำเร็จหนึ่งครั้ง แล้วบันทึกลำดับการกระทำ เช่น แตะปุ่ม พิมพ์ข้อความ เลื่อนหน้าจอ จากนั้นสร้าง agent ที่ทำซ้ำลำดับเดิมแบบตาบอด โดยไม่ต้องดูหน้าจอหรือวิเคราะห์สถานการณ์ใหม่
น่าตกใจตรงที่สคริปต์ขนาดเล็กกว่า 1 MB แบบนี้สามารถทำคะแนนเท่ากับ หรือบางกรณีสูงกว่า model ต้นทางได้บน benchmark ที่กำหนดสถานะตายตัว เช่น งานเริ่มที่หน้าเดิม ข้อมูลเดิม ปุ่มอยู่ตำแหน่งเดิม และเส้นทางสำเร็จเหมือนเดิมเสมอ
ภาพนี้สะท้อนข้อเท็จจริงที่ธุรกิจควรระวัง: คะแนนสำเร็จไม่ได้แปลว่า AI รับมือกับงานจริงได้ งานจริงแทบไม่เคยเหมือนเดิมทั้งหมด ลูกค้าใช้ชื่อไม่เหมือนกัน ยอดชำระไม่เท่ากัน สถานะเริ่มต้นต่างกัน และหน้าตาโปรแกรมเปลี่ยนได้จากการอัปเดตเล็กน้อย
หากเรากำลังทดลอง AI ให้รับออเดอร์ ตรวจเอกสาร หรือบันทึกข้อมูลเข้า CRM แล้วทดสอบจากไฟล์ตัวอย่างชุดเดิมซ้ำ ๆ ผลที่ดีอาจเป็นเพียงการจำรูปแบบ ไม่ใช่ความสามารถในการทำงาน นี่ไม่ใช่ข้อกล่าวหา AI ว่าใช้ไม่ได้ แต่เป็นการเปลี่ยนคำถามจาก “มันทำเดโมได้ไหม” เป็น “มันยังทำได้ไหมเมื่อรายละเอียดเปลี่ยน”
Step 2: อย่าหลงเชื่อ pass@k หากสภาพแวดล้อมเดิมทุกครั้ง
อีกจุดที่คลิปชี้ให้เห็นคือ metric ชื่อ pass@k ซึ่งนิยมใช้วัดโอกาสที่อย่างน้อยหนึ่งครั้งจากการลองทำ k ครั้งจะสำเร็จ ฟังดูสมเหตุสมผล เพราะ AI มักให้ผลต่างกันในแต่ละรอบ แต่บนระบบทดสอบแบบ deterministic หรือระบบที่ทุกอย่างเหมือนเดิม pass@k กลับวัดความสามารถเดียวกับ replay agent ในเชิงหลักการ
พูดแบบภาษางานธุรกิจคือ หากเราให้ AI ลองกดฟอร์มเดิม 10 รอบ แล้วรอบหนึ่งทำถูก ตัวเลขนั้นอาจบอกว่า “มีเส้นทางหนึ่งที่ AI เคยเจอและทำได้” มากกว่าจะบอกว่า “AI ทำงานนี้ได้มั่นคง”
มุมมองที่ควรเห็นต่างกับการใช้ benchmark เพียงอย่างเดียวคือ benchmark ยังมีประโยชน์สำหรับเปรียบเทียบเบื้องต้น แต่ไม่ควรถูกยกระดับเป็นใบรับรองความพร้อมใช้จริง โดยเฉพาะเมื่อ AI ต้องเข้าถึงการเงิน ข้อมูลส่วนบุคคล หรือการตัดสินใจที่ย้อนกลับยาก
Step 3: สร้างชุดทดสอบตามหลัก PRISM ก่อนเปิดใช้ AI จริง
แนวทางแก้ของ Pierluca คือหลัก PRISM สำหรับออกแบบสภาพแวดล้อมทดสอบที่เชื่อถือได้ โดยแต่ละตัวอักษรตอบโจทย์ว่าชุดทดสอบควรไม่เปิดช่องให้ AI หรือ workflow เล่นกับกติกา
- Privileged verification: มีวิธีตรวจคำตอบจากข้อมูลภายในที่เชื่อถือได้ ไม่ดูแค่ว่า AI กดปุ่มจบ
- Realistic: สถานการณ์ต้องใกล้กับงานจริง ไม่ใช่ตัวอย่างที่สะอาดและง่ายเกินไป
- Integrity-checked: ทุกชุดข้อมูลและทุกสถานะที่สร้างขึ้นต้องผ่านการตรวจว่าถูกต้อง
- Sandboxed: ทดลองในพื้นที่แยก ไม่ให้ AI กระทบข้อมูลจริงหรือระบบจริง
- Multifactorial: ต้องมีความหลากหลายหลายแกน เช่น ข้อมูล หน้าจอ ธีม และจุดเริ่มต้นของงาน
หากแปลงเป็นภาษาธุรกิจไทย สมมติว่าเราจะให้ AI ตรวจว่าใบสั่งซื้อครบหรือไม่ อย่าทดสอบเฉพาะใบสั่งซื้อรูปแบบเดียว ควรสลับชื่อลูกค้า รหัสสินค้า จำนวนรายการ ยอดเงิน รูปแบบวันที่ สถานะหน้าจอ และตำแหน่งเริ่มต้นของงาน รวมถึงใส่เคสที่ข้อมูลไม่ครบด้วย
ส่วน sandboxed สำคัญมากในงานที่เกี่ยวข้องกับระบบหลังบ้าน เราควรใช้บัญชีทดสอบ ข้อมูลจำลอง และสิทธิ์จำกัดก่อนเสมอ AI ควรพิสูจน์ว่าทำถูกในพื้นที่ปลอดภัยก่อน จึงค่อยขยับไปยังงานจริงที่ความเสี่ยงต่ำ
Step 4: เพิ่มความหลากหลาย แต่ต้องตรวจว่าทุกเคสยังใช้ได้
การสร้างเคสทดสอบมากขึ้นไม่ได้ช่วยเสมอไป ถ้าเคสจำนวนมากมีข้อมูลเสีย หน้าจอไปต่อไม่ได้ หรือเกณฑ์คำตอบไม่ชัด เราก็จะได้เพียงกองข้อมูลที่ใหญ่ขึ้น ไม่ใช่การประเมินที่ดีขึ้น
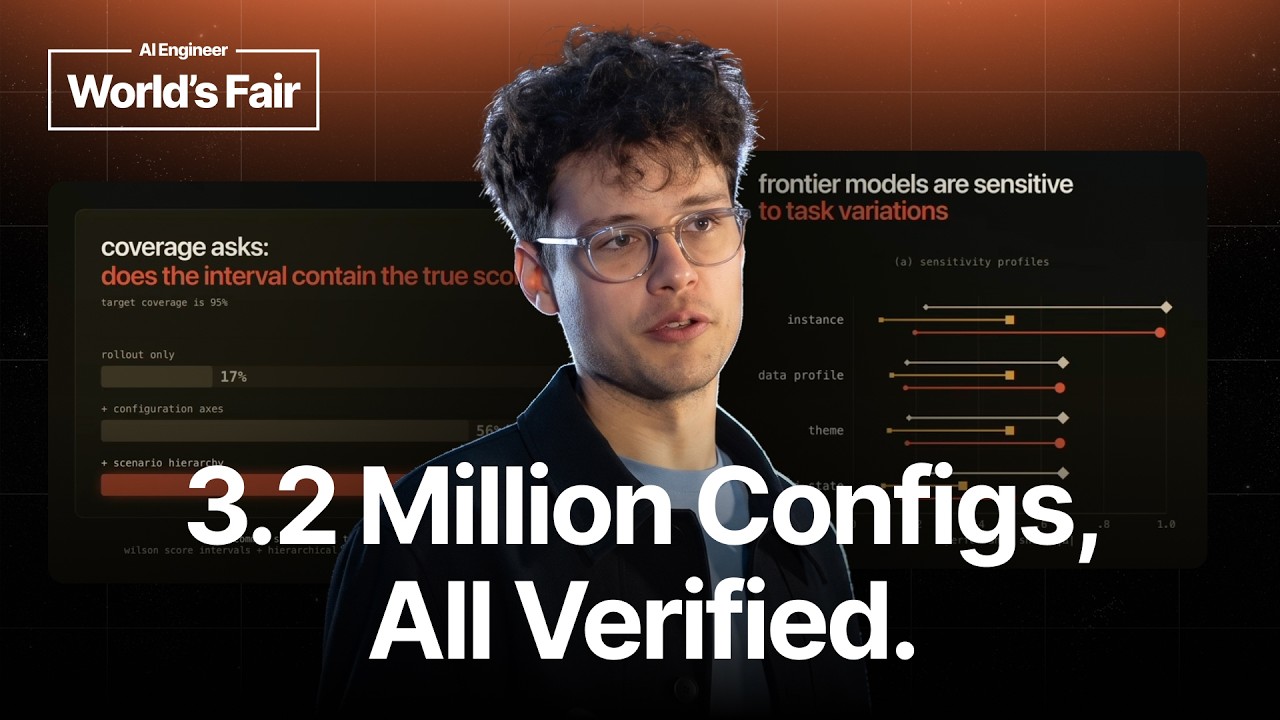
DigiWorld ซึ่งเป็น benchmark ที่นำเสนอในคลิป ใช้แอป Android จำนวน 15 แอป ครอบคลุม 387 สถานการณ์ที่ตรวจสอบแล้ว และสร้าง configuration ที่ผ่านการตรวจสอบได้ 3.2 ล้านแบบ ความหลากหลายมาจากการปรับแกนต่าง ๆ เช่น จำนวนเงิน ข้อมูลผู้ติดต่อ อีเมล ธีม และหน้าจอเริ่มต้น
หัวใจไม่ได้อยู่ที่เลข 3.2 ล้าน แต่อยู่ที่แนวคิด “สร้างแล้วตรวจ” ระบบทำงานคล้าย compiler คือเริ่มจาก task template ที่ระบุพารามิเตอร์ ตัวตรวจคำตอบ และข้อมูลจำลอง จากนั้นประกอบเป็น configuration แล้วคัดชุดที่เสียออก เหลือเฉพาะกรณีที่ทำงานได้จริง
ธุรกิจขนาดเล็กไม่จำเป็นต้องสร้างระบบระดับนี้เอง แต่ควรหยิบหลักการไปใช้กับ spreadsheet ได้ เช่น สร้างตาราง test cases ที่ระบุ ข้อมูลเข้า, สิ่งที่ AI ต้องทำ, ผลลัพธ์ที่ยอมรับได้, ระดับความเสี่ยง แล้วให้คนในทีมตรวจความสมบูรณ์ของเคสก่อนเริ่มทดสอบ
ข้อควรจำคือ AI สร้าง software หรือสร้างชุดทดสอบได้จำนวนมากก็จริง แต่จำนวนไม่เท่ากับคุณภาพ หากชุดข้อมูลที่ AI ช่วยสร้างไม่ได้ถูกตรวจ สุดท้ายเราอาจกำลังวัดความสามารถบนโจทย์ที่ไม่มีคำตอบถูกต้องตั้งแต่แรก
Step 5: ทดสอบความทนต่อการเปลี่ยนแปลง ไม่ใช่แค่ค่าเฉลี่ย
เมื่อ benchmark มีความหลากหลาย เราจะเห็นจุดอ่อนที่คะแนนเฉลี่ยปิดบังไว้ได้ คลิปแสดงให้เห็นว่า frontier models หลายตัวเปราะบางต่อการเปลี่ยนเล็กน้อย แม้งานหลักจะเหมือนเดิม แค่เปลี่ยนหน้าจอเริ่มต้นหรือธีมของแอป ผลลัพธ์ก็อาจตกลงมาก
นี่คือภาพจำลองของสิ่งที่เกิดในบริษัทจริง: ทีมอาจเห็น AI ทำงานได้ดีบนหน้าจอเวอร์ชันเดิม แต่เมื่อ platform อัปเดตปุ่ม เปลี่ยนภาษาของเมนู หรือมีข้อมูลลูกค้ารูปแบบแปลกเข้ามา workflow กลับสะดุดทันที
ดังนั้น KPI ที่ควรถามเพิ่มไม่ใช่เพียง “อัตราสำเร็จเฉลี่ยเท่าไร” แต่ควรถามว่า
- AI ล้มเหลวมากที่สุดในเคสแบบไหน
- การเปลี่ยนข้อมูลหรือหน้าจอข้อใดทำให้ผลตกมาก
- เมื่อทำผิด AI หยุดและแจ้งคน หรือทำรายการต่อแบบเงียบ ๆ
- เคสล้มเหลวส่งผลเป็นค่าใช้จ่าย ความเสียหาย หรือความเสี่ยงแบบใด
Step 6: วัดความไม่แน่นอนให้ตรงกับความจริงก่อนเลือก model
การทดสอบ AI มีความผันผวนอย่างน้อยสองแหล่ง แหล่งแรกคือการกระทำของ AI เอง เพราะการรันซ้ำอาจได้เส้นทางต่างกัน แหล่งที่สองคือความเปลี่ยนแปลงของสภาพแวดล้อม เช่น ข้อมูล หน้าจอ หรือสถานะเริ่มต้น ซึ่งมักถูกละเลย
หากวัดจากการรันซ้ำบนเคสฐานเพียงเคสเดียว ช่วงความเชื่อมั่นที่ตั้งใจให้ครอบคลุมผลจริง 95% อาจครอบคลุมได้จริงเพียงราว 17% ถึง 20% เท่านั้น นั่นหมายความว่าตัวเลขดูแม่นกว่าความเป็นจริงอย่างรุนแรง
ผลต่อการตัดสินใจไม่ใช่เรื่องเทคนิคเล็ก ๆ คลิปยกตัวอย่างว่า หากงานมีปริมาณ 1 ล้านครั้งต่อเดือน model สองตัวต่างกันจริง 4% และความผิดพลาดหนึ่งครั้งมีต้นทุนเฉลี่ย 12 ดอลลาร์ การเลือก model ผิดเพราะเชื่อช่วงความเชื่อมั่นที่แคบเกินจริง อาจเสียเงินหลายแสนดอลลาร์ในเดือนเดียว
สำหรับธุรกิจไทย หลักคิดคืออย่าฝืนเลือกเมื่อข้อมูลยังไม่พอ หากผลของ model A และ B ใกล้กันมาก ให้เพิ่มเคสทดสอบ เพิ่มความหลากหลาย หรือเลือกให้คนอนุมัติงานเสี่ยงสูงไปก่อน การยอมรับว่า “ยังไม่มั่นใจ” มักถูกกว่าการรีบ deploy แล้วแก้ความเสียหายภายหลัง
Step 7: เปลี่ยนบทเรียนเป็น Actionable Insights
- เริ่มจากงานย้อนกลับได้: ให้ AI ร่างข้อมูลหรือจัดคิวงานก่อน ไม่เริ่มจากการโอนเงิน ลบข้อมูล หรือส่งข้อความถึงลูกค้าเอง
- ทำ test matrix 20 ถึง 50 เคส: สลับข้อมูล หน้าจอเริ่มต้น และกรณียกเว้น อย่าใช้ตัวอย่างชุดเดิมซ้ำอย่างเดียว
- กำหนดตัวตรวจผลลัพธ์: ระบุว่าคำตอบที่ถูกต้องคืออะไร และให้คนหรือระบบตรวจปลายทาง ไม่วัดแค่ว่า AI ทำครบขั้นตอน
- เก็บเคสที่พังเป็นสินทรัพย์: ทุกครั้งที่ AI พลาด ให้นำเคสนั้นกลับเข้า test suite เพื่อป้องกันการพลาดซ้ำ
- แบ่งสิทธิ์ตามความเสี่ยง: AI ทำงานอ่านข้อมูลได้กว้างกว่างานเขียนข้อมูล และงานสำคัญควรมีจุดอนุมัติโดยคน
Step 8: แก้ปัญหาที่พบบ่อยเมื่อเริ่มทดสอบ AI
ปัญหา: AI ทำเดโมได้ดี แต่พอใช้จริงผิดพลาดบ่อย
สาเหตุ: เคสทดสอบซ้ำเดิมหรือเรียบเกินไป จน AI จำลำดับการทำงานได้
วิธีแก้:
- เปลี่ยนข้อมูลนำเข้าอย่างน้อย 3 แกน เช่น ชื่อลูกค้า ยอดเงิน และสถานะเริ่มต้น
- เพิ่มเคสข้อมูลไม่ครบหรือคำสั่งกำกวม
- รายงานผลแยกตามประเภทเคส ไม่ดูเฉพาะคะแนนรวม
ปัญหา: ทีมมีคะแนนสูง แต่ไม่รู้ว่าผลลัพธ์ถูกจริงหรือไม่
สาเหตุ: วัดจากการที่ AI ไปถึงหน้าสุดท้าย หรือกดปุ่มสำเร็จ แทนการตรวจผลปลายทาง
วิธีแก้:
- กำหนดเงื่อนไขผ่านที่ตรวจได้ เช่น ยอดเงิน ผู้รับ หรือสถานะรายการ
- สร้างจุดตรวจจากข้อมูลในระบบ ไม่พึ่งหน้าจออย่างเดียว
- สุ่มให้คนตรวจเคสที่ AI ระบุว่าสำเร็จ
ปัญหา: เลือก model จากผลต่างเล็กน้อยแล้วผลไม่เป็นไปตามคาด
สาเหตุ: ชุดทดสอบน้อยเกินไปและไม่ได้รวมความผันผวนจากสภาพแวดล้อม
วิธีแก้:
- เพิ่มจำนวนเคสและเพิ่มความหลากหลายของเคส
- เปรียบเทียบผลในหลายรอบและหลายเงื่อนไข
- หากผลยังทับซ้อนกัน ให้เลือกจากต้นทุน ความปลอดภัย และการควบคุมสิทธิ์ร่วมด้วย
ปัญหา: AI ทำรายการผิดแล้วกระทบข้อมูลจริง
สาเหตุ: ไม่มี sandbox และไม่มีจุดหยุดก่อนงานสำคัญ
วิธีแก้:
- สร้างบัญชีและข้อมูลทดสอบแยกจากระบบจริง
- จำกัดสิทธิ์ AI ให้ทำเฉพาะสิ่งจำเป็น
- วาง human approval ก่อนการส่ง ลบ แก้ไข หรือทำธุรกรรม
Step 9: ต่อยอดจากการทดสอบสู่ workflow ที่ควบคุมได้
- สร้าง AI scorecard รายเดือน: แยกอัตราสำเร็จตามงาน ความเสียหายจากข้อผิดพลาด และเคสที่ต้องส่งต่อให้คน เพื่อดูว่า AI ดีขึ้นหรือแค่เจอโจทย์ง่ายขึ้น
- ทำ regression test ก่อนเปลี่ยน model หรือ prompt: ทุกครั้งที่เปลี่ยน provider, model, prompt หรือหน้าจอระบบ ให้รันเคสสำคัญซ้ำก่อนเปิดใช้
- จัดระดับงานตามความเสี่ยง: งานความเสี่ยงต่ำให้ AI ทำอัตโนมัติ งานปานกลางให้ AI เสนอคำตอบ และงานสูงให้ AI ช่วยสรุปข้อมูลแต่คนเป็นผู้ตัดสินใจ
ผู้ที่ต้องการอ่านรายละเอียดเชิงงานวิจัยสามารถดูเอกสารต้นทางได้ที่ งานวิจัยเกี่ยวกับการประเมิน computer use agent แต่สาระที่นำไปใช้ได้ทันทีคือ เราไม่ควรซื้อความมั่นใจจากคะแนนเดียว
Step 10: สรุป Checklist ทั้งหมดก่อนใช้ AI ทำงานบนคอมพิวเตอร์
- ☐ ระบุงานที่จะให้ AI ทำและผลลัพธ์ที่ถือว่าถูกต้อง
- ☐ แยกงานความเสี่ยงต่ำ ปานกลาง และสูง
- ☐ สร้างเคสทดสอบที่ข้อมูลและสถานะเริ่มต้นต่างกัน
- ☐ เพิ่มเคสผิดปกติ ข้อมูลไม่ครบ และหน้าจอเปลี่ยนแปลง
- ☐ ตรวจผลลัพธ์ปลายทาง ไม่วัดแค่การกดจบ workflow
- ☐ ทดสอบใน sandbox ก่อนแตะข้อมูลจริง
- ☐ จำกัดสิทธิ์ AI และกำหนดจุดอนุมัติโดยคน
- ☐ เปรียบเทียบ model จากหลายรอบ หลายเคส และหลายเงื่อนไข
- ☐ ไม่ตัดสินใจจากช่วงความเชื่อมั่นที่ดูแคบเพียงอย่างเดียว
- ☐ เก็บเคสที่พลาดไว้ทดสอบซ้ำทุกครั้งก่อน deploy
ข้อสรุปของเรื่องนี้ชัดเจน: benchmark ที่ไม่รัดกุมอาจทำให้ทั้งวงการและธุรกิจตัดสินใจผิดได้ AI ที่ทำงานบนคอมพิวเตอร์มีศักยภาพสูง แต่ความพร้อมใช้งานจริงต้องพิสูจน์ด้วยความหลากหลาย การตรวจผลที่ชัดเจน และการยอมรับความไม่แน่นอนอย่างตรงไปตรงมา