เรียบเรียงจากคลิป Julian Goldie SEO และบทความ VideoToBlog วันที่ 3 สิงหาคม 2026 วันที่นี้เป็นวันที่แสดงในบทความต้นทาง ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว ชื่อรุ่น คะแนน benchmark การเข้าถึงฟรี แผนเปิดน้ำหนัก และความเห็นต่อผลงานเป็นข้อมูลที่ต้นทางกล่าวไว้ ยังไม่ได้ยืนยันกับผู้พัฒนาหรือทดสอบซ้ำ ภาพนิ่งที่เก็บได้แสดงตาราง Arcade/Crypt และการเทียบเกม Arcade จึงไม่ยืนยันความลื่นไหลหรือผลทดสอบการบิน ตัวอย่างธุรกิจไทยเป็นแนวทางประยุกต์จากบทความเดิม · วิดีโอต้นทาง
การเลือก AI สำหรับสร้างเว็บไซต์ แอป หรือ workflow ไม่ควรจบที่คะแนน benchmark เพราะตัวเลขสูงไม่ได้แปลว่าเครื่องมือนั้นจะทำงานต่อเนื่องจนส่งมอบได้จริงเสมอไป สิ่งที่ธุรกิจต้องการคือ AI ที่เข้าใจโจทย์ รักษาคุณภาพระหว่างแก้งาน และไม่ทำให้ทีมต้องเริ่มใหม่กลางทาง
คลิปเปรียบเทียบของ Julian Goldie SEO นำ Qwen 3.8 Max, Fable 5, Kimi K3 และ GPT-5.6 Sol มาเปรียบเทียบผลงานหลายโจทย์ โดยใช้เกม 3D และเว็บอินเทอร์แอกทีฟเป็นสนามทดสอบ บทความนี้สรุปสิ่งที่ธุรกิจไทยควรหยิบไปใช้ พร้อมชี้ให้เห็นว่าเหตุใดคำตอบที่ดีไม่ใช่ “model ไหนชนะ” แต่คือ “งานแบบไหนควรให้ model ไหนรับผิดชอบ”
สารบัญ
- Step 1: แยกคะแนน benchmark ออกจากคุณภาพงานที่ใช้งานได้
- Step 2: ใช้งานสร้างต้นแบบเพื่อทดสอบทั้ง logic และหน้าตางาน
- Step 3: หาเคสที่ model แพ้ แล้วอย่าฝืนใช้
- Step 4: มุมมองผู้สาธิตต่อ Fable 5 ในงานที่ต้องทำต่อเนื่อง
- Step 5: ใช้ Qwen 3.8 เมื่อราคา การเข้าถึง และงาน multimodal สำคัญกว่า
- Step 6: สร้างระบบที่เปลี่ยน model ได้ แทนการไล่ตาม model ใหม่ทุกสัปดาห์
- Step 7: Actionable Insights ที่เริ่มทำได้ทันที
- Step 8: Troubleshooting เมื่อ AI สร้างงานไม่ตรงที่คิด
- Step 9: การต่อยอดจากการเทียบ model สู่ระบบธุรกิจ
- Step 10: สรุป Checklist ทั้งหมดก่อนเลือก Qwen 3.8 หรือ Fable 5
Step 1: แยกคะแนน benchmark ออกจากคุณภาพงานที่ใช้งานได้
จุดเริ่มต้นของการเปรียบเทียบคือ Qwen 3.8 Max มีผลคะแนนที่แข่งขันกับ Fable 5 ได้ในหลาย benchmark และใน Terminal Bench 2.1 มีคะแนน 86.6 เทียบกับ 84.6 ของ Fable 5 ตามข้อมูลที่นำเสนอ ผู้จัดทำระบุว่า Qwen เปิดให้ใช้ฟรีในช่วงที่ทำคลิปและกล่าวถึงแผนเปิดน้ำหนักโมเดล แต่ความพร้อมใช้งานและเงื่อนไขใบอนุญาตต้องตรวจจากผู้ให้บริการก่อนใช้งานจริง
แต่คะแนน benchmark วัดเพียงความสามารถภายใต้โจทย์ที่กำหนด ไม่ได้วัดประสบการณ์ทำงานครบวงจร เช่น AI เข้าใจความต้องการของร้านค้าได้แค่ไหน แก้ไขรอบที่ห้าแล้วยังไม่ทำส่วนเดิมพังหรือไม่ หรือทีมสามารถเชื่อมมันเข้ากับระบบงานเดิมได้ง่ายเพียงใด
มุมที่ควรระวังคือการทดสอบชุดนี้เป็นการทดสอบเชิงปฏิบัติจากผู้จัดทำ ไม่ใช่มาตรฐานอิสระที่รับประกันผลลัพธ์กับทุกธุรกิจ ดังนั้นเราไม่ควรใช้ผลนี้เป็นคำตัดสินสุดท้าย แต่ควรใช้เป็นสัญญาณให้ทดลองกับงานจริงขององค์กร
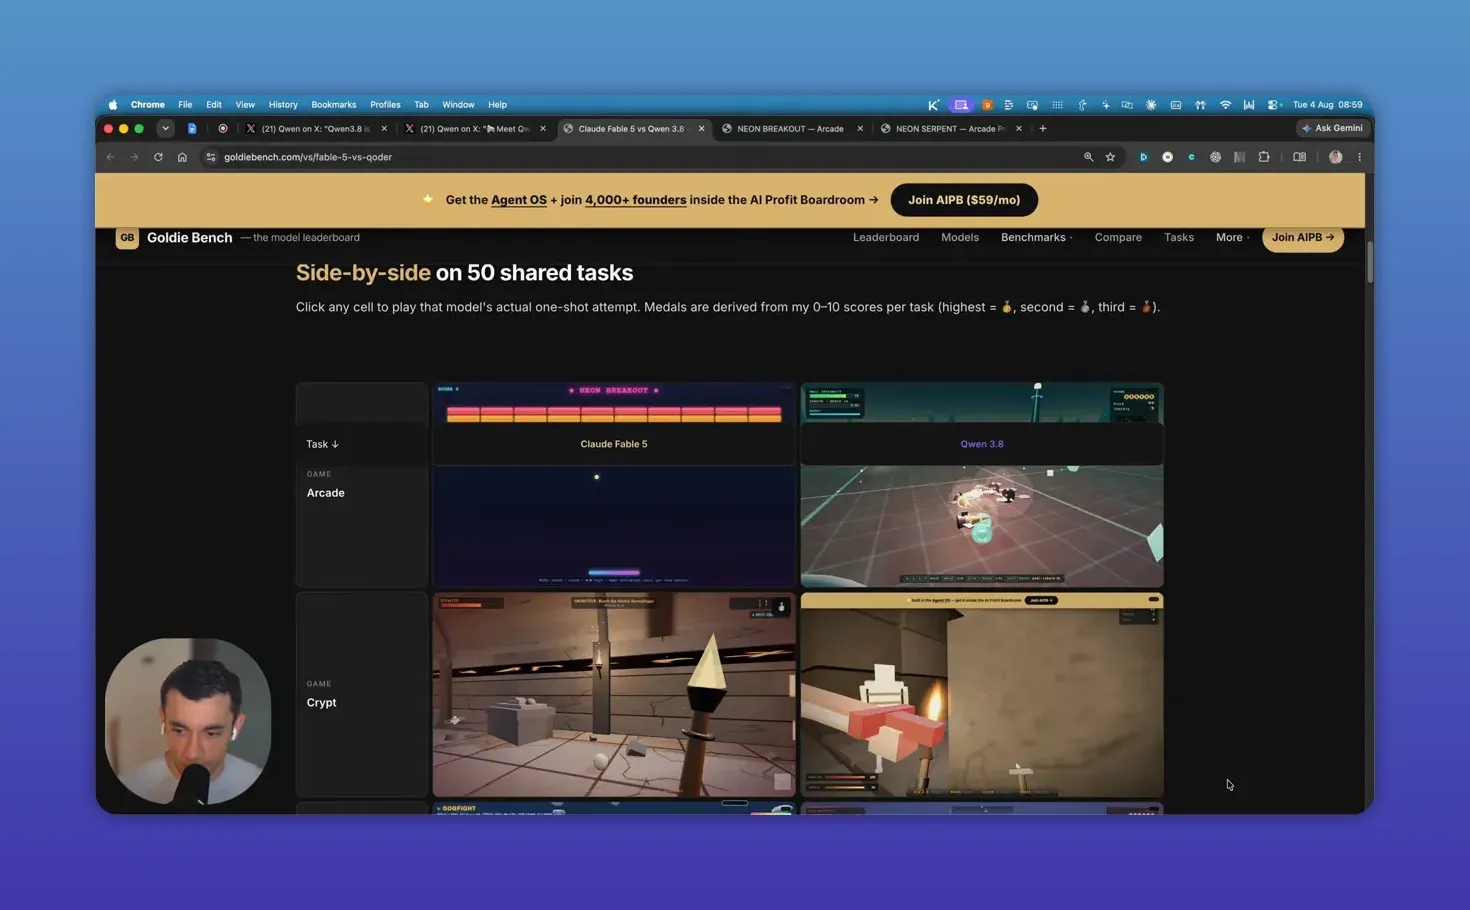
บทเรียนสำหรับธุรกิจ: ก่อนซื้อ subscription รายปีหรือย้าย workflow ทั้งทีม ให้เลือกงานที่ทำซ้ำและมีเกณฑ์วัดชัดเจนมาทดสอบ เช่น สร้างหน้า landing page สำหรับโปรโมชันเดียวกัน สรุปข้อมูลลูกค้า หรือทำต้นแบบระบบจองคิว แล้วเปรียบเทียบเวลา จำนวนรอบแก้ และคุณภาพผลลัพธ์ ไม่ใช่ดูคะแนน model อย่างเดียว
Step 2: ใช้งานสร้างต้นแบบเพื่อทดสอบทั้ง logic และหน้าตางาน
เหตุผลที่คลิปใช้เกมเป็นโจทย์หลักนั้นน่าสนใจ เพราะเกมหนึ่งงานบังคับให้ AI ทำหลายเรื่องพร้อมกัน ทั้งวาง logic เขียนโค้ด ออกแบบหน้าจอ ควบคุมการเคลื่อนไหว จัดการปุ่มและสถานะ รวมถึงแก้ bug งานที่ออกมาจึงสะท้อนมากกว่าความสามารถในการเขียนโค้ดชิ้นสั้น
บทความต้นทางถ่ายทอดความเห็นของผู้สาธิตว่า ในตัวอย่างเกมแข่งรถแนว neon และเกม RPG แบบ open world ผลงานของ Qwen 3.8 มีความลื่นไหล ภาพสามมิติ และความรู้สึกของการเล่นที่โดดเด่นหลายกรณี โดยเฉพาะเมื่อเทียบกับ Fable 5 บางงานที่เคลื่อนไหวช้ากว่า หรือเกิดอาการผิดพลาดระหว่างควบคุม
อย่างไรก็ดี Kimi K3 กลับทำหน้าตา front-end ได้สวยกว่า Qwen 3.8 ในบางตัวอย่าง นี่สะท้อนความจริงที่มักถูกมองข้าม คือ model เดียวไม่จำเป็นต้องเก่งที่สุดทุกด้าน ถ้าโจทย์คือหน้าเว็บไซต์แบรนด์ โรงแรม หรือคอร์สออนไลน์ เราอาจให้ Kimi K3 สร้างแนวทาง visual ก่อน แล้วใช้ model ที่เสถียรกว่าในขั้นต่อระบบหลังบ้าน
สำหรับธุรกิจไทย วิธีแปลงแนวคิดนี้เป็นงานจริงคือใช้ “ต้นแบบที่โต้ตอบได้” แทนการสั่ง AI ทำเอกสารยาว เช่น
- ร้านอาหารสร้างต้นแบบหน้าเมนูและระบบเลือกชุดอาหาร
- คลินิกสร้างหน้าจองคิวที่มีการเลือกบริการ วัน และเวลา
- ทีมขายสร้างเครื่องคำนวณราคาเบื้องต้นสำหรับให้ลูกค้ากรอกข้อมูล
- ฝ่าย HR สร้างแบบฟอร์มคัดกรองผู้สมัครที่แสดงคำถามตามตำแหน่งงาน
ถ้าต้นแบบคลิกได้และข้อมูลไหลตามเงื่อนไขที่ตั้งไว้ได้ เราจะเห็นจุดบอดของ AI เร็วกว่าการอ่านโค้ดหรือคำอธิบายหลายหน้า
Step 3: หาเคสที่ model แพ้ แล้วอย่าฝืนใช้
การเทียบที่มีคุณค่าที่สุดไม่ใช่การประกาศผู้ชนะ แต่คือการแสดงจุดที่แต่ละตัวทำได้ไม่ดี ตามคำประเมินที่บทความต้นทางถ่ายทอด ตัวอย่าง flight simulator ของ Fable 5 เล่นได้ดีกว่า Qwen 3.8 ซึ่งผู้สาธิตมองว่ามีปัญหามุมกล้องและการควบคุม ข้อสังเกตนี้ยังไม่ได้ทดสอบซ้ำ และภาพนิ่งเกม Arcade ที่นำมาประกอบไม่ใช่หลักฐานของผลทดสอบการบิน
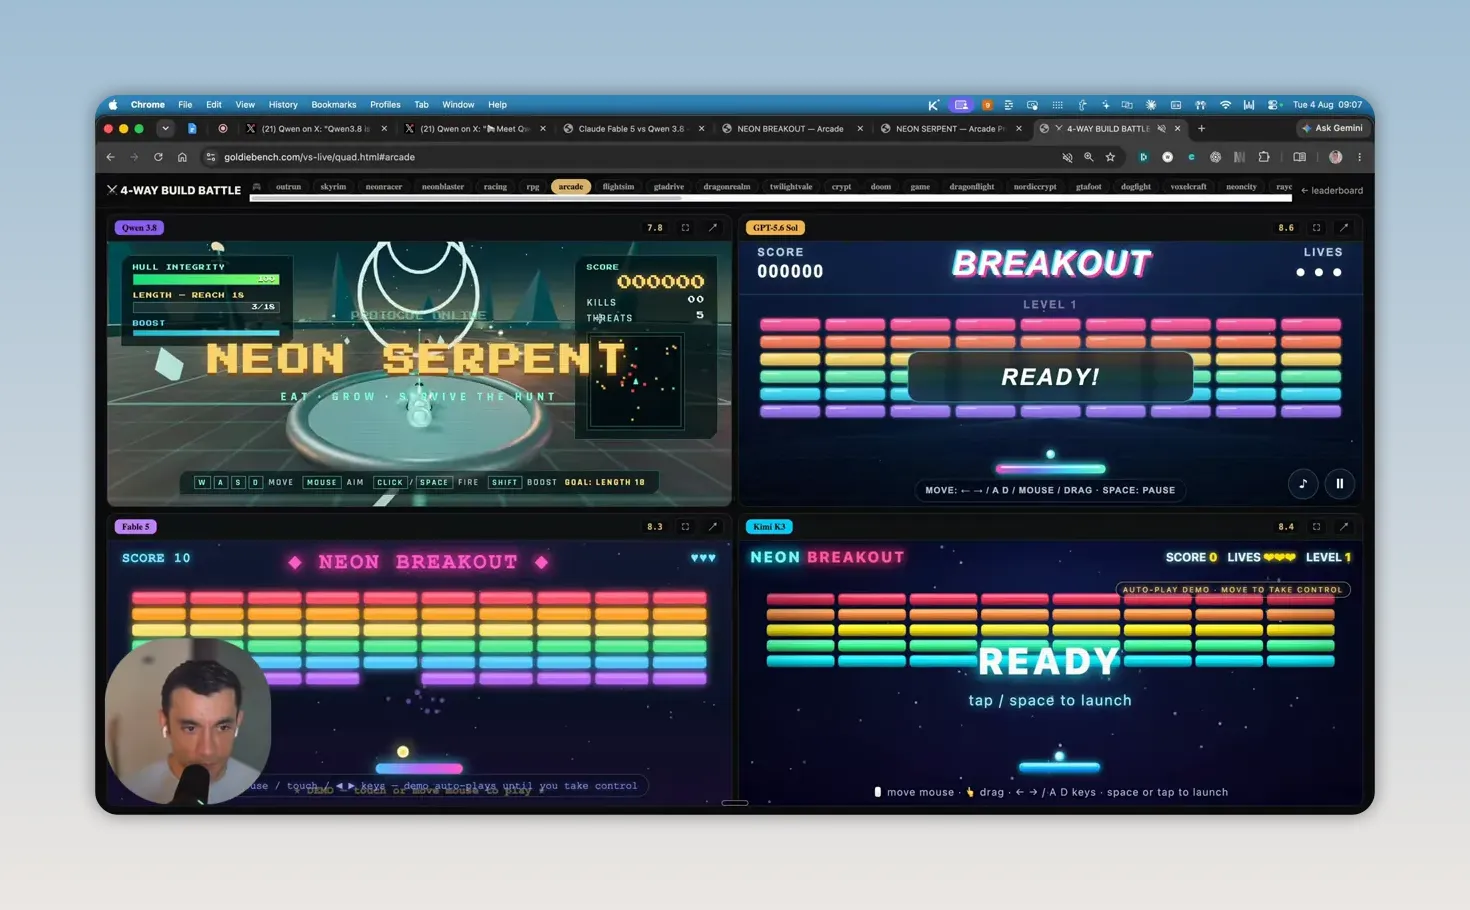
ผลนี้สำคัญกับเจ้าของธุรกิจ เพราะงานจริงมี “มุมกล้อง” ในความหมายของตัวเอง เช่น flow การชำระเงิน ลำดับอนุมัติเอกสาร การคำนวณราคา หรือการส่งข้อมูลไปยัง CRM ถ้า AI สร้างหน้าตาสวยแต่ลำดับการใช้งานผิด ลูกค้าก็ทำรายการไม่สำเร็จ และทีมต้องเสียเวลาตามแก้มากกว่าที่ประหยัดได้
ดังนั้นเกณฑ์ทดสอบที่ควรมีไม่ใช่แค่ “สวยไหม” แต่ต้องมีอย่างน้อย 4 ข้อ คือ
- ทำงานตามเงื่อนไขหลักได้ครบหรือไม่
- ข้อมูลสำคัญหายหรือผิดระหว่างเปลี่ยนขั้นตอนหรือไม่
- เมื่อสั่งแก้จุดหนึ่ง ส่วนอื่นพังตามหรือไม่
- คนในทีมที่ไม่ได้เขียนโค้ดสามารถตรวจและบอกจุดแก้ได้หรือไม่
แนวคิดนี้ใช้ได้กับทุก workflow ไม่ว่าจะเป็นระบบตอบแชต ระบบสรุปรายงาน หรือเว็บขายสินค้า AI ที่ “เก่งที่สุดบนกระดาษ” อาจไม่ใช่ AI ที่เหมาะกับงานหลักของเรา
Step 4: มุมมองผู้สาธิตต่อ Fable 5 ในงานที่ต้องทำต่อเนื่อง
แม้ Qwen 3.8 มีผลงานเด่นหลายรอบ แต่ Julian Goldie SEO ยังเลือกใช้ Fable 5 กับงานประจำวัน โดยเฉพาะโปรเจกต์ขนาดใหญ่ เช่น แอป เว็บไซต์ และระบบที่เชื่อมเครื่องมือหลายตัว เหตุผลคือความน่าเชื่อถือและความสม่ำเสมอในการทำงาน
นี่คือข้อสรุปที่สมเหตุผลสำหรับคนทำธุรกิจ เพราะต้นทุนของงานใหญ่ไม่ได้อยู่ที่ prompt แรก แต่อยู่ที่การทำงานต่อจากของเดิม ถ้าต้องย้อนกลับไปอธิบายโครงสร้างใหม่ทุกครั้ง หรือต้องคอยแก้ผลลัพธ์ที่เปลี่ยนไปมา ต้นทุนเวลาของทีมจะสูงขึ้นทันที
คลิปยังชี้ปัญหาหนึ่งของ Fable 5 คือบางช่วงระบบอาจสลับไปใช้ Opus โดยอัตโนมัติระหว่างทำงาน ซึ่งทำให้ผลลัพธ์และคุณภาพเปลี่ยนได้ ปัญหานี้เตือนเราว่า ต่อให้เลือก model ที่เสถียร ก็ยังต้องตรวจว่า workflow ใช้ model ใดอยู่จริง โดยเฉพาะงานที่ต้องใช้เวลาหลายชั่วโมง
สำหรับองค์กรที่มีเว็บไซต์ ระบบหลังบ้าน หรือฐานความรู้เดิมจำนวนมาก Fable 5 จึงเหมาะกับบทบาท “ผู้รับเหมาหลัก” มากกว่า ใช้จัดการงานที่ต้องรักษาโครงสร้างเดิมและทำต่อหลายรอบ ส่วน Qwen 3.8 สามารถเป็น “ทีมทดลอง” ที่รับงานต้นแบบ งานไอเดียใหม่ หรือโจทย์ที่ต้องการต้นทุนต่ำ
Step 5: ใช้ Qwen 3.8 เมื่อราคา การเข้าถึง และงาน multimodal สำคัญกว่า
บทความต้นทางมองว่า Qwen เป็นทางเลือกสำหรับทีมที่ต้องการทดลองโดยคุมค่าใช้จ่าย และกล่าวถึงเครื่องมือภาพกับวิดีโอในบริการที่ใช้ร่วมกัน ทั้งนี้ต้องแยกความสามารถของตัวโมเดลออกจากเครื่องมือในหน้าแอป รวมถึงตรวจสิทธิ์และโควตาของแต่ละฟีเจอร์ก่อนใช้จริง
ถ้าเอามาใช้กับธุรกิจไทย Qwen 3.8 เหมาะกับงานที่ต้องผลิตและทดลองเร็ว เช่น สร้างหน้าแคมเปญพร้อมภาพประกอบ ทำ prototype เกมหรือกิจกรรมบนเว็บไซต์ สร้างคอนเซปต์สื่อโฆษณาหลายแบบ หรือให้ AI ช่วยวางแผนงานแบบ agent ที่ต้องเรียกใช้เครื่องมือหลายตัว
แต่คำว่าใช้ฟรีไม่ได้แปลว่าต้นทุนเป็นศูนย์ เราต้องนับเวลาของทีมในการเขียน prompt ตรวจผลลัพธ์ แก้ไขงาน และดูแลข้อมูลด้วย โดยเฉพาะเมื่อใช้กับข้อมูลลูกค้า ราคา หรือเอกสารภายใน ควรกำหนดเสมอว่าอะไรส่งเข้า model ได้ และอะไรต้องปกปิดก่อนส่ง
คลิปเสนอว่าการเชื่อม Qwen เข้ากับ Hermes Agent สามารถนำไปใช้กับงานแบบ agent ได้โดยตรง ความหมายในเชิงธุรกิจคือ AI ไม่ได้มีหน้าที่ตอบข้อความเท่านั้น แต่สามารถรับงานหลายขั้น เช่น รับข้อมูล สรุป จัดหมวดหมู่ เตรียมร่างคำตอบ และส่งต่อให้คนอนุมัติ อย่างไรก็ตาม งานที่มีผลต่อเงิน ลูกค้า หรือสิทธิ์การเข้าถึง ควรมีจุดอนุมัติโดยคนเสมอ
Step 6: สร้างระบบที่เปลี่ยน model ได้ แทนการไล่ตาม model ใหม่ทุกสัปดาห์
ข้อเสนอที่น่าสนใจที่สุดคือแนวคิด agentic operating system หรือระบบกลางที่มี memory, prompt, เครื่องมือ และ workflow พร้อมอยู่แล้ว จากนั้นจึงสลับ “สมอง” ที่เป็น model ได้ตามงาน แนวทางนี้ทำให้เราไม่ต้องรื้อ automation ทุกครั้งที่มี AI รุ่นใหม่ออกมา
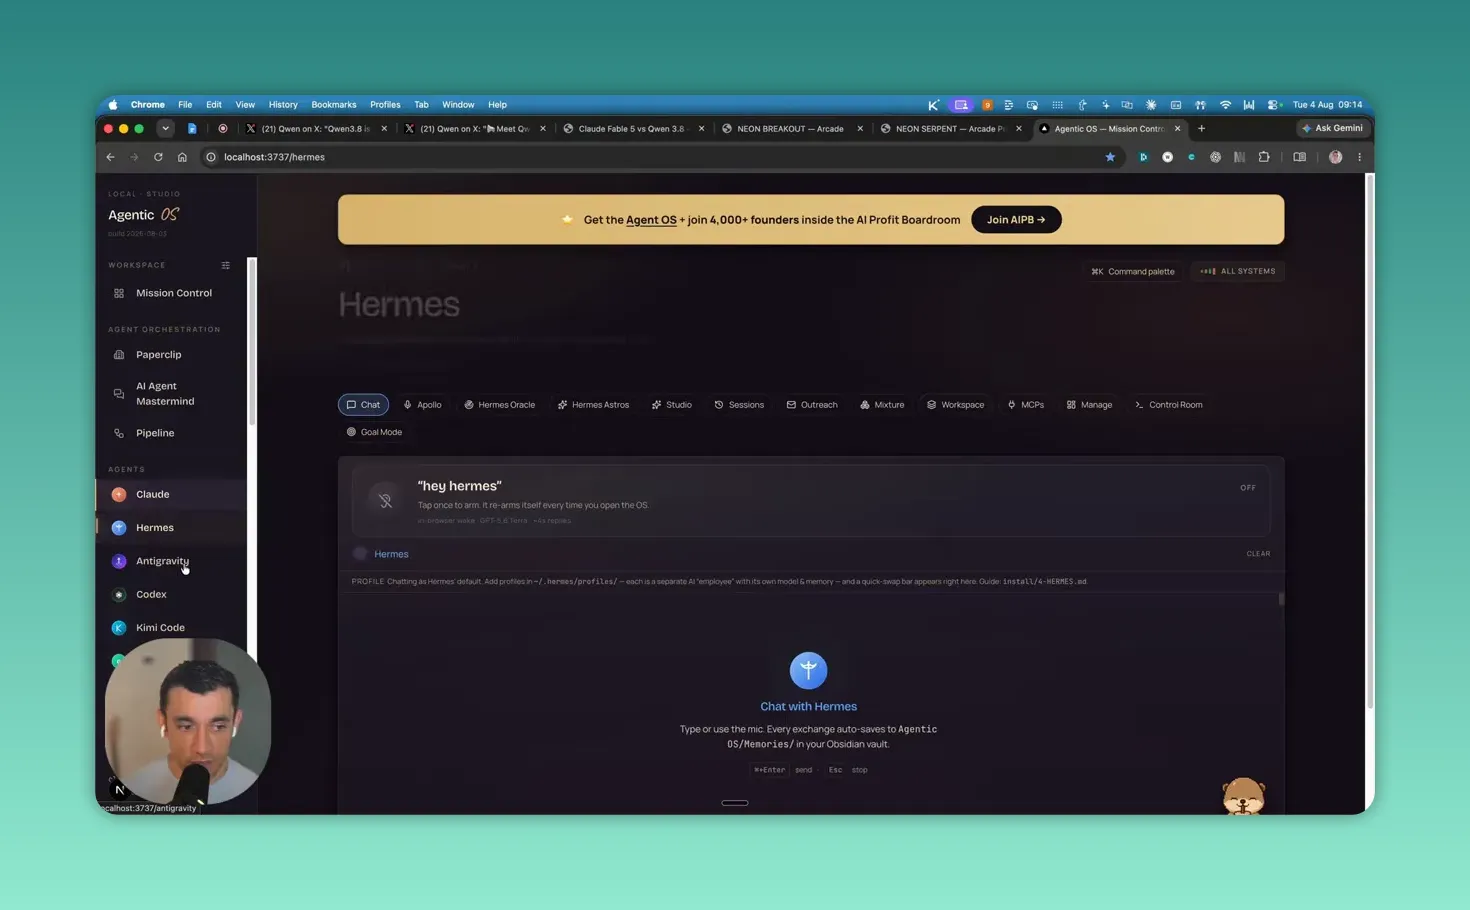
คลิปยกแนวทางการใช้ Claude Code เป็น harness แล้วสลับ model เช่น GLM 5.2, Kimi K3 หรือ Qwen 3.8 ภายในระบบเดียวกัน แม้รายละเอียดทางเทคนิคอาจเกินความจำเป็นสำหรับเจ้าของกิจการ แต่หลักคิดนำไปใช้ได้ทันที: อย่าผูกความรู้และขั้นตอนธุรกิจไว้กับ AI เจ้าเดียว
ตัวอย่างที่จับต้องได้คือฝ่ายการตลาดมี template รับ brief, ข้อมูลสินค้า, โทนแบรนด์, prompt สร้างโพสต์, ขั้นตอนตรวจคำต้องห้าม และช่องอนุมัติอยู่ในที่เดียว เมื่อเปลี่ยน model ทีมก็ยังใช้กระบวนการเดิมได้ สิ่งที่สร้างมูลค่าระยะยาวจึงไม่ใช่ชื่อ model แต่คือชุดข้อมูล กติกา และ workflow ของธุรกิจเราเอง
Step 7: Actionable Insights ที่เริ่มทำได้ทันที
- เลือกงานทดลอง 1 งาน: เริ่มจากงานที่ใช้เวลาซ้ำทุกสัปดาห์ เช่น ทำหน้าโปรโมชัน สรุปรายงานยอดขาย หรือร่าง FAQ
- ทดสอบอย่างน้อย 2 model: ใช้ brief เดียวกัน เกณฑ์เดียวกัน และให้ทีมทดลองแก้งานต่ออย่างน้อย 2 รอบ
- วัดต้นทุนเวลาจริง: บันทึกเวลาตั้งแต่เขียน prompt ตรวจงาน แก้ไข จนพร้อมนำไปใช้ ไม่วัดแค่เวลาที่ AI ตอบ
- แยกงานใหญ่กับงานทดลอง: ใช้ model ที่สม่ำเสมอกับระบบหลัก และใช้ Qwen 3.8 กับ prototype หรือโจทย์ใหม่ที่ต้องการลองเร็ว
- เก็บ prompt และเกณฑ์ตรวจ: ทำเป็นคู่มือกลาง เพื่อให้คนอื่นในทีมทำซ้ำได้ ไม่ขึ้นกับคนที่เก่ง AI เพียงคนเดียว
Step 8: Troubleshooting เมื่อ AI สร้างงานไม่ตรงที่คิด
- ปัญหา: หน้าตางานสวย แต่กดใช้งานแล้ว flow ผิด
สาเหตุ: Prompt ระบุภาพรวม แต่ไม่ได้ระบุลำดับการทำงานและกรณีผิดพลาด
วิธีแก้: เขียนรายการเส้นทางใช้งาน 3 ถึง 5 เส้นทาง เช่น เลือกสินค้า ชำระเงินสำเร็จ ชำระเงินไม่ผ่าน แล้วให้ AI ทดสอบตามรายการนั้น - ปัญหา: แก้จุดเดียว แต่ส่วนเดิมเสีย
สาเหตุ: AI ไม่มีข้อจำกัดชัดเจนว่าส่วนใดห้ามเปลี่ยน
วิธีแก้: ระบุส่วนที่ต้องคงเดิมก่อนสั่งแก้ทุกครั้ง และทดสอบฟังก์ชันเดิมหลังแก้ด้วย checklist - ปัญหา: ผลลัพธ์แกว่งระหว่างทำโปรเจกต์
สาเหตุ: ระบบอาจเปลี่ยน model หรือข้อมูลใน prompt ไม่ครบ
วิธีแก้: บันทึกชื่อ model เวอร์ชัน วันที่ และ prompt ที่ใช้ทุกครั้ง พร้อมเก็บตัวอย่างผลลัพธ์ที่ผ่านมาตรฐาน - ปัญหา: ใช้ AI ฟรีแล้วทีมกลับเสียเวลามากกว่าเดิม
สาเหตุ: เลือกใช้กับงานที่ต้องการความต่อเนื่องสูงเกินไป หรือยังไม่มี template งาน
วิธีแก้: ย้าย AI ไปทำงานต้นแบบก่อน สร้าง template และค่อยขยายไปสู่งานที่ซับซ้อน - ปัญหา: ทีมไม่กล้าใช้เพราะกลัวข้อมูลรั่วไหล
สาเหตุ: ไม่มีขอบเขตข้อมูลและผู้รับผิดชอบชัดเจน
วิธีแก้: แบ่งข้อมูลเป็นสาธารณะ ภายใน และอ่อนไหว แล้วกำหนดว่าแต่ละประเภทใช้กับ AI ได้ระดับใด
Step 9: การต่อยอดจากการเทียบ model สู่ระบบธุรกิจ
- สร้าง AI test library: รวบรวมโจทย์จริงของธุรกิจ 10 ถึง 20 งาน เพื่อใช้เปรียบเทียบ model ใหม่ทุกครั้งอย่างเป็นระบบ
- ทำ workflow แบบ human approval: ให้ AI เตรียมร่างข้อความ รายงาน หรือหน้าเว็บ แต่ให้คนอนุมัติก่อนเผยแพร่หรือส่งลูกค้า
- แยก model ตามบทบาท: ใช้ตัวหนึ่งสร้างโครงสร้าง ใช้อีกตัวช่วยงานภาพหรือ front-end และใช้ model ที่เสถียรกว่าดูแลงานหลักที่เชื่อมระบบ
Step 10: สรุป Checklist ทั้งหมดก่อนเลือก Qwen 3.8 หรือ Fable 5
- ☐ ระบุงานธุรกิจหนึ่งงานที่ต้องการลดเวลาให้ชัด
- ☐ เขียนเกณฑ์ผ่านงาน ทั้งความถูกต้อง ความลื่นไหล และจำนวนรอบแก้
- ☐ ทดสอบ Qwen 3.8 และ Fable 5 ด้วยโจทย์เดียวกัน
- ☐ ทดสอบทั้งงานใหม่และการแก้งานต่อจากของเดิม
- ☐ ตรวจว่า model ที่ใช้อยู่ไม่ถูกสลับโดยไม่ตั้งใจ
- ☐ ใช้ Qwen 3.8 กับต้นแบบ งาน multimodal และงานที่ต้องคุมต้นทุน
- ☐ ใช้ Fable 5 กับโปรเจกต์ใหญ่ที่ต้องการความสม่ำเสมอและต่อยอดจากระบบเดิม
- ☐ เก็บ prompt, template, knowledge และขั้นตอนอนุมัติไว้ในระบบกลาง
- ☐ กำหนดกติกาข้อมูลก่อนนำข้อมูลบริษัทหรือลูกค้าเข้า AI
- ☐ ทบทวน model เป็นระยะ แต่ไม่รื้อ workflow ทุกครั้งที่มีรุ่นใหม่
ข้อสรุปจากการเปรียบเทียบ Qwen 3.8 vs Fable 5 คือ Qwen 3.8 เป็นทางเลือกที่น่าจับตา ทั้งเรื่องความสามารถ ต้นทุน และการรองรับงานภาพหรือวิดีโอ ส่วน Fable 5 ยังมีน้ำหนักในงานใหญ่ที่ต้องทำต่อเนื่อง ความได้เปรียบที่ธุรกิจควรสร้างจึงไม่ใช่การทายว่า model ใดจะชนะรอบหน้า แต่คือการมี workflow ที่พร้อมสลับใช้ AI ตัวที่เหมาะกับงาน โดยไม่ทำให้ความรู้และงานเดิมของทีมสะดุด