ถ่ายทอดจากคลิป Julian Goldie SEO และบทความต้นทางวันที่ 5 สิงหาคม 2026 คำกล่าวเรื่องความเร็ว 20B A1B น้ำหนักสามค่า ขนาดไฟล์ 256 experts/8 active/context128k และใบอนุญาตเป็นข้อมูลที่ต้นทางนำเสนอ ยังไม่ได้ทดสอบซ้ำหรือรับรองสถานะล่าสุด ภาพกราฟเป็นกราฟที่แสดงในคลิป ไม่ใช่การทดสอบของเว็บไซต์ การเก็บข้อมูลในเครื่องต้องตรวจ runtime และตัวเชื่อมต่อด้วย · วิดีโอต้นทาง
ต้นทุน AI ไม่ได้อยู่แค่ค่าสมาชิกหรือค่า API แต่รวมถึงเวลารอคำตอบ ความเสี่ยงจากการส่งข้อมูลออกไป และข้อจำกัดเมื่ออินเทอร์เน็ตไม่พร้อมใช้ด้วย นี่คือเหตุผลที่ Local AI กลับมาเป็นประเด็นสำคัญสำหรับธุรกิจที่ต้องการใช้ AI เป็นเครื่องมือทำงานประจำวัน
คลิปจาก Julian Goldie SEO พูดถึง Maple Preview โมเดลที่ผู้สาธิตระบุว่าเปิดน้ำหนักและชูจุดเด่นเรื่องความเร็ว ขนาดไฟล์เล็ก และการรันบนเครื่องตัวเองได้ แม้ชื่อคลิปจะบอกว่าเร็วกว่า Gemma 4 ถึง 5 เท่า แต่ประเด็นที่มีค่ากว่าสำหรับเจ้าของธุรกิจไทยคือ เราควรเลือก Local AI จาก “งานที่ต้องทำ” ไม่ใช่จากตัวเลข benchmark เพียงอย่างเดียว
Maple มีแนวคิดที่น่าสนใจมาก คือพยายามทำให้โมเดล reasoning ขนาดใหญ่ใช้งานบนอุปกรณ์ขนาดเล็กได้ ตั้งแต่ Mac ไปจนถึงมือถือ โดยไม่ต้องส่งคำสั่งไปประมวลผลบน cloud ตลอดเวลา
สารบัญ
- Step 1: เข้าใจก่อนว่า Maple AI แก้ปัญหาอะไรให้ธุรกิจ
- Step 2: ใช้กราฟ Speed vs Quality ให้ถูก ไม่หลงกับตัวเลขเร็วกว่า 5 เท่า
- Step 3: เข้าใจ Ternary Weights ว่าทำไมโมเดลใหญ่จึงเบาลงได้
- Step 4: มองระบบผู้เชี่ยวชาญของ Maple เป็นการใช้พลังเท่าที่จำเป็น
- Step 5: เริ่มจาก workflow ที่ Local AI ทำได้ดี ไม่ใช่เริ่มจากงานยากที่สุด
- Step 6: ทดสอบ Maple ด้วยเกณฑ์ธุรกิจของเราเอง
- Step 7: เปลี่ยนแนวคิด Maple เป็น Actionable Insights
- Step 8: แก้ปัญหาที่พบบ่อยเมื่อเริ่มใช้ Local AI
- Step 9: การต่อยอดจาก Local AI สู่ระบบงานที่ทีมใช้ทุกวัน
- Step 10: สรุป Checklist ทั้งหมดก่อนนำ Maple AI ไปใช้
Step 1: เข้าใจก่อนว่า Maple AI แก้ปัญหาอะไรให้ธุรกิจ
Maple Preview ถูกอธิบายว่าเป็นโมเดล reasoning แบบ open weights ขนาด 20B ที่มีต้นทุนการรันใกล้เคียงโมเดล 1B หรือที่เรียกว่า 20B A1B จุดขายหลักจึงไม่ใช่การเป็นโมเดลที่เก่งที่สุดทุกด้าน แต่เป็นการหาสมดุลใหม่ระหว่าง คุณภาพคำตอบ ความเร็ว และทรัพยากรเครื่อง
ปัญหาที่ Local AI รุ่นก่อนมักเจอคือ ถ้าโมเดลเล็กเกินไป คำตอบจะตื้นและทำงานซับซ้อนไม่ไหว แต่ถ้าโมเดลใหญ่ขึ้นก็ช้า ใช้หน่วยความจำมาก และทำให้เครื่องทำงานอื่นอืดตามไปด้วย Maple พยายามลดช่องว่างนี้ด้วยสถาปัตยกรรมที่เบากว่าโมเดลทั่วไป
สำหรับธุรกิจไทย ประโยชน์ที่จับต้องได้มีอยู่ 3 ด้าน
- ควบคุมข้อมูลได้มากขึ้น: งานที่มีข้อมูลลูกค้า เอกสารภายใน หรือร่างข้อเสนอราคา ไม่จำเป็นต้องส่งออกไปยังบริการ cloud ทุกครั้ง
- ลดค่าใช้จ่ายต่อการใช้งาน: หลังจากเตรียมเครื่องและโมเดลแล้ว งานซ้ำๆ ไม่คิดต้นทุนตามจำนวน token แบบ API
- ตอบสนองได้ทันที: เหมาะกับงานที่ต้องถามและแก้หลายรอบ เช่น สรุปข้อมูล ร่างข้อความ หรือสร้างต้นแบบหน้าเว็บ
อย่างไรก็ตาม คำว่า “ใช้ฟรี” ต้องอ่านให้ครบความหมาย การรันโมเดลในเครื่องอาจไม่มีค่า API แต่ยังมีต้นทุนอุปกรณ์ พื้นที่เก็บไฟล์ เวลาเซตอัป และคนที่ต้องดูแล workflow ธุรกิจขนาดเล็กจึงไม่จำเป็นต้องย้ายทุกงานมา Local AI แต่ควรเริ่มจากงานที่มีความถี่สูงและข้อมูลอ่อนไหวก่อน
Step 2: ใช้กราฟ Speed vs Quality ให้ถูก ไม่หลงกับตัวเลขเร็วกว่า 5 เท่า
แก่นของคลิปอยู่ที่แนวคิด speed-quality frontier หรือเส้นแลกเปลี่ยนระหว่างความเร็วกับคุณภาพ โมเดลที่ตอบได้ดีมากมักต้องใช้ทรัพยากรมากและตอบช้ากว่า ส่วนโมเดลที่ตอบเร็วมากอาจให้เหตุผลหรือเขียนงานยากได้ไม่ดีเท่า
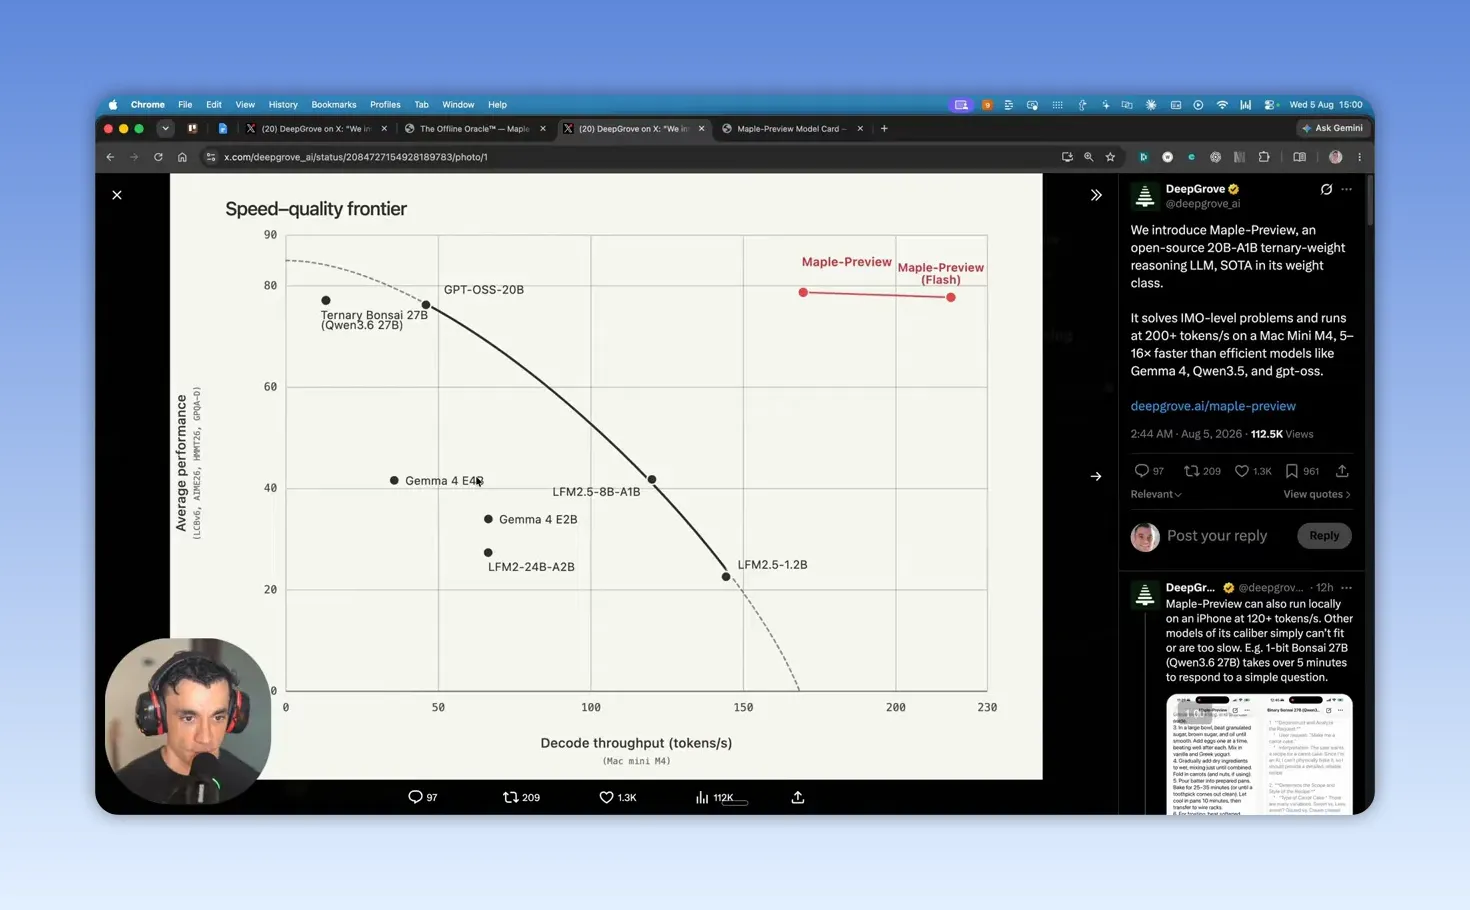
จากกราฟเปรียบเทียบ Maple อยู่ในตำแหน่งที่เน้นทั้งความเร็วและคะแนนเฉลี่ย ขณะที่โมเดลอย่าง Gemma อยู่ใกล้จุดสมดุลกลางๆ และโมเดลระดับ 27B อาจให้ความสามารถมากกว่าในบางงาน แต่ช้าจนไม่เหมาะกับการโต้ตอบต่อเนื่องบนเครื่องบางรุ่น
มุมที่ต้องระวังคือ benchmark ไม่ใช่คำตอบสุดท้ายของธุรกิจ คะแนนสูงในชุดทดสอบไม่ได้แปลว่าจะเขียนภาษาไทยตามน้ำเสียงแบรนด์ได้ดี สรุปเอกสารบริษัทได้ตรง หรือเข้าใจเงื่อนไขการขายของเรา สิ่งที่ควรวัดจริงคือ
- ใช้เวลากี่วินาทีตั้งแต่พิมพ์ prompt จนได้คำตอบที่นำไปต่อได้
- คำตอบผิดพลาดมากแค่ไหน และทีมต้องแก้กี่รอบ
- เครื่องทำงานอื่นไปพร้อมกันได้หรือไม่
- งานนั้นคุ้มพอหรือไม่ที่จะแลกคุณภาพสูงสุดกับความเร็ว
ข้อสังเกตที่น่าเชื่อถือจากคลิปคือ Julian Goldie SEO ไม่ได้อ้างว่า Maple เหนือกว่าโมเดลชั้นนำด้านการเขียนโค้ดทั้งหมด เขาระบุชัดว่าผลทดสอบจริงยังไม่เทียบระดับ Claude Sonnet 5, GLM 4.7 Flash หรือ GPT-OSS ในงาน coding ได้ จุดแข็งของ Maple คือความไว ไม่ใช่ชัยชนะทุกสนาม
Step 3: เข้าใจ Ternary Weights ว่าทำไมโมเดลใหญ่จึงเบาลงได้
เบื้องหลังความเร็วของ Maple คือ ternary weights ปกติโมเดล AI เก็บค่าน้ำหนักการเชื่อมโยงจำนวนมากเป็นตัวเลขละเอียดหลายตำแหน่ง แต่ Maple ลดค่าที่ใช้เก็บลงเหลือเพียง 3 สถานะ คือ ลบ ศูนย์ และบวก
หากเปรียบโมเดลเป็นระบบตัดสินใจขนาดใหญ่ โมเดลปกติอาจใช้ตัวเลขละเอียดเพื่อบอกว่าแต่ละสัญญาณสำคัญระดับไหน ส่วน Maple เลือกบันทึกเพียงว่า สัญญาณนี้ควรต้าน ควรละไว้ หรือควรสนับสนุน ผลที่ตามมาคือไฟล์โมเดลเล็กลงและชิปประมวลผลได้เร็วขึ้น
ตัวเลขในคลิปยกตัวอย่างว่าโมเดลที่เดิมอาจกินพื้นที่ราว 38GB สามารถลดเหลือประมาณ 5GB ได้ แน่นอนว่าไม่ควรตีความว่าโมเดลทุกตัวจะลดขนาดได้เท่านี้เสมอไป แต่แนวคิดสำคัญคือการบีบโมเดลให้เล็กลงโดยยังพยายามรักษาความสามารถในการให้เหตุผล
สำหรับคนทำธุรกิจ ไม่ต้องจำศัพท์เทคนิคทั้งหมดก็ได้ ให้จำผลลัพธ์นี้แทน: โมเดลที่เบาขึ้น เปิดทางให้ AI รันใกล้กับข้อมูลและคนใช้งานมากขึ้น เช่น ผู้จัดการสาขาอาจใช้ AI ช่วยสรุปรายงานภายในบนโน้ตบุ๊ก โดยไม่ต้องพึ่งอินเทอร์เน็ตตลอดเวลา
Step 4: มองระบบผู้เชี่ยวชาญของ Maple เป็นการใช้พลังเท่าที่จำเป็น
Maple ยังใช้แนวคิด expert routing ภายในมีเครือข่ายผู้เชี่ยวชาญย่อย 256 ชุด แต่ทุกครั้งที่สร้างคำหรือ token ระบบจะเลือกเปิดใช้เพียง 8 ชุดที่น่าจะเกี่ยวข้องที่สุด แทนที่จะเปิดทุกส่วนของโมเดลพร้อมกัน
หลักการนี้คล้ายการทำงานของทีมบริษัท งานด้านบัญชีไม่จำเป็นต้องเรียกฝ่ายออกแบบมาร่วมทุกครั้ง และงานออกแบบก็ไม่ควรดึงฝ่ายขายทั้งทีมมาประชุมโดยไม่มีเหตุผล การเลือกใช้ผู้เชี่ยวชาญเฉพาะส่วนช่วยลดต้นทุนการประมวลผล โดยยังคงเข้าถึงความรู้จากระบบที่ใหญ่กว่า
ในคลิปมีการระบุ context window ขนาด 128k token และใบอนุญาตแบบ MIT แต่ก่อนใช้จริงต้องตรวจใบอนุญาตของไฟล์และรุ่นที่ดาวน์โหลดโดยตรง MIT License เป็นใบอนุญาต open-source ที่ยืดหยุ่น แต่การนำโมเดลไปใช้ในธุรกิจยังควรตรวจเงื่อนไขของชุดข้อมูล ระบบที่ครอบโมเดล และนโยบายความปลอดภัยขององค์กรแยกต่างหาก
ในเชิงการทำงานจริง context ที่ยาวช่วยให้เราป้อนเอกสาร นโยบาย หรือข้อมูลโครงการได้มากขึ้นในหนึ่ง session แต่ไม่ได้ทำให้คำตอบแม่นโดยอัตโนมัติ ถ้าใส่ข้อมูลที่ซ้ำ ขัดกัน หรือไม่บอกหน้าที่ของ AI ให้ชัด โมเดลก็ยังสรุปผิดทิศได้อยู่ดี
Step 5: เริ่มจาก workflow ที่ Local AI ทำได้ดี ไม่ใช่เริ่มจากงานยากที่สุด
เดโมในคลิปใช้ Maple สร้างเกม Snake และสั่งสร้าง landing page สำหรับเอเจนซี SEO ภายใน agentic operating system ผลลัพธ์แสดงให้เห็นว่าระบบสร้างโค้ดและเปิด preview ได้รวดเร็ว พร้อมเก็บงานใน workspace และสลับไปทำงานกับ agent หรือโมเดลตัวอื่นได้ระหว่างรอ
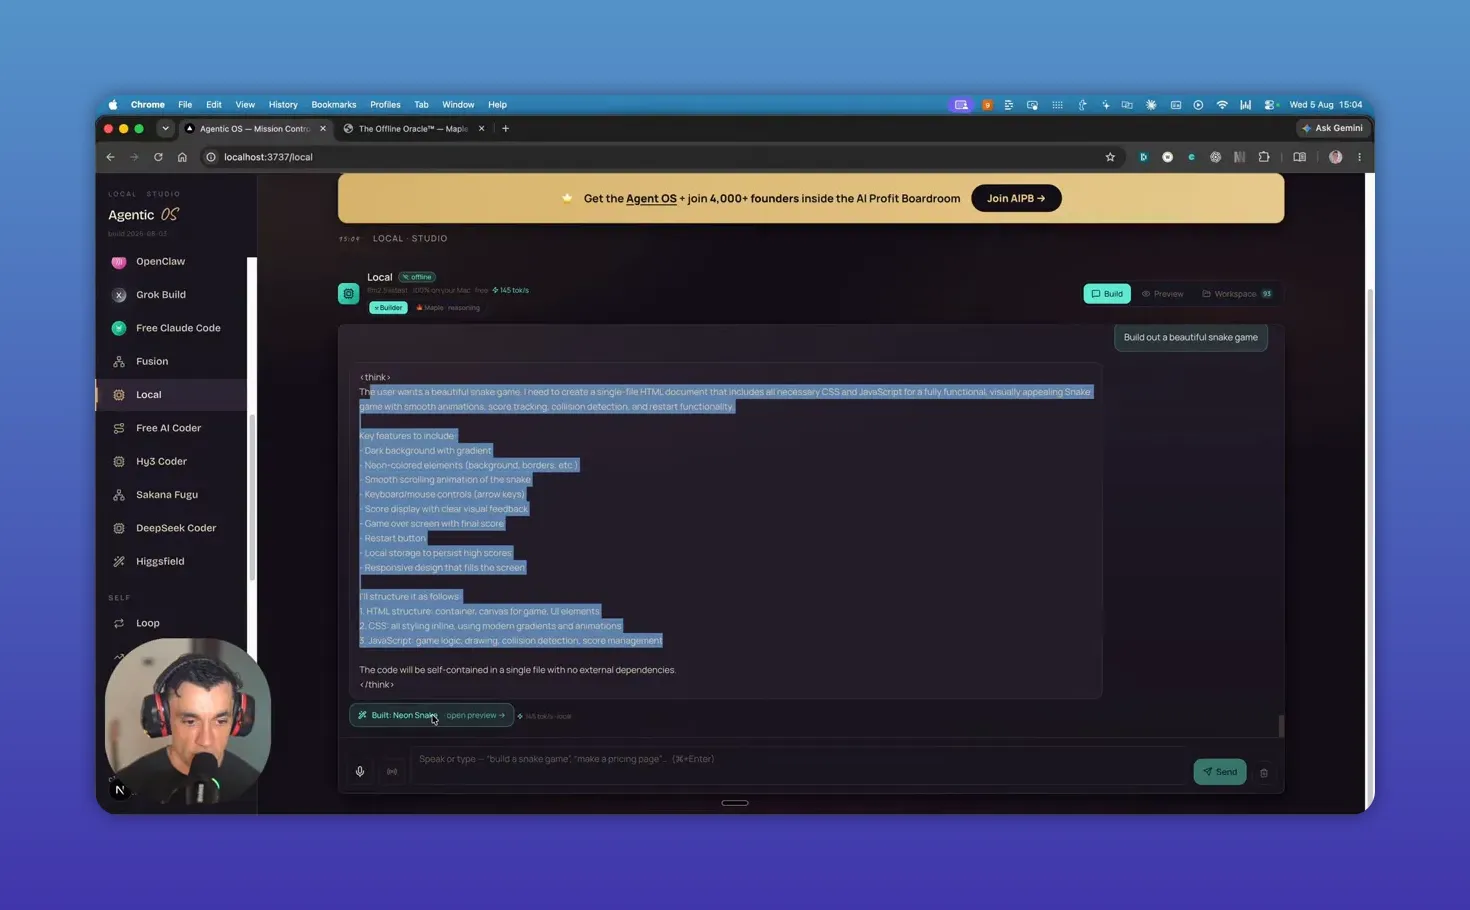
ภาพนี้สะท้อนจุดที่สำคัญกว่าเกมหรือหน้าเว็บ นั่นคือ AI ควรอยู่ใน workflow ไม่ใช่เป็นแค่หน้าต่างแชต ธุรกิจไม่จำเป็นต้องให้โมเดลเดียวทำทุกอย่าง แต่สามารถแบ่งงานตามจุดแข็งของแต่ละ model ได้
ตัวอย่างสำหรับธุรกิจไทยอาจเป็นร้านค้าออนไลน์ที่วาง workflow ดังนี้
- ใช้ Local AI สรุปข้อความจากแชตลูกค้า แยกคำถามเรื่องสินค้า การจัดส่ง และการเคลม
- ใช้โมเดลบน cloud สำหรับงานที่ต้องการภาษาไทยลื่นหรือวิเคราะห์เชิงลึกกว่า
- ให้คนในทีมตรวจคำตอบสุดท้ายก่อนส่งออก โดยเฉพาะเรื่องราคา การรับประกัน และเงื่อนไขทางกฎหมาย
- บันทึกคำถามที่พบบ่อยและคำตอบที่ผ่านการตรวจแล้วไว้เป็น knowledge base
แนวทางนี้ทำให้เราไม่ต้องเลือกระหว่าง Local AI กับ cloud AI แบบสุดทาง งานที่ต้องเร็ว ซ้ำบ่อย และข้อมูลภายในสามารถอยู่บนเครื่อง ส่วนงานที่ต้องการคุณภาพสูงมากก็เรียกใช้โมเดล cloud เฉพาะจังหวะที่คุ้มค่า
Step 6: ทดสอบ Maple ด้วยเกณฑ์ธุรกิจของเราเอง
Maple สามารถทดลองใช้ผ่านหน้าแชตของโครงการ หรือดาวน์โหลด open weights จาก Hugging Face แต่ก่อนเริ่มติดตั้งควรกำหนดโจทย์ทดสอบให้ชัด เพราะการถามคำถามทั่วไปเพียงข้อเดียวแทบไม่บอกว่าโมเดลเหมาะกับงานจริงหรือไม่
ชุดทดสอบที่ใช้งานได้สำหรับทีมเล็กควรมี 10 ถึง 20 งานซ้ำจริง เช่น สรุปบันทึกประชุม เปลี่ยนข้อความสินค้าเป็นโพสต์หลายรูปแบบ จัดหมวดหมู่คำถามลูกค้า ร่างโครงหน้า landing page หรือแปลงโน้ตฝ่ายขายเป็นรายการติดตามงาน
ให้ทีมให้คะแนนแต่ละงานจาก 1 ถึง 5 ใน 4 มิติ ได้แก่ ความเร็ว ความถูกต้อง ความต้องแก้ไข และความเหมาะสมกับข้อมูลภายใน จากนั้นเปรียบเทียบ Maple กับเครื่องมือที่ใช้อยู่เดิม ผลลัพธ์จะตอบได้ชัดกว่าคำโฆษณาว่า “เร็วกว่า” สำหรับงานของเราหมายถึงอะไร
ข้อจำกัดที่ต้องยอมรับตรงๆ คือการรัน Local AI ไม่ได้เป็นทางลัดสำหรับทุกบริษัท หากทีมไม่มีเครื่องที่พร้อม ไม่มีคนดูแลการติดตั้ง หรือยังไม่มี workflow ที่นิยามชัดเจน การเริ่มด้วยบริการ AI สำเร็จรูปอาจเหมาะกว่า Maple น่าสนใจมากในฐานะชิ้นส่วนหนึ่งของระบบ ไม่ใช่คำตอบสำเร็จรูปของการทำ AI transformation
Step 7: เปลี่ยนแนวคิด Maple เป็น Actionable Insights
- เลือกงานก่อนเลือก model: จด 5 งานที่ทีมทำซ้ำทุกสัปดาห์ แล้วเลือกงานที่ข้อมูลอ่อนไหวหรือเสียเวลารอมากที่สุดมาทดลอง Local AI
- กำหนดเกณฑ์ผ่านให้วัดได้: เช่น ลดเวลาสรุปประชุมจาก 30 นาทีเหลือ 10 นาที โดยยังต้องมีคนตรวจทุกครั้ง
- ออกแบบระบบสองชั้น: ให้ Local AI รับงานร่าง สรุป จัดหมวด และใช้ cloud AI เฉพาะงานที่ต้องใช้คุณภาพภาษา เหตุผล หรือความรู้กว้างกว่า
- สร้างคลัง prompt ที่ผ่านงานจริง: เก็บ prompt ที่ให้ผลดี พร้อมตัวอย่าง input และรูปแบบ output ที่ทีมต้องการ
- อย่าปล่อย AI ตัดสินใจแทน: งานที่มีผลต่อราคา เงิน ความเป็นส่วนตัว หรือคำมั่นต่อลูกค้า ต้องมีจุดอนุมัติโดยคนเสมอ
Step 8: แก้ปัญหาที่พบบ่อยเมื่อเริ่มใช้ Local AI
- ปัญหา: โมเดลตอบช้าหรือเครื่องอืด
สาเหตุ: เครื่องมีหน่วยความจำไม่พอ หรือเปิดหลายงานหนักพร้อมกัน
วิธีแก้: ปิดโปรแกรมที่ไม่จำเป็น เลือกโมเดลที่เบากว่า ทดสอบทีละ workflow และวัดเวลาจริงก่อนเพิ่มจำนวนผู้ใช้ - ปัญหา: คำตอบดีบ้างแย่บ้าง แม้ใช้ prompt เดิม
สาเหตุ: ข้อมูลนำเข้าขาดรายละเอียด มีหลายประเด็นปนกัน หรือไม่ได้กำหนดรูปแบบคำตอบ
วิธีแก้: แยกงานให้เล็กลง ระบุบทบาท ข้อมูลที่ต้องใช้ ข้อห้าม และตัวอย่าง output ที่ต้องการให้ชัด - ปัญหา: โมเดลเขียนโค้ดหรือหน้าเว็บได้ แต่ใช้งานจริงไม่ได้
สาเหตุ: งานสร้างต้นแบบต่างจากงาน production และโมเดลอาจสร้างส่วนที่ขาดหรือผิดพลาด
วิธีแก้: ใช้ผลลัพธ์เป็น draft ตรวจการทำงานบนอุปกรณ์จริง ตรวจเนื้อหา ปุ่ม ลิงก์ และข้อมูลสำคัญก่อนเผยแพร่ - ปัญหา: ทีมคิดว่า Local AI จะไม่มีค่าใช้จ่ายเลย
สาเหตุ: สับสนระหว่างไม่มีค่า API กับไม่มีต้นทุนทั้งหมด
วิธีแก้: คิดค่าเครื่อง พื้นที่เก็บไฟล์ เวลาติดตั้ง และเวลาตรวจงานรวมในต้นทุนโครงการตั้งแต่ต้น - ปัญหา: ส่งเอกสารภายในเข้าโมเดลโดยไม่มีนโยบาย
สาเหตุ: ทีมเห็นว่าโมเดลรันในเครื่องจึงคิดว่าปลอดภัยทุกกรณี
วิธีแก้: กำหนดระดับข้อมูลที่ป้อนได้ จำกัดสิทธิ์เข้าถึง workspace และลบข้อมูลทดสอบเมื่อจบงาน
Step 9: การต่อยอดจาก Local AI สู่ระบบงานที่ทีมใช้ทุกวัน
แนวคิดแรกคือสร้าง ผู้ช่วยความรู้ภายใน โดยเริ่มจากเอกสารที่มีโครงสร้าง เช่น คู่มือบริการ FAQ นโยบายคืนสินค้า และสคริปต์ตอบลูกค้า จุดเริ่มต้นควรเป็นข้อมูลที่ทีมตรวจสอบความถูกต้องได้ง่าย ไม่ใช่โยนไฟล์ทุกอย่างเข้าไปพร้อมกัน
แนวคิดที่สองคือใช้ Local AI เป็นด่านคัดแยกงาน เช่น อ่านฟอร์มติดต่อเข้า จัดหมวดลีด สรุปข้อเสนอจากฝ่ายขาย หรือแปลงบันทึกเสียงเป็นหัวข้อทำงานต่อ จากนั้นจึงส่งเฉพาะงานสำคัญให้คนหรือโมเดลที่เก่งกว่า
แนวคิดสุดท้ายคือสร้าง dashboard วัดผลการใช้ AI ของทีม ไม่ต้องเริ่มด้วยระบบใหญ่ แค่บันทึกประเภทงาน เวลาเดิม เวลาหลังใช้ AI และจำนวนรอบแก้ไข ก็เพียงพอจะช่วยให้เราเห็นว่าการลงทุนใน Local AI สร้างผลลัพธ์ตรงไหนจริง
Step 10: สรุป Checklist ทั้งหมดก่อนนำ Maple AI ไปใช้
- ☐ ระบุงานซ้ำที่ใช้เวลาเยอะและมีข้อมูลภายใน
- ☐ แยกให้ออกว่างานใดต้องการความเร็ว และงานใดต้องการคุณภาพสูงสุด
- ☐ ตรวจความพร้อมของเครื่อง พื้นที่เก็บไฟล์ และผู้ดูแลระบบ
- ☐ ทดลอง Maple กับชุดงานจริง 10 ถึง 20 งาน
- ☐ วัดความเร็ว ความถูกต้อง จำนวนรอบแก้ และต้นทุนรวม
- ☐ ทำ prompt template ที่ทีมใช้ซ้ำได้
- ☐ วางจุดตรวจโดยคนสำหรับงานสำคัญ
- ☐ กำหนดนโยบายข้อมูลก่อนป้อนเอกสารภายใน
- ☐ ใช้ Local AI ร่วมกับ cloud AI ตามจุดแข็งของแต่ละ model
- ☐ ขยายผลเฉพาะ workflow ที่พิสูจน์แล้วว่าช่วยประหยัดเวลา
Maple AI น่าสนใจเพราะทำให้ภาพของ Local AI ใกล้ความจริงขึ้นมาก โมเดล reasoning ที่เบา เร็ว และรันบนเครื่องได้อาจไม่แทนโมเดล cloud ชั้นนำในทุกงาน แต่สำหรับธุรกิจที่เริ่มจาก workflow ที่ถูกต้อง มันอาจกลายเป็นผู้ช่วยประจำเครื่องที่ลดเวลางานซ้ำ คุมข้อมูลได้ดีขึ้น และเปิดทางให้เราใช้ AI โดยไม่ต้องจ่ายเพิ่มทุกครั้งที่พิมพ์คำสั่ง