ถ่ายทอดจากบทความต้นทางลงวันที่ 15 กันยายน 2026 และคลิป 5 Voice Agent Failure Modes You’ll Hit in Week One โดย Venky B แห่ง Plivo บนช่อง AI Engineer ตัวเลขเวลาและข้อสังเกตเป็นสิ่งที่ผู้บรรยายรายงานจากงานของตน ไม่ใช่เกณฑ์มาตรฐานหรือผลทดสอบอิสระสำหรับทุกระบบ ตัวอย่างภาษาไทยและเช็กลิสต์คงจากบทความเดิม วันที่นี้เป็นวันที่บทความต้นทาง ไม่ใช่วันอัปโหลดวิดีโอซึ่งยังไม่ทราบ
Voice AI Agent ที่ตอบคำถามได้ลื่นไหลในการเดโม อาจกลายเป็นระบบที่สร้างความหงุดหงิดให้ลูกค้าได้ทันทีเมื่อรับสายจริงหลายร้อยสายต่อวัน ปัญหาไม่ได้อยู่ที่เลือก AI model ไม่เก่งพอเพียงอย่างเดียว แต่อยู่ที่รายละเอียดเล็กๆ ระหว่างเสียงพูด ข้อความ การตรวจข้อมูล และเสียงตอบกลับ
คลิปจากช่อง AI Engineer ที่นำเสนอโดย Venky B จาก Plivo ชี้ให้เห็นความล้มเหลว 5 รูปแบบที่พบเมื่อ Voice AI Agent ออกจากช่วง proof of concept ไปสู่การใช้งานจริง บทเรียนนี้น่าสนใจมากสำหรับเจ้าของธุรกิจไทย เพราะระบบโทรศัพท์อัตโนมัติมักต้องรับมือทั้งสำเนียง ชื่อเฉพาะ ภาษาไทยปนอังกฤษ และข้อมูลสำคัญอย่างเบอร์โทรหรือที่อยู่
แก่นของเรื่องคือ เราไม่ควรออกแบบ Voice AI เป็นเพียงแชตบอตที่เปลี่ยนข้อความเป็นเสียง แต่ต้องมองมันเป็น workflow การสนทนา ที่ต้องมีโครงสร้าง การตรวจสอบ และทางออกเมื่อ AI ไม่แน่ใจ
Step 1: มอง Voice AI Agent เป็นระบบหลายชั้น ไม่ใช่ prompt เดียว
โครงสร้างพื้นฐานที่หลายทีมเริ่มต้นมักประกอบด้วย 4 ชั้น คือ speech-to-text สำหรับแปลงเสียงเป็นข้อความ, LLM สำหรับคิดและตอบ, ระบบตรวจจังหวะการพูด และ text-to-speech หรือ TTS สำหรับสร้างเสียงตอบกลับ แนวทางนี้ทำเดโมได้เร็ว แต่ทุกชั้นเพิ่มทั้งเวลา ความคลาดเคลื่อน และจุดที่ระบบอาจพัง
เมื่อใช้จริง ความผิดพลาดจากแต่ละชั้นจะส่งต่อกันเป็นลูกโซ่ ถ้าระบบฟังชื่อผิด LLM ก็จะตีความบนข้อมูลที่ผิด ถ้า LLM สร้างข้อความไม่เหมาะกับการออกเสียง TTS ก็จะอ่านสะดุด และถ้าตรวจผิดว่าปลายสายพูดจบแล้ว AI ก็อาจพูดแทรกกลางประโยค
สำหรับธุรกิจไทย ควรเริ่มจากโจทย์ที่แคบและวัดผลได้ เช่น รับจองคิว ยืนยันนัดหมาย ติดตามสถานะคำสั่งซื้อ หรือคัดกรองลูกค้าที่ต้องการให้เจ้าหน้าที่โทรกลับ อย่าเริ่มจากโจทย์ว่า “ให้ AI รับได้ทุกเรื่อง” เพราะขอบเขตที่กว้างทำให้ควบคุมคุณภาพไม่ได้
ก่อนเลือก platform หรือ model ให้เขียนแผนการสนทนาออกมาก่อนว่า AI ต้องเก็บข้อมูลอะไรบ้าง ข้อมูลไหนผิดไม่ได้ จุดไหนต้องยืนยันซ้ำ และเมื่อใดต้องโอนสายให้คน
Step 2: วัดความเร็วตอบกลับให้เหมือนวัดคุณภาพบริการ
ความล้มเหลวแรกคือ latency หรือเวลารอหลังปลายสายพูดจบจน AI เริ่มส่งเสียงตอบกลับ ตัวชี้วัดสำคัญคือ time to first audio ไม่ใช่แค่เวลาที่ model สร้างข้อความเสร็จ
Venky ระบุว่าทีมที่เขาพบมักต้องการเวลาไม่เกิน 550 มิลลิวินาที แต่ในประสบการณ์ของเขาการใช้งานจริงมักอยู่ราว 750 ถึง 1,200 มิลลิวินาที และเมื่อช้ากว่านั้น ความรู้สึกจะเริ่มคล้ายระบบค้าง จนอาจทำให้สายหลุดได้
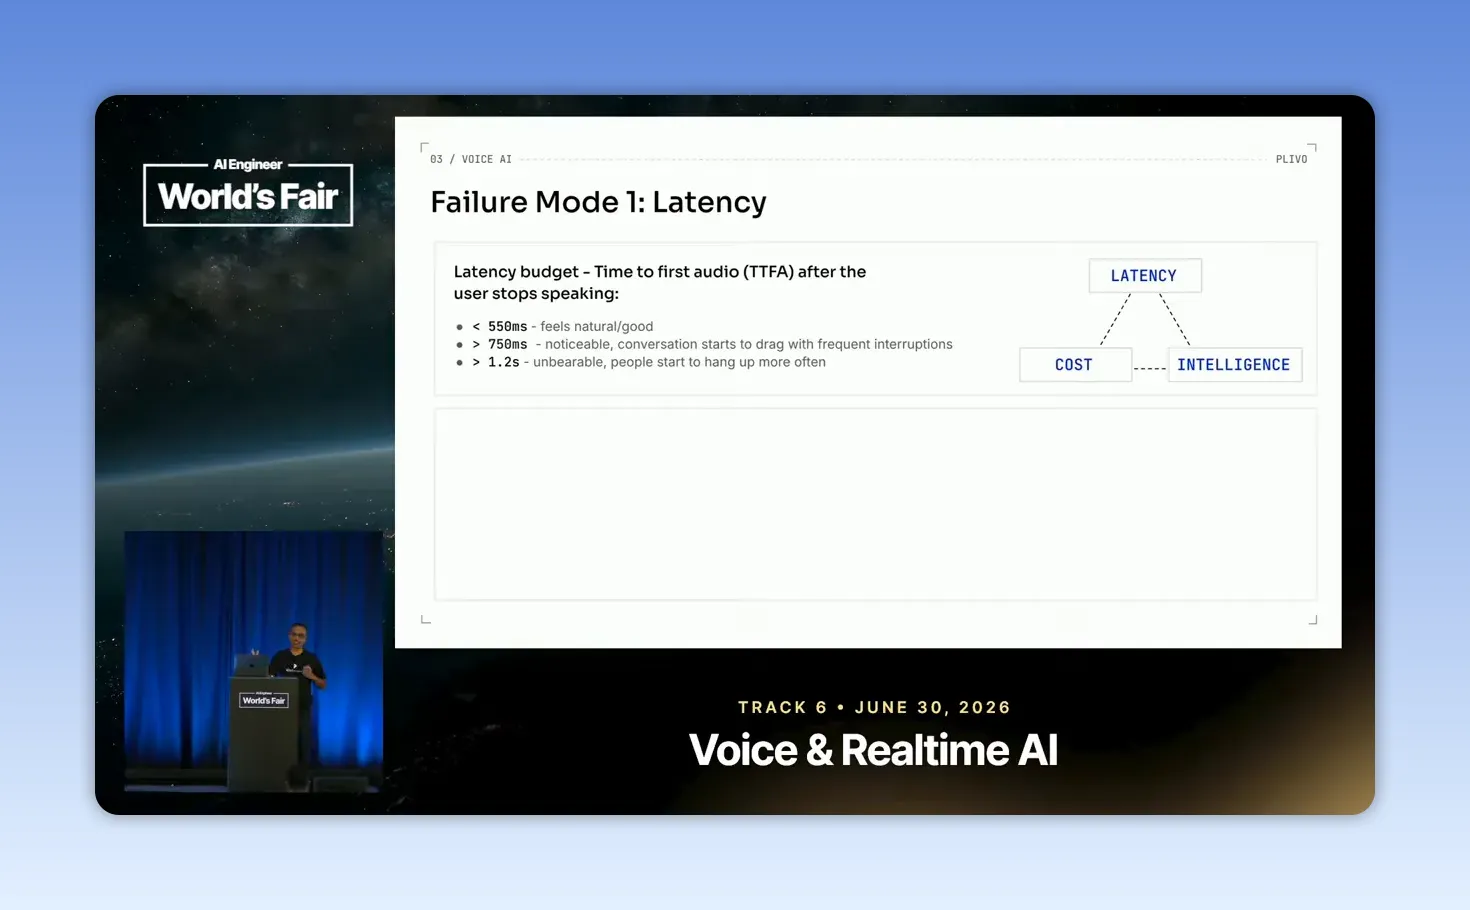
จุดที่ต้องยอมรับคือ Voice AI มีข้อจำกัดต่างจากแชต AI อย่างชัดเจน LLM ที่ใช้เวลาคิดนานอาจให้คำตอบดีขึ้น แต่การเว้นช่วงเงียบก่อนพูดทำลายประสบการณ์การสนทนา ดังนั้น AI รับสายไม่จำเป็นต้องใช้ model ที่ฉลาดที่สุดในทุกจังหวะ แต่ต้องใช้ model ที่ตอบได้เร็วพอและทำงานตามคำสั่งได้สม่ำเสมอ
แนวคิดที่นำไปใช้ได้จริงคือแยกงานเป็นสองระดับ งานพูดคุยทั่วไป เช่น ทักทาย ถามข้อมูลพื้นฐาน และตอบคำถามตามคู่มือ ใช้ model ขนาดเล็กที่เร็วกว่า ส่วนงานที่ต้องเรียกข้อมูลจากระบบ เช่น ตรวจยอดค้างชำระ เช็กสต็อก หรือสร้างนัดหมาย อาจส่งต่อไปยัง model ที่เก่งเรื่อง tool calling มากกว่า
ไม่จำเป็นที่ธุรกิจขนาดเล็กต้องลงทุนโฮสต์ open source model เองตั้งแต่วันแรก แต่ควรกำหนด SLA ของประสบการณ์ เช่น เวลาตอบกลับเฉลี่ยและเวลาที่ช้าที่สุดที่ยอมรับได้ แล้วทดสอบกับสายจริง ไม่ใช่ทดสอบเฉพาะบนอินเทอร์เน็ตที่เสถียร
Step 3: เผื่อความผิดพลาดของ speech-to-text
ความล้มเหลวข้อที่สองคือการเชื่อว่าระบบถอดเสียงจะถูกต้อง แม้ระบบ speech-to-text ชั้นดีจะมีอัตราคลาดเคลื่อนต่ำในการทดสอบมาตรฐาน แต่สายจริงเต็มไปด้วยเสียงรบกวน สำเนียง คำเฉพาะทาง และการสลับภาษา
ปัญหาจะเห็นชัดในประเทศไทย เช่น ลูกค้าพูดว่า “นัดวันพุธ next week ตอนบ่ายสอง” หรือสะกดชื่อแบรนด์ภาษาอังกฤษปนไทย รวมถึงชื่อสินค้า รุ่นรถ รหัสโปรโมชัน และชื่อถนน ซึ่งเป็นข้อมูลที่ AI เดาไม่ได้ง่ายๆ
ใช้คำสำคัญแบบไดนามิก
หลายระบบรองรับ keyword boosting เพื่อช่วยให้ speech-to-text จับชื่อเฉพาะได้แม่นขึ้น แต่ไม่ควรใส่คำสำคัญทุกคำค้างไว้ตลอดสาย เพราะอาจทำให้ระบบเอนเอียงจนได้คำที่ไม่ได้พูดจริง
วิธีที่ดีกว่าคือใส่คำสำคัญตามสถานะของบทสนทนา ตัวอย่างเช่น ตอนถามชื่อสินค้า ให้เพิ่มเฉพาะรายชื่อสินค้าหรือแบรนด์ ตอนถามสาขา ให้เพิ่มรายชื่อจังหวัด เขต และสาขา ตอนถามชื่อผู้ติดต่อ ให้เพิ่มข้อมูลจาก CRM เฉพาะเคสนั้น
ทำความสะอาดข้อความก่อนส่งเข้า LLM
ควรมีชั้น normalization ระหว่าง speech-to-text กับ LLM เพื่อปรับรูปแบบตัวเลข คำทับศัพท์ และข้อความหลายภาษา ตัวอย่างเช่น หากระบบได้ตัวอักษรคล้าย “E” อยู่กลางเบอร์โทร ระบบควรตรวจได้ว่าตำแหน่งนี้ต้องเป็นตัวเลข แล้วขอให้ยืนยันหรือแก้ไขก่อนบันทึก
LLM ช่วย post-process ข้อความได้ เพราะมันรู้ว่าเบอร์โทรควรมีลักษณะอย่างไร หรือชื่อสินค้าใดอยู่ในฐานข้อมูล แต่ไม่ควรเปิดให้ LLM เดาเองโดยไม่ตรวจสอบในข้อมูลที่มีผลต่อธุรกรรม
Step 4: เก็บข้อมูลเป็นฟิลด์ ไม่ใช่ปล่อยให้ AI สรุปจากบทสนทนา
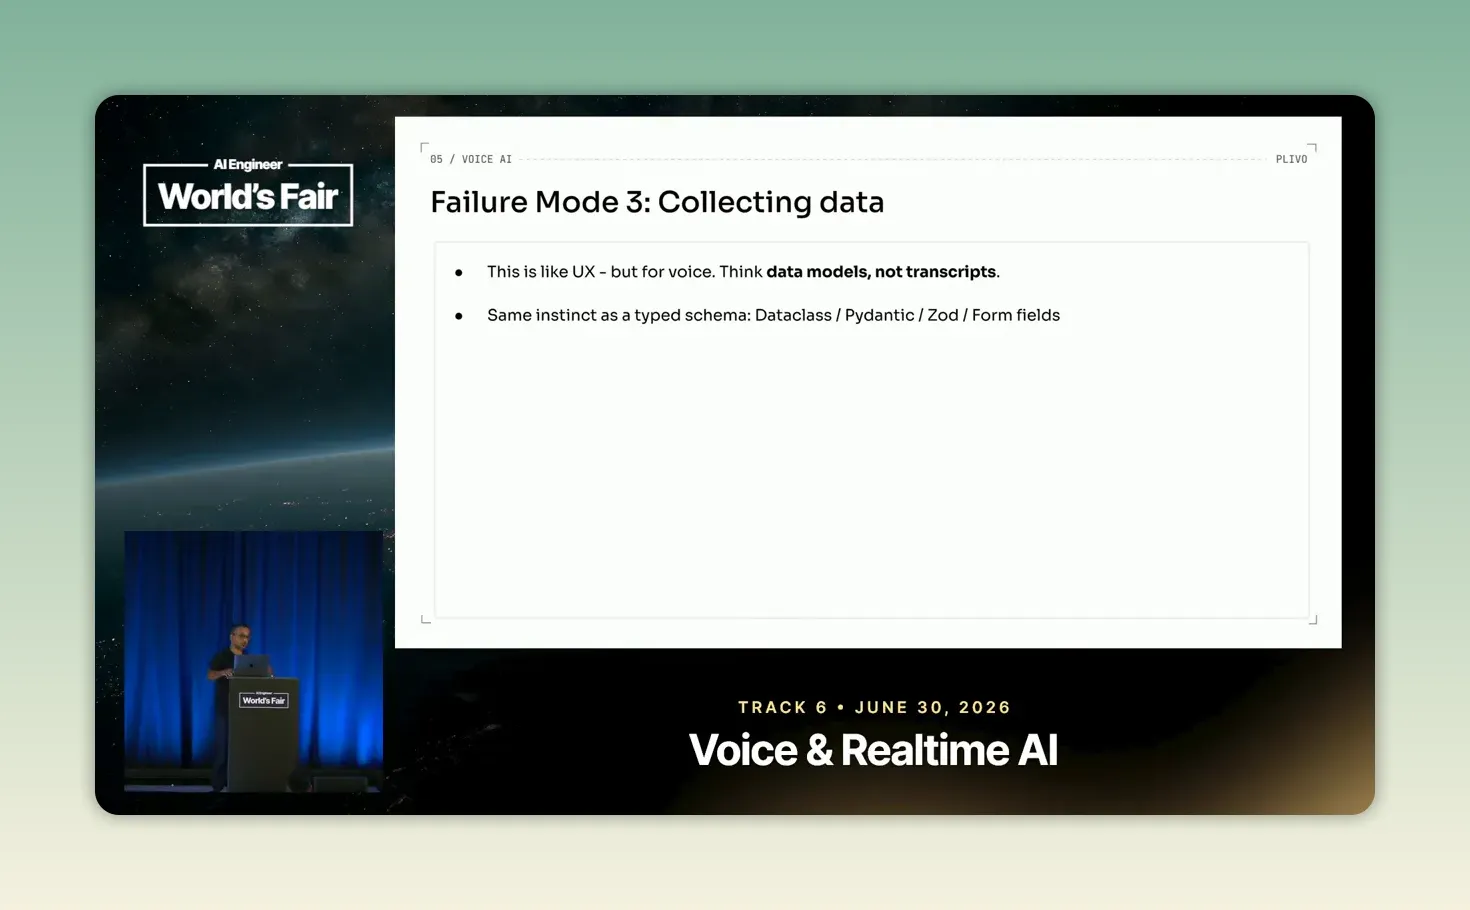
นี่คือจุดที่สำคัญที่สุดสำหรับธุรกิจที่ใช้ AI รับข้อมูล Venky B ระบุว่าการเก็บข้อมูลเป็นจุดที่ระบบจำนวนมากพัง โดยปัญหาไม่ใช่แค่เรื่องการฟังผิด แต่เป็นเรื่อง UX ของการสนทนา
แทนที่จะส่งบทสนทนาทั้งหมดให้ LLM แล้วสั่งว่า “สรุปชื่อ เบอร์โทร และเวลานัดหมาย” เราควรกำหนดรูปทรงข้อมูลก่อนเริ่มถาม เช่น
- ชื่อ: ข้อความ และต้องยืนยันการสะกดเมื่อระบบไม่มั่นใจ
- เบอร์โทร: ตัวเลขตามจำนวนหลักที่กำหนด พร้อมตรวจรูปแบบ
- อีเมล: อ่านและทวนทีละส่วนเมื่อจำเป็น
- สาขา: เลือกได้เฉพาะรายชื่อสาขาที่มีจริง
- วันเวลานัด: แปลงเป็นวันเวลาแบบชัดเจนก่อนบันทึก
เมื่อถามว่า “สะดวกวันพุธหน้า 8 โมง” ระบบต้องไม่รีบบันทึกทันที เพราะยังไม่รู้ว่าเป็น 8 โมงเช้าหรือ 2 ทุ่ม และต้องแปลงคำว่า “พุธหน้า” เทียบกับวันที่ปัจจุบันด้วย วิธีที่ปลอดภัยคือให้ AI สรุปกลับเป็นรูปแบบชัดเจน เช่น วัน เดือน ปี และเวลา แล้วรอคำยืนยัน
มุมมองนี้เปลี่ยน Voice AI จากระบบที่ “พยายามเข้าใจทุกอย่าง” เป็นระบบที่ “เก็บข้อมูลสำคัญให้ครบและถูกต้อง” ซึ่งเหมาะกับงานธุรกิจมากกว่า โดยเฉพาะนัดหมายคลินิก ฝ่ายขาย ประกัน อสังหาริมทรัพย์ และบริการหลังการขาย
ทดสอบทีละฟิลด์ ไม่ใช่ทดสอบทั้งสายอย่างเดียว
การทดสอบแบบ end-to-end มีประโยชน์ แต่หาสาเหตุยากเมื่อเกิดข้อผิดพลาด ทางที่ดีกว่าคือสร้างชุดทดสอบระดับฟิลด์ เช่น เบอร์โทรที่พูดเร็ว ชื่อที่ออกเสียงยาก วันที่แบบกำกวม หรือที่อยู่ที่มีคำไทยปนอังกฤษ
หากฟิลด์ใดเริ่มผิด เราจะรู้ทันทีว่าต้องแก้ที่ speech-to-text, กติกาตรวจข้อมูล, prompt หรือ flow การยืนยัน ไม่ต้องไล่แก้ทั้งระบบแบบเดาสุ่ม
Step 5: สร้างชั้นแปลงข้อความก่อนให้ TTS พูด
ข้อผิดพลาดข้อที่สี่เกิดเมื่อส่งข้อความจาก LLM เข้า TTS โดยตรง LLM อาจสร้าง markdown, emoji, ตัวย่อ, อีเมล, วันที่ หรือราคาที่อ่านออกเสียงไม่เป็นธรรมชาติ แม้ TTS หลายเจ้าแก้ปัญหาเหล่านี้ได้บางส่วน แต่ธุรกิจไม่ควรฝากคุณภาพไว้กับผู้ให้บริการเพียงรายเดียว
ควรสร้าง normalization layer ก่อนสังเคราะห์เสียง โดยมีรายการพื้นฐานดังนี้
- ตัด emoji, markdown และสัญลักษณ์ที่ไม่ควรอ่านออกเสียง
- สร้างพจนานุกรมการออกเสียงสำหรับแบรนด์ ชื่อสินค้า ชื่อบุคคล และตัวย่อ
- กำหนดรูปแบบการอ่านตัวเลข เงิน วันที่ อีเมล และเบอร์โทร
- ลดความเร็วการพูดเมื่ออ่านข้อมูลสำคัญทีละตัว เช่น รหัส OTP หรือหมายเลขอ้างอิง
- แยกข้อความที่ใช้แสดงผลออกจากข้อความที่ออกเสียง
หากร้านมีชื่อแบรนด์ภาษาอังกฤษที่อ่านเฉพาะทาง หรือมีรหัสสินค้าเช่น “X3 Pro” ต้องกำหนดการออกเสียงให้ชัดเจนตั้งแต่ต้น จุดทดสอบง่ายที่สุดคือให้ AI อ่านชื่อบริษัท ชื่อพนักงาน ชื่อสินค้า และเบอร์โทรของเราเอง หากอ่านสิ่งพื้นฐานเหล่านี้ผิด ก็ไม่ควรปล่อยไปเจอลูกค้าจริง
การมีชั้นนี้ยังช่วยให้เปลี่ยนผู้ให้บริการ TTS ได้ง่ายขึ้นในอนาคต โดยไม่ต้องแก้ flow การสนทนาทั้งหมด
Step 6: ทำให้ AI รู้จังหวะหยุด ฟังต่อ และยอมให้ขัดจังหวะ
ความล้มเหลวข้อที่ห้าคือ turn detection และ barge-in หรือการที่ระบบจับไม่ได้ว่าปลายสายพูดจบหรือยัง รวมถึงหยุดพูดไม่ได้เมื่ออีกฝ่ายเริ่มพูดแทรก ปัญหานี้อาจดูเล็ก แต่ส่งผลต่อความรู้สึกว่า AI “ฟังอยู่” หรือกำลังพูดตามสคริปต์
หาก AI ตัดบทเร็วเกินไป มันจะเก็บข้อมูลไม่ครบ หากรอนานเกินไป ทุกคำตอบจะมีช่องว่างน่าอึดอัด และหากไม่รองรับ barge-in ลูกค้าจะต้องรอฟัง AI พูดยาวจนจบแม้ต้องการแก้ข้อมูลเพียงคำเดียว
สำหรับ workflow ธุรกิจ ควรกำหนดกติกาง่ายๆ ก่อน เช่น ให้ AI ตอบสั้นในขั้นเก็บข้อมูล หยุดเสียงทันทีเมื่อพบการพูดแทรก และทวนคำตอบเฉพาะข้อมูลเสี่ยงสูง การทำให้เสียง AI เป็นธรรมชาติไม่จำเป็นต้องเริ่มจากระบบซับซ้อน แต่ต้องเริ่มจากการไม่พูดทับ ไม่เว้นช่วงนาน และไม่อ่านสคริปต์ยาวเกินจำเป็น
Step 7: เปลี่ยน 5 บทเรียนเป็น Actionable Insights
- เลือก 1 workflow ก่อน: เริ่มจากงานที่คำตอบและข้อมูลมีรูปแบบชัด เช่น จองคิว ยืนยันนัด หรือรับเรื่องบริการ
- ตั้งตัวเลขคุณภาพ: วัด time to first audio, อัตราเก็บข้อมูลครบ, อัตราขอให้พูดซ้ำ และอัตราโอนสายให้เจ้าหน้าที่
- ทำรายการคำเสี่ยง: รวบรวมชื่อแบรนด์ รุ่นสินค้า สาขา เขต ชื่อบุคคล และคำอังกฤษที่ใช้บ่อย เพื่อป้อนให้ระบบตามช่วงที่เหมาะสม
- ออกแบบการยืนยัน: ให้ AI ยืนยันเบอร์โทร วันนัด ที่อยู่ และข้อมูลที่ความผิดพลาดมีต้นทุนสูง
- วาง human handoff: เมื่อระบบไม่มั่นใจหรือเจอคำถามนอกขอบเขต ให้ส่งต่อเจ้าหน้าที่พร้อมสรุปข้อมูลที่เก็บได้
Step 8: แก้ปัญหาที่พบบ่อยก่อนระบบสร้างต้นทุนแฝง
- ปัญหา: AI เงียบนานหลังปลายสายพูดจบ
สาเหตุ: latency รวมของ speech-to-text, LLM, การเรียกเครื่องมือ และ TTS สูงเกินไป
วิธีแก้: วัดเวลาแยกตามแต่ละชั้น ลดความยาวคำตอบ ใช้ model ที่เร็วขึ้นกับงานสนทนาทั่วไป และลดการเรียกเครื่องมือที่ไม่จำเป็น - ปัญหา: เก็บเบอร์โทรหรือชื่อผิด
สาเหตุ: ใช้ข้อความถอดเสียงดิบโดยไม่มีการตรวจรูปแบบ
วิธีแก้: กำหนดฟิลด์เบอร์โทร ตรวจจำนวนหลัก ให้ระบบอ่านทวน และขอให้พูดซ้ำเมื่อความมั่นใจต่ำ - ปัญหา: AI ฟังภาษาไทยปนอังกฤษผิดบ่อย
สาเหตุ: code switching ทำให้ทั้ง speech-to-text และการตีความหลังจากนั้นคลาดเคลื่อน
วิธีแก้: เพิ่มคำสำคัญตามสถานะการสนทนา ทำ normalization และทดสอบจากรูปแบบภาษาที่ลูกค้าใช้จริง - ปัญหา: เสียง AI อ่านชื่อแบรนด์ อีเมล หรือราคาแปลก
สาเหตุ: ส่งผลลัพธ์จาก LLM เข้า TTS โดยตรง
วิธีแก้: สร้างพจนานุกรมการออกเสียง ตัด markdown และกำหนดรูปแบบการอ่านข้อมูลสำคัญก่อนส่งไป TTS - ปัญหา: AI พูดแทรกหรือไม่ยอมหยุดเมื่อปลายสายตอบ
สาเหตุ: ตั้งค่า turn detection และ barge-in ไม่เหมาะกับรูปแบบการพูดจริง
วิธีแก้: ทดสอบกับการเว้นวรรค การลังเล และการพูดแทรกหลายแบบ พร้อมลดความยาวประโยคของ AI
Step 9: ต่อยอด Voice AI จากการรับสายสู่ระบบงานที่วัดผลได้
- เชื่อมกับ CRM: ให้ AI ดึงชื่อ ประวัติการติดต่อ และสถานะลูกค้าก่อนเริ่มสนทนา พร้อมบันทึกผลลัพธ์กลับเป็นฟิลด์ที่ตรวจแล้ว
- ทำแดชบอร์ดข้อผิดพลาด: แยกสาเหตุเป็นฟังผิด เก็บฟิลด์ไม่ครบ ตอบช้า ออกเสียงผิด และโอนสาย เพื่อเห็นจุดที่ต้องแก้ก่อน
- สร้างคลังเสียงทดสอบของธุรกิจ: เก็บตัวอย่างสำเนียง คำถามจริง ชื่อสินค้า และกรณีที่เคยพัง แล้วใช้เป็นชุดทดสอบทุกครั้งก่อนอัปเดต flow
Step 10: สรุป Checklist ทั้งหมดก่อนเปิดใช้ Voice AI Agent
- ☐ กำหนด use case ที่แคบ ชัด และวัดผลได้
- ☐ วาด flow ตั้งแต่รับเสียง ถอดเสียง ตัดสินใจ เรียกข้อมูล และตอบกลับ
- ☐ ตั้งเป้า time to first audio และวัด latency แยกทุกชั้น
- ☐ แยกงานสนทนาทั่วไปออกจากงานที่ต้องเรียกข้อมูลหรือทำธุรกรรม
- ☐ เตรียม keyword boosting สำหรับแบรนด์ สาขา สินค้า และชื่อเฉพาะตามสถานะของสาย
- ☐ ทำ normalization สำหรับข้อความจาก speech-to-text ก่อนเข้า LLM
- ☐ ออกแบบข้อมูลเป็น typed fields พร้อมกติกาตรวจสอบ
- ☐ ให้ AI ยืนยันเบอร์โทร วันเวลา ที่อยู่ และข้อมูลที่ผิดพลาดไม่ได้
- ☐ ทดสอบรายฟิลด์ก่อนทดสอบการสนทนาทั้งสาย
- ☐ ทำ normalization สำหรับข้อความก่อนเข้า TTS
- ☐ สร้างพจนานุกรมการออกเสียงชื่อบริษัท แบรนด์ บุคคล และคำย่อ
- ☐ ทดสอบการพูดแทรก การหยุดพูด และกรณีที่ปลายสายลังเล
- ☐ กำหนดเงื่อนไขส่งต่อเจ้าหน้าที่เมื่อ AI ไม่มั่นใจ
บทเรียนสำคัญจาก 5 Voice AI Agent failure modes คือ ความสำเร็จไม่ได้มาจากการเขียน prompt ที่ยาวขึ้น แต่มาจากการออกแบบระบบให้รู้ว่าอะไรต้องเร็ว อะไรต้องตรวจ และอะไรต้องยอมรับว่า AI ไม่ควรเดา เมื่อเราคุมโครงสร้างข้อมูล จังหวะการสนทนา และคุณภาพเสียงได้ Voice AI ก็จะกลายเป็นเครื่องมือช่วยงานหน้าบ้านที่ธุรกิจไทยนำไปใช้ได้จริง
แหล่งที่มา: 5 Voice Agent Failure Modes You'll Hit in Week One — Venky B, Plivo · บทความต้นทาง