เรียบเรียงจากการบรรยาย The Prime Intellect Stack บนช่อง AI Engineer และบทความ VideoToBlog วันที่ 13 กรกฎาคม 2026 วันที่นี้เป็นวันที่แสดงในบทความต้นทาง ไม่ใช่วันจัดงานหรืออัปโหลดคลิปที่ตรวจยืนยันแล้ว รายละเอียดผลิตภัณฑ์ บริการ hosted training และแผนพัฒนาเป็นสิ่งที่ต้นทางกล่าวในเวลานั้น ไม่ใช่คำยืนยันสิทธิ์ใช้งานปัจจุบันหรือต้นทุนที่ประหยัดได้กับทุกองค์กร ตัวอย่างธุรกิจไทยเป็นข้อเสนอประยุกต์ของบทความ · วิดีโอต้นทาง · สถาปัตยกรรม verifiers v1 จาก Prime Intellect · โครงการ Prime RL ต้นทาง ·
AI กำลังเดินมาถึงจุดที่คำถามไม่ใช่แค่ว่า “จะใช้ model ตัวไหนดี” แต่คือ “จะทำให้ model เก่งขึ้นกับงานของเราเองได้อย่างไร” คลิป The Prime Intellect Stack จากช่อง AI Engineer พูดถึงเรื่องนี้แบบตรงแกนมาก โดยเฉพาะโลกของ post-training, evals, RL และเครื่องมือ open source ที่ช่วยให้บริษัทไม่ต้องพึ่ง model สำเร็จรูปเพียงอย่างเดียว
สิ่งที่น่าสนใจคือแก่นของคลิปไม่ได้อยู่ที่ความลึกทางเทคนิคอย่างเดียว แต่อยู่ที่แนวคิดเชิงระบบว่า ถ้าองค์กรอยากมี AI ที่เก่งขึ้นจากงานจริงของตัวเอง ต้องมีชิ้นส่วนอะไรบ้าง ตั้งแต่ environment, reward, evaluation ไปจนถึง training infrastructure และ hosted platform สำหรับรันงานระดับ production
สำหรับเจ้าของธุรกิจและคนทำงาน ประเด็นสำคัญไม่ใช่ว่าเราจะไปเขียน RL framework เองหรือไม่ แต่คือการมองให้ออกว่าอนาคตของการใช้ AI ในองค์กรจะไม่ได้จบที่ prompt ดีขึ้นเท่านั้น มันจะค่อยๆ ขยับไปสู่การเก็บสัญญาณจากงานจริง แล้วหมุนกลับมาอัปเกรด model ของเราเอง
สารบัญ
- Step 1: เริ่มจากเข้าใจว่า post-training ไม่ใช่เรื่องของแล็บอย่างเดียว
- Step 2: มอง environment ให้เป็นภาษากลางของการพัฒนา AI
- Step 3: แยก environment ออกเป็น task, harness และ runtime
- Step 4: สร้าง evals ก่อนคิดเรื่องฝึก model เพิ่ม
- Step 5: ออกแบบ reward ให้ตอบโจทย์ธุรกิจ ไม่ใช่ตอบโจทย์ความสวยงาม
- Step 6: รองรับโลกจริงด้วย tools, user simulators และ MCP
- Step 7: ทำให้ harness เดิมใช้กับ training ได้ด้วย interception server
- Step 8: แก้ปัญหา tokenization และ trace ให้รอดก่อน scale
- Step 9: เข้าใจว่าทำไม asynchronous RL ถึงสำคัญกับงานจริง
- Step 10: มอง algorithm เป็นชุดประกอบที่สลับได้
- Step 11: เมื่อถึงเวลาขยาย ให้มี platform ที่ไม่บังคับให้ทีมคิดเรื่อง GPU ตลอดเวลา
- Step 12: แปลทั้งหมดนี้ให้เป็นแผนสำหรับธุรกิจไทย
- Actionable Insights
- Troubleshooting
- การต่อยอด
- สรุป Checklist ทั้งหมด
Step 1: เริ่มจากเข้าใจว่า post-training ไม่ใช่เรื่องของแล็บอย่างเดียว
Prime Intellect วางภาพใหญ่ชัดมากว่า post-training คือการเอา model พื้นฐานที่เก่งอยู่แล้ว มาปรับให้เหมาะกับงานเฉพาะขององค์กร ไม่ว่าจะเป็น workflow ภายใน งาน coding งาน support งานค้นเอกสาร หรือ agent ที่ต้องโต้ตอบหลายรอบ
มุมนี้สำคัญกับธุรกิจไทยมาก เพราะหลายทีมยังคิดว่า AI มีแค่ 2 ทางเลือก คือใช้ model ผ่าน API หรือไม่ก็สร้าง model เองตั้งแต่ศูนย์ ซึ่งจริงๆ มีทางกลางที่ใช้งานได้จริงกว่ามาก นั่นคือเลือก open model หรือบริการที่รองรับการปรับแต่ง โดยตรวจใบอนุญาตและสิทธิ์ใช้ข้อมูลก่อน แล้วจึงปรับหลังการฝึกให้เข้ากับงานที่เจอบ่อยในองค์กร ไม่ใช่ทุก model หรือ API จะให้ปรับน้ำหนักได้
ข้อดีของแนวคิดนี้คือเราไม่ต้องแข่งสร้าง foundation model กับใคร แต่ไปชนะในสนามที่สำคัญกว่า คือทำให้ AI เข้าใจงานของเราได้ดีกว่าคนอื่น
ตัวอย่างเช่น
- บริษัทซอฟต์แวร์อาจอยากให้ agent แก้ bug ตาม style codebase ของตัวเอง
- ทีมกฎหมายอาจอยากให้ model ตอบโดยอ้างอิงเอกสารภายในแบบสั้น ชัด และปลอดภัย
- ทีมขายอาจอยากให้ AI สรุป lead และร่างข้อความติดตามแบบเข้ากับสินค้าของบริษัท
ทั้งหมดนี้ไม่ใช่โจทย์ “AI ทั่วไป” แต่เป็นโจทย์ “AI สำหรับงานจริง” ซึ่งเป็นพื้นที่ที่ post-training มีความหมายมาก
Step 2: มอง environment ให้เป็นภาษากลางของการพัฒนา AI
หนึ่งใน insight ที่ดีที่สุดของคลิปคือ environment คือภาษาที่ใช้บอกว่าเราอยากให้ model ทำอะไร ไม่ได้เป็นของ RL อย่างเดียว แต่เป็นแกนกลางของทั้ง evaluation, SFT, distillation และ reinforcement learning
ถ้าแปลเป็นภาษาธุรกิจ environment ก็คือฉากจำลองงานจริงของเรา ประกอบด้วยข้อมูล สถานการณ์ วิธีที่ AI โต้ตอบกับระบบ และเกณฑ์ว่าสิ่งที่ถือว่าดีคืออะไร
จุดนี้ทำให้เห็นชัดว่า ก่อนจะคิดเรื่องเทรน model เพิ่ม เราควรถามก่อนว่า “เราวัดงานนี้เป็นหรือยัง” เพราะถ้ายังวัดไม่ได้ ก็ยังฝึกไม่ได้ และถึงฝึกก็ไม่รู้ว่าดีขึ้นจริงหรือไม่
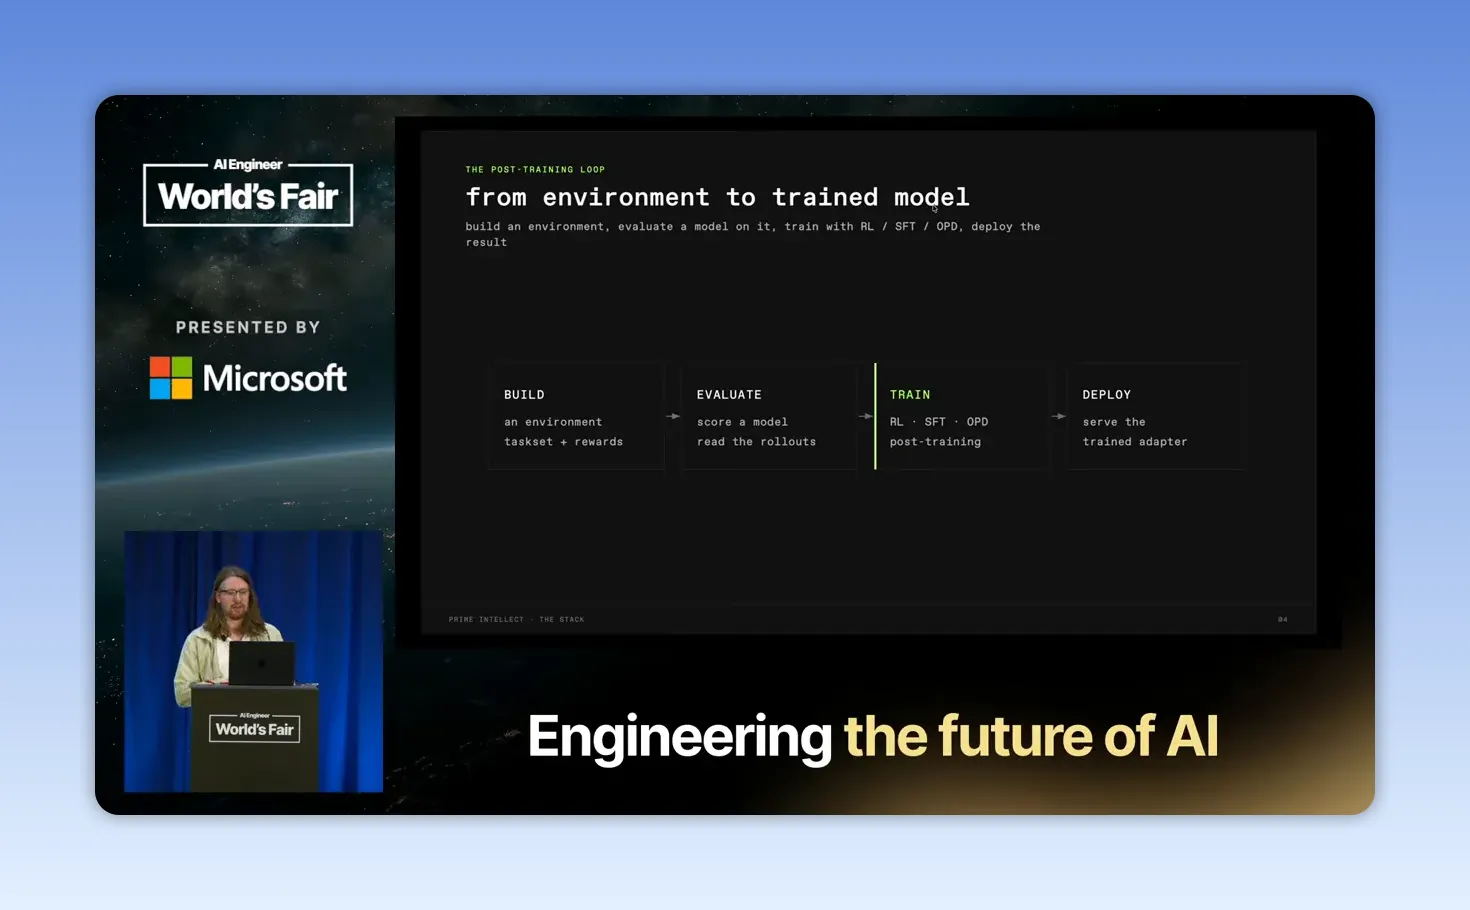
นี่คือเหตุผลที่ทีมในคลิปย้ำว่า evals คือประตูสู่ post-training ต่อให้วันนี้เรายังใช้ GPT หรือ Claude ผ่าน API อยู่ การมี evaluation ที่ดีอยู่แล้วก็ยังคุ้ม เพราะช่วยให้เรา
- เทียบ model หลายตัวได้
- ตัดสินใจระหว่างคุณภาพกับต้นทุนได้
- รู้ว่าปัญหาอยู่ที่ prompt, harness หรือ model
- เตรียมพร้อมสำหรับการ fine-tune ในอนาคต
สำหรับธุรกิจไทย นี่แปลว่าแทนที่จะเริ่มจาก “อยากเทรน AI” ควรเริ่มจาก “ออกแบบข้อสอบของงานเรา” ก่อนเสมอ
Step 3: แยก environment ออกเป็น task, harness และ runtime
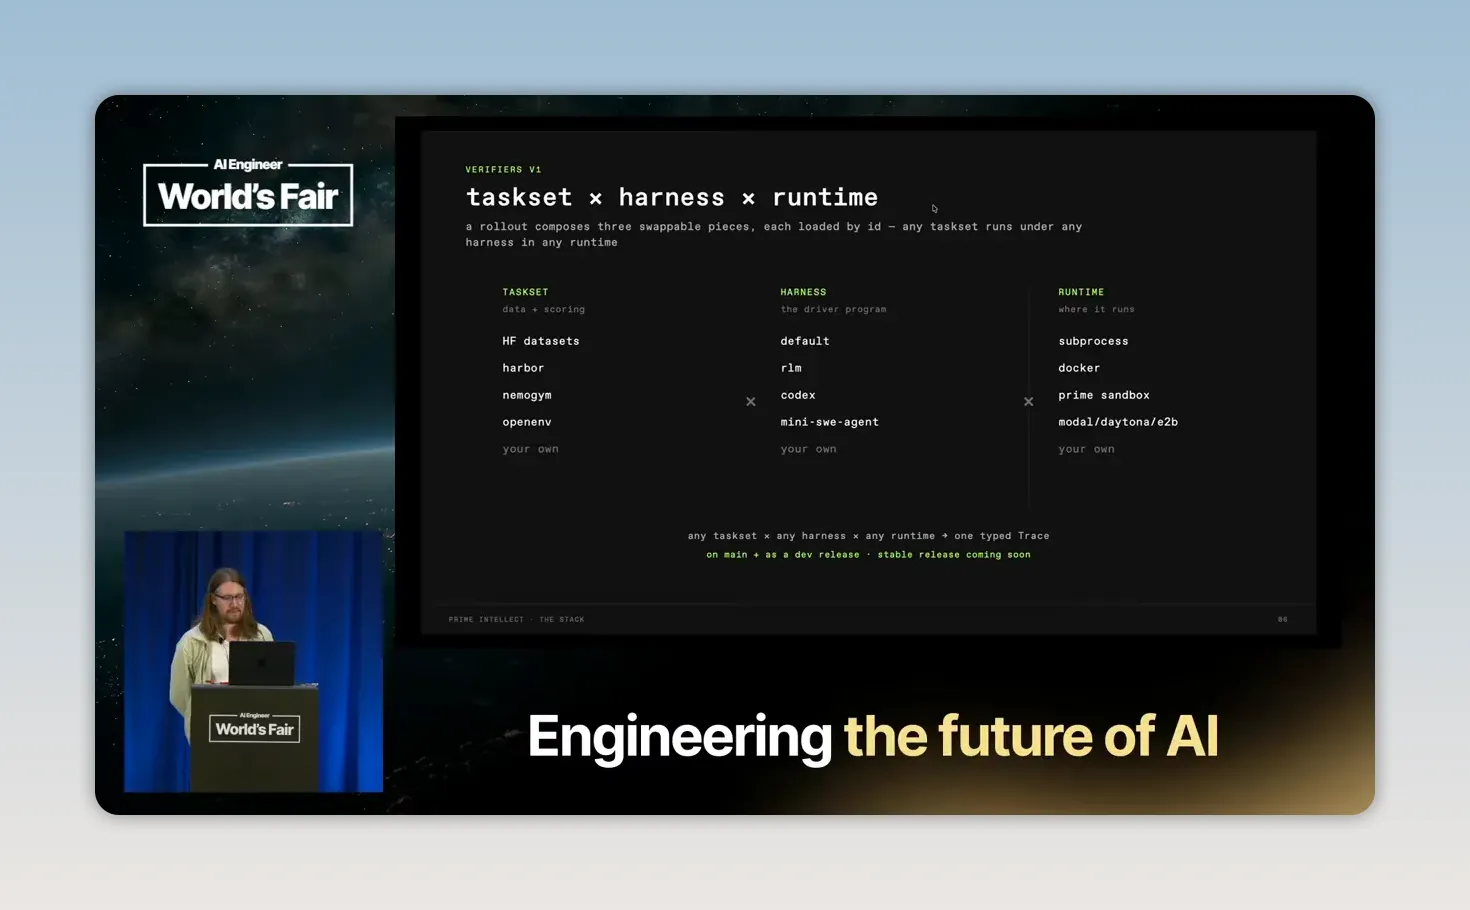
Prime Intellect รีแฟกเตอร์แนวคิด environment ใหม่ โดยแยกเป็น 3 ส่วนหลัก คือ task set, harness และ runtime
การแยกแบบนี้ฟังดูเทคนิค แต่จริงๆ มีประโยชน์กับการออกแบบระบบในองค์กรอย่างมาก
- Task set คือข้อมูลและกติกาของงาน เช่น โจทย์ลูกค้า เอกสาร คำถาม benchmark หรือ ticket ที่ต้องแก้
- Harness คือวิธีที่ agent ทำงาน เช่น ใช้ system prompt อะไร ใช้เครื่องมืออะไร โต้ตอบกี่รอบ
- Runtime คือที่ที่งานนั้นรัน เช่น local, Docker, sandbox หรือ cloud
มุมมองนี้ดีมากเพราะช่วยให้เราไม่เอาทุกอย่างไปกองรวมกัน หากทีมหนึ่งกำลังทดสอบ AI อ่านเอกสารภายใน เราอาจใช้ task set เดิม แต่ลองเปลี่ยน harness หลายแบบ เช่น แบบเรียก search tool, แบบใช้ CLI หรือแบบใช้ prompt ง่ายๆ เพื่อดูว่าอะไรเวิร์กกว่า
นี่เป็นจุดที่หลายองค์กรพลาด เพราะเวลาผลลัพธ์ไม่ดี มักสรุปเร็วว่า model ไม่เก่งพอ ทั้งที่ปัญหาอาจอยู่ที่วิธีห่อ model เข้า workflow มากกว่า
ในโลกธุรกิจ การคิดแบบ modular แบบนี้ช่วยให้ทีมทดลองเร็วขึ้น และไม่ล็อกตัวเองกับเครื่องมือเดียว
Step 4: สร้าง evals ก่อนคิดเรื่องฝึก model เพิ่ม
อีกจุดที่คลิปพูดได้ตรงมากคือ หลายคนกลัว post-training เพราะคิดว่าต้องรื้อของเดิมทั้งหมด แต่ความจริงไม่จำเป็น ระบบที่ดีมักใช้ทั้ง frontier model และ model ที่ปรับแต่งเองร่วมกัน
ตรงนี้เราเห็นด้วยมาก และอยากเสริมว่าองค์กรไม่ควรมองเรื่องนี้แบบสุดโต่ง ไม่ใช่ว่าใช้ API แล้วแปลว่าไม่ต้องมี training strategy และไม่ใช่ว่าอยากประหยัดเลยต้องเทรนเองทุกอย่าง
วิธีคิดที่ดีกว่าคือ
- งานไหนสำคัญแต่เกิดไม่บ่อย ใช้ model เก่งผ่าน API ก็ได้
- งานไหนเกิดซ้ำ ปริมาณสูง มี pattern ชัด ควรเริ่มออกแบบ evals และคิดเรื่อง post-training
- งานไหนต้องใช้ข้อมูลภายในสูง และต้องการควบคุมการ deploy มาก ควรให้ความสำคัญกับ open stack มากขึ้น
ตัวอย่างในธุรกิจไทย เช่น call center, ticket support, back office, ตรวจเอกสาร, code review ภายใน สิ่งเหล่านี้มักมีข้อมูลซ้ำและมีนิยามของคำว่า “ดี” พอสมควร จึงเหมาะกับการเริ่มทำ eval อย่างจริงจัง
Step 5: ออกแบบ reward ให้ตอบโจทย์ธุรกิจ ไม่ใช่ตอบโจทย์ความสวยงาม
ช่วงที่พูดถึง rewards และ metrics เป็นอีกส่วนที่มีคุณค่ามาก เพราะสะท้อนปัญหาจริงของการใช้งาน AI ในองค์กร นั่นคือ model มักจะคิดยาว ตอบยาว ใช้ token เยอะ และไม่แปลว่าดีขึ้นเสมอไป
Prime Intellect จึงให้ความสำคัญกับ group rewards หรือการให้คะแนนแบบดูหลาย rollout พร้อมกัน เช่น ให้โบนัสกับคำตอบที่ถูกและสั้นกว่า
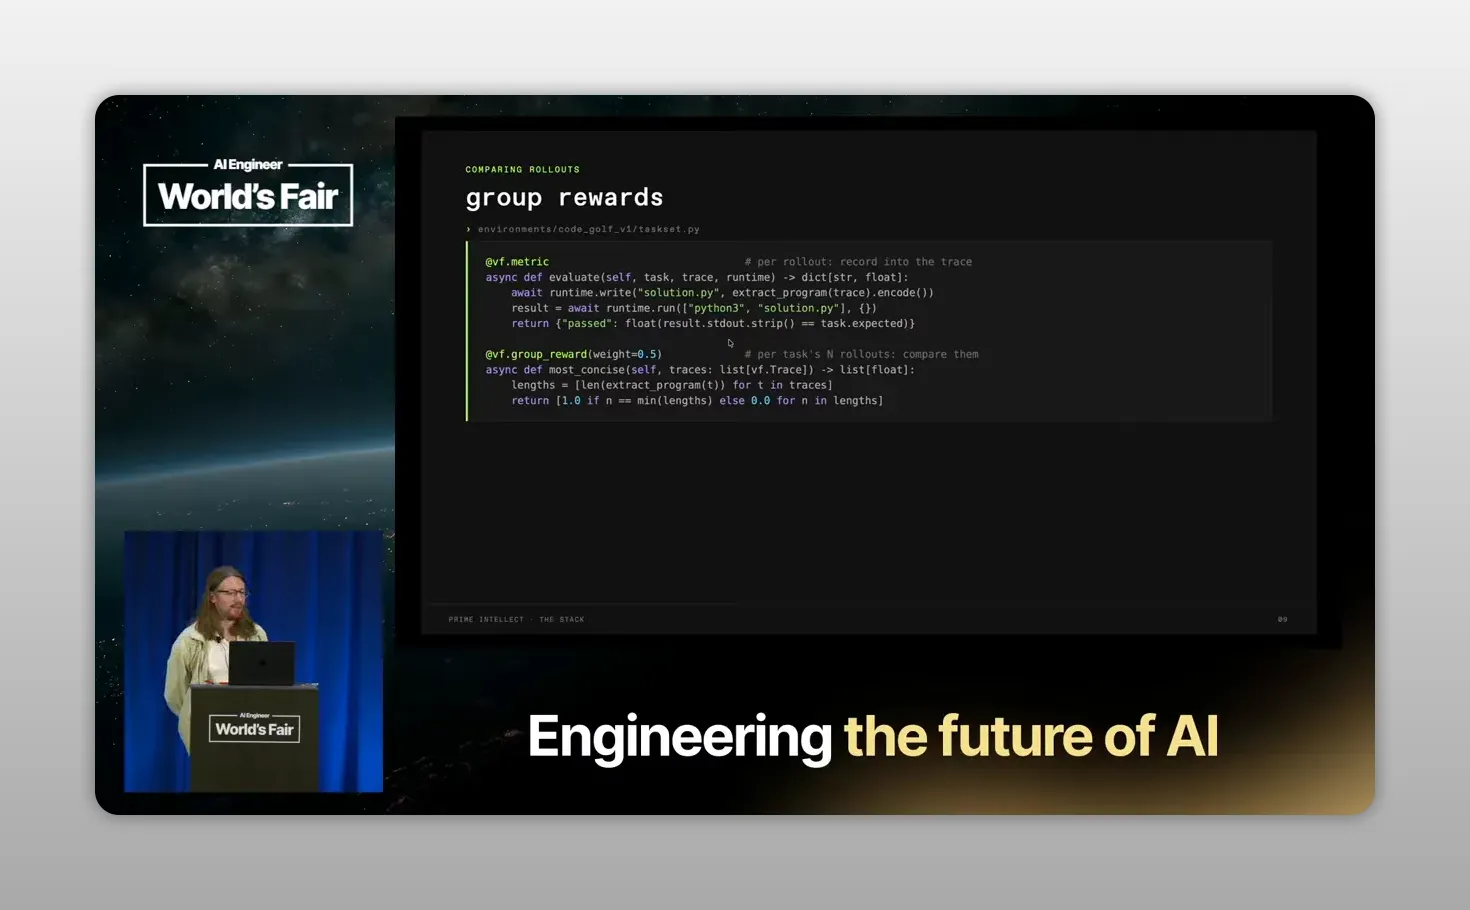
นี่เป็นแนวคิดที่ธุรกิจเอาไปใช้ต่อได้ทันที แม้ยังไม่ทำ RL เต็มรูปแบบ เพราะมันสอนเราว่า quality ไม่ได้มีมิติเดียว งานจริงมักต้องบาลานซ์หลายอย่างพร้อมกัน เช่น
- ถูกต้อง
- สั้นพอ
- ปลอดภัย
- ใช้เครื่องมือถูกจุด
- ต้นทุนต่อคำตอบไม่สูงเกินไป
หลายทีมโฟกัสแต่ความฉลาดของคำตอบ แต่ลืมเรื่องความกระชับและต้นทุน ซึ่งใน production นี่เป็นเรื่องใหญ่มาก โดยเฉพาะเมื่อ AI ต้องรันหลักหมื่นหรือหลักแสนครั้งต่อเดือน
ถ้ามองแบบเจ้าของธุรกิจ reward design ก็คือการแปลง KPI ของงานให้เป็นคะแนนที่ระบบเข้าใจได้ ยิ่งแปลงได้ดี โอกาสที่ model จะพัฒนาไปในทิศทางที่ต้องการก็ยิ่งมาก
Step 6: รองรับโลกจริงด้วย tools, user simulators และ MCP
คลิปชี้ชัดว่า use case ของ agent ซับซ้อนขึ้นมากแล้ว AI ไม่ได้แค่ตอบคำถาม แต่ต้องใช้ tools และโต้ตอบหลายรอบกับคนหรือระบบอื่น
Prime Intellect เลยทำให้ tools และ user simulators เป็นส่วนประกอบระดับ first class ของ environment โดยเฉพาะการจำลอง user ผ่าน MCP server เพื่อทดสอบสถานการณ์ที่ AI ต้องคุยกับผู้ใช้หลายรอบ
มุมนี้มีผลกับธุรกิจมาก เพราะสินค้าหลายอย่างไม่ได้ล้มเหลวเพราะ model ไม่เก่ง แต่ล้มเหลวเพราะทดสอบกับโจทย์ที่ง่ายเกินไป
ถ้าระบบของเราต้องรับ requirement จากลูกค้า ถามกลับ ขอข้อมูลเพิ่ม หรือใช้เครื่องมือไปดึงข้อมูลจากระบบภายใน การประเมินแบบ one-shot จะหลอกเราได้ง่ายมาก
สำหรับองค์กรไทยที่กำลังทำ AI assistant ภายใน นี่เป็นคำเตือนสำคัญว่าเราควรจำลองงานจริงให้ใกล้ของจริงที่สุด โดยเฉพาะงานที่มีหลาย turn และมี dependency กับหลายระบบ
Step 7: ทำให้ harness เดิมใช้กับ training ได้ด้วย interception server
อีกแนวคิดที่เฉียบมากคือ interception server pattern แทนที่จะบังคับให้ทีมต้องเขียน harness ใหม่สำหรับ RL ระบบนี้ทำให้ harness คิดว่ากำลังคุยกับ endpoint ปกติ แล้วมีชั้นกลางคอยดัก request ไปจัดการต่อ
ข้อดีคือโค้ดของ agent ไม่ต้องรู้ว่ากำลังอยู่ในโหมด eval, train หรือ deploy
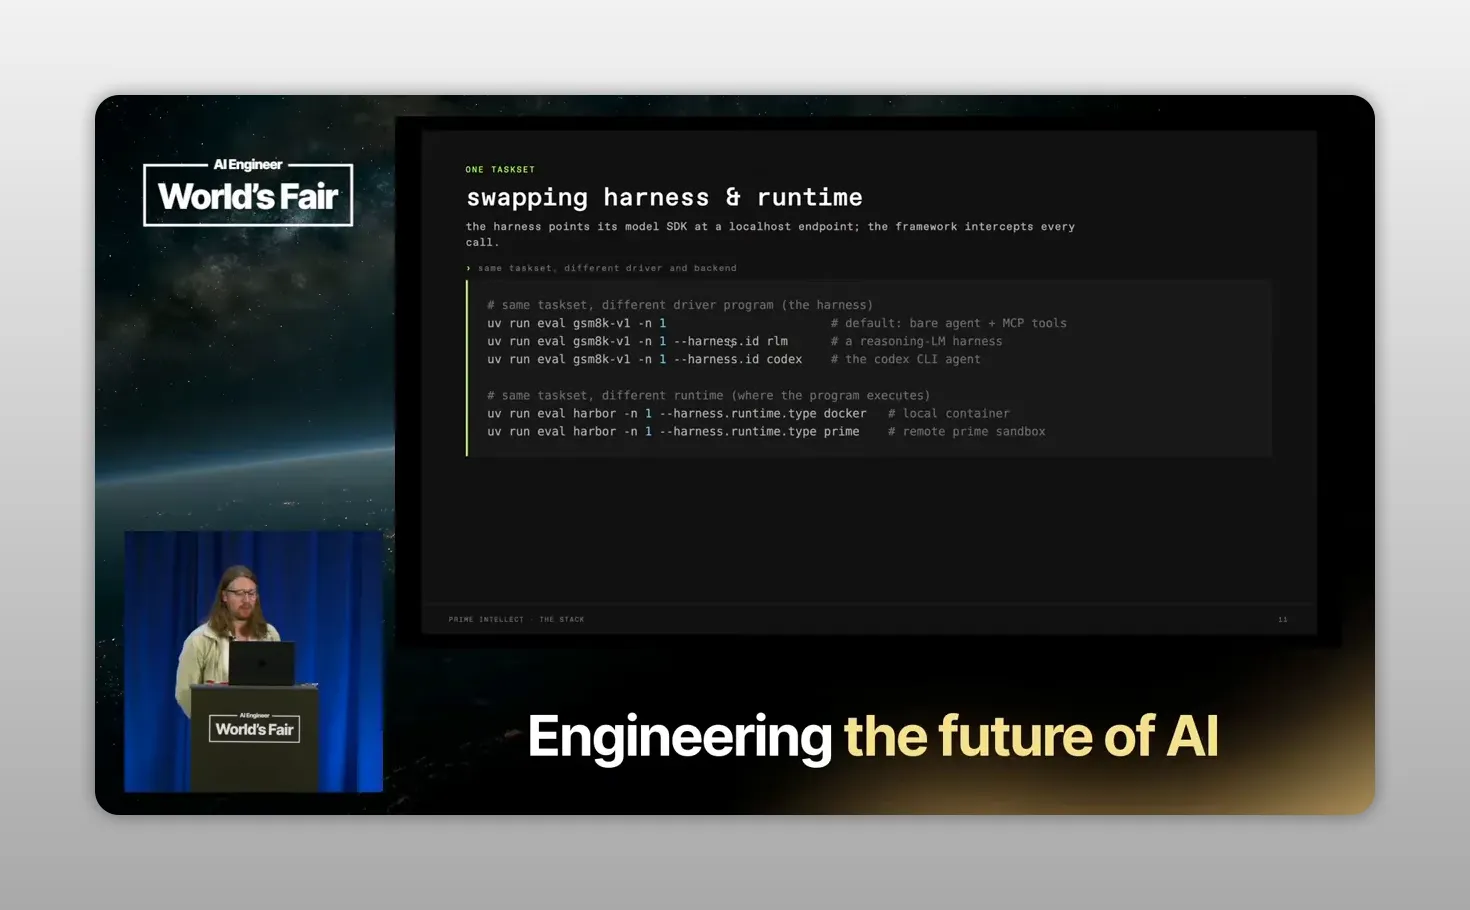
นี่เป็นการออกแบบที่มีนัยสำคัญในเชิงธุรกิจ เพราะลดภาระการแยกระบบทดลองกับระบบใช้งานจริง ถ้า tooling บังคับให้เราเขียนของซ้ำสองชุด ต้นทุนทีมจะพุ่งเร็วมาก และสุดท้ายหลายองค์กรจะเลิกทำกลางทาง
การออกแบบที่โค้ดส่วนเดียวกันวิ่งได้ทั้ง local, sandbox, eval และ training ช่วยให้การทดลองเร็วขึ้น และทำให้เส้นทางจาก prototype ไป production สั้นลง
Step 8: แก้ปัญหา tokenization และ trace ให้รอดก่อน scale
ช่วง trace graph กับ renderers อาจดูเป็นเรื่องลึก แต่จริงๆ สะท้อนบทเรียนสำคัญว่า เมื่อระบบ agent ซับซ้อนขึ้น ปัญหาเล็กอย่าง chat template หรือ token mismatch สามารถทำให้ผล training เพี้ยนได้
Prime Intellect จึงสร้าง trace graph เพื่อเก็บทั้งมุมมองแบบข้อความและ token พร้อมกัน และมี library ชื่อ Renderers เพื่อจัดการ chat templates ให้ควบคุมได้มากขึ้น
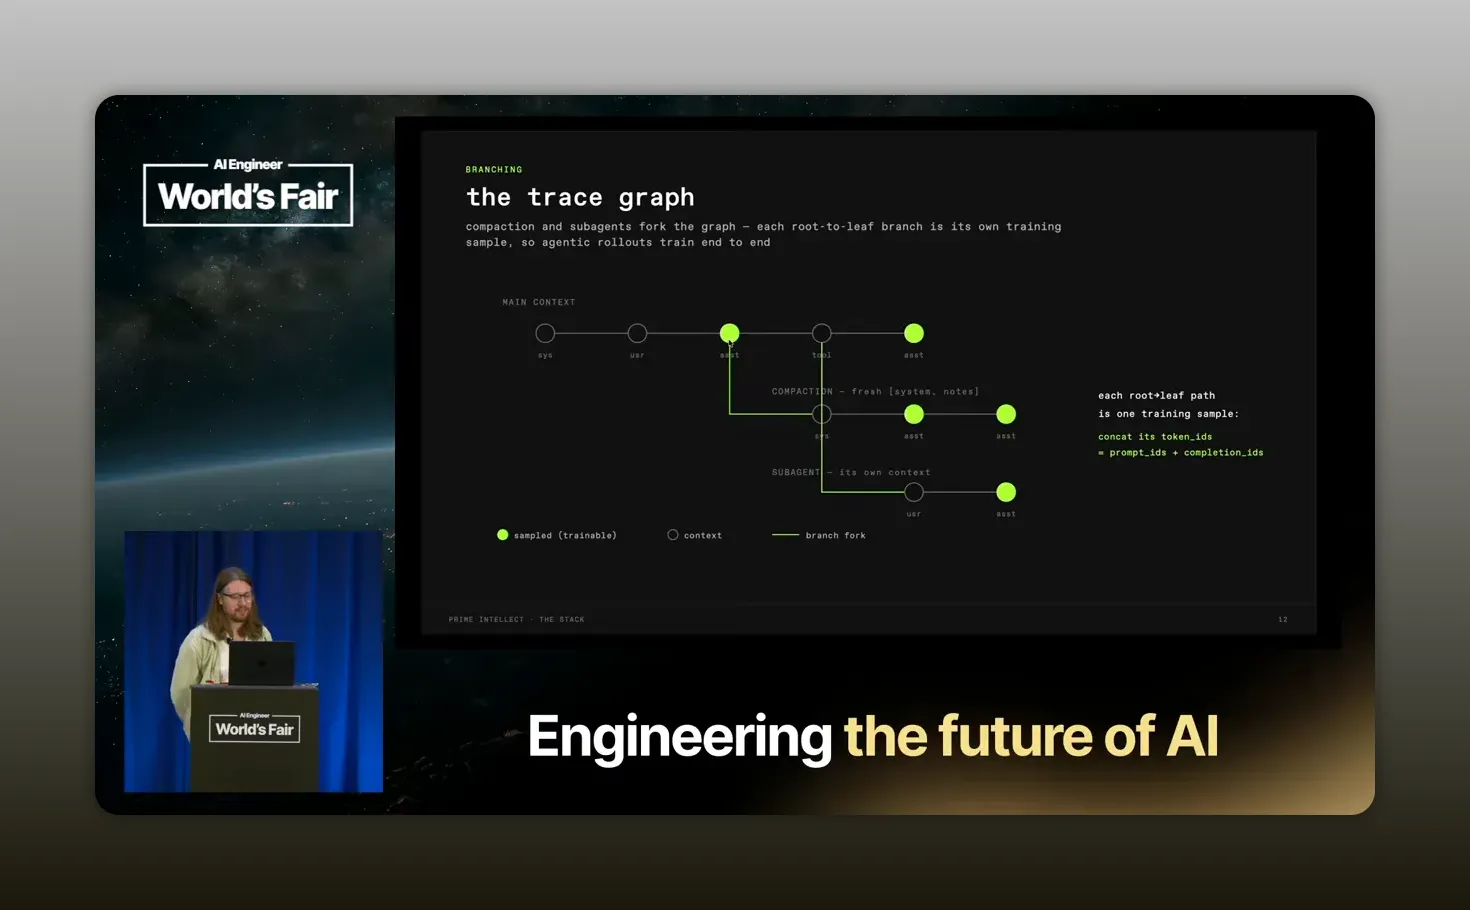
ประเด็นนี้แม้ไม่ใช่เรื่องที่คนทำธุรกิจต้องลงมือเอง แต่ควรรู้ไว้ว่า AI system ระดับ production ไม่ได้มีแค่ model กับ prompt เท่านั้น ยังมีชั้นรายละเอียดที่ถ้าพลาด จะทำให้ต้นทุนการทดลองสูงขึ้นและ debug ยากมาก
ใครที่กำลังเลือก vendor หรือ platform ควรถามให้ชัดว่าเครื่องมือที่ใช้จัดการเรื่อง trace, template, evaluation และ reproducibility ดีแค่ไหน ไม่ใช่ดูแค่ demo ที่ตอบเก่ง
ข้อมูลเสริมเรื่องโมเดลแบบ open และเครื่องมือใน ecosystem สามารถตามต่อได้จาก Hugging Face และแนวทางออกแบบ evals ที่ OpenAI Evals
Step 9: เข้าใจว่าทำไม asynchronous RL ถึงสำคัญกับงานจริง
Prime RL ถูกออกแบบให้เป็น asynchronous RL framework ตั้งแต่ต้น เหตุผลคือ rollout ของ agent ในงานจริงใช้เวลาไม่เท่ากันเลย งานหนึ่งเสร็จใน 30 วินาที อีกงานอาจลากยาวเป็นชั่วโมง
ถ้าระบบบังคับให้ทุกอย่างเดินพร้อมกัน เราจะต้องรอเคสที่ช้าที่สุดตลอด ซึ่งเสียทั้งเวลาและ GPU
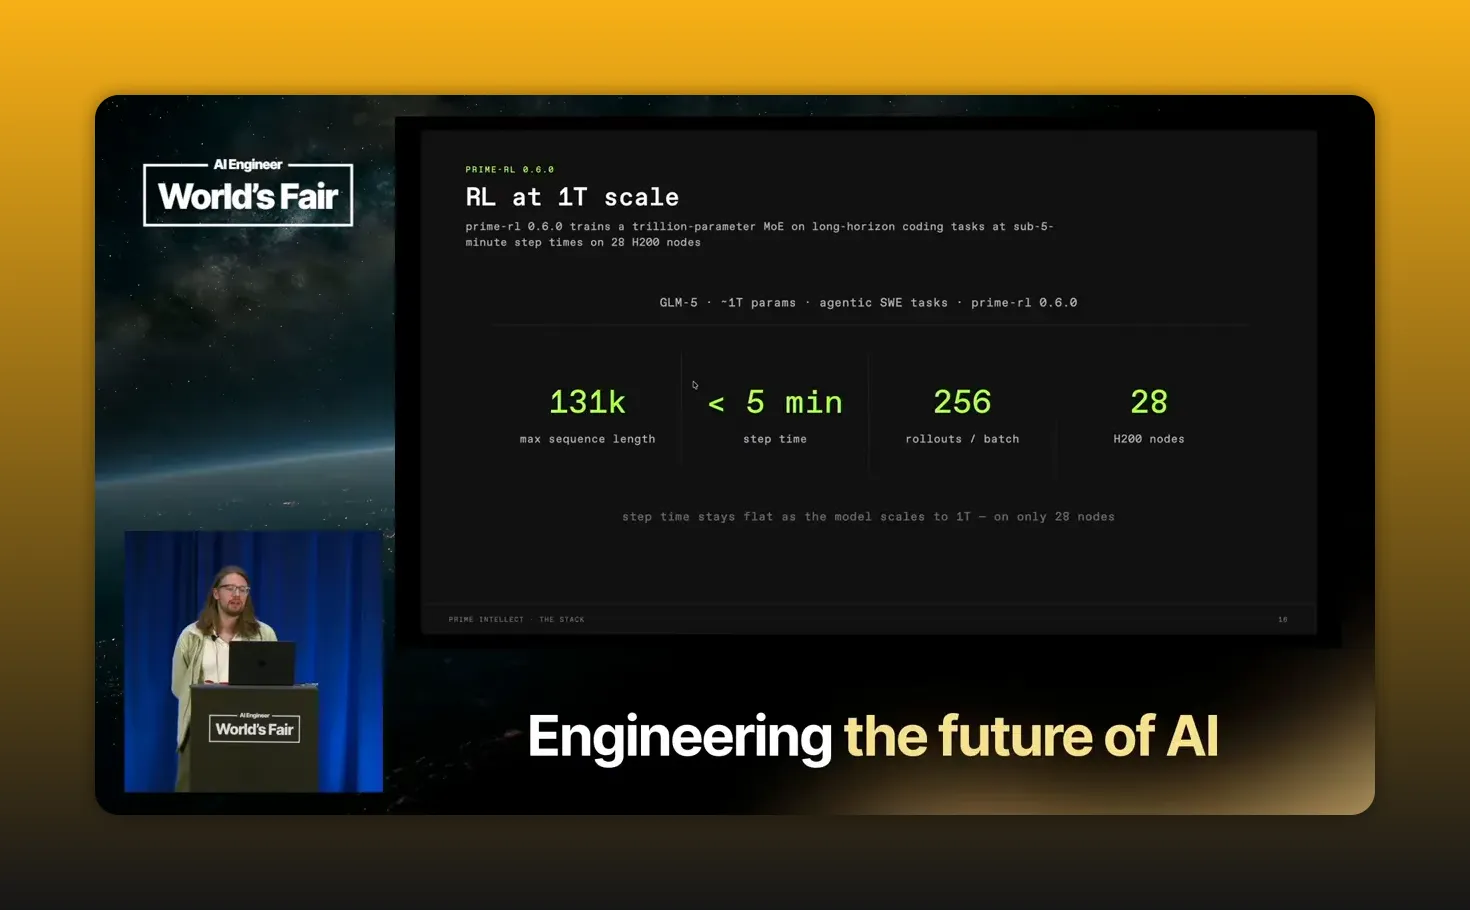
นี่เป็นจุดที่เจ้าของธุรกิจควรฟังให้ดี เพราะมันโยงกับ economics ของ AI โดยตรง คลิปยกตัวอย่างว่าการทำ RL ระดับใหญ่กับ model ขนาด frontier เริ่มเข้าใกล้ความคุ้มค่าสำหรับองค์กรบางประเภทแล้ว แม้ยังแพง แต่ไม่ได้ไกลเกินเอื้อมแบบเมื่อก่อน
มุมมองที่ต้นทางเสนอคือ เมื่อค่าใช้จ่ายด้าน inference ขององค์กรสูงขึ้น อาจมีเหตุผลให้ศึกษาความคุ้มค่าของ post-training โดยต้องรวมค่าข้อมูล การฝึก การประเมิน การดูแล และความเสี่ยงของระบบก่อน โดยเฉพาะถ้า model ที่ปรับเองช่วยลด token ลด latency หรือย้ายบางงานออกจาก model ราคาแพงได้
อย่างไรก็ดี ตรงนี้ต้องพูดให้แฟร์ว่า ไม่ใช่ทุกธุรกิจควรกระโดดไปทำ RL ทันที ถ้ายังไม่มี evals ชัด ยังไม่รู้ว่างานไหนทำเงิน หรือยังไม่มีงานซ้ำมากพอ การเริ่มจาก prompt, routing, retrieval และ workflow design มักคุ้มกว่ามาก
Step 10: มอง algorithm เป็นชุดประกอบที่สลับได้
อีกจุดที่น่าสนใจคือ Prime RL แยก algorithm ออกจาก loss เพื่อให้ปรับวิธีฝึกได้ง่ายขึ้น รองรับทั้ง SFT, on-policy distillation, self-distillation, GRPO และรูปแบบอื่นๆ
แม้ทีมธุรกิจอาจไม่ลงไปแตะ algorithm โดยตรง แต่แนวคิดนี้บอกเราว่าอนาคตของ AI platform จะต้องยืดหยุ่น ไม่ใช่ผูกกับสูตรเดียว
เพราะในโลกจริง งานแต่ละแบบอาจต้องใช้วิธีปรับ model ต่างกัน เช่น
- งานที่มีตัวอย่างดีอยู่แล้ว เหมาะกับ SFT
- งานที่ต้องเทียบหลายคำตอบ อาจได้ประโยชน์จาก reward แบบกลุ่ม
- งานที่มี teacher model เก่งกว่าในบางเรื่อง อาจใช้ distillation ช่วยลดต้นทุน
สิ่งนี้สะท้อนมุมคิดที่ดีมาก คืออย่าถามว่า “algorithm ไหนดีที่สุด” แต่ให้ถามว่า “งานนี้ต้องการสัญญาณแบบไหน”
Step 11: เมื่อถึงเวลาขยาย ให้มี platform ที่ไม่บังคับให้ทีมคิดเรื่อง GPU ตลอดเวลา
ช่วงท้ายคลิปพูดถึง Lab platform และ hosted training ซึ่งเป็นชั้นที่ทำให้ทีมใช้งาน Prime RL ได้แบบ self-serve มากขึ้น ทั้ง multi-tenant LoRa และ full fine-tuning ที่กำลังตามมา
นี่คือคำตอบของปัญหาที่พบบ่อยในองค์กร คือทีมมีไอเดีย มี data และมี use case แต่ไม่มีคนดูแล infrastructure ระดับลึก
แนวทางแบบ hosted ทำให้ทีมสามารถพัฒนา environment บนเครื่องตัวเอง แล้วค่อย push ขึ้น platform เพื่อรันจริงได้ ซึ่งเป็นโมเดลที่มีเหตุผลมากสำหรับองค์กรที่อยากคุมความเร็วในการทดลอง แต่ไม่อยากสร้าง infra team ใหญ่ตั้งแต่วันแรก
มุมที่ควรระวังคือ hosted platform ไม่ได้แทนการคิดเชิงระบบทั้งหมด ถ้า reward ผิด, eval อ่อน, หรือ task set ไม่แทนงานจริง ต่อให้มี platform ดีแค่ไหน ผลลัพธ์ก็ยังหลอกเราได้
Step 12: แปลทั้งหมดนี้ให้เป็นแผนสำหรับธุรกิจไทย
ถ้าสรุปแบบใช้งานได้จริง แนวคิดจาก Prime Intellect บอกเราว่า องค์กรที่อยากใช้ AI ให้ลึกกว่าระดับ chatbot ควรสร้างความสามารถ 4 ชั้นนี้
- รู้ว่างานไหนสำคัญและเกิดซ้ำ
- มี evals วัดคุณภาพงานนั้นได้
- มี environment จำลองการทำงานจริงได้
- ค่อยตัดสินใจว่าจะ optimize ที่ prompt, workflow หรือ model
นี่เป็นเส้นทางที่จับต้องได้กว่าการพูดว่า “เราจะสร้าง AI ของบริษัท” มาก และยังสอดคล้องกับข้อจำกัดจริงของทีมไทยที่มักมีคนไม่มาก งบจำกัด และต้องเห็นผลเร็ว
Actionable Insights
- เริ่มจากทำ evals สำหรับ 1 workflow ที่มีมูลค่าชัดก่อน เช่น support ticket หรือสรุปเอกสาร
- แยกให้ออกว่าปัญหาอยู่ที่ model, prompt หรือ workflow อย่าโทษ model ก่อนเสมอ
- กำหนดคุณภาพหลายมิติพร้อมกัน เช่น ถูกต้อง สั้น ปลอดภัย และต้นทุนต่อคำตอบ
- ถ้างานมีหลายรอบโต้ตอบ ให้จำลอง user และ tool use ตั้งแต่ต้น
- ใช้ API model สำหรับงานยากไม่บ่อย และค่อยพิจารณา post-training กับงานซ้ำปริมาณสูง
Troubleshooting
ปัญหา: AI ตอบเก่งในเดโม แต่พอใช้งานจริงคุณภาพตก
สาเหตุ: ชุดทดสอบไม่สะท้อนงานจริง หรือวัดแค่ one-shot
วิธีแก้: เริ่มจากตัวอย่างที่ได้รับอนุญาตให้ใช้ เช่น 50 ถึง 100 เคสตามข้อเสนอในบทความ โดยคัดข้อมูลอ่อนไหวออกและแยกตามประเภทงาน แล้วทำ eval ที่มีหลายรอบโต้ตอบและมี tool use จำนวนนี้เป็นจุดเริ่มทดลอง ไม่ใช่หลักประกันว่าครอบคลุมงานทั้งหมด
ปัญหา: ค่า AI รายเดือนสูงขึ้นเรื่อยๆ
สาเหตุ: model ตอบยาวเกิน ใช้ model ราคาแพงกับทุกงาน
วิธีแก้: วัด token ต่อคำตอบ เพิ่มเกณฑ์ความกระชับ และแยกงานที่ควร route ไป model ราคาต่างกัน
ปัญหา: Fine-tune แล้วไม่รู้ว่าดีขึ้นจริงหรือไม่
สาเหตุ: ไม่มี baseline และไม่มี eval ชุดเดิมไว้เทียบก่อนหลัง
วิธีแก้: แยกชุด eval สำหรับปรับระบบออกจากชุดทดสอบที่กันไว้และไม่ใช้ฝึก แล้ววัดก่อนและหลังด้วยเกณฑ์เดิม ระวังข้อมูลรั่วและการปรับระบบจนจำชุดทดสอบ
ปัญหา: ทีมสับสนว่าควรเริ่มที่ SFT หรือ RL
สาเหตุ: ยังไม่ได้แยกชนิดของสัญญาณที่มีอยู่
วิธีแก้: ถ้ามีตัวอย่างคำตอบดีชัดเจน เริ่ม SFT ก่อน ถ้ามีเกณฑ์ตัดสินคุณภาพหลายมิติและต้องลองหลาย rollout ค่อยขยับไป RL
การต่อยอด
- สร้าง internal benchmark ของบริษัทเอง และอัปเดตทุกเดือนจากเคสจริง
- ทำ model routing layer ที่เลือกทั้ง API model และ model ที่ปรับเองตามต้นทุนและคุณภาพ
- เริ่มเก็บ feedback จากผู้ใช้ปลายทางแบบมีโครงสร้าง เพื่อแปลงกลับเป็น reward หรือ eval ในรอบถัดไป
สรุป Checklist ทั้งหมด
- ☑ เลือก workflow ที่มีผลต่อธุรกิจและเกิดซ้ำ
- ☑ เก็บตัวอย่างงานจริงเป็น task set
- ☑ นิยามว่า output ที่ดีคืออะไรในหลายมิติ
- ☑ สร้าง evals ก่อนทำ post-training
- ☑ แยก task, harness และ runtime ออกจากกัน
- ☑ ทดสอบทั้ง prompt, tools และ workflow ก่อนสรุปว่า model ไม่ดี
- ☑ วัดต้นทุน token และความกระชับของคำตอบ
- ☑ จำลอง multi-turn interaction ถ้างานจริงมีผู้ใช้ใน loop
- ☑ วางแผนว่าจุดไหนควรใช้ API model และจุดไหนควรฝึกเพิ่ม
- ☑ คิดเรื่อง platform และ infra หลังจากรู้ชัดแล้วว่างานไหนคุ้มจะ scale
สรุปแล้ว Prime Intellect Stack ไม่ได้สำคัญเพราะเป็นอีกชุดเครื่องมือสำหรับนักวิจัยเท่านั้น แต่สำคัญเพราะมันสะท้อนทิศทางใหม่ของการใช้ AI ในองค์กร นั่นคือจากการ “เรียกใช้ model” ไปสู่การ “สร้างระบบที่ทำให้ model ดีขึ้นจากงานจริงของเรา”
สำหรับคนทำธุรกิจไทย บทเรียนที่คมที่สุดอาจไม่ใช่เรื่อง RL หรือ tokenization แต่คือการยอมรับว่าแต้มต่อในระยะยาวจะไม่ได้อยู่ที่ว่าใครเข้าถึง AI ได้ก่อน แต่อยู่ที่ว่าใครสร้าง flywheel ของการวัดผล ปรับปรุง และเรียนรู้จากงานจริงได้ก่อนต่างหาก