วันที่บทความต้นทางใน VTB: 16 กันยายน 2026 (2026-09-16) · วันที่อัปโหลดวิดีโอยังไม่ได้รับการยืนยัน
ตัวเลขความเร็ว จำนวนเอกสาร และผลด้านต้นทุนเป็นสิ่งที่ Legora และ turbopuffer รายงานในวิดีโอต้นทาง ไม่ใช่ benchmark ที่ทดสอบซ้ำกับทุกระบบ แนวทางสำหรับธุรกิจไทยเป็นข้อเสนอประยุกต์ของบทความเดิม ไม่ใช่คำแนะนำทางกฎหมาย
AI ที่ตอบคำถามจากเอกสารได้ ไม่ได้ชนะกันที่ model เพียงอย่างเดียว จุดตัดสินจริงคือ AI “ค้นเจอข้อมูลที่ถูกต้อง” ได้เร็ว ปลอดภัย และอยู่ในขอบเขตสิทธิ์ที่กำหนดหรือไม่ หากค้นเอกสารผิดฉบับ หรือดึงข้อตกลงของลูกค้ารายหนึ่งไปปนกับอีกราย AI ที่เก่งแค่ไหนก็สร้างความเสี่ยงให้ธุรกิจได้ทันที
ประเด็นนี้ชัดมากในคลิปจากช่อง AI Engineer ที่ Jacob Lauritzen จาก Legora และ Simon Eskildsen จาก turbopuffer เล่าการเชื่อม AI เข้ากับเอกสารกฎหมายจำนวนมหาศาล ตั้งแต่ปัญหา search ช้าจาก 100 มิลลิวินาทีไปถึง 20 วินาที ไปจนถึงการออกแบบข้อมูลให้แยกตามลูกค้า โปรเจกต์ และข้อกำหนดด้านความปลอดภัย
แม้กรณีศึกษาจะอยู่ในโลกกฎหมาย แต่บทเรียนใช้ได้ตรงกับธุรกิจไทยที่ต้องการทำ AI Knowledge Base, AI ช่วยค้นสัญญา, ผู้ช่วยตอบนโยบาย HR, ระบบตอบข้อมูลสินค้า หรือระบบสรุปเอกสารลูกค้า เพราะโจทย์หลักเหมือนกัน คือทำอย่างไรให้ AI เข้าถึง “ข้อมูลที่ควรเข้าถึง” โดยไม่แบกต้นทุนและความซับซ้อนเกินจำเป็น
สารบัญ
- Step 1: เริ่มจากแยกโจทย์การค้นหา ก่อนเลือก AI หรือ platform
- Step 2: จัดข้อมูลตามหน่วยงานจริง ไม่ใช่ตามความสะดวกของระบบ
- Step 3: ระวังข้อมูลเก่าไปแย่งทรัพยากรจากงานสำคัญ
- Step 4: แยกข้อมูลตามโปรเจกต์และลูกค้า เพื่อให้เร็วขึ้นและควบคุมได้
- Step 5: ทำให้ความปลอดภัยเป็นส่วนหนึ่งของโครงสร้างข้อมูล
- Step 6: ยอมให้ข้อมูลบางส่วนช้าลง เพื่อแลกกับต้นทุนที่สมเหตุผล
- Step 7: ใช้ทั้ง semantic search และ keyword search เพื่อให้ AI หาเจอจริง
- Step 8: เปลี่ยนบทเรียนเป็น Actionable Insights สำหรับธุรกิจไทย
- Step 9: Troubleshooting ปัญหาที่มักเกิดเมื่อทำ AI ค้นเอกสาร
- Step 10: ต่อยอดจาก AI ค้นเอกสารสู่ workflow ที่มีมูลค่าสูงกว่า
- Step 11: สรุป Checklist ทั้งหมดก่อนเชื่อม AI กับเอกสารองค์กร
Step 1: เริ่มจากแยกโจทย์การค้นหา ก่อนเลือก AI หรือ platform
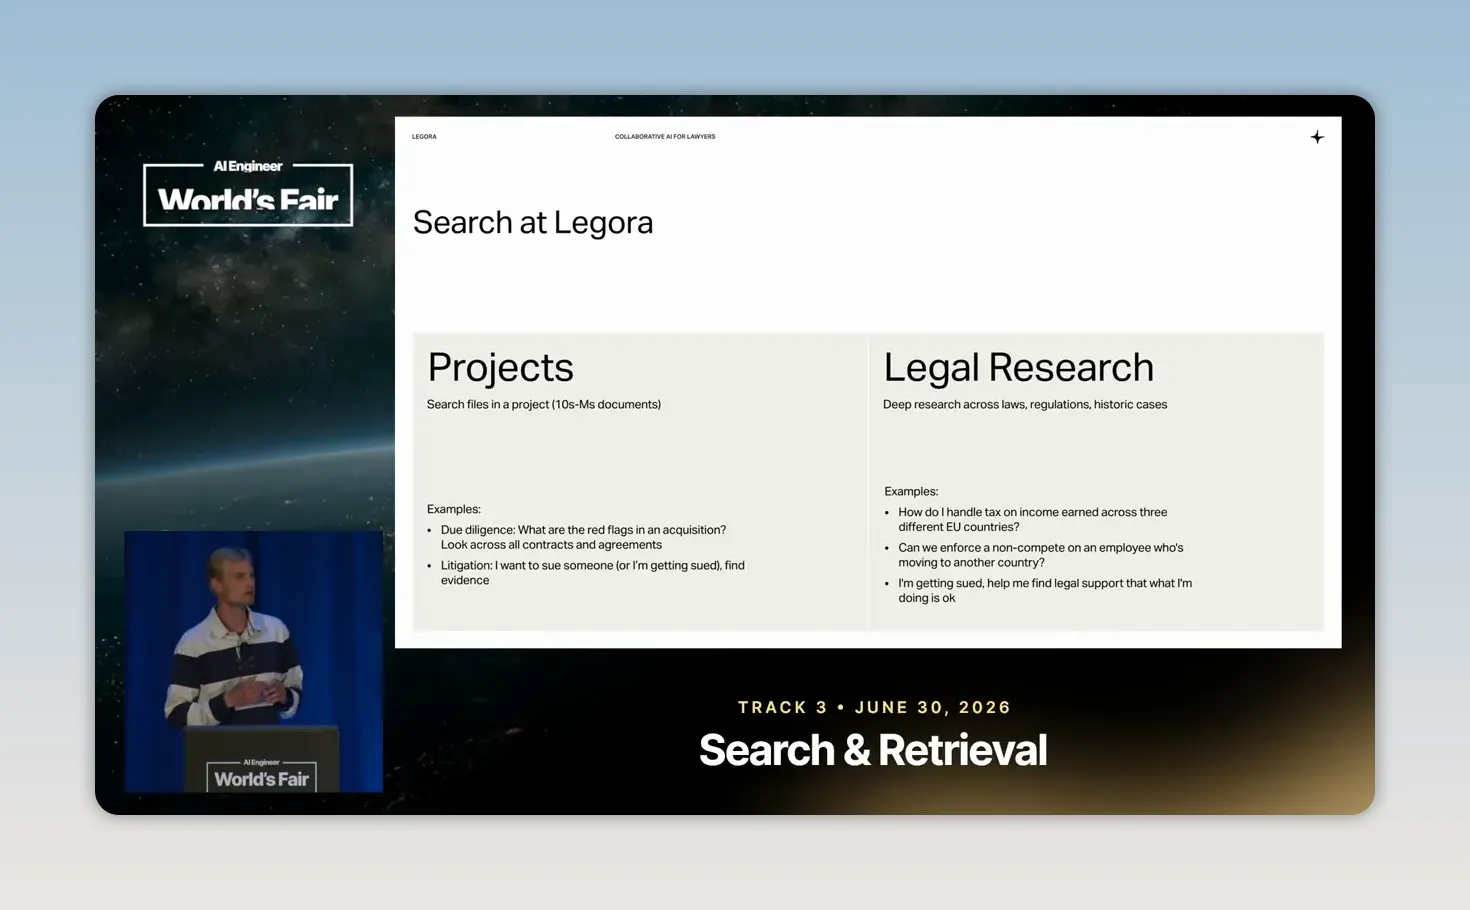
Legora เป็น collaborative AI platform สำหรับงานกฎหมาย ใช้ตรวจทานสัญญา ร่างเอกสาร และค้นหาข้อมูลทางกฎหมาย โดยแบ่งการค้นหาออกเป็นสองแบบที่ชัดเจน ได้แก่ Project Search และ Legal Research
- Project Search คือการค้นหาในชุดเอกสารของงานหนึ่งงาน เช่น ดีลซื้อกิจการ สัญญาผู้ขาย หรือเอกสารของลูกค้ารายหนึ่ง
- Legal Research คือการค้นหาข้ามฐานความรู้ขนาดใหญ่ เช่น กฎหมาย คำพิพากษา ระเบียบ และข้อยกเว้นต่าง ๆ
นี่คือจุดที่หลายองค์กรเริ่มผิดทาง เพราะมองว่า “ค้นเอกสาร” เป็น use case เดียว ทั้งที่รูปแบบการใช้งานต่างกันมาก การค้นหาสัญญาของลูกค้ารายเดียวต้องเน้นสิทธิ์เข้าถึง ความแม่นยำ และการแยกข้อมูล ส่วนการค้นหานโยบายทั้งบริษัทต้องรับคำถามหลากหลายและอาจต้องเชื่อมโยงเอกสารหลายประเภท
ถ้าใช้กับธุรกิจไทย องค์กรควรเริ่มด้วยการระบุว่า AI จะตอบคำถามจากเอกสารชุดไหน ใครเป็นเจ้าของข้อมูล และคำตอบที่ผิดสร้างผลกระทบระดับใด ตัวอย่างเช่น ทีมขายอาจค้นข้อมูลสินค้าและใบเสนอราคาได้ แต่ไม่ควรเข้าถึงสัญญาเงินเดือนหรือข้อมูลข้อพิพาทลูกค้า
Step 2: จัดข้อมูลตามหน่วยงานจริง ไม่ใช่ตามความสะดวกของระบบ
บทเรียนสำคัญที่สุดจาก Legora คือปัญหา performance ไม่ได้เกิดจากจำนวนเอกสารอย่างเดียว แต่เกิดจากการจัดข้อมูลไม่สอดคล้องกับพฤติกรรมใช้งานจริง
ในช่วงแรก Legora ใช้ search cluster กลางก้อนเดียว ทุกลูกค้าและทุกโปรเจกต์แชร์ระบบเดียวกัน วิธีนี้เริ่มต้นง่าย ดูแลง่าย และเหมาะเมื่อข้อมูลยังไม่มาก แต่เมื่อมีลูกค้าหลายภูมิภาค ก็เริ่มมีข้อกำหนดว่าเอกสารของลูกค้าในสหรัฐฯ ต้องประมวลผลในสหรัฐฯ เอกสารยุโรปต้องอยู่ในสหภาพยุโรป จึงต้องแยกระบบตาม region
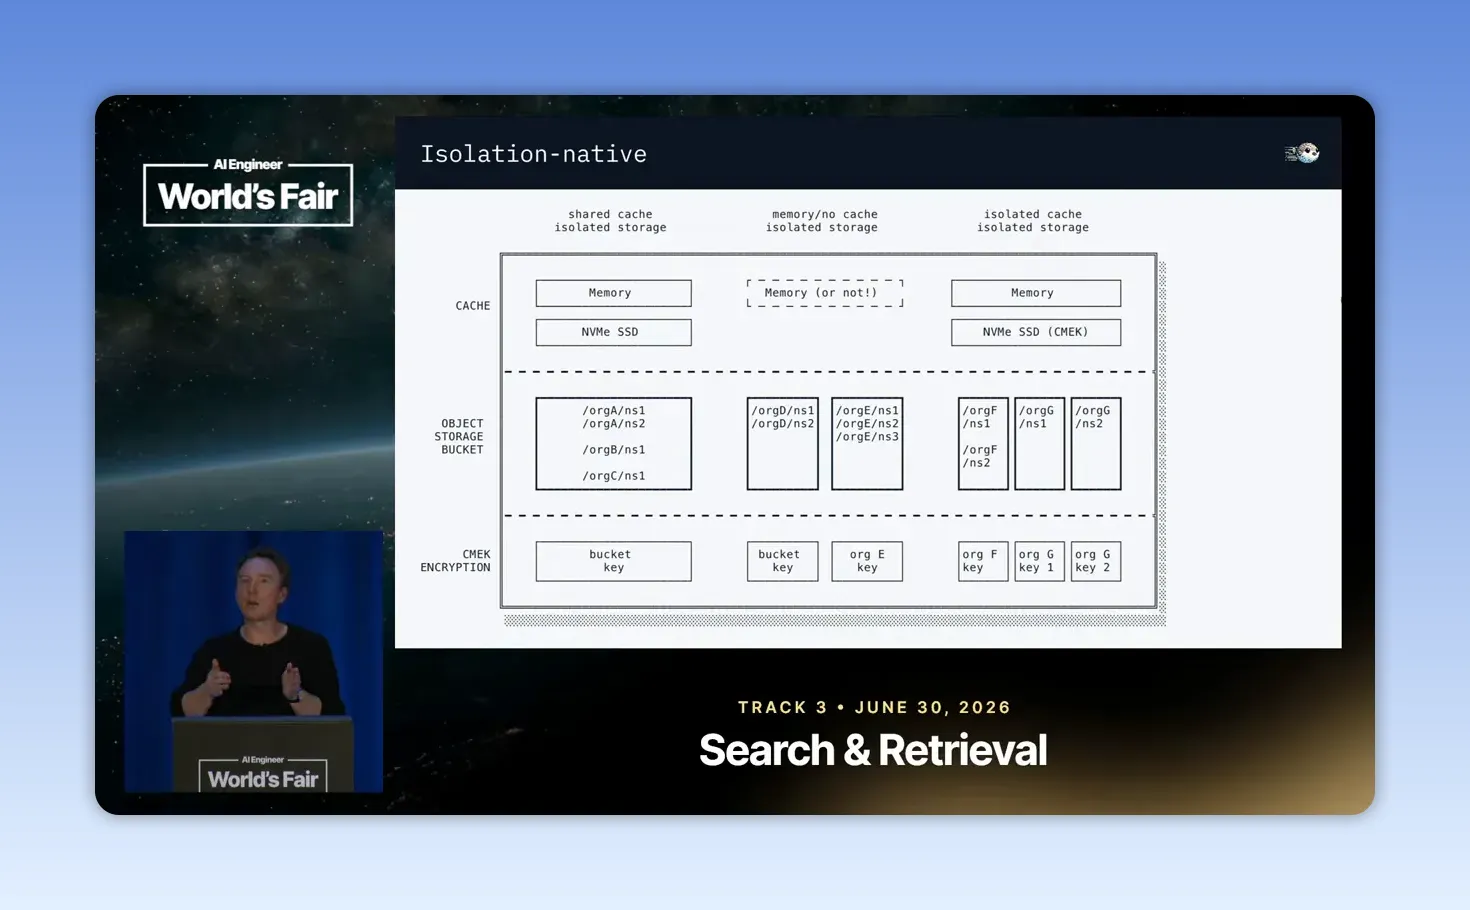
จากนั้นองค์กรขนาดใหญ่เพิ่มเงื่อนไขอีกระดับ เช่น ต้องการ physical isolation หรือการแยกพื้นที่เก็บข้อมูลให้ชัด ต้องการ customer managed encryption keys หรือกุญแจเข้ารหัสที่ลูกค้าควบคุมเอง นั่นทำให้การออกแบบแบบ “ฐานกลางหนึ่งก้อน” ไม่ตอบโจทย์อีกต่อไป
มุมธุรกิจที่ควรจำคือ หน่วยจัดเก็บข้อมูลควรใกล้กับหน่วยความรับผิดชอบ หากธุรกิจให้บริการหลายลูกค้า การแยกตามลูกค้าอาจเหมาะที่สุด หากทำงานเป็นเคสหรือโปรเจกต์ การแยกตามโปรเจกต์อาจปลอดภัยและจัดการต้นทุนได้ดีกว่า
เช่น บริษัทบัญชีอาจแยกคลังความรู้ตามบริษัทลูกค้า บริษัทรับเหมาควรแยกเอกสารตามโครงการ ส่วนทีม HR ควรแยกข้อมูลตามสิทธิ์ของฝ่ายงานและระดับผู้บริหาร ไม่ใช่โยนเอกสารทั้งหมดเข้า AI ตัวเดียวแล้วหวังให้ prompt ป้องกันความผิดพลาด
Step 3: ระวังข้อมูลเก่าไปแย่งทรัพยากรจากงานสำคัญ
Legora เคยย้าย search ไปอยู่บน PostgreSQL ที่ใช้งานอยู่แล้ว เพราะต้องการลดจำนวนระบบที่ต้องดูแล แนวคิดนี้ฟังดูสมเหตุผล และช่วงแรกก็ใช้ได้ดี พวกเขาแบ่งข้อมูลเอกสารออกเป็นราว 4,000 partitions เพื่อรองรับโปรเจกต์จำนวนมาก
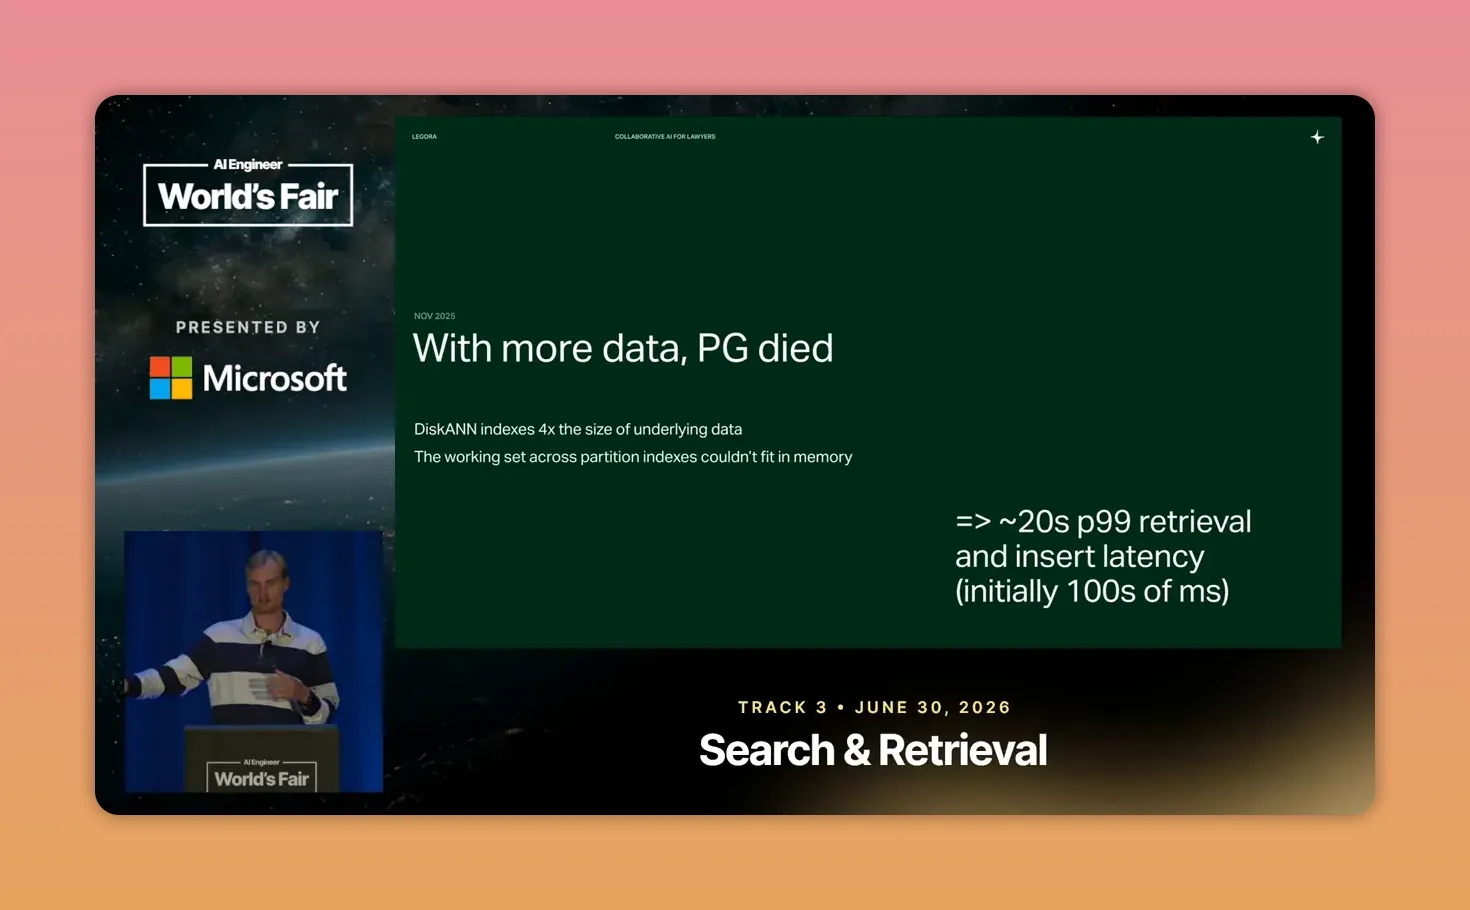
ปัญหาเกิดขึ้นเมื่อโปรเจกต์ที่ปิดไปแล้วและแทบไม่มีใครค้น ถูกเก็บปนอยู่ใน partition เดียวกับโปรเจกต์ที่มีการใช้งานหนัก ทุกครั้งที่ค้นหา ระบบต้องดึงข้อมูลชุดใหญ่ขึ้นสู่หน่วยความจำ แล้วเบียดข้อมูลชุดก่อนหน้าออกไป เกิดอาการ cache thrashing หรือการสลับข้อมูลเข้าออกจาก cache ตลอดเวลา
ผลลัพธ์คือ latency ของการค้นหาและการนำเข้าข้อมูลที่เคยอยู่ราว 100 มิลลิวินาทีในระดับ P99 พุ่งขึ้นไปถึง 20 วินาที ซึ่งเป็นความล่าช้าที่ทำให้ workflow ของ AI แทบใช้งานไม่ได้
สำหรับเจ้าของธุรกิจ ประเด็นนี้แปลเป็นภาษาง่าย ๆ ว่า อย่าดูแค่จำนวนไฟล์ทั้งหมด ให้ดูว่า เอกสารไหนถูกใช้บ่อย เอกสารไหนแทบไม่ถูกเปิด ข้อมูลเก่าหลายปีอาจจำเป็นต้องเก็บเพื่อการตรวจสอบ แต่ไม่ควรกินทรัพยากรเท่ากับข้อมูลที่ทีมงานใช้ทุกวัน
ระบบ AI ที่ตอบคำถามช้า บ่อยครั้งไม่ใช่เพราะ model ช้า แต่เพราะกระบวนการค้นหาเอกสารก่อนส่งคำถามเข้า model ช้าเกินไป ยิ่งระบบใช้ AI agent ที่ต้องค้นหลายรอบเพื่อรวบรวมคำตอบ ความหน่วงเพียงเล็กน้อยจะสะสมเป็นเวลารอที่ยาวมาก
Step 4: แยกข้อมูลตามโปรเจกต์และลูกค้า เพื่อให้เร็วขึ้นและควบคุมได้
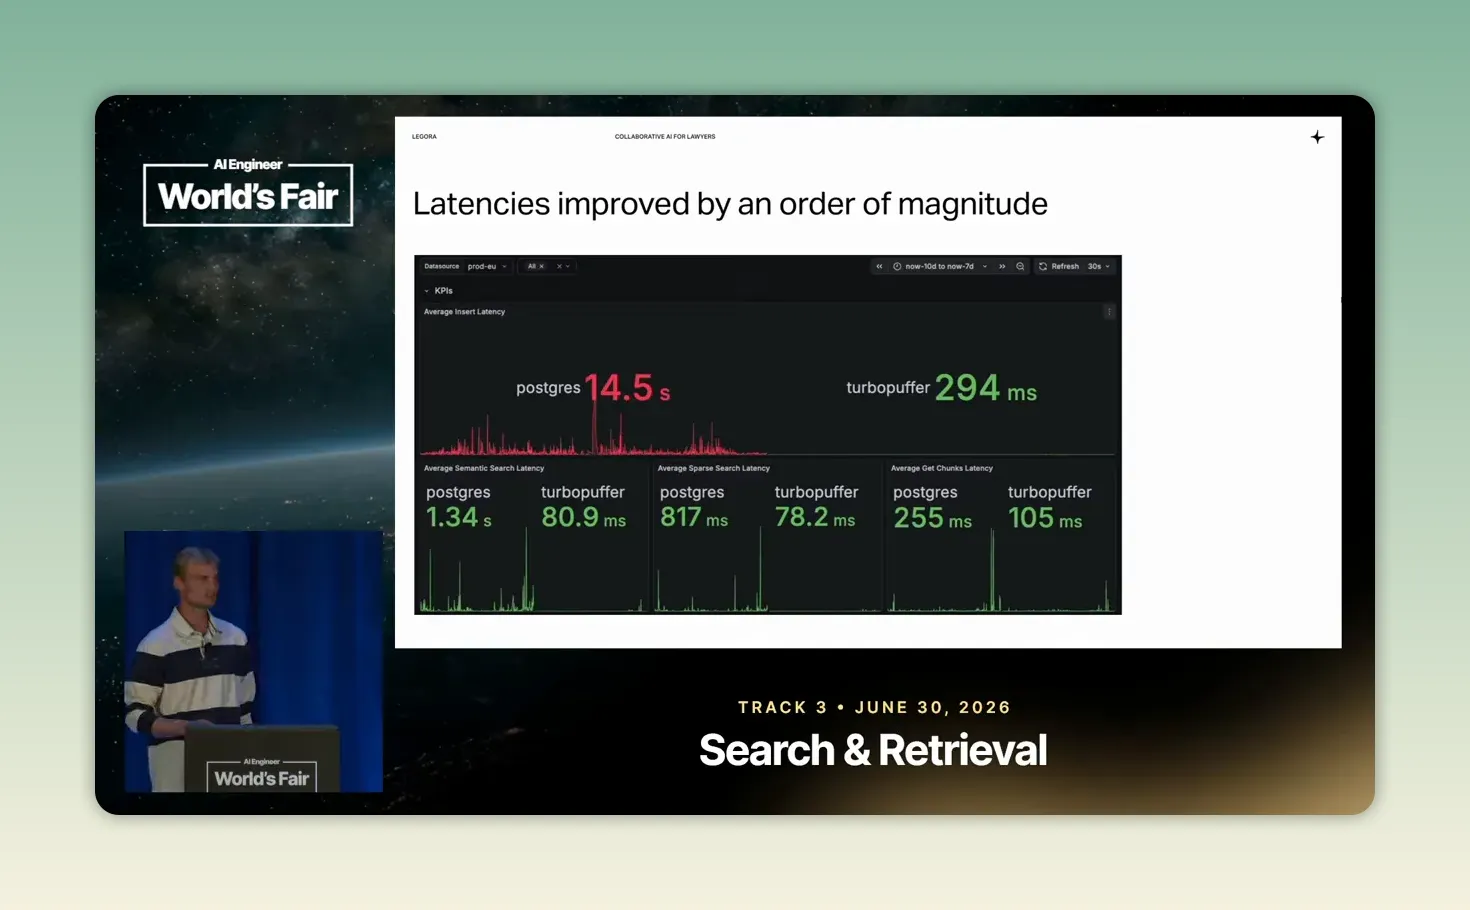
ทางออกของ Legora คือเปลี่ยนหน่วยจัดเก็บเป็น หนึ่ง namespace ต่อหนึ่งโปรเจกต์ โดย namespace ทำหน้าที่คล้ายตารางหรือพื้นที่แยกของข้อมูลแต่ละชุด เมื่อโปรเจกต์ใดไม่ถูกใช้งาน ข้อมูลนั้นสามารถพักอยู่ใน object storage แทนการกินทรัพยากรในระบบที่ต้องตอบสนองเร็ว
ผลที่ได้ไม่ได้มีแค่ความเร็ว ระบบรองรับ BM25 สำหรับ full text search ได้ดีขึ้น ทำให้การค้นหาด้วยคำสำคัญมีความเกี่ยวข้องมากขึ้น ลดภาระงานดูแล และช่วยควบคุมต้นทุน เพราะข้อมูลที่ไม่ค่อยถูกเรียกไม่จำเป็นต้องอยู่ในพื้นที่แพงตลอดเวลา
ข้อคิดที่นำไปใช้ได้ทันทีคือ ก่อนสร้าง AI chatbot ภายในบริษัท ให้แบ่งคลังข้อมูลเป็นชุดที่มีความหมายต่อธุรกิจ เช่น ลูกค้ารายหนึ่ง โปรเจกต์หนึ่ง แบรนด์หนึ่ง ฝ่ายงานหนึ่ง หรือระดับความลับหนึ่ง แล้วบังคับให้ AI ค้นได้เฉพาะชุดที่ผู้ใช้นั้นได้รับอนุญาต
วิธีนี้ดีกว่าการใช้ prompt บอก AI ว่า “ห้ามเปิดเผยข้อมูลลับ” เพียงอย่างเดียว เพราะสิทธิ์ควรถูกกำหนดตั้งแต่ระดับข้อมูล ไม่ใช่หวังให้ model ปฏิบัติตามคำสั่งได้ทุกครั้ง
Step 5: ทำให้ความปลอดภัยเป็นส่วนหนึ่งของโครงสร้างข้อมูล
ลูกค้าองค์กรขนาดใหญ่ไม่ได้ต้องการคำว่า “ข้อมูลปลอดภัย” แบบกว้าง ๆ แต่ต้องการหลักฐานว่าข้อมูลถูกแยกอย่างไร และใครมีสิทธิ์เพิกถอนการเข้าถึงได้
Legora จึงต้องรองรับการแยกข้อมูลระดับกายภาพและการใช้ encryption key ที่ลูกค้าเป็นผู้ควบคุม หากลูกค้าเพิกถอนสิทธิ์การใช้กุญแจ ระบบก็ไม่สามารถถอดรหัสข้อมูลที่เก็บไว้อีกต่อไป แนวคิดนี้ทำให้ลูกค้ามีอำนาจควบคุมข้อมูลของตนมากกว่าการฝากทุกอย่างไว้กับผู้ให้บริการ
สำหรับธุรกิจไทย ไม่จำเป็นต้องสร้างระบบเข้ารหัสระดับเดียวกับสถาบันการเงินตั้งแต่วันแรก แต่ควรยึดหลักเดียวกัน คือแยกสิทธิ์ แยกพื้นที่ และมีทางถอนสิทธิ์ได้จริง โดยเฉพาะเมื่อข้อมูลเกี่ยวข้องกับลูกค้า พนักงาน สัญญา หรือข้อมูลส่วนบุคคล
การออกแบบควรสอดคล้องกับหลักคุ้มครองข้อมูลส่วนบุคคลตาม สำนักงานคณะกรรมการคุ้มครองข้อมูลส่วนบุคคล ไม่ใช่แค่ตอนระบบใกล้เปิดใช้แล้วค่อยกลับมาแก้สิทธิ์การเข้าถึง เพราะตอนนั้นต้นทุนมักสูงกว่าเดิมมาก
Step 6: ยอมให้ข้อมูลบางส่วนช้าลง เพื่อแลกกับต้นทุนที่สมเหตุผล
อีกแนวคิดที่น่าสนใจคือการแยกข้อมูล hot และ cold ข้อมูลที่ถูกค้นหาบ่อย เช่น กฎหมายสหภาพยุโรปในกรณีของ Legora ควรอยู่ใกล้หน่วยความจำหรือ SSD มากกว่า ส่วนข้อมูลเฉพาะทางที่แทบไม่มีใครเรียก สามารถเก็บไว้ใน object storage ได้
การค้นข้อมูล cold อาจช้ากว่าราว 500 มิลลิวินาที แต่สำหรับงานวิจัยเชิงลึก ความล่าช้าระดับนี้รับได้ หากช่วยลดต้นทุนการเก็บข้อมูลระยะยาวได้มาก
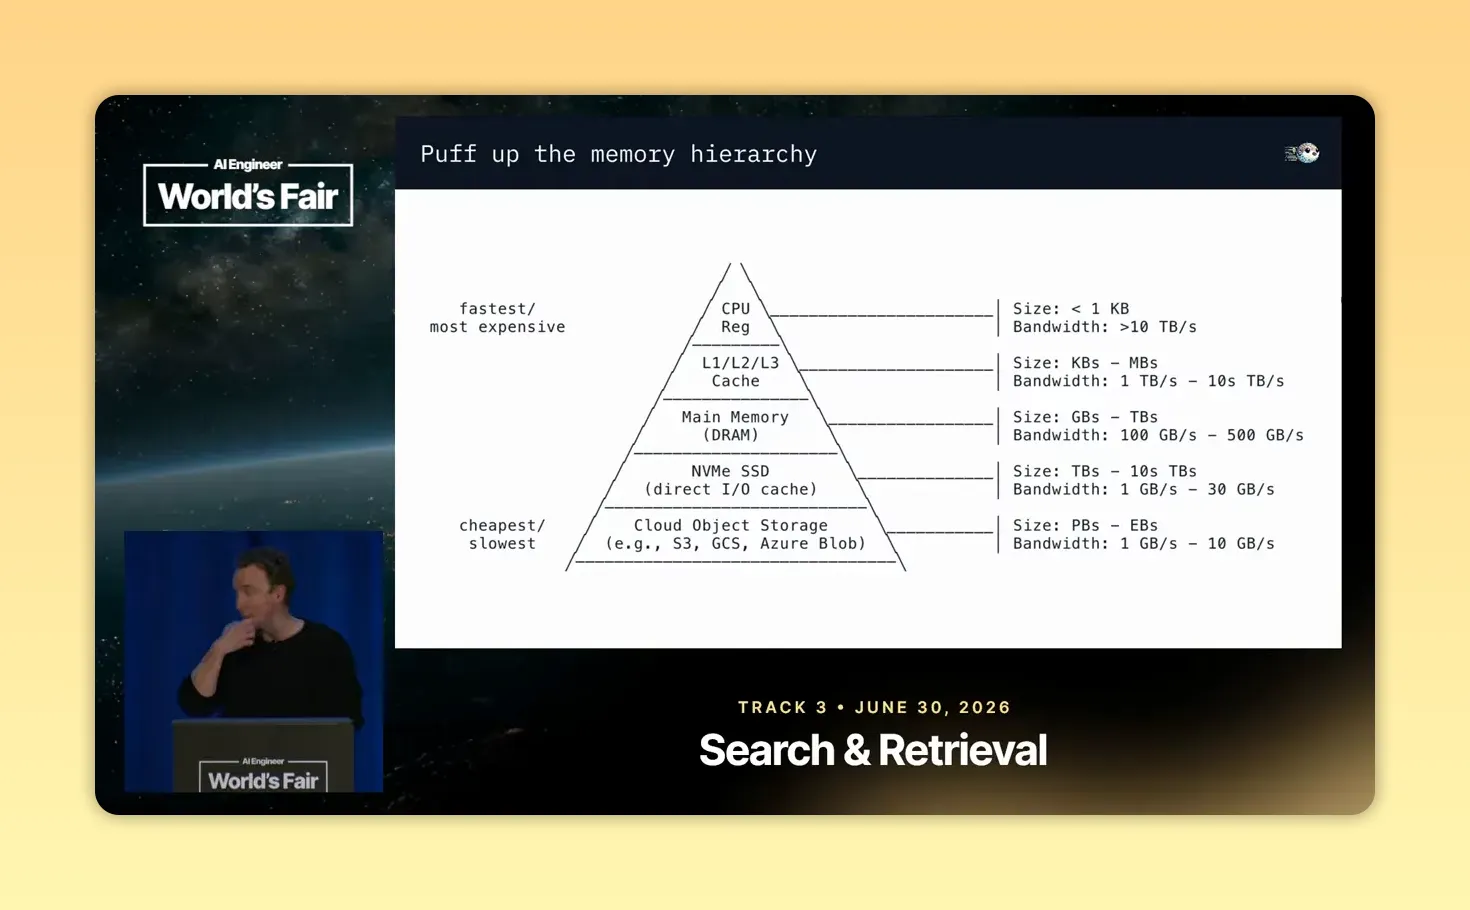
นี่เป็นมุมที่หลายทีมมองข้าม เพราะมักตั้งเป้าว่า “ทุกคำตอบต้องเร็วที่สุด” แต่คำถามที่ควรถามคือ งานไหนต้องเร็วแค่ไหน แชตตอบลูกค้าหน้าเว็บไซต์ต้องเร็วมาก แต่การค้นสัญญาเก่าเพื่อเตรียมประชุมอาจยอมรอได้มากกว่า
การกำหนดมาตรฐานความเร็วตาม use case ช่วยให้เราไม่จ่ายค่า infrastructure เกินความจำเป็น และยังทำให้ทีมเลือกลงทุนกับจุดที่กระทบรายได้หรือความเสี่ยงจริง
Step 7: ใช้ทั้ง semantic search และ keyword search เพื่อให้ AI หาเจอจริง
การค้นหาเอกสารสำหรับ AI ไม่ควรพึ่ง vector search อย่างเดียว Vector search เหมาะกับการหาข้อมูลที่มีความหมายใกล้เคียงกัน แม้ใช้คนละคำ เช่น คำถามเรื่อง “เงื่อนไขยกเลิกสัญญา” อาจไปเจอหัวข้อ “การสิ้นสุดข้อตกลง” ได้
แต่ในเอกสารกฎหมาย ชื่อบริษัท เลขสัญญา ชื่อมาตรา หรือคำศัพท์เฉพาะต้องการ full text search ที่แม่นตรงคำ Legora จึงให้ความสำคัญกับ BM25 ซึ่งให้คะแนนเอกสารตามความสำคัญและความหายากของคำ ยิ่งคำหนึ่งปรากฏน้อยแต่ตรงกับคำค้น ก็ยิ่งมีน้ำหนักมากขึ้น
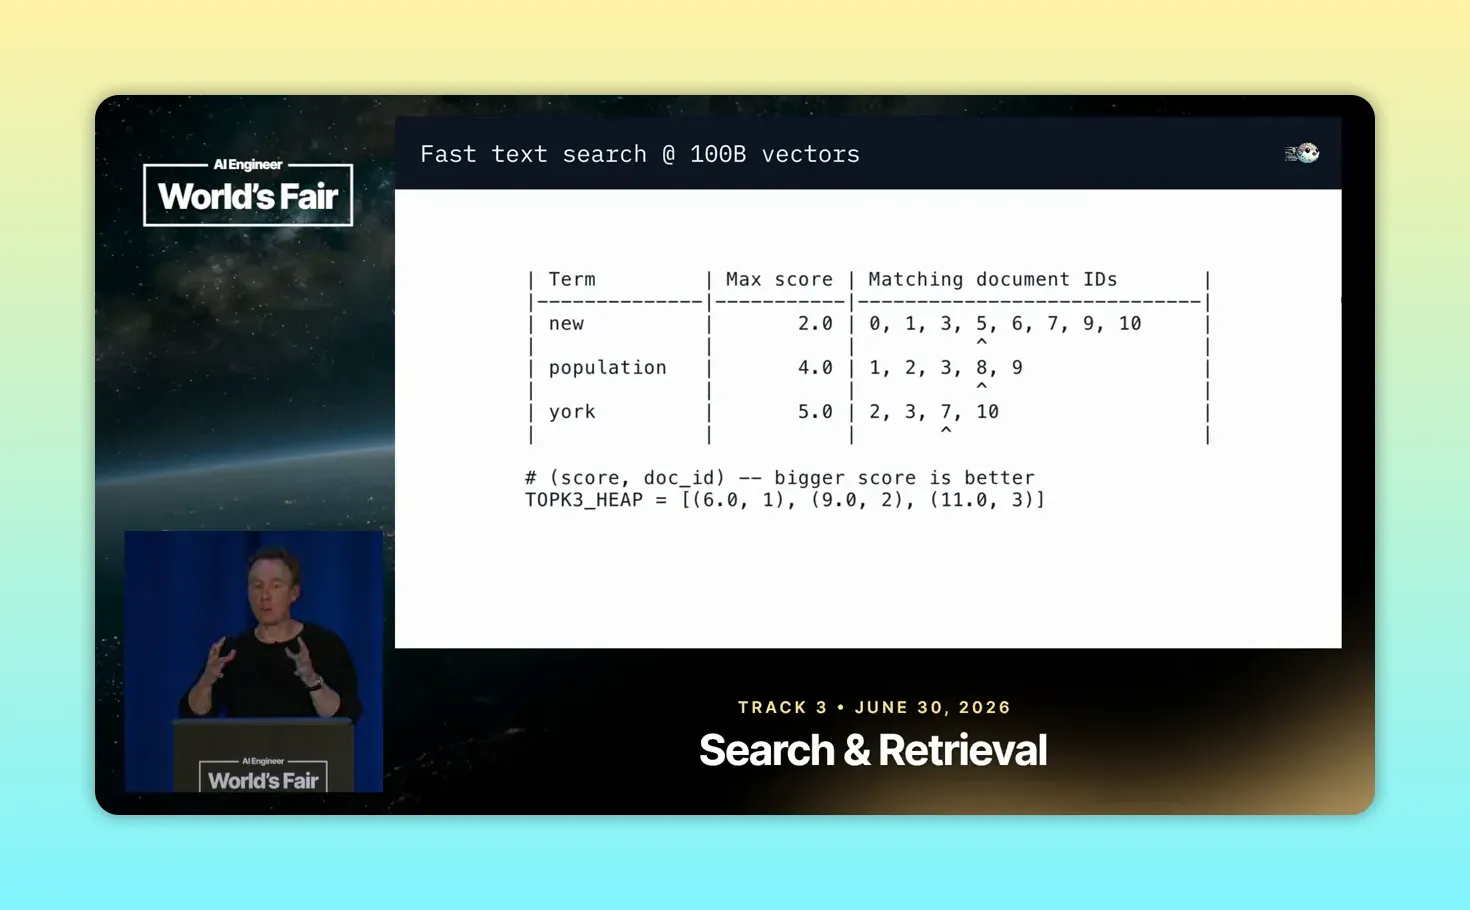
มุมมองของเราคือ AI Knowledge Base ที่ดีควรใช้การค้นหาแบบผสม ไม่ใช่เลือกฝ่ายใดฝ่ายหนึ่ง หากค้นด้วยชื่อ SKU, รหัสสินค้า, เลขใบสั่งซื้อ หรือชื่อคู่สัญญา ระบบต้องเจอคำตรง หากถามด้วยภาษาธรรมชาติ ระบบก็ควรเข้าใจเจตนาและคำพ้องความหมายได้
อย่าหลงเชื่อภาพจำว่า vector search คือคำตอบของทุกอย่าง แม้ในระดับ web scale งาน full text search ยังเป็นงานที่ใช้พลังประมวลผลและออกแบบยากมาก การวัดผลจากคำถามจริงของทีมจึงสำคัญกว่าการเลือกเทคโนโลยีตามกระแส
Step 8: เปลี่ยนบทเรียนเป็น Actionable Insights สำหรับธุรกิจไทย
- แบ่งคลังเอกสารก่อนทำ chatbot: แยกตามลูกค้า โปรเจกต์ ฝ่ายงาน หรือชั้นความลับ แล้วค่อยเชื่อม AI
- ทำรายการข้อมูล hot และ cold: ระบุเอกสารที่ทีมใช้ทุกวัน และเอกสารที่เก็บเพื่ออ้างอิงเท่านั้น เพื่อวางต้นทุนให้เหมาะ
- ทดสอบด้วยคำถามงานจริง: รวบรวมคำถาม 30 ถึง 50 ข้อจากทีมงาน แล้ววัดว่า AI หาแหล่งอ้างอิงถูกหรือไม่
- กำหนดสิทธิ์ก่อนเปิดใช้: อย่ารอให้เกิดข้อมูลรั่วแล้วค่อยเพิ่ม permission ต้องตัดสินว่าใครค้นอะไรได้ตั้งแต่ต้น
- วัดเวลาค้นหาแยกจากเวลาที่ AI ตอบ: หากคำตอบช้า ให้ดู retrieval ก่อนเปลี่ยน model หรือเพิ่มงบ token
Step 9: Troubleshooting ปัญหาที่มักเกิดเมื่อทำ AI ค้นเอกสาร
- ปัญหา: AI ตอบช้าเมื่อเอกสารเพิ่มขึ้น
สาเหตุ: ข้อมูลที่ใช้งานหนักปนกับข้อมูลเก่าหรือข้อมูลที่แทบไม่ถูกเรียก
วิธีแก้: แยกเอกสารตามหน่วยงานจริง, ระบุชุดข้อมูล hot และ cold, วัด latency แยกตามคลังข้อมูล - ปัญหา: AI อ้างอิงเอกสารผิดลูกค้าหรือผิดโปรเจกต์
สาเหตุ: ระบบค้นหาข้ามขอบเขตข้อมูลโดยไม่มี permission ที่ระดับ retrieval
วิธีแก้: กำหนด namespace หรือคลังข้อมูลแยก, ส่งสิทธิ์ผู้ใช้ไปพร้อมคำค้น, ตรวจคำตอบพร้อมแหล่งอ้างอิง - ปัญหา: ค้นหาเลขสัญญา ชื่อสินค้า หรือคำเฉพาะไม่เจอ
สาเหตุ: ใช้ semantic search เพียงแบบเดียว
วิธีแก้: เพิ่ม keyword search, รองรับการค้นคำตรง, เตรียมคำพ้องและรูปแบบรหัสที่ทีมใช้จริง - ปัญหา: ต้นทุน AI สูงขึ้นทั้งที่การใช้งานไม่ได้โตมาก
สาเหตุ: เก็บและเตรียมข้อมูลทั้งหมดไว้ในชั้นที่มีต้นทุนสูง
วิธีแก้: ย้ายข้อมูลที่ไม่ค่อยใช้ไปเก็บระยะยาว, กำหนดเวลาหมดอายุของ cache, วัดต้นทุนตามประเภทงาน - ปัญหา: ทีมไม่มั่นใจจะใช้คำตอบจาก AI
สาเหตุ: คำตอบไม่มีที่มา หรือค้นข้อมูลมาไม่ครบ
วิธีแก้: บังคับให้แสดงเอกสารต้นทาง, ระบุหน้าและหัวข้อเมื่อทำได้, ให้คนตรวจทานในงานที่มีผลทางกฎหมายหรือการเงิน
Step 10: ต่อยอดจาก AI ค้นเอกสารสู่ workflow ที่มีมูลค่าสูงกว่า
เมื่อระบบค้นหาเอกสารเริ่มเชื่อถือได้ ธุรกิจสามารถต่อยอดได้มากกว่า chatbot คำถามตอบคำตอบ
- AI ตรวจสัญญาเบื้องต้น: ค้นหาข้อกำหนดสำคัญ เช่น ระยะเวลาสัญญา การต่ออายุ ค่าปรับ และเงื่อนไขยกเลิก แล้วส่งประเด็นให้ฝ่ายกฎหมายตรวจ
- AI ผู้ช่วยฝ่ายขาย: ดึงข้อมูลสินค้า กรณีศึกษา เงื่อนไขราคา และคำถามพบบ่อยจากคลังที่ได้รับสิทธิ์ เพื่อช่วยร่างคำตอบลูกค้า
- AI สรุปความเสี่ยงรายโครงการ: รวบรวมเอกสารหลายฉบับในโปรเจกต์เดียว แล้วแจ้งรายการที่ยังขาดหรือเงื่อนไขที่ขัดกัน
หัวใจคืออย่ารีบให้ AI ตัดสินใจแทนคน ระบบควรเริ่มจากช่วยค้น ช่วยจัดลำดับ และช่วยสรุปก่อน เมื่อมีข้อมูลผลลัพธ์มากพอ จึงค่อยขยายไปสู่งานที่ซับซ้อนขึ้น
Step 11: สรุป Checklist ทั้งหมดก่อนเชื่อม AI กับเอกสารองค์กร
- ☐ ระบุ use case ว่าเป็นการค้นหาในโปรเจกต์ หรือค้นหาข้ามคลังความรู้
- ☐ แบ่งเอกสารตามลูกค้า โปรเจกต์ ฝ่ายงาน หรือระดับความลับ
- ☐ กำหนดสิทธิ์เข้าถึงก่อนเชื่อมข้อมูลเข้า AI
- ☐ แยกข้อมูล hot และ cold ตามพฤติกรรมการใช้งานจริง
- ☐ ตั้งเป้าความเร็วที่ต่างกันตามประเภทงาน
- ☐ ใช้ keyword search ร่วมกับ semantic search เมื่อมีคำเฉพาะหรือรหัสสำคัญ
- ☐ ทดสอบคำถามจากงานจริง และตรวจความถูกต้องของแหล่งอ้างอิง
- ☐ วัด latency ของ retrieval แยกจากเวลาที่ model สร้างคำตอบ
- ☐ ติดตามต้นทุนตามคลังข้อมูลและรูปแบบการใช้งาน
- ☐ ให้คนตรวจทานผลลัพธ์ในงานกฎหมาย การเงิน และข้อมูลอ่อนไหว
บทเรียนจาก Legora และ turbopuffer สรุปได้ชัดเจนว่า การต่อ AI กับเอกสารนับพันล้านไม่ใช่เรื่องของ model ที่ฉลาดที่สุด แต่คือการออกแบบระบบค้นหาให้เข้าใจโครงสร้างธุรกิจ ขอบเขตข้อมูล และพฤติกรรมการใช้งานจริง หากเริ่มจากการจัดข้อมูลและสิทธิ์ให้ถูก AI จะตอบได้เร็วขึ้น น่าเชื่อถือขึ้น และพร้อมขยายจากผู้ช่วยเล็ก ๆ ไปสู่ workflow ที่สร้างผลลัพธ์ให้ธุรกิจได้มากกว่าเดิม
ที่มาวิดีโอ: Connect AI to Billions of Legal Documents — Simon Eskildsen, turbopuffer & Jacob Lauritzen, Legora · AI Engineer · ย้ายจากบทความต้นทางวันที่ 2026-09-16 โดยคงเนื้อหาหลักเดิม