การเพิ่ม GPU ไม่ได้ทำให้ระบบ AI เร็วขึ้นเสมอไป เพราะเวลาส่วนหนึ่งอาจสูญไปกับการรอข้อความขนาดเล็กระหว่างเครื่องใน cluster นี่คือประเด็นที่ John Ousterhout จาก Stanford ชวนมองในคลิปนี้ โดยเขาเห็นว่าข้อความสั้นมีบทบาทมากขึ้นใน inference และ agentic workload ขณะที่งานเทรน model ยังมีการส่งข้อมูลขนาดใหญ่เป็นหลัก
คลิป The End of TCP for AI Clusters — John Ousterhout, Stanford จากช่อง AI Engineer นำเสนอข้อโต้แย้งของ Ousterhout ว่า TCP และ RDMA ในรูปแบบที่เขากล่าวถึงอาจไม่เหมาะกับงานที่ผสมข้อความเล็กกับข้อมูลขนาดใหญ่ ประเด็นสำคัญคือการมอง tail latency ที่อาจทำให้ GPU ทั้งกลุ่มว่างรอ คำอธิบาย protocol และผลทดสอบต่อจากนี้เป็นสิ่งที่เขานำเสนอในคลิป ไม่ใช่ผลทดสอบที่บทความนี้ทำซ้ำ
สำหรับเจ้าของธุรกิจไทย ตัวอย่าง AI chatbot, ระบบค้นหาความรู้ภายใน หรือ workflow อัตโนมัติในบทความนี้เป็นการประยุกต์แนวคิดเพื่อชวนตั้งคำถามเรื่องคอขวด ไม่ใช่ระบบที่ Ousterhout ทดสอบในคลิป และไม่ได้แปลว่าต้องเปลี่ยน protocol ของระบบเหล่านั้น
เมื่อ AI workload มีข้อความสั้นมากขึ้น
ในภาพที่ Ousterhout อธิบาย งาน AI แบบดั้งเดิม โดยเฉพาะการเทรน model ขนาดใหญ่ ต้องส่งข้อมูลมหาศาลระหว่างเครื่อง เช่น weight gradients สิ่งที่ระบบสนใจที่สุดจึงเป็น throughput หรือปริมาณข้อมูลที่ส่งผ่านเครือข่ายได้ต่อวินาที แม้เริ่มเชื่อมต่อช้าไปเล็กน้อยก็ไม่กระทบมาก เพราะการส่งข้อมูลกินเวลานานอยู่แล้ว เขาระบุว่า TCP และ RDMA ทำงานกับลักษณะงานนี้ได้ดีพอสมควร
แต่เขามองว่า inference และ agentic workload บางส่วนมีลักษณะต่างออกไป ระบบอาจต้องตรวจว่าข้อมูลอยู่ใน distributed KV cache หรือไม่ ส่ง metadata เพื่อประสานงานระหว่าง node หรือรอ barrier synchronization ก่อนเริ่มงานรอบถัดไป ข้อมูลแต่ละครั้งมีขนาดเล็ก แต่ถูกส่งถี่และต่อเนื่อง
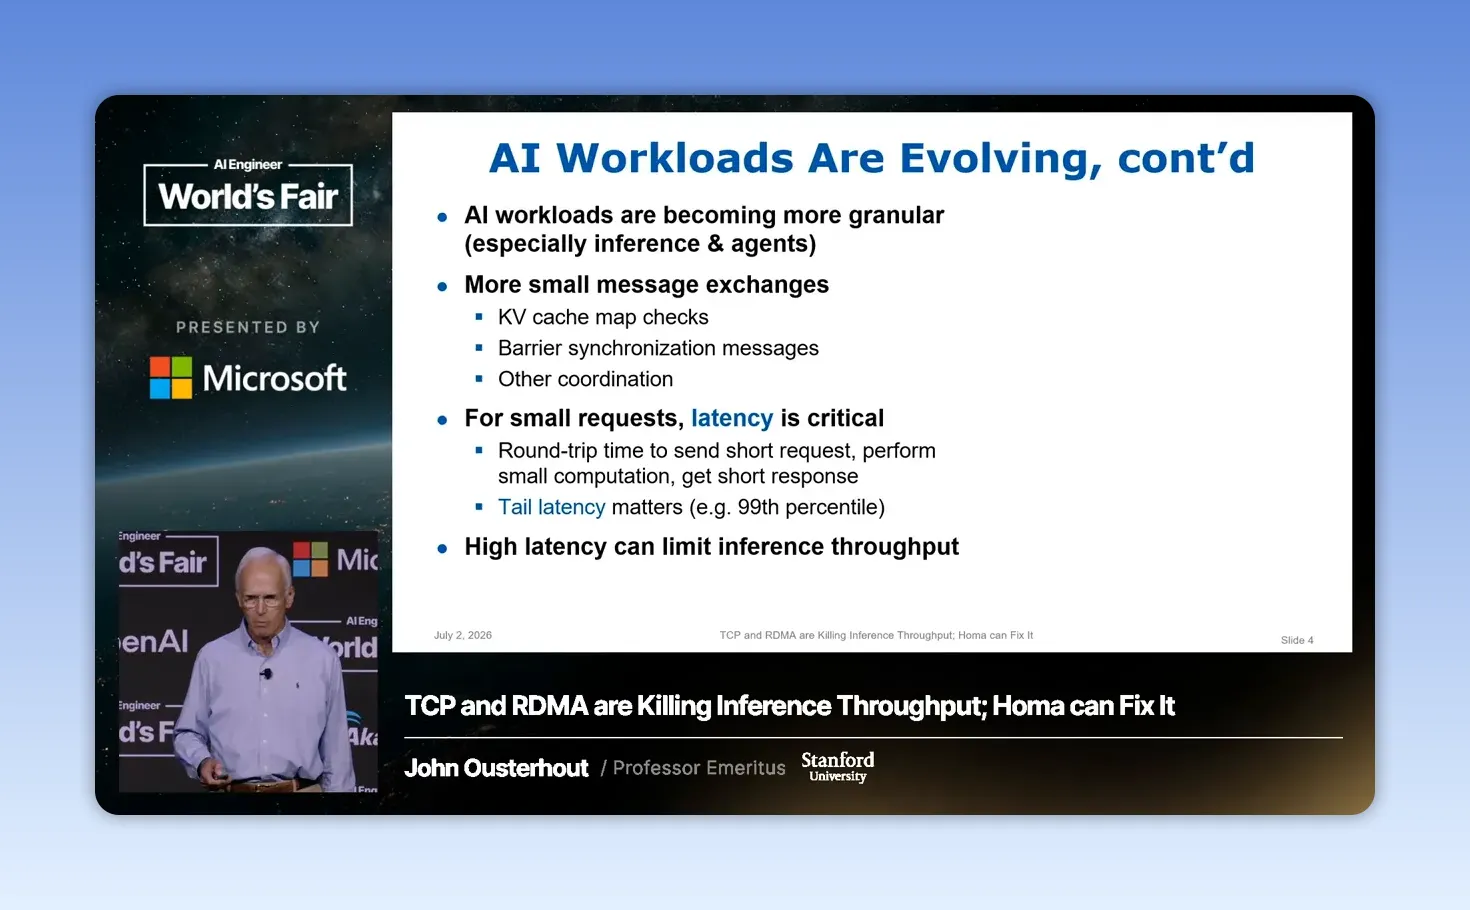
จุดที่ควรจับตาจึงไม่ใช่เพียง latency เฉลี่ย แต่รวมถึง P99 latency หรือค่าที่ประมาณ 99% ของคำขอใช้เวลาไม่เกินค่านั้น ส่วนคำขอที่ช้าที่สุดประมาณ 1% อยู่เหนือค่า P99 ในตัวอย่างงานที่กระจายอยู่หลาย node และต้องรอทุกฝ่ายเสร็จ หากมีเพียงหนึ่งคำขอที่ช้าผิดปกติ งานทั้งรอบก็ไปต่อไม่ได้
มุมมองที่นำไปใช้กับธุรกิจไทยได้คือ อย่าถามแค่ว่า “ระบบตอบโดยเฉลี่ยกี่วินาที” แต่ควรถามว่า “ช่วงเวลาเร่งด่วน คำขอที่ช้าที่สุดช้าแค่ไหน และช้าจากจุดใด” เพราะลูกค้าหรือพนักงานจะจดจำเคสที่ระบบค้าง ไม่ใช่ค่าเฉลี่ยที่ดูสวยใน dashboard
มองต้นทุนที่ซ่อนอยู่เมื่อ GPU ทั้งกลุ่มต้องรอ node เดียว
Ousterhout ยกภาพการทำงานที่แบ่งงานไปหลาย node แต่ละเครื่องใช้ GPU ประมวลผล แล้วจึงแลกเปลี่ยนข้อมูลเล็กน้อยก่อนเริ่มรอบใหม่ ระหว่างการแลกเปลี่ยนนี้ GPU ทุกตัวต้องหยุดรอ
ในตัวอย่างสมมติของเขา เมื่อช่วงคำนวณยาวราว 5 วินาที การรอแลกเปลี่ยนข้อมูลไม่กี่มิลลิวินาทีแทบไม่มีนัยสำคัญ แต่ใน agentic workload ที่ช่วงคำนวณลดเหลือระดับมิลลิวินาที การรอ network ที่ยาวพอๆ กับเวลาคำนวณอาจทำให้ทรัพยากร GPU ส่วนสำคัญหมดไปกับการรอ
ตัวอย่างประยุกต์ของบทความคือธุรกิจที่ทำระบบผู้ช่วยขายผ่าน LINE หรือระบบสรุปเคสลูกค้าสำหรับ call center หาก workflow หนึ่งเรียกหลายบริการ เช่น retrieval, cache, model serving และฐานข้อมูล ความช้าจากจุดหนึ่งอาจสะสมจนการตอบกลับทั้งชุดรู้สึกช้า แม้ model แต่ละตัวทำงานได้เร็วแล้วก็ตาม ตัวอย่างนี้ไม่ได้ยืนยันว่าคอขวดเกิดจาก transport protocol แบบเดียวกับในคลิป
นี่คือเหตุผลที่การเพิ่ม GPU หรือเปลี่ยนไปใช้ model ที่เล็กกว่าอาจแก้ปัญหาไม่ตรงจุด หากช่วงเวลาส่วนใหญ่เสียไปกับการประสานงานระหว่างบริการ การลงทุน compute เพิ่มอาจให้ผลตอบแทนน้อยกว่าการวัดและลด latency ของเส้นทางข้อมูล
เข้าใจ Incast และเหตุผลที่ข้อความเล็กติดอยู่หลังงานใหญ่
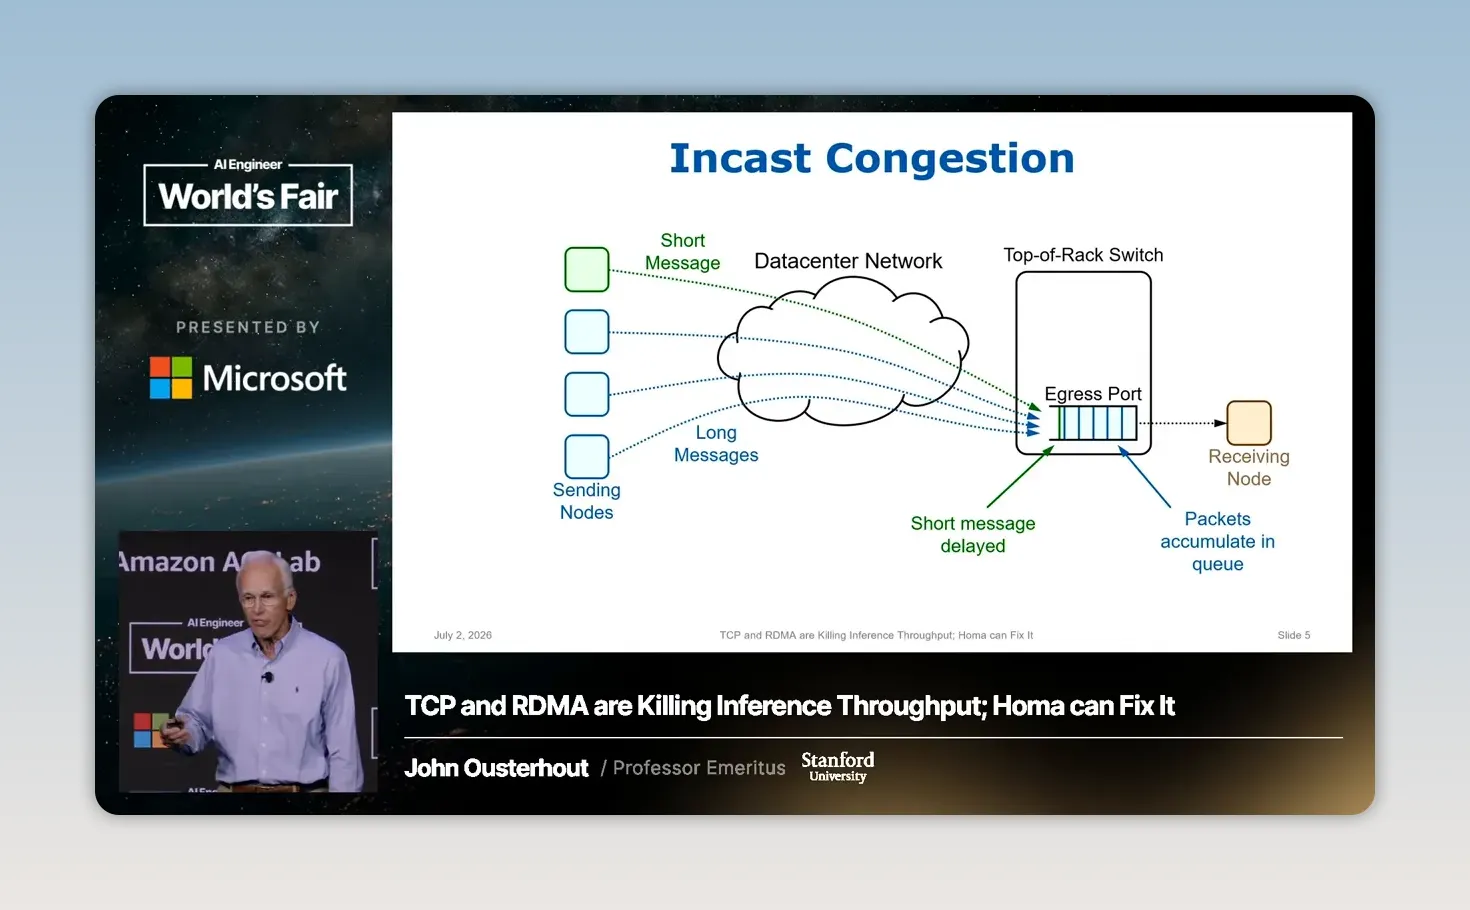
สาเหตุของ tail latency ที่ Ousterhout เน้นในคลิปคือ incast congestion หรือหลาย node ส่งข้อมูลเข้าสู่ปลายทางเดียวกันในเวลาใกล้เคียงกัน ในตัวอย่างที่ลิงก์มีความเร็วเท่ากัน ลิงก์จากหลายเครื่องรวมกันส่งได้เร็วกว่าที่ปลายทางเดียวจะรับไหว แพ็กเก็ตจึงสะสมตรงคิวของ switch ใน hop สุดท้ายก่อนถึงเครื่องรับ
ปัญหาเกิดเมื่อมีข้อความสั้นและเร่งด่วนมุ่งไปยังปลายทางเดียวกัน ข้อความนั้นต้องเข้าคิวต่อท้ายแพ็กเก็ตของงานใหญ่ หากคิวเต็ม switch อาจทิ้งแพ็กเก็ต จนเกิด timeout และการส่งซ้ำ ซึ่งยิ่งทำให้ความหนาแน่นแย่ลง
เปรียบกับหน้าร้านที่มีรถบรรทุกหลายคันถอยเข้าประตูรับของเดียวกัน รถจักรยานยนต์ที่นำเอกสารสำคัญมาส่งก็ถูกบังคับให้รอท้ายคิวรถบรรทุก แม้ใช้เวลาเปิดประตูรับเอกสารเพียงไม่กี่วินาที ปัญหาไม่ใช่เอกสารใหญ่ แต่เป็นการจัดคิวที่ไม่แยกความเร่งด่วน
ธุรกิจส่วนใหญ่ที่ใช้ API จาก cloud provider อาจไม่ต้องแก้ระดับ protocol เอง แต่ยังได้บทเรียนสำคัญ คือควรออกแบบ workflow ไม่ให้ทุก service ยิงคำขอพร้อมกันเข้าสู่ฐานข้อมูล, cache หรือ endpoint เดียวโดยไม่จำเป็น โดยเฉพาะตอนมีงาน batch, การปล่อยแคมเปญ หรือการทำ retrieval จำนวนมากพร้อมกัน
รู้ข้อจำกัดของ TCP เมื่อผู้ส่งรู้ปัญหาช้าเกินไป
Ousterhout อธิบายข้อจำกัดของ congestion control แบบที่ให้ “ผู้ส่ง” เป็นคนลดความเร็วส่งข้อมูล แต่คอขวดเกิดอยู่ใกล้ “ผู้รับ” ผู้ส่งจึงได้รับสัญญาณช้า ผ่านการสูญหายของแพ็กเก็ตหรือสัญญาณ ECN ที่ switch ทำเครื่องหมายไว้ เมื่อพูดถึง RDMA ในคลิป เขาระบุว่าหมายถึง RoCE หรือ RDMA over Converged Ethernet คำวิจารณ์นี้จึงควรอ่านในขอบเขตระบบที่เขานำเสนอ
ผู้ส่งหลายรายจึงพยายามปรับความเร็วพร้อมกัน โดยมีข้อมูลจำกัดว่าเครือข่ายเริ่มแน่นแล้ว แต่ไม่รู้ชัดว่าแน่นตรงไหนหรือควรลดเท่าไร กว่าจะปรับได้พอดี สภาพเครือข่ายก็เปลี่ยนเพราะมีงานใหม่เริ่มหรืองานเดิมจบ ระบบจึงแกว่งระหว่างส่งมากเกินไปและส่งน้อยเกินไป
อีกข้อจำกัดคือ TCP มองข้อมูลเป็น byte stream จึงไม่รู้ขอบเขตของแต่ละ message หากส่งข้อความใหญ่สองชุดก่อน แล้วส่งข้อความเล็กตามหลัง ข้อความเล็กอาจติดอยู่หลังข้อมูลใหญ่ เรียกว่า head of line blocking
สำหรับคนทำธุรกิจ นี่ไม่ใช่เหตุผลให้สรุปว่า TCP ใช้ไม่ได้ เพราะ TCP ยังเหมาะกับงานทั่วไปจำนวนมาก แต่เป็นสัญญาณว่าเมื่อระบบ AI เริ่มทำงานแบบกระจายหลาย node เราควรแยกปัญหาให้ถูกระหว่าง “model ช้า” กับ “การสื่อสารระหว่างระบบช้า”
เรียนรู้แนวคิด Homa ที่ให้ผู้รับจัดคิวและให้สิทธิ์การส่งข้อมูล
Homa คือ protocol ที่ทีม Stanford ออกแบบใหม่โดยตั้งต้นจากงานใน data center ตามคำอธิบายของ Ousterhout แทนที่จะพยายามแต่ง TCP เพิ่มอีกชั้น แนวคิดหลักที่เขายกมาเล่ามีสามส่วน
1. ใช้ message เป็นหน่วยหลัก
Homa มองการสื่อสารเป็น remote procedure call หรือ RPC ที่มี request และ response จึงรู้ขนาด message ตั้งแต่แรก เมื่อผู้รับเห็นแพ็กเก็ตแรก ก็พอรู้ได้ว่ามีข้อมูลกำลังตามมาอีกเท่าไร ข้อมูลนี้ช่วยให้ตัดสินใจจัดคิวได้ดีกว่า byte stream ที่ไม่เห็นขอบเขต message
เมื่อ message เป็นอิสระจากกัน ข้อความสั้นจึงข้ามข้อความยาวได้ Homa ใช้หลัก SRPT หรือจัดงานที่เหลือน้อยกว่าให้เสร็จก่อน เพื่อป้องกันไม่ให้งานเล็กที่สำคัญต้องติดค้างหลังงานใหญ่
2. ให้ผู้รับควบคุม congestion
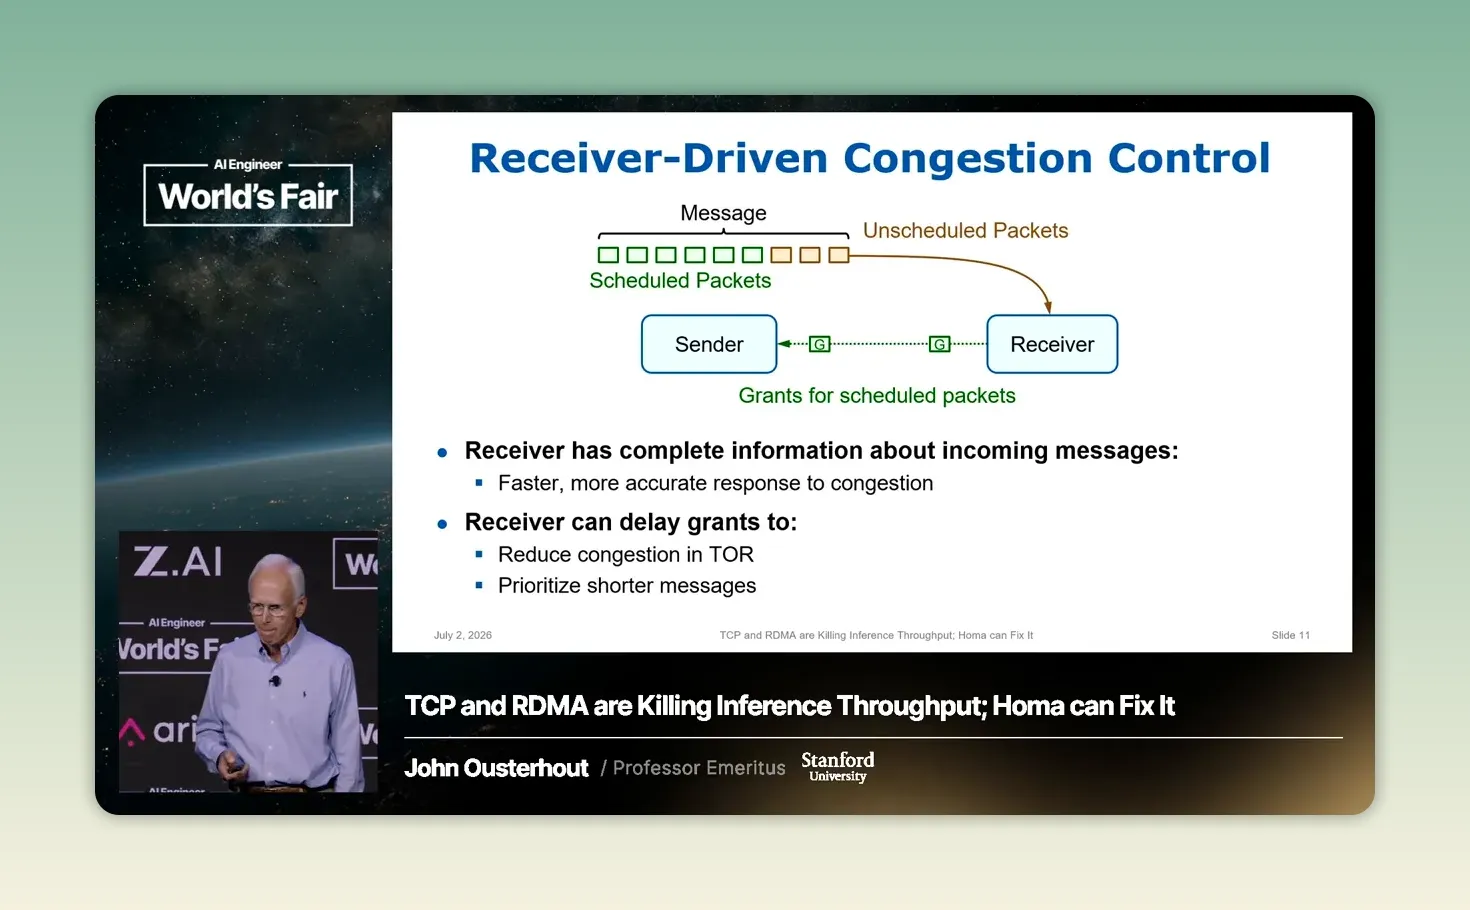
ผู้ส่งใน Homa จะส่งแพ็กเก็ตช่วงแรกของ message ก่อน ส่วนที่เหลือจะส่งได้ก็ต่อเมื่อผู้รับออก grant packet อนุญาต ผู้รับจึงเป็นฝ่ายกำหนดว่าข้อมูลชุดใดควรเดินต่อและเมื่อไร
หากมี 10 message กำลังวิ่งเข้ามา ผู้รับไม่จำเป็นต้องอนุญาตทั้งหมดพร้อมกัน เพราะจะทำให้คิวสะสมตรง switch ผู้รับเลือกหน่วงบางชุด และให้สิทธิ์กับ message ที่สั้นกว่าได้ก่อน นี่คือการย้ายอำนาจตัดสินใจไปไว้ใกล้จุดที่เห็นภาระจริงที่สุด
3. ใช้ priority queues ที่ switch มีอยู่แล้ว
switch ใน data center รุ่นใหม่มักมีหลายคิวต่อ egress port Homa ใช้คิวเหล่านี้แยกความสำคัญของแพ็กเก็ต งานใหญ่จะกองในคิวลำดับต่ำ ส่วนข้อความสั้นใช้คิวลำดับสูงกว่าและผ่านไปก่อน
แนวคิดนี้น่าสนใจในเชิงบริหารงานด้วยเช่นกัน งานทุกประเภทไม่ควรได้รับสิทธิ์เท่ากันเสมอไป หากทุกทีมส่งคำขอเข้าสู่ระบบกลางแบบเท่าเทียม งานเร่งด่วนของลูกค้าอาจถูกกลืนด้วยงานรายงาน batch ที่รอได้
อ่าน benchmark แบบไม่หลงกับตัวเลข
ในการทดสอบตัวอย่างที่ Ousterhout ใช้ปรับแต่งและประเมิน Homa เครื่องหลายเครื่องแลกเปลี่ยน message แบบ mixed workload ขนาดตั้งแต่ประมาณ 50 ไบต์ถึง 1 เมกะไบต์ โดย request และ response มีขนาดเท่ากัน กราฟวัด round-trip time แยกตามขนาด message และแสดงทั้ง P50 ซึ่งเป็นค่ามัธยฐาน กับ P99 ซึ่งเป็น tail latency
เขารายงานว่า P99 สำหรับข้อความสั้นของ Homa ต่ำกว่า 100 ไมโครวินาที ขณะที่ TCP มากกว่า 1 มิลลิวินาที โดยสไลด์ระบุค่าชัดเจนเป็น Homa 92 ไมโครวินาที เทียบกับ TCP 1.2 มิลลิวินาที ภายใต้ลิงก์ 100 Gbps และการใช้งานลิงก์ 80% จึงมี round-trip latency ต่ำกว่าประมาณ 13 เท่าใน benchmark ชุดนี้ ตัวเลขนี้ไม่ได้หมายความว่า AI application ทั้งระบบจะเร็วขึ้น 13 เท่า
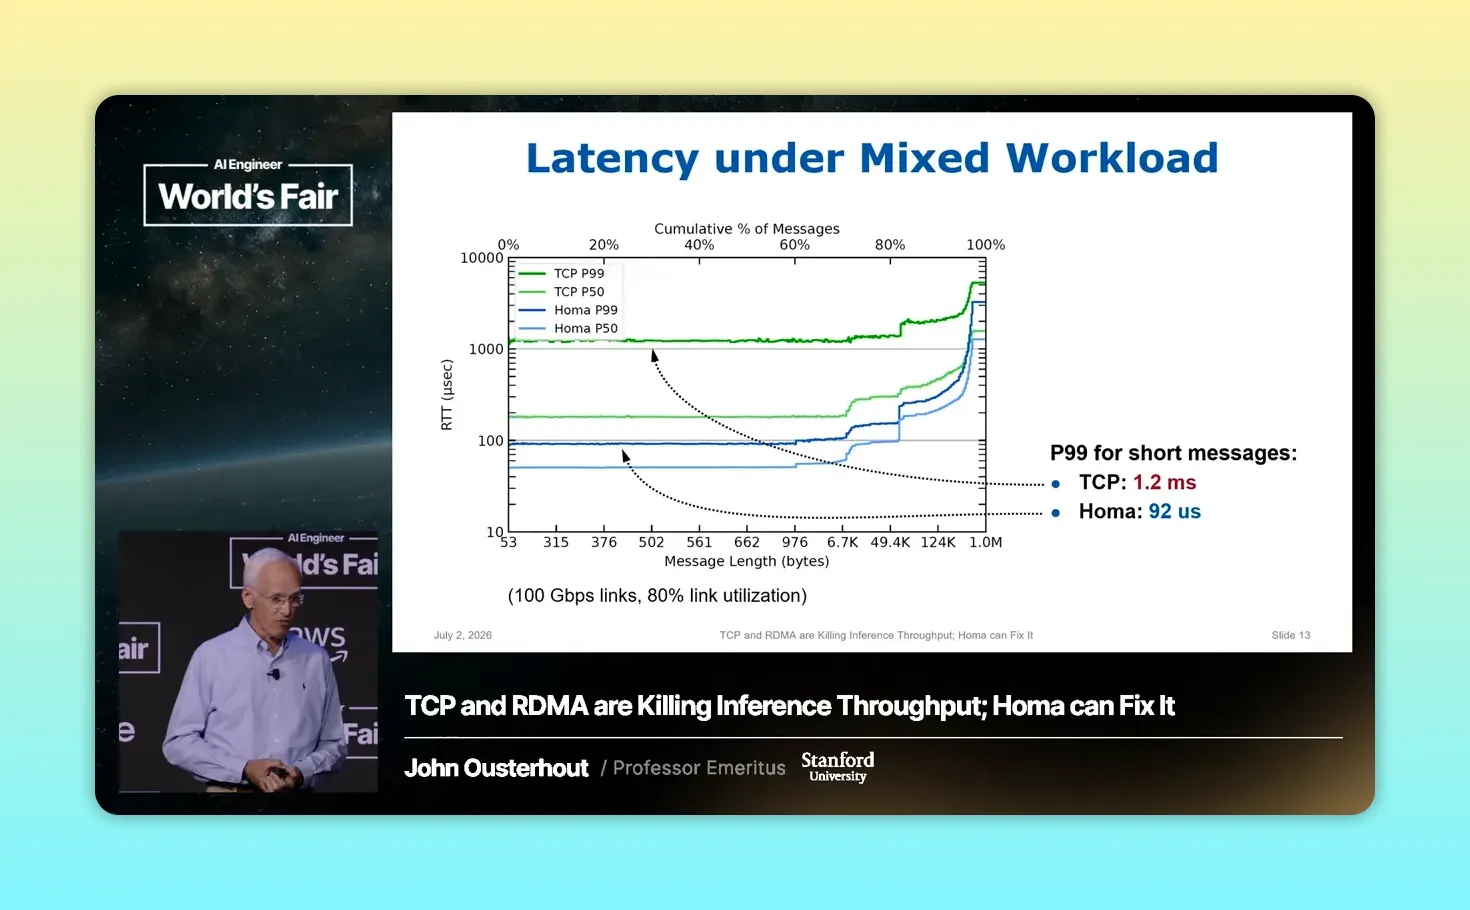
สำหรับ message ที่ยาวที่สุดในกราฟ Ousterhout รายงานว่า Homa ยังทำเวลาได้ดีกว่า TCP เกือบสองเท่า เขาอธิบายสั้นๆ ว่าเกี่ยวกับการจัดการแบบ run to completion เทียบกับ fair scheduling ของ TCP แต่ไม่ได้แจกแจงกลไกหรือเงื่อนไขการทดลองทั้งหมดในช่วงนี้
แต่ควรอ่านตัวเลขนี้อย่างมีสติ นี่คือ benchmark ของผู้พัฒนา protocol ไม่ใช่คำรับประกันว่าทุกองค์กรจะได้ผลเท่ากัน คลิปและสไลด์ระบุขนาดข้อความ วิธีวัด ความเร็วลิงก์ และการใช้งานลิงก์ แต่ไม่ได้ให้รายละเอียดครบ เช่น จำนวนเครื่อง รุ่นอุปกรณ์ และการตั้งค่า TCP จึงยังใช้เปรียบเทียบแทน workload ขององค์กรไม่ได้ ณ เวลาที่บรรยาย Ousterhout ระบุว่าเขาทำ Linux kernel module และกำลังดำเนินการนำเข้า upstream kernel ข้อมูลนี้เป็นสถานะในคลิป ไม่ใช่การยืนยันสถานะปัจจุบันหรือความพร้อมของระบบ production ทุกแบบ
ลิงก์อ่านเพิ่มเติมที่บทความต้นฉบับให้ไว้: เว็บไซต์ของ John Ousterhout ที่ Stanford และ RFC 3168 เรื่อง ECN ส่วนตัวเลข benchmark ข้างต้นอ้างจากคลิปของ Ousterhout
แนวทางนำไปตั้งคำถามกับระบบของธุรกิจ
ข้อเสนอในส่วนต่อไปนี้เป็นการประยุกต์ของบทความเดิมเพื่อช่วยวางแผนวัดและทดลอง ไม่ใช่ขั้นตอนติดตั้ง Homa หรือผลทดสอบ production จาก Stanford ควรหาสาเหตุจากระบบจริงก่อนเลือกวิธีแก้
- วัด P50 และ P99 แยกกัน: dashboard ที่มีแต่ latency เฉลี่ยซ่อนปัญหาสำคัญไว้ ให้ดูคำขอช้าที่สุดในช่วงใช้งานจริงด้วย
- ทำแผนที่ workflow ของ AI: ระบุทุกจุดตั้งแต่รับคำขอ, retrieval, cache, model, ฐานข้อมูล จนส่งคำตอบ เพื่อหาว่าความช้าเกิดก่อนหรือหลัง model
- แยกงานเร่งด่วนจากงาน batch: งานตอบลูกค้าและงานสรุปรายงานไม่ควรแย่งทรัพยากรชุดเดียวกันโดยไม่มีการจัดลำดับ
- ทดสอบช่วง peak load: ตรวจพฤติกรรมเมื่องานหลายชุดมาถึงพร้อมกัน เทียบกับการทดสอบทีละคำขอ โดยไม่สรุปว่าความช้าทั้งหมดคือ incast
- คุยกับทีม infra ด้วยคำถามที่ถูก: ถามว่า GPU idle เพราะ compute ไม่พอ หรือรอ synchronization และ network กันแน่
อาการที่ควรตรวจสอบเมื่อระบบ AI ตอบช้า
-
ปัญหา: ค่า latency เฉลี่ยดี แต่ลูกค้าบางรายเจอระบบค้าง
สาเหตุที่ควรตรวจสอบ: มี tail latency สูงในช่วงงานหนาแน่น
แนวทางตรวจสอบหรือทดลอง: เก็บ P95 และ P99 แยกตามช่วงเวลา, endpoint และขนาดคำขอ แล้วตรวจว่าความช้าสัมพันธ์กับ traffic spike หรือไม่ -
ปัญหา: เพิ่ม GPU แล้วเวลาตอบกลับแทบไม่ดีขึ้น
สาเหตุที่ควรตรวจสอบ: งานอาจติดที่ cache, database หรือการรอประสานงานระหว่าง service
แนวทางตรวจสอบหรือทดลอง: ทำ tracing ตลอด workflow, แยกเวลาของ compute ออกจากเวลารอ network และเลือกแก้จุดที่ใช้เวลามากสุดก่อน -
ปัญหา: ระบบช้าหนักเมื่อเริ่มงาน batch พร้อมกับ chatbot
สาเหตุที่ควรตรวจสอบ: งานจำนวนมากแย่ง endpoint หรือทรัพยากรชุดเดียวกัน
แนวทางตรวจสอบหรือทดลอง: แยก queue, จำกัดอัตราการส่งงาน batch และกำหนดลำดับความสำคัญให้งานที่กระทบลูกค้า -
ปัญหา: ทีมรีบจะเปลี่ยน protocol เพราะเห็น benchmark ของ Homa
สาเหตุที่ควรตรวจสอบ: นำผลทดสอบเฉพาะทางมาใช้แทนการวัดระบบจริง
แนวทางตรวจสอบหรือทดลอง: ตั้ง baseline ของระบบเดิม, ทำ pilot ใน workload ที่มีข้อความสั้นและการประสานงานสูง แล้วเปรียบเทียบต้นทุนกับผลลัพธ์
การต่อยอดจากบทเรียน Homa
- สร้าง SLO สำหรับ AI experience: กำหนดเป้าหมายเวลาเริ่มตอบและเวลาจบคำตอบ รวมถึง P99 แทนการวัดแค่ค่าเฉลี่ย
- ออกแบบ agent workflow ใหม่: ลดจำนวนจุดที่ต้องรอพร้อมกัน และรวมคำสั่งตรวจสอบ metadata ที่ทำได้ในรอบเดียว
- ประเมินสถาปัตยกรรมก่อนขยาย cluster: เมื่อใช้ GPU หลาย node มากขึ้น ให้ประเมิน network และ synchronization ควบคู่กับจำนวน GPU เสมอ
สรุป Checklist ทั้งหมดก่อนขยายระบบ AI Cluster
- ☐ แยกประเภท workload ว่าเป็นงานส่งข้อมูลใหญ่หรือข้อความสั้นถี่
- ☐ วัด latency ทั้ง P50, P95 และ P99 ในช่วงใช้งานจริง
- ☐ ตรวจเวลาที่ GPU หรือ service ว่างรอ synchronization
- ☐ ทำ tracing หาเส้นทางที่คำขอช้าที่สุด
- ☐ ทดสอบระบบเมื่อมีคำขอหลายชุดเข้าสู่ปลายทางเดียวกันพร้อมกัน
- ☐ แยกงานตอบลูกค้าออกจากงาน batch และกำหนดลำดับความสำคัญ
- ☐ อย่าตัดสินใจเปลี่ยน TCP, RDMA หรือ protocol ใดจาก benchmark เพียงชุดเดียว
- ☐ ทำ pilot และวัดผลต่อธุรกิจ ทั้งเวลาตอบกลับ, ต้นทุน GPU และความเสถียรของระบบ
บทเรียนจากข้อเสนอของ Ousterhout คือ เมื่อ workload มีข้อความสั้นและต้องรอประสานงานข้ามหลาย node มากขึ้น การวัด tail latency จะช่วยให้เห็นต้นทุนการรอที่ค่า throughput หรือค่าเฉลี่ยเพียงอย่างเดียวอาจไม่บอก Homa เป็นแนวทางที่เขานำเสนอให้ทดลองกับปัญหานี้ ส่วนการตัดสินใจของแต่ละองค์กรยังต้องเริ่มจากการวัดคอขวดและทดสอบกับ workload ของตัวเอง
ที่มา: The End of TCP for AI Clusters — John Ousterhout, Stanford ช่อง AI Engineer โดยเฉพาะช่วง 02:19–05:34 เรื่อง workload และการรอประสานงาน, 06:01–11:03 เรื่อง incast และ TCP/RoCE, 11:11–15:49 เรื่อง Homa และ 15:52–17:23 เรื่อง benchmark
วันที่ในรายการบทความต้นทาง VideoToBlog: 17 กันยายน 2026 เป็นวันที่บทความต้นทาง ไม่ใช่วันที่เผยแพร่วิดีโอที่ยืนยันแล้ว