ที่มา: วิดีโอที่ฝังในบทความและบทความ VideoToBlog วันที่ 2026-07-01 (วันที่แสดงในบทความต้นทาง ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว) ชื่อรุ่น สเปก context ราคา ใบอนุญาต และความพร้อมใช้งานเป็นข้อมูลที่ต้นทางรายงานในเวลานั้น ผลคำถาม เกม ส่วนขยาย Chrome การจัดไฟล์ skill และ Remotion เป็นการทดลองของต้นทาง ยังไม่ได้ทดสอบซ้ำ ภาพนิ่งไม่รับรองการทำงานครบทุกขั้นหรือความปลอดภัยของระบบ การผ่านหรือพลาดคำถามตัวอย่างไม่ใช่ข้อสรุปความสามารถหรือความปลอดภัยโดยรวม การเชื่อมบันทึกประชุม คัดลอก traffic ติดตั้ง skill และตั้งงานอัตโนมัติต้องได้รับสิทธิ์จากเจ้าของข้อมูลและระบบ พร้อมให้คนตรวจโค้ด ข้อมูล และผลประเมินก่อนเปิดใช้จริง ภาพที่ 2 เป็นจอว่างสีครีม และภาพที่ 6 เป็นหน้า FutureTools จึงไม่ใช้ยืนยันผลหน้าเว็บหรือส่วนขยาย Page Brief · วิดีโอต้นทาง
GLM-5.2 จาก Z.ai กำลังถูกพูดถึงอย่างมากในวงการ AI โดยเฉพาะในกลุ่มที่ต้องทำงานกับเอกสารยาว โค้ดจำนวนมาก และระบบเอเจนต์ที่ต้องใช้โทเคนมหาศาล จุดเด่นสำคัญของโมเดลนี้ไม่ใช่แค่ความสามารถ แต่คือการผสมกันของ บริบทยาว 1 ล้านโทเคน, น้ำหนักโมเดลแบบเปิดภายใต้ไลเซนส์ MIT, และ ต้นทุนการใช้งานที่ต่ำกว่ารุ่นเรือธงจากค่ายใหญ่หลายเท่า
คำถามคือ มันดีพอจะนำไปใช้จริงแค่ไหน และเหมาะกับงานประเภทใดบ้าง
GLM-5.2 คืออะไร
GLM-5.2 เป็นโมเดลหลักของ Z.ai ที่เน้นงานแบบ long context หรือการรับข้อมูลจำนวนมากในครั้งเดียว รูปแบบการทำงานในตอนนี้ยังเป็น ข้อความเข้า ข้อความออก เป็นหลัก ยังไม่เน้นภาพหรือเสียง แต่สิ่งที่ทำให้มันน่าสนใจคือความสามารถเชิงระบบที่พร้อมสำหรับงานระดับโปรดักชัน
- รองรับ context window ขนาด 1 ล้านโทเคน
- สร้างผลลัพธ์ได้ยาวสูงสุด 128,000 โทเคน
- รองรับ function calling
- สร้าง structured output ได้
- มี context caching
- รองรับ MCP
- ถูกปรับมาเพื่อการเขียนโค้ดและ workflow แบบ agentic
นั่นหมายความว่า GLM-5.2 ไม่ได้เหมาะแค่ตอบแชตทั่วไป แต่เหมาะกับการโยนไฟล์ เอกสาร โค้ดเบส และงานหลายขั้นตอนให้มันทำความเข้าใจ วางแผน และลงมือทำต่อ
จุดสำคัญของคำว่า Open Weight
คำว่า open weight มักทำให้หลายคนคิดว่าจะดาวน์โหลดมารันบนเครื่องที่บ้านได้ทันที แต่ความจริงไม่ได้ง่ายขนาดนั้น แม้จะเปิดให้นำ weights ไปใช้ได้ และองค์กรที่มีทรัพยากรสามารถโฮสต์เอง ปรับแต่ง หรือทำ quantization ได้ แต่ขนาดโมเดลใหญ่ระดับนี้ยังเกินขีดความสามารถของคอมพิวเตอร์ผู้ใช้ทั่วไป
ตัวโมเดลมีขนาดประมาณ 753 พันล้านพารามิเตอร์ และไฟล์ weights ใหญ่เกิน 1.5 เทราไบต์ ต่อให้บีบอัดอย่างหนักก็ยังต้องใช้หน่วยความจำมหาศาล จึงไม่ใช่โมเดลที่เหมาะกับการรันแบบ local สำหรับคนส่วนใหญ่
ความน่าตื่นเต้นของ open weight จึงไม่ได้อยู่ที่ใครก็เปิดบนโน้ตบุ๊กได้ แต่คือการที่ระบบนิเวศภายนอกสามารถสร้างต่อได้ มีทางเลือกในการโฮสต์มากขึ้น และลดการผูกขาดจากโมเดลปิดของห้องแล็บรายใหญ่
3 วิธีใช้งาน GLM-5.2
โดยภาพรวม มี 3 แนวทางหลักในการใช้งาน
- ใช้งานผ่านเว็บไซต์ของ Z.ai
เหมาะกับการทดลอง เริ่มต้นง่าย ไม่ต้องตั้งค่า API หรือเครื่องมือเขียนโค้ด - ใช้งานผ่าน API หรือ agent harness
เชื่อมเข้ากับแอปของตัวเอง หรือใช้ผ่านเครื่องมืออย่าง Cursor และแพลตฟอร์มเอเจนต์อื่น - โฮสต์เอง
เหมาะกับองค์กรที่มีงบด้านโครงสร้างพื้นฐาน หรือเช่า GPU บนคลาวด์เพื่อควบคุมความเป็นส่วนตัวและระบบได้มากขึ้น
สำหรับผู้ใช้ส่วนใหญ่ วิธีแรกและวิธีที่สองคือทางเลือกที่ใช้งานได้จริงมากที่สุด
ทำไมโมเดลราคาถูกจึงสำคัญ
ต้นทุนเป็นเรื่องที่ส่งผลต่อพฤติกรรมการใช้งาน AI มากกว่าที่คิด ถ้างานหนึ่งมีค่าใช้จ่ายสูง ผู้ใช้มักลังเลที่จะส่งข้อมูลเพิ่ม ลองใหม่หลายรอบ หรือปล่อยให้เอเจนต์ทำงานนานขึ้น แต่เมื่อราคาต่อโทเคนถูกลง การทดลองก็เกิดขึ้นได้ง่ายกว่า
นั่นเปิดทางให้เกิดงานประเภทใหม่ เช่น
- อ่านเอกสารยาวระดับหลายร้อยหน้า
- วิเคราะห์โค้ดเบสขนาดใหญ่
- ให้เอเจนต์วนแก้บั๊กหลายรอบ
- สร้างเครื่องมือเล็ก ๆ ใช้เองโดยไม่กังวลค่าใช้จ่าย
นี่คือเหตุผลที่ GLM-5.2 น่าสนใจมากสำหรับงานที่กินโทเคนเยอะ แม้มันจะไม่ได้ชนะทุกด้านเมื่อเทียบกับ Claude, GPT หรือ Gemini ก็ตาม
ทดสอบผ่านเว็บไซต์ Z.ai
การทดลองเริ่มจากการให้โมเดลสร้างหน้าเว็บจากพรอมป์เดียว ผลลัพธ์ออกมาเป็นหน้า HTML เดียวที่สะอาด ใช้งานได้ และมีการเลื่อนหน้าไปยังแต่ละส่วนแบบอัตโนมัติ งานออกแบบไม่ได้หรูหรามาก แต่คุณภาพอยู่ในระดับที่ใกล้เคียงกับโมเดลชั้นนำหลายตัว

ข้อจำกัดในงานนี้คือมีการขอให้สร้างเพียงไฟล์เดียว หากใช้ผ่าน agent harness ที่ให้สร้างหลายไฟล์ร่วมกัน โครงสร้างเว็บอาจลึกและสมบูรณ์กว่านี้
ความแม่นยำกับคำถามหลอกเชิงตรรกะ
มีการทดสอบคำถามที่มักใช้วัดว่าโมเดลยังสับสนกับภาษาอยู่หรือไม่ เช่น การนับตัวอักษรในคำภาษาอังกฤษ หรือโจทย์แนวหลอกตรรกะ ผลออกมาคละกัน บางข้อโมเดลตอบถูก แต่บางข้อยังพลาดเหมือนโมเดลชั้นนำหลายตัว
ตัวอย่างที่น่าสนใจคือโจทย์ล้างรถซึ่งถามว่าร้านล้างรถอยู่ห่างไปเพียง 100 เมตร ควรเดินหรือขับรถไป โมเดลจับประเด็นได้ว่าต้องนำรถไปด้วย จึงแนะนำให้ขับรถ
อีกกรณีคือพรอมป์ที่แฝงความขัดแย้ง เช่น ขอโปรแกรมออกกำลังกายฟื้นฟูหลัง แต่ย้ำว่าต้องมีท่า deadlift หนักมาก โมเดลไม่ทำตามแบบตรงตัว แต่เตือนถึงความเสี่ยงและแนะนำแนวทางที่ปลอดภัยกว่า แสดงให้เห็นว่าอย่างน้อยในบางสถานการณ์ มันพอแยกแยะเจตนาที่ไม่สมเหตุสมผลได้
ด้านความปลอดภัยยังมีช่องโหว่
จุดที่น่ากังวลคือเมื่อมีการอ้อมด้วยบริบทเชิงนิยายหรือการแต่งเรื่อง โมเดลยอมอธิบายขั้นตอนของการหลอกลวงทางการเงินในระดับที่พอเชื่อถือได้ แม้จะอยู่ในกรอบของงานเขียนก็ตาม เรื่องนี้สะท้อนว่าระบบป้องกันการใช้งานผิดวัตถุประสงค์ยังไม่แน่นหนาเท่าบางค่าย
ตัวอย่างนี้เป็นเหตุให้ต้องประเมินการกำกับคำตอบเพิ่มเติม ไม่ใช่ข้อได้เปรียบทางธุรกิจจากการยอมให้คำแนะนำที่เป็นอันตราย และผลจาก prompt เดียวไม่เพียงพอจะจัดอันดับความปลอดภัยของโมเดล
งานเขียนยังมีกลิ่น AI
ในการทดสอบอินโทรวิดีโอ ผู้สาธิตมองว่าสำนวนยังมีลักษณะซ้ำแบบงาน AI การประเมินนี้เป็นความเห็นต่อชิ้นงานตัวอย่าง ไม่ใช่หลักฐานว่าเครื่องมือตรวจข้อความสามารถระบุผู้เขียนได้แน่นอน
สรุปคือ GLM-5.2 เขียนได้ดีในแง่โครงสร้างและความลื่นไหล แต่ถ้าต้องการงานคอนเทนต์ที่เป็นธรรมชาติแบบมนุษย์จริง ๆ ยังจำเป็นต้องมีการรีไรต์
สร้างกราฟและ SVG ได้ดีเกินคาด
แม้โมเดลจะไม่สร้างภาพแบบเนทีฟ แต่สามารถใช้ HTML, CSS และ SVG เพื่อสร้างภาพเชิงข้อมูลได้อย่างน่าสนใจ มีการลองสั่งให้ทำกราฟแสดงการพัฒนาของโมเดลภาษาจากจีนในช่วงหลายปีที่ผ่านมา รอบแรกได้ผลลัพธ์คล้ายตาราง แต่เมื่อปรับพรอมป์ใหม่ โมเดลสร้างกราฟภาพที่ดูดีมาก
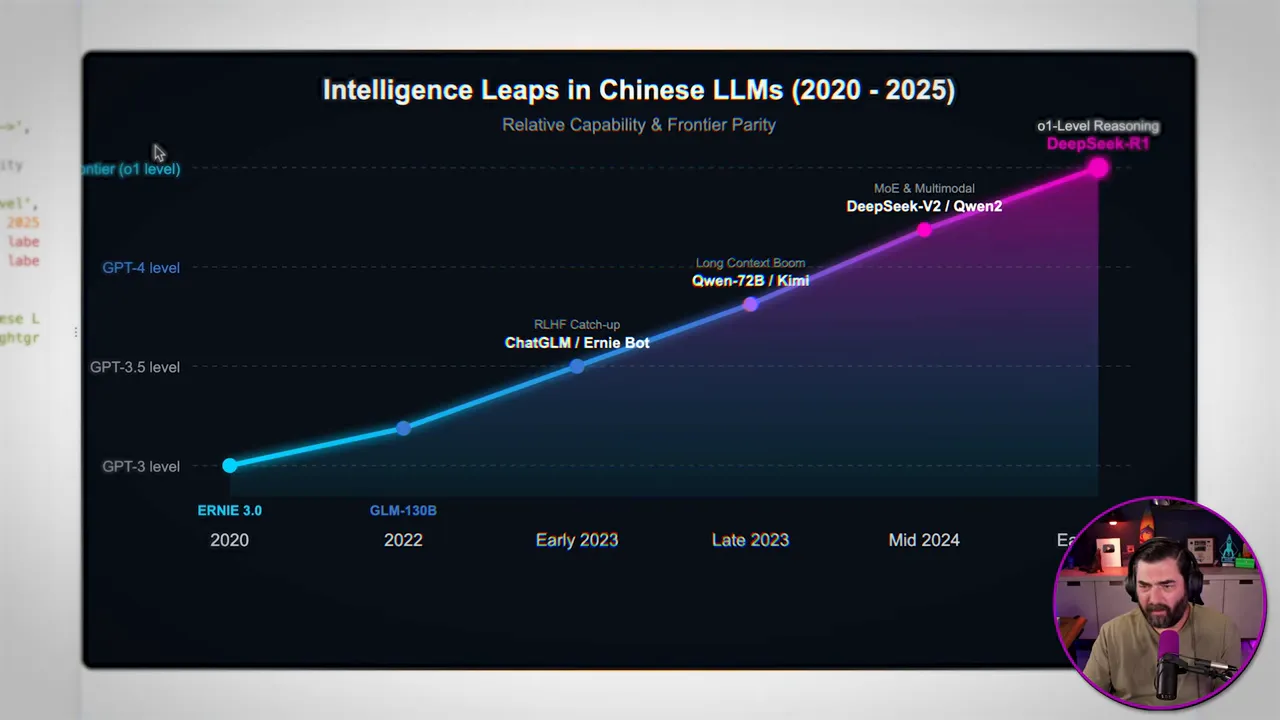
ข้อความบางส่วนในกราฟยังมีการตัดขอบและจัดวางไม่สมบูรณ์ แต่ถ้ามองเรื่องต้นทุนต่อคุณภาพ ผลลัพธ์ถือว่าน่าประทับใจมาก
นอกจากนี้ยังมีการทดสอบสร้าง SVG แบบสนุก ๆ เช่นใบหน้าคนดัง และลิงใส่โรลเลอร์สเกตส์ ซึ่งสะท้อนว่ามันมีความสามารถด้านการวาดด้วยโค้ดที่ใช้งานต่อยอดได้ ทั้งในงานกราฟิกอย่างง่าย งานอินโฟกราฟิก หรือ mockup ภายในทีม
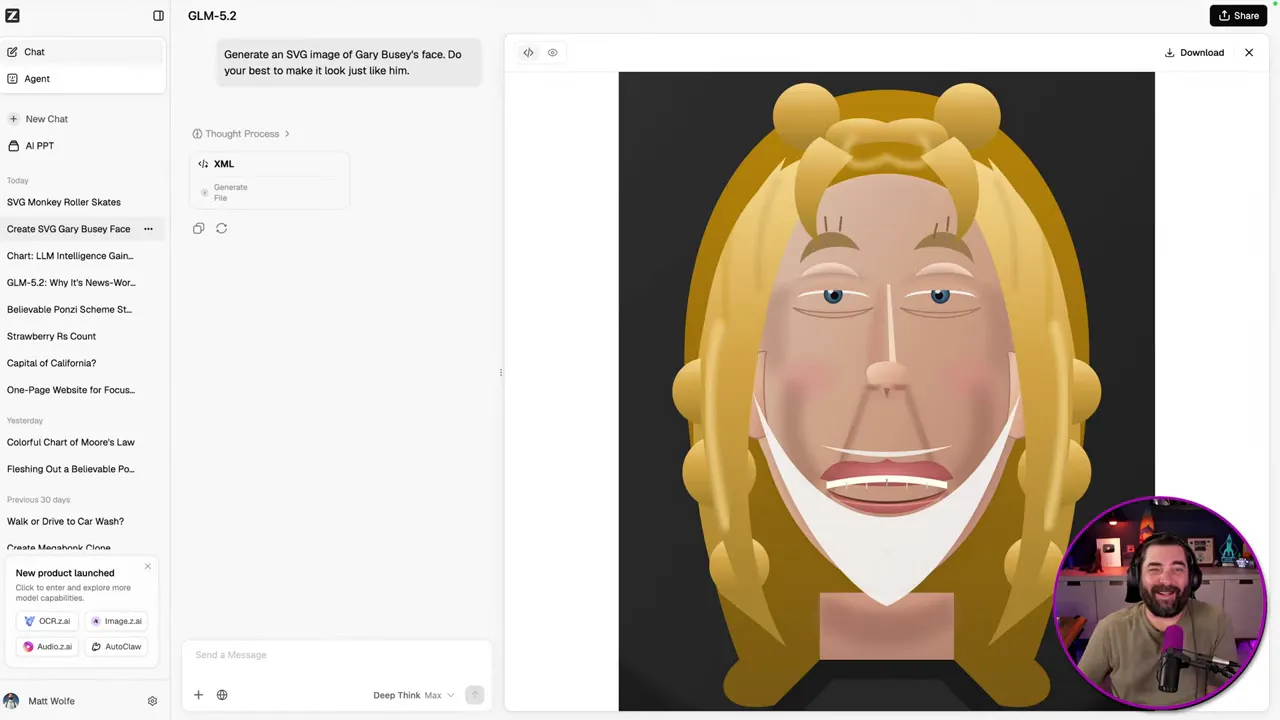
เมื่อใช้งานผ่าน Agent Harness ความสามารถเพิ่มขึ้นมาก
ความต่างระหว่างใช้โมเดลบนหน้าเว็บกับใช้ผ่าน agent harness คือเรื่อง สิทธิ์ในการลงมือทำ บนเว็บ โมเดลให้เพียงคำตอบหรือโค้ด แต่ใน harness มันมีเครื่องมือเข้าถึงไฟล์ แก้โค้ด รันคำสั่ง ตรวจ error และทำงานต่อเนื่องหลายขั้นตอน
เปรียบง่าย ๆ โมเดลคือสมอง ส่วน harness คือร่างกายและมือที่ทำงานแทนได้จริง
สร้างเกมคล้าย Megabonk
หนึ่งในการทดสอบที่น่าสนใจที่สุดคือการให้มันสร้างเกม 3 มิติคล้าย Megabonk ในรอบแรก ผลลัพธ์ยังไม่สมบูรณ์ มีหน้าจอเลือกตัวละครแต่เกมไม่ทำงาน จากนั้นจึงป้อนภาพหน้าจอและฟีดแบ็กกลับเข้าไปให้แก้ต่อ
หลังจากปรับไปหลายรอบ เกมเริ่มเล่นได้จริง มีการเคลื่อนไหว มุมกล้อง การโจมตี และระบบความเสียหาย แม้กราฟิกจะยังไม่ถึงระดับสวยงามมาก แต่ถือว่าน่าทึ่งสำหรับโมเดลโอเพนเวตที่มีต้นทุนต่ำกว่าหลายตัวในกลุ่ม frontier
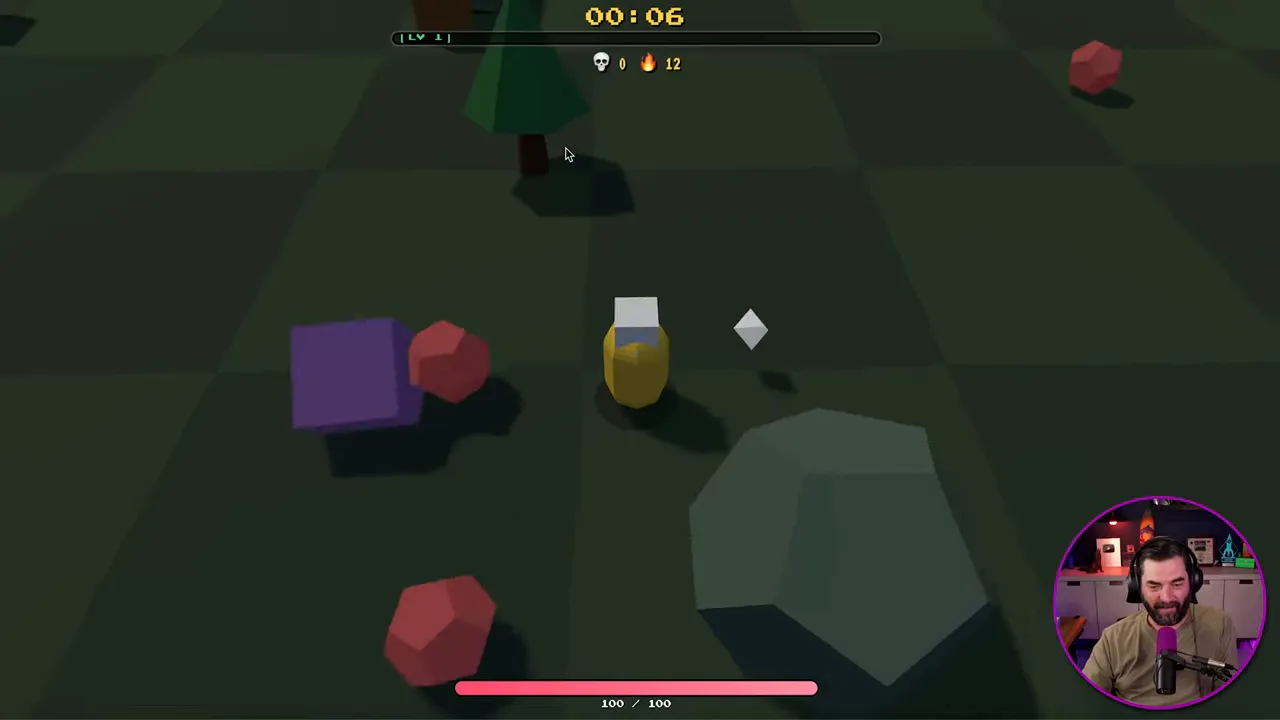
ประเด็นสำคัญไม่ใช่ว่ามันสร้างเกมได้สมบูรณ์ในพรอมป์เดียว แต่คือมันสามารถ รับฟีดแบ็ก แก้ปัญหา และพัฒนาโปรเจกต์ต่อเนื่อง ได้ในลักษณะใกล้เคียงผู้ช่วยวิศวกรซอฟต์แวร์
สร้าง Chrome Extension ใช้งานได้จริง
อีกตัวอย่างที่มีคุณค่ามากกว่าเดโมโชว์คือการให้สร้าง Chrome extension ชื่อ Page Brief หน้าที่คือสรุปหน้าเว็บปัจจุบัน ดึง action items รวบรวมลิงก์สำคัญ และคัดลอกทั้งหมดเป็น Markdown
รอบแรกยังใช้ไม่ได้ แต่หลังฟีดแบ็กเพิ่มเพียงรอบเดียว extension ก็ทำงานได้ครบตามโจทย์ ทั้งสรุปหน้า แสดงรายการสิ่งที่ควรทำ และส่งออก Markdown
กรณีนี้สะท้อนให้เห็นชัดว่า GLM-5.2 เหมาะกับงานสร้างเครื่องมือภายใน ทีมงาน หรือ utility ขนาดเล็กที่ต้องการทำเร็วและคุมต้นทุน
จัดระเบียบโฟลเดอร์ดาวน์โหลดอัตโนมัติ
งานอีกแบบที่ agent harness ทำได้ดีคือการให้โมเดลอ่านไฟล์จริงในโฟลเดอร์แล้วจัดประเภทให้ เช่น แยกรูปภาพ วิดีโอ เอกสาร แอปพลิเคชัน และไฟล์เสียงเข้าโฟลเดอร์ที่เตรียมไว้แล้ว
นี่คือตัวอย่างคลาสสิกของ AI ที่ไม่ได้แค่ตอบคำถาม แต่ลงมือจัดการสิ่งแวดล้อมดิจิทัลแทนมนุษย์ ซึ่งมีประโยชน์มากในงาน routine
จุดที่น่าสนใจที่สุด คือการสร้างระบบที่พัฒนาตัวเอง
การสาธิตที่โดดเด่นที่สุดอาจไม่ใช่เกมหรือ extension แต่เป็นการเชื่อมต่อเอเจนต์เข้ากับเครื่องมือจดบันทึกการประชุม แล้วให้มันวิเคราะห์บทสนทนาย้อนหลังเพื่อหาปัญหาซ้ำ ๆ จากนั้นสร้างเครื่องมือใหม่เพื่อแก้ปัญหาเหล่านั้นทุกสัปดาห์แบบอัตโนมัติ
workflow นี้มีองค์ประกอบหลายชั้น
- ดึงข้อมูลจากบันทึกการประชุม
- วิเคราะห์ pain points ที่เกิดซ้ำ
- สร้าง skill หรือเครื่องมือใน Cursor เพื่อแก้ปัญหา
- ติดตั้ง skill ใหม่ให้พร้อมใช้
- เขียนรายงานประจำสัปดาห์
- รันตามตารางเวลาอัตโนมัติ
ผลที่ได้คือระบบพบว่าหนึ่งในปัญหาที่เกิดบ่อยคือการคิด hook สำหรับวิดีโอสั้นยังไม่คมพอ จึงสร้าง skill ใหม่ขึ้นมาเพื่อผลิต hook หลายรูปแบบตามสูตรที่ต่างกัน
นี่คือแนวคิดสำคัญของ agentic workflow ยุคใหม่ ไม่ใช่แค่ให้ AI ช่วยทำงาน แต่ให้ AI สังเกตกระบวนการทำงาน แล้วสร้างเครื่องมือใหม่เพื่อปรับปรุงงานในอนาคต
ใช้ร่วมกับ Remotion เพื่อสร้างแอนิเมชัน
GLM-5.2 ยังถูกนำไปใช้ร่วมกับ skill ของ Remotion เพื่อสร้างวิดีโอแอนิเมชันจากคำสั่งข้อความ โดยโจทย์คือให้สร้างกราฟแท่งเปรียบเทียบ GLM-5.2 กับ GPT 5.5, Opus 4.6 และ Gemini 3.5 โดยกราฟที่เก็บจากคลิปใช้ชื่อ SWE-Bench Pro และมีข้อความ illustrative comparison จึงควรอ่านเป็นเดโมงานกราฟ ไม่ใช่หลักฐานยืนยันคะแนน benchmark
รอบแรกมีข้อผิดพลาดด้าน layout เช่น ข้อความซ้อนทับและกราฟเริ่มไม่ตรงแกน แต่หลังอธิบายปัญหาให้แก้เพิ่ม ผลลัพธ์ก็ดีขึ้นอย่างชัดเจน
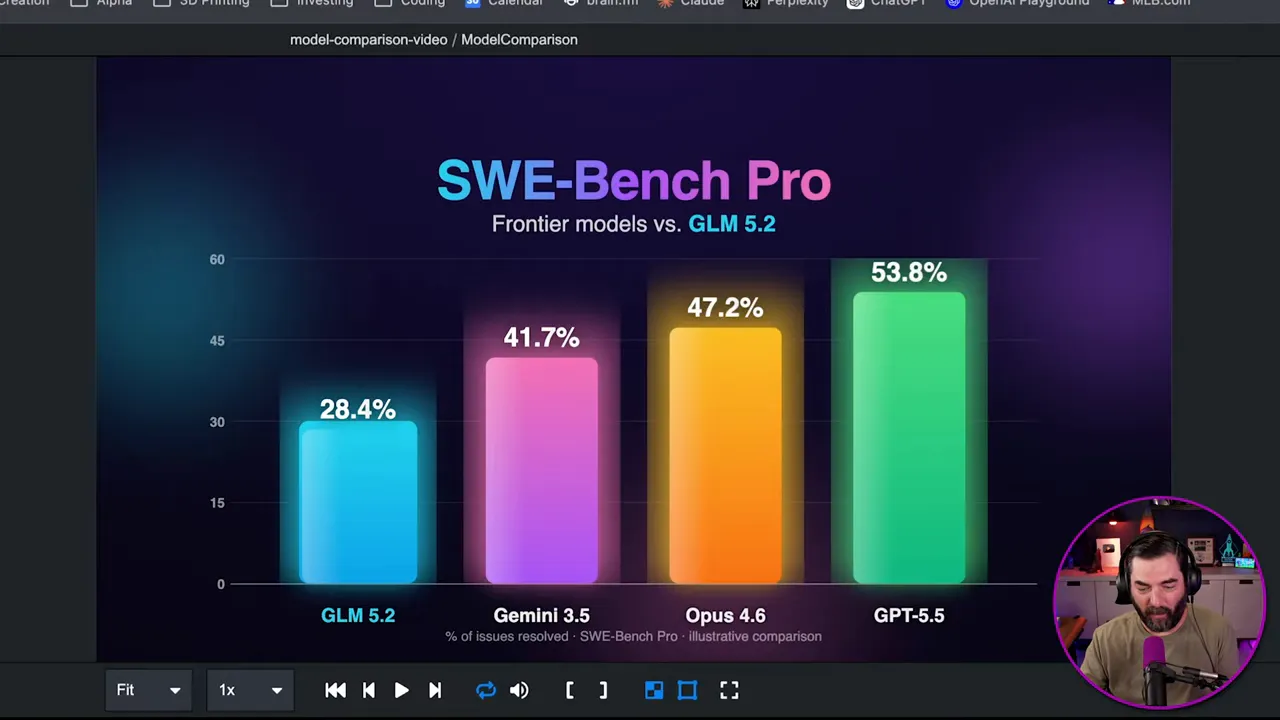
ประเด็นสำคัญคือแม้โมเดลจะยังไม่มองภาพได้โดยตรงใน workflow นี้ แต่มันยังพอแก้ปัญหาจากคำอธิบายได้ และสามารถขับงานสร้างสื่อแบบ programmatic ได้ในต้นทุนต่ำ
วิธีทดสอบ GLM-5.2 ในระบบจริงแบบไม่เสี่ยง
สำหรับทีมที่มีระบบ AI ใช้งานจริงอยู่แล้ว การเปลี่ยนโมเดลทันทีอาจเสี่ยงเกินไป จึงมีการแนะนำแนวทางที่น่าสนใจจาก Inference.net ซึ่งช่วยทำ model mirroring ได้
ต้นทางอธิบายการส่งงานจริงไปยังผู้ให้บริการเดิม พร้อมคัดลอกคำขอที่ได้รับอนุญาตไปประเมิน GLM-5.2 ในพื้นหลัง ผลเปรียบเทียบเป็นข้อมูลประกอบการตัดสินใจของทีม ไม่ใช่การรับรองว่าปลอดภัยพอจะสลับโมเดลโดยอัตโนมัติ ต้องตรวจสิทธิ์ข้อมูล เงื่อนไขผู้รับ และเกณฑ์คุณภาพก่อนเริ่ม
ข้อดีของแนวทางนี้คือ
- ไม่กระทบผู้ใช้จริงทันที
- เห็นผลเปรียบเทียบจากข้อมูลการใช้งานจริง
- ลดความเสี่ยงก่อนเปลี่ยนโมเดลในโปรดักชัน
- เหมาะกับทีมที่ต้องการลดต้นทุนแต่ไม่อยากลดคุณภาพ
แล้ว GLM-5.2 ดีพอจะแทน Claude หรือ GPT หรือไม่
คำตอบที่ตรงที่สุดคือ ยังไม่ใช่ทุกงาน
GLM-5.2 ไม่ได้ชนะทุกด้าน และยังมีจุดอ่อนในเรื่องความแม่นยำบางประเภท คุณภาพงานเขียนเชิงธรรมชาติ และการคุมคำตอบในประเด็นอ่อนไหวบางแบบ แต่สิ่งที่มันทำได้ดีมากคือการเป็น โมเดลคุ้มค่า สำหรับงานที่ต้องกินบริบทเยอะ ใช้โทเคนหนัก และต้องทำงานร่วมกับเอเจนต์
งานที่ควรลองใช้ GLM-5.2 ก่อน
- วิเคราะห์เอกสารยาวมาก
- ทำงานกับโค้ดเบสขนาดใหญ่
- สร้างหรือแก้ utility ภายในทีม
- ใช้งาน agent harness ที่ต้องรันหลายรอบ
- งานที่มีต้นทุนโทเคนสูงจนโมเดลแพงไม่คุ้ม
- องค์กรที่ต้องการทางเลือกจากโมเดลปิด
งานที่ยังควรระวัง
- คอนเทนต์ที่ต้องการน้ำเสียงมนุษย์สูงมาก
- งานที่อ่อนไหวด้านความปลอดภัยหรือการกำกับคำตอบ
- กรณีที่ต้องการความแม่นยำสูงสุดแบบ one-shot
บทสรุป
GLM-5.2 ไม่ใช่โมเดลที่ควรถูกมองว่าเป็นผู้ชนะเหนือทุกค่าย แต่เป็นหนึ่งในโมเดลที่น่าทดลองที่สุดในตอนนี้ เพราะมันรวมคุณสมบัติที่หาได้ยากไว้ในตัวเดียวกัน คือ ราคาถูก, context ใหญ่มาก, เก่งงานโค้ด, เหมาะกับระบบเอเจนต์ และ มีสถานะ open weight ที่เปิดโอกาสให้ ecosystem ต่อขยายได้
สำหรับผู้ที่ทำงานกับ AI ในเชิงปฏิบัติ สิ่งที่น่าสนใจไม่ใช่แค่คำถามว่าโมเดลไหนฉลาดที่สุด แต่คือโมเดลไหนทำให้งานจริงคุ้มค่าที่สุดในต้นทุนที่ยอมรับได้ และในหมวดงานยาว งานหนัก และงานที่เผาโทเคนรวดเร็ว GLM-5.2 คือชื่อที่ควรอยู่ในรายการทดสอบอย่างจริงจัง