วันที่บทความต้นทางใน VTB: 16 กันยายน 2026 (2026-09-16) · วันที่อัปโหลดวิดีโอยังไม่ได้รับการยืนยัน
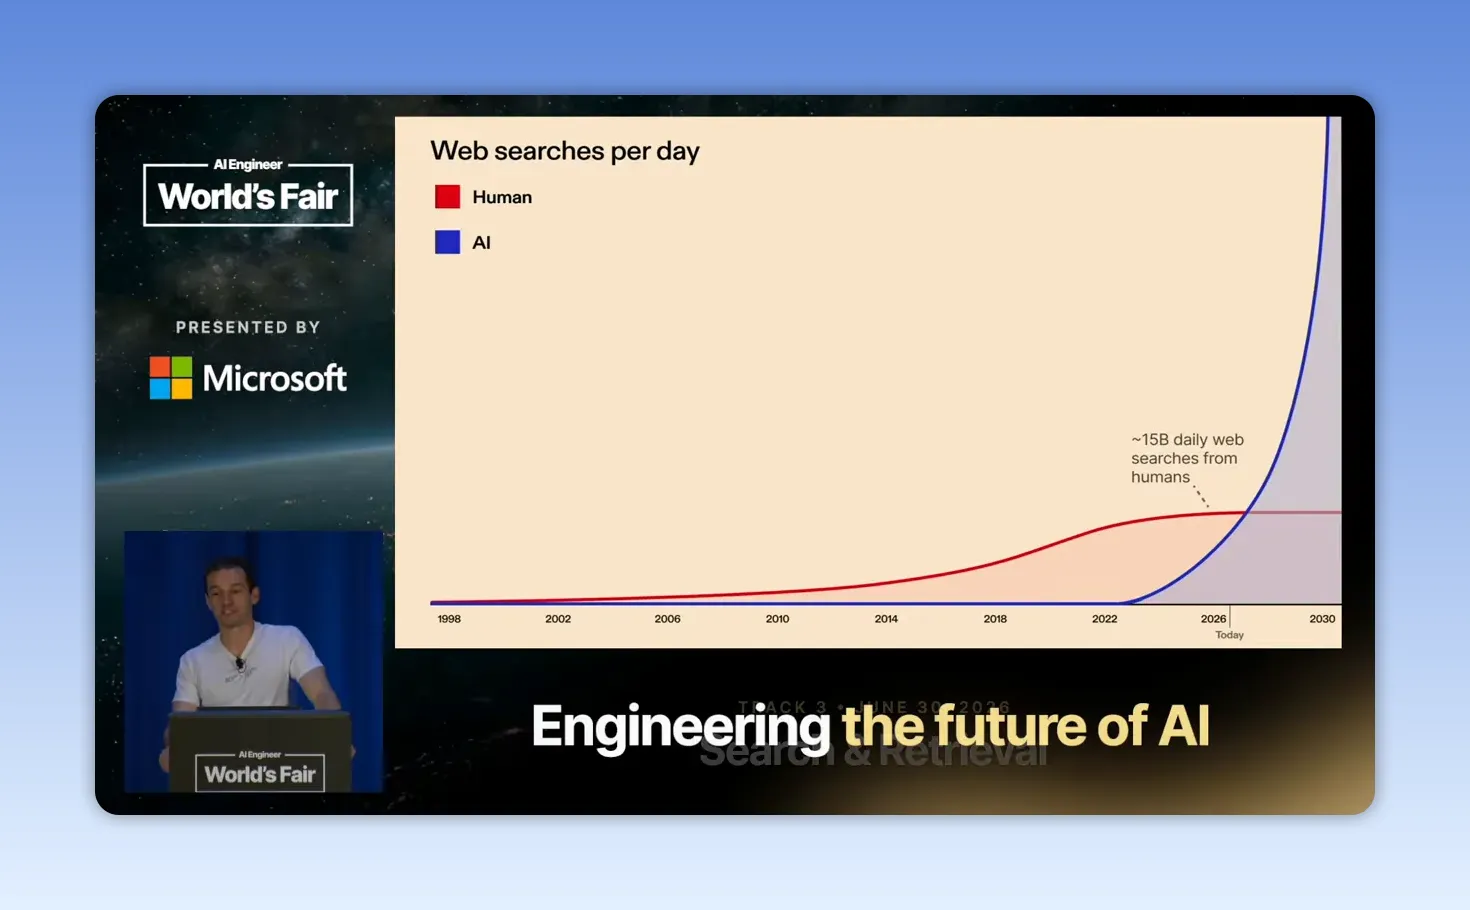
บทความนี้ถ่ายทอดมุมมองและการสาธิตของ Will Bryk จาก Exa ในวิดีโอต้นทาง กราฟจำนวนการค้นหาและแนวคิด Perfect Information เป็นการคาดการณ์หรือเป้าหมายของผู้บรรยาย ไม่ใช่ข้อมูลยืนยันอนาคต ความสามารถของบริการอ้างตามคลิป และตัวอย่างธุรกิจไทยเป็นการประยุกต์ของบทความเดิม
เมื่อ AI เริ่มค้นหาข้อมูลแทนคน ปัญหาไม่ได้อยู่ที่ “เราพิมพ์ prompt เก่งพอหรือยัง” แต่อยู่ที่ AI ได้ข้อมูลอะไรกลับมา และข้อมูลนั้นน่าเชื่อถือแค่ไหน หากแหล่งอ้างอิงผิด การสรุปที่ดูฉลาดก็อาจพาธุรกิจตัดสินใจผิดได้เร็วขึ้นหลายเท่า
ประเด็นนี้คือแก่นของการบรรยายโดย Will Bryk จาก Exa บนช่อง AI Engineer เขานำเสนอภาพอนาคตของ Agentic Web ที่ AI agents จะค้นเว็บถี่กว่ามนุษย์มหาศาล พร้อมอธิบายว่าทำไม search engine แบบเดิมซึ่งเน้นคีย์เวิร์ด โฆษณา และการแนะนำเนื้อหา อาจไม่พอสำหรับงานธุรกิจที่ต้องการคำตอบเฉพาะเจาะจง
สิ่งที่น่าสนใจสำหรับเจ้าของธุรกิจไทยไม่ใช่การเลือกใช้ Exa เพียงอย่างเดียว แต่คือการปรับวิธีคิดใหม่ว่า AI ในองค์กรควรถูกออกแบบให้ ค้นหา ตรวจสอบ คัดกรอง และสรุปข้อมูล อย่างไร ก่อนให้มันตอบลูกค้า วิเคราะห์คู่แข่ง หรือช่วยทีมตัดสินใจ
สารบัญ
- Step 1: มองให้เห็นว่า AI agents กำลังเปลี่ยนความหมายของการค้นหา
- Step 2: แยกให้ออกระหว่างระบบแนะนำ กับระบบที่ตอบตามเงื่อนไข
- Step 3: กำหนดโจทย์ให้ AI ค้นหาแบบงานวิจัย ไม่ใช่คำค้นกว้างๆ
- Step 4: ออกแบบ retrieval ให้สมดุลระหว่างความเร็ว คุณภาพ และต้นทุน
- Step 5: สร้างขอบเขตข้อมูลและแหล่งอ้างอิงก่อนปล่อย agent ใช้งานจริง
- Step 6: มอง private data เป็นข้อได้เปรียบ ไม่ใช่ของที่ต้องโยนให้ AI ทั้งหมด
- Step 7: เปลี่ยนแนวคิด Perfect Information เป็น workflow ที่ทำได้จริง
Step 1: มองให้เห็นว่า AI agents กำลังเปลี่ยนความหมายของการค้นหา
Bryk เสนอภาพที่ชัดมากว่า การค้นหาบนเว็บกำลังเปลี่ยนจากกิจกรรมของมนุษย์ ไปสู่กิจกรรมเบื้องหลังของ software และ AI agents เขาประเมินว่าปี 2026 จะเป็นจุดที่จำนวนการค้นหาจากระบบ AI แซงการค้นหาจากคน และช่องว่างอาจขยายถึงระดับพันเท่าในอีกไม่กี่ปี
ตัวเลขนี้เป็นการคาดการณ์ของ Exa จึงไม่ควรนำไปใช้เป็นข้อเท็จจริงทางการตลาดทันที แต่ทิศทางนั้นสมเหตุสมผล เพราะ AI ไม่ได้ค้นหาเฉพาะตอนที่เราถามคำถามในแชต ระบบหนึ่งอาจค้นหาเพื่อเช็กสต๊อก สรุปข่าวคู่แข่ง ตรวจเอกสาร ตอบคำถามลูกค้า หรือหาข้อมูลก่อนเสนอขาย โดยแต่ละงานสามารถเรียกค้นหลายรอบในเวลาไม่กี่วินาที
สำหรับธุรกิจไทย นี่หมายความว่าเว็บไซต์ ฐานความรู้ และเอกสารสินค้า จะไม่ได้ถูกอ่านโดยคนอย่างเดียวอีกต่อไป แต่จะถูก AI นำไปค้นหา ตีความ และอ้างอิงด้วย หากข้อมูลราคาสินค้า เงื่อนไขบริการ หรือรายละเอียดผลิตภัณฑ์กระจัดกระจาย AI ก็มีโอกาสหยิบคำตอบเก่าหรือไม่ครบไปใช้
คำถามที่ควรถามจึงเปลี่ยนจาก “ธุรกิจมี chatbot หรือยัง” เป็น “chatbot และ agent ของเรารู้ได้อย่างไรว่าข้อมูลไหนถูกต้องที่สุด”
Step 2: แยกให้ออกระหว่างระบบแนะนำ กับระบบที่ตอบตามเงื่อนไข
ข้อวิจารณ์สำคัญของ Bryk คือ search engine ทั่วไปไม่ได้ถูกสร้างมาเพื่อเป็นฐานข้อมูลที่ตอบเงื่อนไขแบบตรงตัวเสมอไป เขายกตัวอย่างการค้นหาเสื้อ “ไม่มีลายทาง” แต่ระบบอาจยังเสนอเสื้อที่มีลายทาง เพราะระบบถูกปรับมาให้แนะนำสิ่งที่น่าจะเกี่ยวข้องหรือขายได้ ไม่ใช่ยืนยันว่าตรงข้อกำหนดทุกข้อ
ปัญหานี้ดูเล็กเมื่อค้นหาสินค้าใช้เอง แต่มีต้นทุนสูงเมื่อเอาไปใช้ในงานธุรกิจ เช่น
- หารายชื่อบริษัทโลจิสติกส์ไทยที่มีคลังสินค้าในภาคตะวันออกและให้บริการควบคุมอุณหภูมิ
- รวบรวมโรงงานที่ได้รับมาตรฐานเฉพาะ มีการส่งออก และอยู่ในช่วงขนาดธุรกิจที่กำหนด
- ติดตามข่าวที่มีผลต่อราคาวัตถุดิบ โดยตัดข่าวประชาสัมพันธ์หรือเนื้อหาซ้ำออก
- ค้นหาผู้สมัครที่มีประสบการณ์เฉพาะทาง พร้อมข้อมูลผลงานจากแหล่งที่ตรวจสอบได้
งานเหล่านี้ต้องการ “รายการที่ผ่านเกณฑ์” ไม่ใช่ลิงก์จำนวนมากที่มีคำบางคำตรงกัน นี่คือความต่างระหว่าง การค้นหาเพื่อสำรวจ กับ การค้นหาเพื่อนำไปทำงานต่อ
มุมที่ควรระวังคือ ไม่มีระบบใดรับประกันได้ว่าพบ “ทุก” รายการบนอินเทอร์เน็ต เว็บมีข้อมูลที่ปิดกั้น ล้าสมัย หรือไม่มีการจัดทำดัชนีเสมอ ดังนั้นคำว่า perfect search ควรถูกมองเป็นเป้าหมายด้านคุณภาพ ไม่ใช่ใบรับรองว่าผลลัพธ์สมบูรณ์ 100%
Step 3: กำหนดโจทย์ให้ AI ค้นหาแบบงานวิจัย ไม่ใช่คำค้นกว้างๆ
หัวใจของ Agentic Search คือ AI สามารถแตกโจทย์ที่ซับซ้อนออกเป็นเงื่อนไขย่อย ค้นหาแหล่งข้อมูลหลายจุด แล้วจัดผลลัพธ์เป็นรูปแบบที่นำไปใช้งานได้ Bryk ยกตัวอย่างการค้นหา startup ที่ได้รับเงินทุนจาก Y Combinator และทำงานด้าน AI พร้อมระบุรุ่นที่เข้าร่วมและสถานะของบริษัท
สำหรับคนทำงาน จุดสำคัญไม่ใช่การเขียนคำถามให้ยาวที่สุด แต่คือการกำหนดเงื่อนไขให้ครบก่อนสั่ง AI ตัวอย่างโจทย์สำหรับทีมขาย B2B อาจเขียนในรูปแบบนี้
- เป้าหมาย: หาลูกค้าเป้าหมายสำหรับบริการจัดการบัญชี
- กลุ่มธุรกิจ: บริษัทอีคอมเมิร์ซและผู้ขายออนไลน์
- ขนาด: มีทีมงานระดับที่เหมาะกับการซื้อบริการ
- สัญญาณความต้องการ: กำลังขยายทีม เปิดตลาดใหม่ หรือรับสมัครตำแหน่งการเงิน
- พื้นที่: กรุงเทพฯ และปริมณฑล
- ผลลัพธ์ที่ต้องการ: ตารางชื่อบริษัท เว็บไซต์ เหตุผลที่เข้าเกณฑ์ แหล่งอ้างอิง และระดับความมั่นใจ
การระบุผลลัพธ์เป็นตารางสำคัญมาก เพราะเปลี่ยน AI จากเครื่องมือ “ช่วยคิด” ให้เป็นผู้ช่วยทำ research ที่ส่งต่อให้ทีมใช้งานได้จริง แต่รายการที่ AI สร้างควรผ่านการตรวจโดยคนก่อนนำเข้าสู่ CRM หรือใช้ติดต่อขายเสมอ โดยเฉพาะข้อมูลสถานะบริษัท ตำแหน่งงาน และข้อมูลบุคคล
Step 4: ออกแบบ retrieval ให้สมดุลระหว่างความเร็ว คุณภาพ และต้นทุน
Exa อธิบายแนวคิดทางเทคนิคเบื้องหลังว่า การค้นหาแบบคีย์เวิร์ดเร็วและเหมาะกับคำถามพื้นฐาน ส่วน embeddings ช่วยให้ระบบเข้าใจความหมายและเงื่อนไขที่ซับซ้อนขึ้น เช่น การแยกความต่างระหว่าง “เสื้อมีลายทาง” และ “เสื้อไม่มีลายทาง” อย่างไรก็ตาม embeddings เองก็มีข้อจำกัด จึงมักต้องใช้ร่วมกับการค้นหาแบบคีย์เวิร์ดและตัวกรองอื่น
เจ้าของธุรกิจไม่จำเป็นต้องสร้างระบบ embeddings เอง แต่ควรเข้าใจหลักการตัดสินใจสามด้านนี้
- ความเร็ว: งานตอบแชตลูกค้าหรือ voice agent ต้องตอบเร็วมาก
- ความละเอียด: งานวิเคราะห์ตลาด คัดเลือก vendor หรือทำรายงานผู้บริหาร ยอมรอนานขึ้นได้ หากผลลัพธ์ตรวจสอบได้มากกว่า
- ต้นทุน: ทุกข้อความและเอกสารที่ส่งเข้า LLM ใช้ token และมีค่าใช้จ่าย
Bryk ระบุว่า Exa สามารถส่งกลับเฉพาะส่วนสำคัญของเอกสาร แทนที่จะโยนเอกสารยาวทั้งหมดให้ model อ่าน แนวคิดนี้มีประโยชน์มากกับองค์กรไทยที่เริ่มใช้ AI กับคู่มือสินค้า รายงานประชุม หรือเอกสารนโยบายหลายร้อยหน้า
หลักปฏิบัติคือ ค้นหาให้กว้าง คัดให้แคบ แล้วค่อยส่งให้ AI สรุป อย่าให้ model อ่านทุกอย่างเพราะ “เผื่อไว้” นอกจากสิ้นเปลือง token แล้ว ยังเพิ่มโอกาสที่คำตอบจะปะปนระหว่างข้อมูลสำคัญและข้อมูลรบกวน
เริ่มต้นได้ด้วยการแบ่งงานเป็น 2 ระดับ คือ งานด่วนที่ตอบจากฐานความรู้ที่อนุมัติแล้ว และงานวิเคราะห์ที่อนุญาตให้ค้นเว็บหรือแหล่งข้อมูลภายนอก พร้อมแสดงแหล่งอ้างอิงทุกครั้ง
Step 5: สร้างขอบเขตข้อมูลและแหล่งอ้างอิงก่อนปล่อย agent ใช้งานจริง
Exa ชี้ว่าคำว่า “ผลค้นหาที่ดีที่สุด” ไม่ได้มีนิยามเดียว บางธุรกิจต้องการความเร็ว บางธุรกิจต้องการคุณภาพสูงสุดแม้ใช้เวลาหลายนาที บางงานต้องการค้นเฉพาะบางโดเมน กรองช่วงเวลา หลีกเลี่ยงหน้าสินค้า หรือห้ามใช้แหล่งที่ไม่น่าเชื่อถือ
นี่คือบทเรียนสำคัญที่สุดสำหรับองค์กร ไม่ใช่ทุกคำถามควรค้นหาจากเว็บทั้งหมด ตัวอย่างเช่น AI ฝ่ายขายควรใช้ข้อมูลสินค้า ราคา และเงื่อนไขบริการจากเอกสารภายในที่ฝ่ายรับผิดชอบอนุมัติแล้ว ขณะที่ AI ฝ่ายกลยุทธ์อาจค้นข่าว ตลาด และคู่แข่งจากภายนอก แต่ต้องเก็บลิงก์ต้นทางไว้
สำหรับงานที่มีผลต่อเงิน ชื่อเสียง หรือข้อผูกพันทางกฎหมาย ต้องใช้หลัก human approval เสมอ เช่น การส่งราคาให้ลูกค้า การประกาศนโยบาย การให้คำแนะนำด้านสุขภาพ การเงิน หรือกฎหมาย AI ควรช่วยรวบรวมและร่างคำตอบ แต่คนต้องเป็นผู้อนุมัติ
อีกประเด็นคือข้อมูลส่วนตัว หากนำรายชื่อพนักงาน ผู้สมัคร หรือข้อมูลลูกค้าเข้าสู่ workflow ต้องพิจารณาข้อกำหนด PDPA และนโยบายข้อมูลขององค์กรอย่างจริงจัง แหล่งข้อมูลที่หาได้บนเว็บ ไม่ได้แปลว่านำไปใช้ติดต่อหรือประมวลผลต่อได้โดยไม่มีข้อจำกัด สามารถดูแนวทางกฎหมายได้จาก สำนักงานคณะกรรมการคุ้มครองข้อมูลส่วนบุคคล
Step 6: มอง private data เป็นข้อได้เปรียบ ไม่ใช่ของที่ต้องโยนให้ AI ทั้งหมด
อีกแนวคิดที่ Exa ผลักดันผ่าน Exa Connect คือการเชื่อมข้อมูลสาธารณะบนเว็บเข้ากับข้อมูลเอกชนจากผู้ให้บริการ เพื่อให้ agent ตอบโจทย์ได้ครบกว่าเดิม เช่น การวิจัยบริษัทโครงสร้างพื้นฐาน AI โดยรวมข้อมูลเว็บไซต์เข้ากับสถิติผู้เข้าชมจากผู้ให้บริการข้อมูลภายนอก
แนวคิดนี้นำมาปรับใช้กับธุรกิจไทยได้ทันที แม้ยังไม่ต้องเชื่อม data marketplace ระดับโลก ลองนึกภาพ AI ที่ค้นเว็บเพื่อดูคู่แข่ง แล้วเทียบกับยอดขาย สต๊อก ต้นทุน หรือข้อมูลลูกค้าของเรา ผลลัพธ์จะมีคุณค่ากว่า AI ที่มองเฉพาะโลกภายนอก หรือมองเฉพาะข้อมูลภายในอย่างใดอย่างหนึ่ง
แต่ private data คือจุดที่ต้องมีวินัยมากที่สุด ไม่ควรเชื่อม Google Drive, LINE, CRM และโฟลเดอร์กลางทั้งหมดเข้ากับ AI เพียงเพื่อให้มัน “ฉลาดขึ้น” ควรเริ่มจากชุดข้อมูลแคบที่มีเจ้าของชัดเจน อัปเดตสม่ำเสมอ และกำหนดสิทธิ์เข้าถึงตามหน้าที่งาน
Step 7: เปลี่ยนแนวคิด Perfect Information เป็น workflow ที่ทำได้จริง
วิสัยทัศน์ของ Bryk คือข้อมูลที่ดีพอจะทำให้ AI ทำ research ระดับหนึ่งปีได้ในไม่กี่วินาที ภาพนี้ทรงพลัง แต่ไม่ควรทำให้เราหลงเชื่อว่าการตัดสินใจทางธุรกิจจะกลายเป็นเรื่องอัตโนมัติทั้งหมด เพราะคุณภาพข้อมูลยังขึ้นกับคำถาม เกณฑ์คัดเลือก แหล่งอ้างอิง และการตีความผลลัพธ์
จุดที่ควรเห็นด้วยเต็มที่คือ AI agents จะมีประโยชน์มากเมื่อมันถูกทำให้ “รู้ว่าอะไรไม่รู้” กล่าวคือ แสดงที่มา ระบุข้อมูลที่หาไม่พบ แยกข้อเท็จจริงออกจากข้อสรุป และเปิดทางให้คนตรวจกลับไปยังต้นทางได้
ธุรกิจที่ได้เปรียบจึงไม่ใช่ธุรกิจที่ใช้ AI ตอบเร็วที่สุด แต่คือธุรกิจที่สร้าง workflow ให้คำตอบของ AI ตรวจสอบย้อนหลังได้ ปลอดภัย และเชื่อมต่อกับการลงมือทำ
Actionable Insights: สิ่งที่เริ่มทำได้ภายในสัปดาห์นี้
- เลือก 1 งาน research ซ้ำๆ: เช่น สรุปข่าวคู่แข่ง หา lead หรือรวบรวมข้อมูล vendor แล้ววัดเวลาที่ทีมใช้ก่อนนำ AI มาช่วย
- ทำรายการแหล่งข้อมูลที่อนุญาต: แยกเว็บไซต์ทางการ ฐานความรู้ภายใน และแหล่งข่าวที่ยอมรับได้ก่อนสร้าง prompt
- บังคับให้ผลลัพธ์มีหลักฐาน: ทุกตารางหรือบทสรุปต้องมี URL วันที่เผยแพร่ และช่องระบุข้อมูลที่ยังยืนยันไม่ได้
- กำหนดจุดอนุมัติ: ห้ามให้ agent ส่งอีเมล เสนอราคา หรือแก้ข้อมูล CRM โดยไม่มีคนยืนยันในช่วงเริ่มต้น
- วัดคุณภาพก่อนวัดความเร็ว: ตรวจความถูกต้องของผลลัพธ์ 20 ตัวอย่างก่อน แล้วค่อยขยายไปยังงานปริมาณมาก
Troubleshooting: แก้ปัญหาที่พบบ่อยเมื่อใช้ AI ค้นหาข้อมูล
- ปัญหา: AI ให้รายชื่อบริษัทที่ไม่ตรงกลุ่มเป้าหมาย
สาเหตุ: โจทย์บอกเพียงอุตสาหกรรม แต่ไม่ระบุพื้นที่ ขนาดบริษัท สัญญาณความต้องการ หรือเงื่อนไขตัดออก
วิธีแก้: เขียนเกณฑ์คัดเลือกเป็นข้อ บังคับให้ AI แสดงเหตุผลที่แต่ละรายผ่านเกณฑ์ และสุ่มตรวจผลลัพธ์ชุดแรก - ปัญหา: คำตอบดูน่าเชื่อถือ แต่กดดูแหล่งอ้างอิงแล้วไม่รองรับ
สาเหตุ: AI สรุปจากเนื้อหาเก่า แหล่งที่ไม่เกี่ยวข้อง หรืออนุมานเกินข้อมูลที่ค้นพบ
วิธีแก้: ระบุให้แยก “ข้อเท็จจริงที่ยืนยันได้” ออกจาก “ข้อสันนิษฐาน” และห้ามสรุปหากไม่มีแหล่งต้นทาง - ปัญหา: ค่าใช้จ่าย LLM สูงเกินคาด
สาเหตุ: ส่งบทความหรือเอกสารยาวทุกชิ้นเข้า model โดยไม่มีการคัดส่วนสำคัญ
วิธีแก้: จำกัดจำนวนแหล่งข้อมูล ตัดเอกสารเป็นส่วนย่อย และให้ระบบดึงเฉพาะข้อความที่ตรงกับคำถามก่อนสรุป - ปัญหา: AI ตอบข้อมูลผลิตภัณฑ์ไม่ตรงกับราคาและเงื่อนไขล่าสุด
สาเหตุ: ฐานความรู้ภายในมีเอกสารหลายเวอร์ชัน หรือไม่มีเจ้าของข้อมูลรับผิดชอบ
วิธีแก้: ตั้งแหล่งข้อมูลหลักเพียงชุดเดียว ใส่วันที่อัปเดต กำหนดผู้รับผิดชอบ และปิดการเข้าถึงไฟล์เก่าจาก workflow - ปัญหา: ทีมไม่กล้าใช้ผลลัพธ์จาก AI เลย
สาเหตุ: ระบบให้คำตอบก้อนเดียว ไม่มีที่มา และไม่ชัดว่า AI ทำอะไรไปบ้าง
วิธีแก้: เปลี่ยนผลลัพธ์เป็นตารางที่ตรวจง่าย ระบุแหล่งอ้างอิง และให้ AI บอกช่องว่างของข้อมูลอย่างตรงไปตรงมา
การต่อยอด: จาก AI ค้นข้อมูลสู่ระบบช่วยตัดสินใจ
- สร้าง Market Intelligence Agent: รวบรวมข่าวคู่แข่ง เทรนด์อุตสาหกรรม และการเปลี่ยนแปลงราคาวัตถุดิบเป็นรายสัปดาห์ พร้อมลิงก์อ้างอิง
- สร้าง Sales Research Brief: ให้ AI สรุปบริษัทเป้าหมาย เหตุการณ์ล่าสุด และประเด็นที่น่าจะเป็น pain point ก่อนทีมขายเข้าพบ
- สร้าง Knowledge Assistant ภายใน: ค้นเอกสาร SOP คู่มือ และนโยบายบริษัทจากชุดข้อมูลที่ผ่านการอนุมัติ โดยตอบพร้อมชื่อเอกสารและหัวข้อที่อ้างอิง
สรุป Checklist ทั้งหมด
- ☐ ระบุงานที่ต้องค้นข้อมูลซ้ำและมีผลต่อธุรกิจ
- ☐ แยกงานที่ต้องการความเร็ว ออกจากงานที่ต้องการความละเอียด
- ☐ เขียนเงื่อนไขคัดเลือกและเงื่อนไขตัดออกให้ชัด
- ☐ กำหนดรูปแบบผลลัพธ์ เช่น ตาราง รายงาน หรือรายการที่มีหลักฐาน
- ☐ สร้างรายชื่อแหล่งข้อมูลที่อนุญาตและแหล่งที่ห้ามใช้
- ☐ จำกัดข้อมูลภายในให้เข้าถึงเท่าที่จำเป็นตามสิทธิ์งาน
- ☐ ให้ AI แสดง URL วันที่ และระดับความมั่นใจของข้อมูล
- ☐ ตั้งจุดอนุมัติโดยคนก่อนส่งผลลัพธ์ออกไปหาลูกค้าหรือแก้ข้อมูลสำคัญ
- ☐ ทดสอบความถูกต้องกับตัวอย่างจริงก่อนขยาย workflow
- ☐ ทบทวนต้นทุน token คุณภาพผลลัพธ์ และข้อมูลที่ต้องอัปเดตเป็นประจำ
Agentic Web ไม่ได้เริ่มต้นเมื่อองค์กรมี AI ที่พูดเก่ง แต่มันเริ่มเมื่อ AI ค้นเจอข้อมูลที่ใช่ รู้ว่าข้อมูลมาจากไหน และส่งต่อคำตอบในรูปแบบที่ทีมตรวจและตัดสินใจได้ Search Engine สำหรับ AI Agents จึงไม่ใช่เรื่องไกลตัวของ developer เท่านั้น แต่เป็นโครงสร้างพื้นฐานใหม่ของงานขาย งานวิเคราะห์ และการบริหารธุรกิจไทย
ที่มาวิดีโอ: The Search Engine for the Agentic Web — Will Bryk, Exa · AI Engineer · ย้ายจากบทความต้นทางวันที่ 2026-09-16 โดยคงเนื้อหาหลักเดิม