ถ่ายทอดจากบทความต้นทางลงวันที่ 15 กันยายน 2026 และคลิป Realtime Voice Agents with Frontier Intelligence โดย Bohan Li แห่ง EliseAI บนช่อง AI Engineer เป็นคำอธิบายระบบและตัวอย่างในคลิป ยังไม่ได้ทดสอบซ้ำหรือรับรองความเร็วในงานอื่น บทถอดเสียงที่กู้คืนเป็นภาษาอาหรับและมีชื่อเฉพาะคลาดเคลื่อน จึงใช้ชื่อผู้บรรยายและองค์กรตามข้อมูลวิดีโอและสไลด์ ตัวอย่างไทยคงจากบทความเดิม วันที่นี้เป็นวันที่บทความต้นทาง ไม่ใช่วันอัปโหลดวิดีโอซึ่งยังไม่ทราบ
AI รับสายที่ตอบเก่งแต่เว้นจังหวะนาน ไม่ได้สร้างประสบการณ์ที่ดีไปกว่า IVR แบบเดิมมากนัก จุดตัดสินใจของลูกค้าไม่ได้อยู่แค่คำตอบถูกหรือผิด แต่อยู่ที่ความรู้สึกว่าอีกฝ่าย “ฟังอยู่ เข้าใจอยู่ และช่วยจัดการเรื่องให้ทันที” หรือไม่
คลิปจากช่อง AI Engineer ที่ Bohan Li แห่ง EliseAI อธิบายแนวทางสร้าง Realtime Voice Agent สำหรับงานจริง เช่น การนัดหมายคลินิก โดยใช้แนวคิดจากรถยนต์ไร้คนขับมาวางระบบเสียงเป็น 3 ชั้น ตั้งแต่การฟัง การคิด ไปจนถึงการพูดกลับ ประเด็นสำคัญที่ Bohan เสนอคือการลดเวลารอด้วย workflow ที่ให้แต่ละส่วนทำงานทับซ้อนกันได้ โดยยังใช้โมเดลที่ต้องการ ไม่ใช่การรับรองว่าความเร็วและความแม่นยำไม่มีข้อแลกเปลี่ยน
สำหรับธุรกิจไทย นี่ไม่ใช่แค่เรื่องเทคนิคของทีม developer แต่เป็นกรอบคิดสำหรับออกแบบแชตบอตเสียง ระบบรับสายอัตโนมัติ และผู้ช่วยฝ่ายขายที่รักษาทั้งความเร็ว ความถูกต้อง และความน่าเชื่อถือไว้พร้อมกัน
Step 1: แยก Voice Agent ออกเป็น 3 งานเหมือนรถยนต์ไร้คนขับ
Bohan Li เปรียบ Voice Agent กับระบบขับเคลื่อนอัตโนมัติ ซึ่งต้องทำ 3 งานต่อเนื่องกัน คือ รับรู้ วางแผน และควบคุม สำหรับ AI โทรศัพท์ แปลเป็นโครงสร้างง่าย ๆ ได้ดังนี้
- การรับรู้ คือแปลงเสียงเป็นข้อความ หรือ Speech-to-Text
- การวางแผน คือให้ language model ทำความเข้าใจ ตัดสินใจ และเรียกข้อมูลหรือเครื่องมือที่จำเป็น
- การควบคุม คือแปลงคำตอบกลับเป็นเสียง หรือ Text-to-Speech
มุมที่น่าสนใจคือ ทีมงานไม่ได้พยายามเร่ง AI จุดเดียวให้เร็วที่สุด แต่แยกดูว่า latency เกิดตรงไหน แล้วลดเวลารอในแต่ละชั้นต่างหาก วิธีคิดนี้นำมาใช้กับธุรกิจไทยได้ทันที เพราะปัญหา Voice Agent หลายระบบไม่ได้เกิดจาก model ไม่ฉลาด แต่เกิดจากข้อมูลหลังบ้านช้า เสียงอ่านช้า หรือระบบรอให้ประมวลผลจบทุกอย่างก่อนจึงเริ่มตอบ
ตัวอย่างเช่น คลินิกเสริมความงามอาจต้องให้ AI รับสายเพื่อถามชื่อ สาขาที่สะดวก และช่วงเวลาที่ต้องการจอง หากระบบออกแบบเป็นก้อนเดียว ทุกคำตอบต้องผ่านลำดับ “ฟังให้จบ คิดให้จบ เช็กตารางให้จบ แล้วค่อยพูด” ลูกค้าจะรู้สึกถึงช่วงเงียบแทบทุกครั้ง แต่เมื่อแยก 3 ชั้นออกมา ธุรกิจจะรู้ว่าควรลงทุนแก้ตรงไหนก่อน
Step 2: ใช้ระบบถอดเสียง 2 ชั้น เพื่อให้เร็วโดยไม่ยอมเสียความแม่น
ชั้นแรกของ Voice Agent คือการฟัง แต่เสียงสนทนาไม่ได้สะอาดเหมือนข้อความ ลูกค้าอาจพูดเร็ว เว้นวรรคไม่ชัด มีเสียงรบกวน หรือบอกชื่อเฉพาะที่ถอดยาก เช่น ชื่อบุคคล ชื่อสินค้า เลขสมาชิก และวันเดือนปี
แนวทางของ EliseAI คือใช้การถอดเสียงแบบสตรีม 2 ตัวพร้อมกัน ตัวแรกให้ผลเร็วเพื่อให้ระบบเริ่มเข้าใจประโยคระหว่างที่ลูกค้ายังพูด ส่วนตัวที่สองช้ากว่าเล็กน้อย แต่ใช้เสียงและ context มากกว่า จึงทำหน้าที่ตรวจแก้ผลลัพธ์แรก
จุดที่ควรจำคือ “ผลที่เร็ว” ไม่ได้ถูกนำไปใช้เป็นความจริงถาวร แต่เป็นข้อมูลชั่วคราวให้ระบบเริ่มเตรียมงานได้ก่อน หากมีเสียงใหม่เข้ามา ผลแก้ไขที่ล้าสมัยก็ต้องถูกยกเลิก เพราะข้อความที่มี context มากกว่าอาจน่าเชื่อถือกว่า
กรณีในคลิปคือ AI ขอชื่อและวันเกิด ระบบถอดเสียงเร็วอาจจับคำได้ไม่ครบหรือไม่แน่ใจว่าเป็นชื่ออะไร แต่ตัวถอดเสียงที่มี context รู้ว่าคำตอบนี้ควรมีช่อง “ชื่อ” และ “วันเกิด” จึงช่วยตีความและแก้ผลได้ตรงจุดกว่า ไม่ได้แก้แค่คำสะกดตามเสียงอย่างเดียว
ธุรกิจไทยควรนำหลักการนี้ไปใช้กับข้อมูลที่มีมูลค่าสูง เช่น เลขบัตรสมาชิก เลขคำสั่งซื้อ เลขทะเบียนรถ รหัสไปรษณีย์ หรือชื่อผู้รับบริการ ถ้าระบบไม่มั่นใจ อย่าเดาแล้วเดินหน้าทำรายการ ควรถามย้ำเฉพาะข้อมูลสำคัญ เช่น “ขอทวนเลขท้าย 4 ตัวอีกครั้งได้ไหม” ความเร็วที่ดีไม่ใช่การตอบทันทีทุกครั้ง แต่คือการรู้ว่าข้อมูลไหนต้องชะลอเพื่อลดความเสียหาย
Step 3: ให้ Background Agent เริ่มเช็กข้อมูลก่อนบทสนทนาจบ
ความหน่วงก้อนใหญ่ของ Voice Agent มักเกิดเมื่อ AI ต้องเรียก tool เช่น ค้นหาประวัติลูกค้า เช็กตารางนัด ตรวจสถานะการชำระเงิน หรือค้นหาสต๊อกสินค้า หากรอให้ลูกค้าพูดจบสนิท แล้วค่อยสั่ง model ให้ตัดสินใจเรียก tool ทุกครั้ง บทสนทนาจะติดช่วงเงียบเป็นธรรมชาติ
EliseAI แก้ด้วยการให้ Background Agent เริ่มเรียกเครื่องมือจากข้อความชั่วคราวที่ไหลเข้ามา แล้วเติมผลลัพธ์กลับเข้า context ของ model หลัก เมื่อถึงเวลาตอบ Model หลักจึงมีข้อมูลที่ต้องใช้รออยู่แล้ว
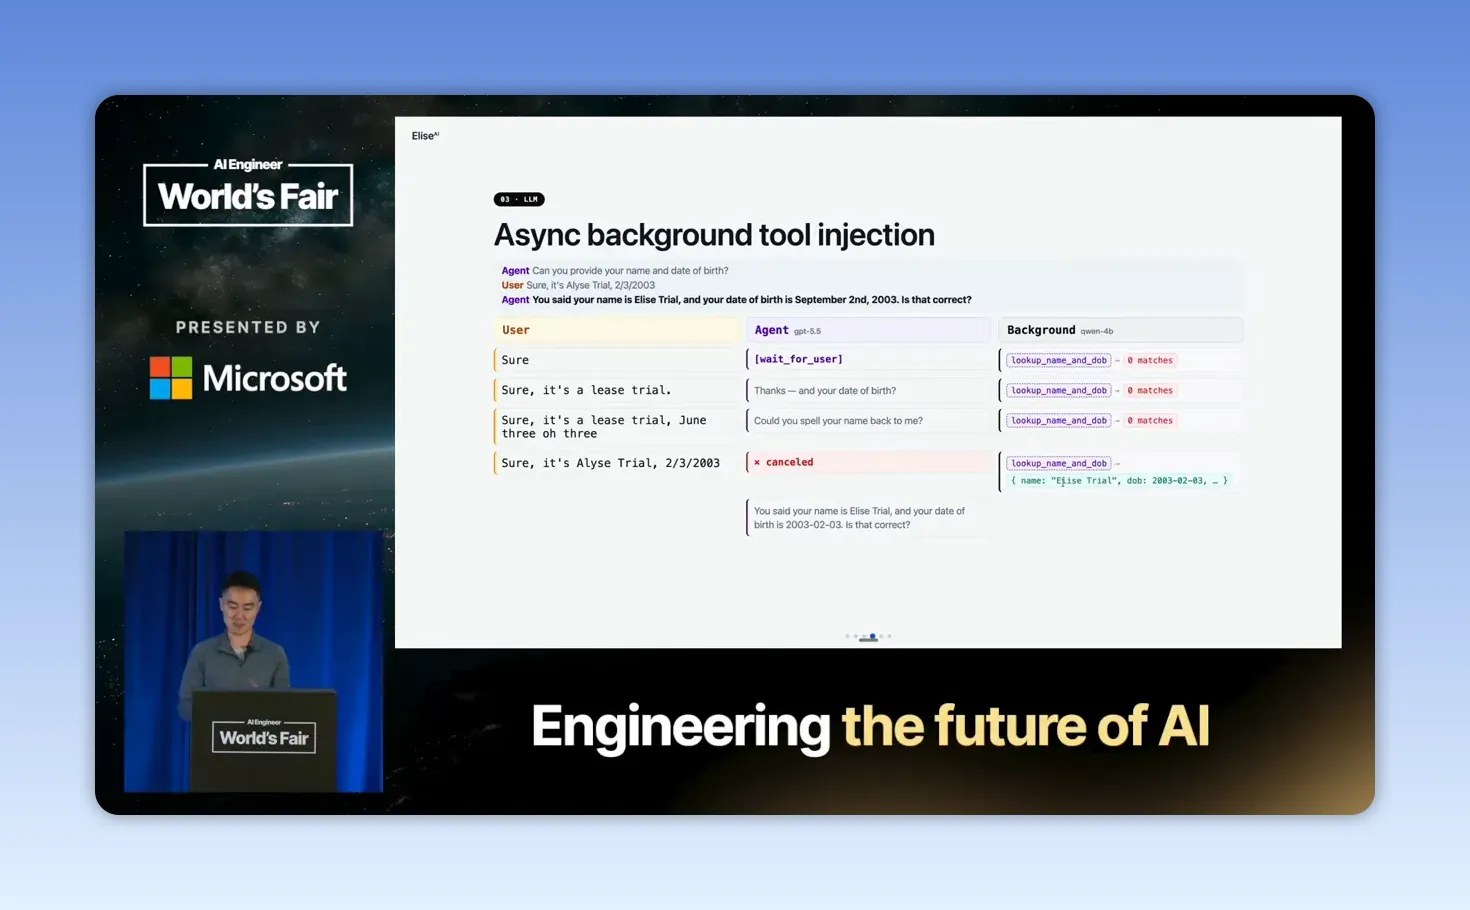
แนวคิดนี้อธิบายได้ด้วยสถานการณ์ร้านค้าออนไลน์ ลูกค้าโทรมาพูดว่า “สั่งรองเท้าไว้เมื่อวาน อยากเช็กว่าส่งหรือยัง” แทนที่จะรอให้ลูกค้าพูดจบทุกคำ ระบบสามารถเริ่มค้นหาคำสั่งซื้อจากเบอร์โทรที่ระบุตัวตนไว้ได้ทันที จากนั้นจึงตอบสถานะเมื่อแน่ใจว่าลูกค้าพูดจบ
อย่างไรก็ตาม นี่คือจุดที่เราไม่ควรนำไปใช้แบบอัตโนมัติทุกกรณี การเรียก tool ล่วงหน้าอาจทำให้ต้นทุนเพิ่มและสร้างความเสี่ยงหากไปกระทบข้อมูลส่วนบุคคลหรือการทำธุรกรรมที่ย้อนกลับไม่ได้ ทางที่เหมาะกับธุรกิจคือแบ่ง tool เป็น 2 กลุ่ม
- เรียกล่วงหน้าได้ เช่น ค้นหาข้อมูลสินค้า เช็กช่วงเวลาว่าง ค้นหาคำสั่งซื้อ หรือเตรียมคำตอบจากฐานความรู้
- ต้องรอยืนยัน เช่น ยืนยันจองนัด ตัดบัตรเครดิต ยกเลิกคำสั่งซื้อ เปลี่ยนที่อยู่ หรือเปิดเผยข้อมูลสุขภาพ
อีกชั้นหนึ่งที่สำคัญคือระบบต้องสร้างคำตอบล่วงหน้าได้ แต่ยังไม่ควรปล่อยเสียงออกจนกว่าจะจับได้ว่าลูกค้าหยุดพูดจริง วิธีนี้ลดเวลารอโดยไม่ทำให้ AI พูดแทรก และยังยกเลิกคำตอบเดิมได้หากข้อมูลที่ถอดเสียงถูกแก้ภายหลัง
Step 4: ทำให้ AI เริ่มพูดระหว่างที่ยังสร้างคำตอบอยู่
หลัง model ตัดสินใจแล้ว งานยังไม่จบ เพราะ Text-to-Speech ต้องใช้เวลาสร้างเสียงเช่นกัน แนวทางทั่วไปคือรอให้ model เขียนประโยคจบ แล้วส่งไปสังเคราะห์เสียงทั้งประโยค ผลคือมีความเงียบสะสมเพิ่มขึ้นอีกชั้น
Voice Agent แบบเรียลไทม์จึงควรรับข้อความแบบสตรีม เมื่อ model เริ่มสร้างคำตอบ ระบบเสียงต้องเริ่มเตรียมอ่านทันทีโดยไม่จำเป็นต้องรอประโยคสมบูรณ์ หลักการนี้มีผลกับความรู้สึกของการสนทนามาก เพราะเสียงคำแรกที่มาเร็วช่วยกลบเวลาที่เหลือของการคิดและการสร้างเสียง
แต่การอ่านเป็นชิ้นเล็กเกินไปมีข้อเสีย เสียงจะขาดจังหวะ น้ำเสียงไม่ลื่น หรือเน้นคำผิดตำแหน่ง ดังนั้นเป้าหมายไม่ใช่ส่งทุก token ไปอ่านทันที เป้าหมายคือหาจังหวะที่เร็วพอและมีข้อความมากพอให้เสียงยังฟังเป็นธรรมชาติ
Step 5: ใช้ Prefix Cache กับประโยคที่พูดซ้ำ เพื่อให้เสียงออกก่อน
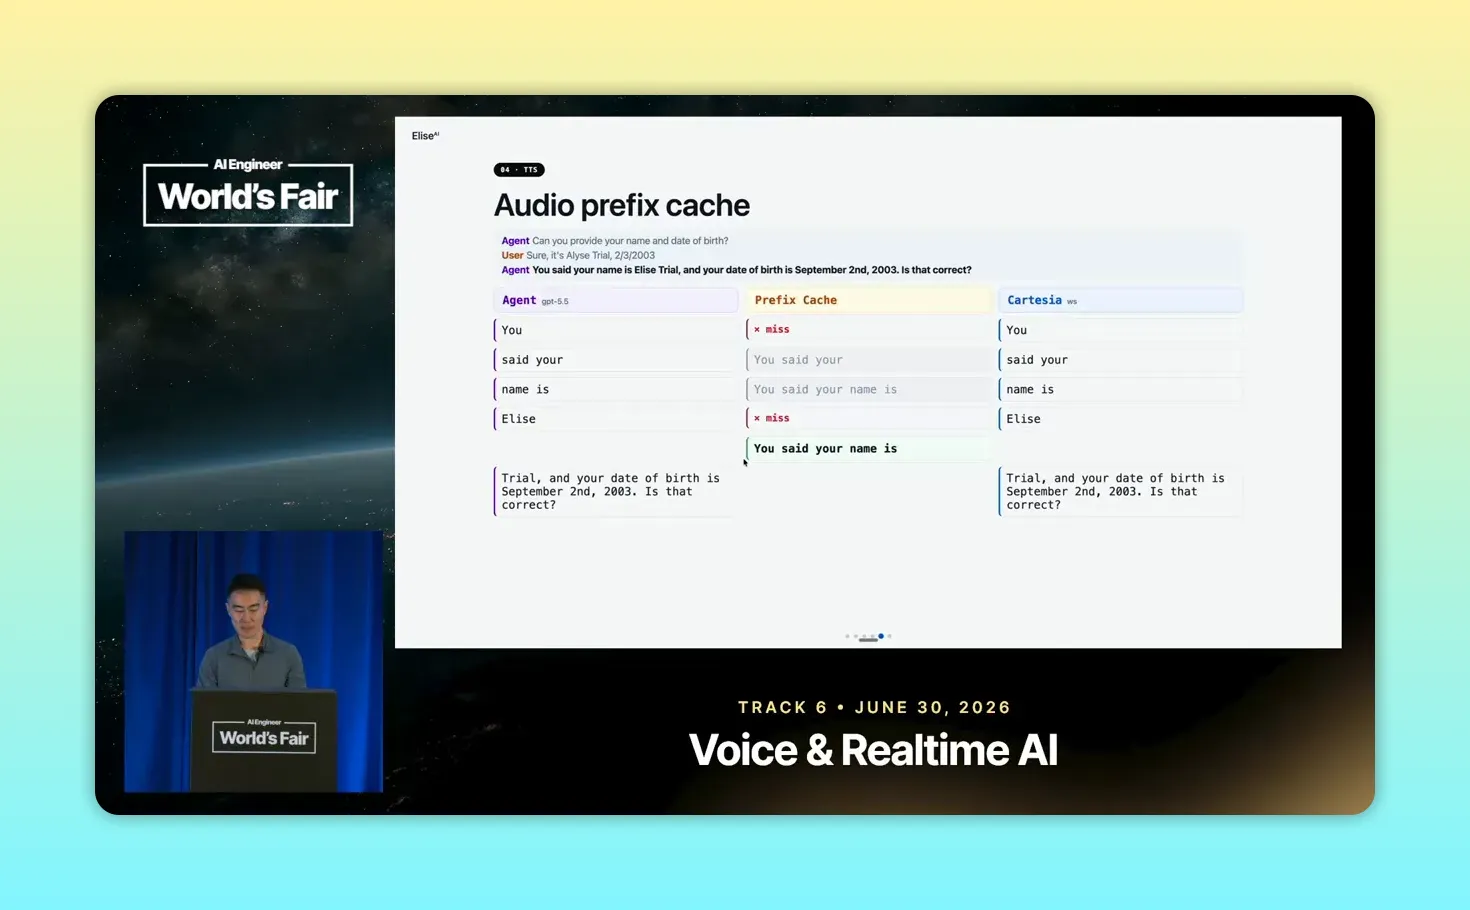
เทคนิคที่เฉียบคมที่สุดในคลิปคือ Audio Prefix Cache ระบบจะตรวจข้อความที่ model กำลังสร้าง แล้วค้นว่าเคยมีไฟล์เสียงของช่วงต้นประโยคนี้จากรอบก่อนหรือไม่
งานรับสายจำนวนมากมีประโยคเปิดที่ซ้ำกันเสมอ เช่น “ขอบคุณที่ให้ข้อมูลค่ะ” “ขอตรวจสอบสักครู่นะคะ” “มีเวลาว่างในวัน...” หรือ “สามารถส่งลิงก์ให้ทาง SMS ได้ไหม” หากมีเสียงของวลีเหล่านี้เก็บไว้ ระบบสามารถเริ่มเล่นเสียงจาก cache ได้ก่อน ขณะที่ model และผู้ให้บริการ Text-to-Speech กำลังสร้างส่วนที่เหลือ
เมื่อคำตอบเดินมาถึงจุดเฉพาะ เช่น ชื่อลูกค้า วันนัด หรือชื่อแพทย์ ระบบก็เปลี่ยนไปใช้เสียงที่สร้างใหม่แทน เบื้องหลัง Text-to-Speech ยังได้รับข้อความเต็มเพื่อสร้างน้ำเสียงทั้งประโยคให้เป็นธรรมชาติ แต่ระบบจะตัดส่วนเสียงที่เล่นจาก cache ไปแล้วออก เพื่อเชื่อมสองช่วงให้แทบไม่รู้สึกถึงรอยต่อ
ธุรกิจไม่จำเป็นต้องสร้าง cache เองตั้งแต่วันแรก แต่ควรเริ่มเก็บรายการประโยคที่ถูกใช้ซ้ำใน workflow ก่อน เช่น คำทักทาย คำขออนุญาต คำยืนยัน และคำแนะนำขั้นต่อไป จากนั้นจึงประเมินว่า platform ที่เลือกทำเสียงตอบกลับได้เร็วเพียงใด โดยเฉพาะในภาษาไทยที่วรรณยุกต์และจังหวะน้ำเสียงส่งผลต่อความน่าเชื่อถือมาก
ข้อควรระวังคืออย่าใช้เสียงสำเร็จรูปจนแข็งเกินไป หากทุกประโยคฟังเหมือนบันทึกเทป ลูกค้าจะจับได้ทันทีว่าเป็นระบบอัตโนมัติ Prefix cache ควรเร่งเฉพาะช่วงที่เป็นมาตรฐาน แล้วให้ส่วนที่มีข้อมูลเฉพาะบุคคลยังเปลี่ยนตามสถานการณ์
Step 6: ทดลองกับ Workflow แคบ ๆ ก่อนขยายไปทั้งธุรกิจ
ตัวอย่างการโทรนัดคลินิกในคลิปแสดงภาพปลายทางได้ชัดเจน AI รับข้อมูลชื่อและวันเกิด ตรวจว่าผู้ติดต่อเป็นผู้รับบริการรายใหม่หรือไม่ ส่งลิงก์เก็บข้อมูลประกัน เสนอเวลานัด และเปลี่ยนไปค้นหาตัวเลือกใหม่เมื่ออีกฝ่ายขอวันอื่น ทั้งหมดดำเนินไปเหมือนบทสนทนาต่อเนื่อง เพราะการฟัง ค้นหา และเตรียมคำตอบทำงานเหลื่อมกันอยู่เบื้องหลัง
หากเอามาใช้กับธุรกิจไทย เราแนะนำให้เลือก use case ที่มีคุณสมบัติ 3 ข้อก่อน คือ คำถามซ้ำสูง ข้อมูลหลังบ้านเข้าถึงได้ และความเสี่ยงของคำตอบผิดยังควบคุมได้ ตัวอย่างเช่น
- ร้านค้าปลีกที่รับสายถามสถานะจัดส่ง เวลาเปิดปิด และสาขา
- คลินิกที่คัดกรองความต้องการและขอข้อมูลก่อนส่งต่อเจ้าหน้าที่
- ธุรกิจอสังหาริมทรัพย์ที่รับข้อมูลผู้สนใจ คัดกรองงบประมาณ และนัดหมายเข้าชม
- ศูนย์บริการรถยนต์ที่ตรวจคิวเบื้องต้นและยืนยันข้อมูลรถ
เราไม่เห็นด้วยกับการเริ่มต้นจากเป้าหมาย “แทนพนักงานทั้งหมด” เพราะงานเสียงที่มีผลต่อรายได้และความเชื่อใจสูงต้องมีทางส่งต่อคนเสมอ AI ควรรับงานซ้ำ ๆ ก่อน เก็บข้อมูลให้ครบขึ้น ลดสายที่หลุด และช่วยให้พนักงานรับช่วงต่อพร้อมข้อมูล ไม่ใช่บังคับให้ระบบตอบทุกเรื่อง
Step 7: Actionable Insights สำหรับเจ้าของธุรกิจและคนทำงาน
- วัดช่วงเงียบก่อนวัดความฉลาด ฟังสายจริง 20 ถึง 30 สาย แล้วจดว่าลูกค้าต้องรอนานที่สุดตรงไหน
- ทำรายการข้อมูลสำคัญ ระบุชัดว่าชื่อ เบอร์โทร วันนัด เลขออเดอร์ หรือยอดชำระ ข้อมูลใดต้องให้ AI ทวนก่อนบันทึก
- แยกงานค้นหากับงานยืนยัน ให้ AI ค้นตารางหรือสถานะล่วงหน้าได้ แต่ต้องรอคำยืนยันก่อนจอง ยกเลิก หรือชำระเงิน
- เขียนคลังวลีที่ใช้ซ้ำ สร้างประโยคมาตรฐานสั้น ชัด และเป็นภาษาของแบรนด์ เพื่อให้การตอบเร็วและคุมคุณภาพได้
- ตั้งเกณฑ์ส่งต่อเจ้าหน้าที่ เช่น ระบบฟังชื่อไม่ชัด ลูกค้าถามนอกฐานความรู้ มีอารมณ์ไม่พอใจ หรือเป็นเรื่องที่มีผลทางการเงิน
Step 8: Troubleshooting แก้ปัญหาที่มักเจอเมื่อทำ Voice Agent
- ปัญหา: AI ตอบช้าแม้คำตอบสั้น
สาเหตุ: ระบบรอให้ถอดเสียง คิด เรียกข้อมูล และสร้างเสียงจบทีละขั้น
วิธีแก้: แยกเวลาของแต่ละขั้น เริ่มค้นหาข้อมูลที่ปลอดภัยระหว่างรับฟัง และให้ Text-to-Speech รับข้อความแบบสตรีม - ปัญหา: AI บันทึกชื่อหรือเลขสำคัญผิด
สาเหตุ: ใช้ผลถอดเสียงครั้งแรกเป็นคำตอบสุดท้าย หรือไม่มีการตรวจรูปแบบข้อมูล
วิธีแก้: ใช้การตรวจซ้ำสำหรับข้อมูลสำคัญ ทวนข้อมูลกลับ และกำหนดกติกาส่งต่อคนเมื่อความมั่นใจต่ำ - ปัญหา: AI พูดแทรกลูกค้าบ่อย
สาเหตุ: ระบบตีความช่วงหยุดสั้น ๆ ว่าลูกค้าพูดจบแล้ว
วิธีแก้: ปรับกติกาตรวจจับจุดจบการพูด ให้ AI เตรียมคำตอบได้ล่วงหน้าแต่ปล่อยเสียงเมื่อแน่ใจ - ปัญหา: เสียงตอบกลับกระตุกหรือฟังแข็ง
สาเหตุ: ส่งข้อความให้ระบบเสียงสั้นเกินไป หรือใช้วลีสำเร็จรูปมากเกิน
วิธีแก้: ให้ระบบเสียงเห็นประโยคเต็มเมื่อทำได้ ใช้ cache เฉพาะวลีเปิด และทดสอบเสียงกับประโยคไทยที่มีชื่อเฉพาะจริง - ปัญหา: AI ดำเนินการผิด เช่น จองคิวหรือเปลี่ยนข้อมูลโดยไม่ได้รับอนุมัติ
สาเหตุ: ไม่มีการแยกสิทธิ์ระหว่างค้นหาข้อมูลและทำธุรกรรม
วิธีแก้: กำหนดขั้นยืนยันก่อนทุก action ที่ย้อนกลับยาก บันทึกเหตุการณ์ และทำปุ่มส่งต่อเจ้าหน้าที่ให้ชัดเจน
Step 9: การต่อยอดจากระบบรับสายสู่ AI Workforce
เมื่อ workflow รับสายเริ่มนิ่งแล้ว ธุรกิจสามารถต่อยอดได้โดยไม่ต้องกระโดดไปทำระบบใหญ่ทันที
- เชื่อม CRM และระบบนัดหมาย ให้ทุกสายสร้างหรืออัปเดตข้อมูลลูกค้าโดยมีการตรวจความถูกต้องก่อนบันทึก
- วิเคราะห์เหตุผลที่ลูกค้าโทร แยกหมวดคำถามที่พบบ่อย สายที่ส่งต่อคน และจุดที่ลูกค้าหลุด เพื่อปรับทั้งสคริปต์และบริการ
- ทำระบบติดตามหลังการสนทนา เช่น ส่งลิงก์เอกสาร ยืนยันนัด หรือสรุปรายละเอียดผ่าน SMS หรือ LINE หลังจากได้รับอนุญาต
แก่นของการต่อยอดไม่ใช่เพิ่ม AI ให้มากที่สุด แต่คือทำให้แต่ละจุดส่งต่องานลดการถามซ้ำ และทำให้ลูกค้าได้รับคำตอบหรือขั้นตอนต่อไปเร็วขึ้น
Step 10: สรุป Checklist ทั้งหมดก่อนเริ่มทำ Realtime Voice Agent
- ☐ เลือก use case ที่มีคำถามซ้ำสูงและขอบเขตชัด
- ☐ แยก flow เป็นการฟัง การคิด และการพูดกลับ
- ☐ ระบุข้อมูลสำคัญที่ต้องทวนหรือให้เจ้าหน้าที่ตรวจ
- ☐ เตรียมฐานข้อมูล ตารางนัด หรือสถานะคำสั่งซื้อที่ AI ค้นหาได้
- ☐ แยก tool สำหรับค้นหาล่วงหน้าออกจาก action ที่ต้องยืนยัน
- ☐ ออกแบบกติกาไม่ให้ AI พูดแทรก
- ☐ สร้างคลังประโยคมาตรฐานที่สั้น เป็นธรรมชาติ และตรงแบรนด์
- ☐ ทดสอบเสียงไทยกับชื่อบุคคล ตัวเลข วันเวลา และคำเฉพาะธุรกิจ
- ☐ ตั้งเงื่อนไขส่งต่อเจ้าหน้าที่สำหรับความเสี่ยงและคำถามนอกขอบเขต
- ☐ วัดเวลารอ ความถูกต้อง อัตราส่งต่อ และผลลัพธ์ทางธุรกิจจากสายจริง
บทเรียนจาก Realtime Voice Agent ของ EliseAI ชัดเจนว่า AI ที่ทำงานดีในการโทรศัพท์ไม่ได้ชนะด้วย model เพียงตัวเดียว แต่ชนะจากการออกแบบ workflow ที่ไม่ปล่อยให้เวลารอสะสม ตั้งแต่การฟังที่ยอมแก้ไขตัวเอง การค้นข้อมูลล่วงหน้า ไปจนถึงการเริ่มพูดด้วยส่วนที่เตรียมไว้แล้ว สำหรับธุรกิจไทย จุดเริ่มที่ถูกต้องคือแก้หนึ่ง workflow ให้ราบรื่นและวัดผลได้ก่อน แล้วค่อยขยาย AI ไปยังงานที่ใกล้เคียงกัน
แหล่งที่มา: Realtime Voice Agents with Frontier Intelligence — Bohan Li, EliseAI · บทความต้นทาง