ที่มา: บทความ VideoToBlog วันที่ 9 มีนาคม 2026 คำเปรียบเทียบว่าตัดสมองหมายถึงการตัด expert ระหว่างการฝึกตามอัลกอริทึมที่นักวิจัยออกแบบ ไม่ใช่หลักฐานว่าโมเดลมีสติหรือแก้ตัวเองได้อย่างอิสระ ตัวเลขความเร็ว ความแม่นยำและการเทียบคู่แข่งเป็นผลที่ผู้พัฒนา/ต้นทางรายงาน ยังไม่ได้ทดสอบซ้ำอย่างอิสระ ตรวจโครงการ Yuan3.0 Ultra ทางการเมื่อ 13 ตุลาคม 2026 พบคำอธิบาย LAEP จาก 1515B เหลือ 1010B และประสิทธิภาพ pre-training เพิ่ม 49% ซึ่งไม่ใช่คำรับประกันความเร็ว inference หรือการประหยัดพลังงานทุกกรณี ภาพเดิมเป็นหน้าอธิบายและภาพจำลองในคลิป รวมถึงกราฟเทียบที่ไม่ได้ระบุชุดทดสอบครบ จึงไม่ใช้ภาพเหล่านี้เป็นหลักฐานผลทดลองจริงหรือยืนยันว่าเหนือกว่าทุกโมเดล · แหล่งอ้างอิงในบทความต้นทาง · โครงการและรายงานทางเทคนิค Yuan3.0 Ultra ·
บทนำ: คลิปที่กระตุกความคิดเรื่องการสร้าง AI
เพิ่งชมคลิปสั้นที่เล่าข่าวการพัฒนาโมเดลจาก Yuan Lab AI ที่เรียกชื่อรุ่นว่า Yuan 3.0 Ultra แล้วรู้สึกว่ามุมมองเดิมๆ ต่อการพัฒนา AI กำลังถูกท้าทายอย่างหนัก เราเคยเชื่อกันว่าใหญ่ไว้ก่อน ยิ่งพารามิเตอร์มาก ยิ่งชนะ แต่สิ่งที่เกิดขึ้นกลับตรงกันข้าม: ทีมวิจัยเริ่มจากโมเดลใหญ่ทีเดียว—ราว 1.5 ล้านล้านพารามิเตอร์—แล้วค่อยตัดออก จนเหลือเพียงสองในสาม และผลลัพธ์คือโมเดลฝึกเรียนรู้เร็วขึ้นและทำงานได้ดีกว่าเดิม
ภาพรวมเทคนิคหลัก: ตัดส่วนที่ไม่ทำงานและจัดสมดุลใหม่
แกนกลางของแนวทางนี้ประกอบด้วยสองไอเดียที่จับต้องได้: การตัดส่วนที่ไม่ช่วยเรียนรู้ (automatic pruning) ระหว่างการฝึก และการกระจายงานไปยังชิปให้สมดุล (dynamic load balancing) ทั้งสองอย่างทำงานร่วมกันเพื่อลดความสิ้นเปลืองทรัพยากรและแก้ปัญหาจุดคอขวดในการประมวลผล
Yuan 3.0 Ultra: เริ่มใหญ่เพื่อหาคนใช้จริง
ทีมงานเริ่มด้วยสถาปัตยกรรมที่มีโมดูลย่อยจำนวนมาก โมดูลเหล่านี้คือ "experts" หรือสมองเล็กๆ ภายในโมเดลที่เชี่ยวชาญด้านต่างกัน แนวคิดคือไม่ต้องปลุกทุก expert ทุกครั้ง แต่เลือกเฉพาะที่เหมาะกับงาน
เมื่อฝึกจริงพบว่า expert บางตัวกลายเป็นดาวเด่น ถูกเรียกใช้งานบ่อย ส่วนอีกมากกลับถูกละเลย ไม่ได้เรียนรู้เพิ่มขึ้น เหมือนคนที่ไม่เคยรับผิดชอบงานสำคัญเลยถูกทิ้งให้เป็นผู้สังเกตการณ์ตลอดเวลา
Mixture of Experts: หลายหัวทำงานเป็นทีม แต่มีคนไม่เข้าที
Mixture of Experts หรือ MoE เป็นแนวคิดที่รู้จักมานาน: โมเดลจะมี expert หลายตัว และตัวเลือกที่เรียกว่า router จะตัดสินใจเลือก expert เพียงไม่กี่ตัวให้ทำงานกับอินพุตนั้นๆ ข้อเสียที่เกิดขึ้นทางปฏิบัติคือบาง expertเก่งจนโดดเด่นมาก เกือบทุกคำถามถูกโยนไปหาเขา ส่วน expert อื่นๆ แทบไม่มีโอกาสพัฒนา
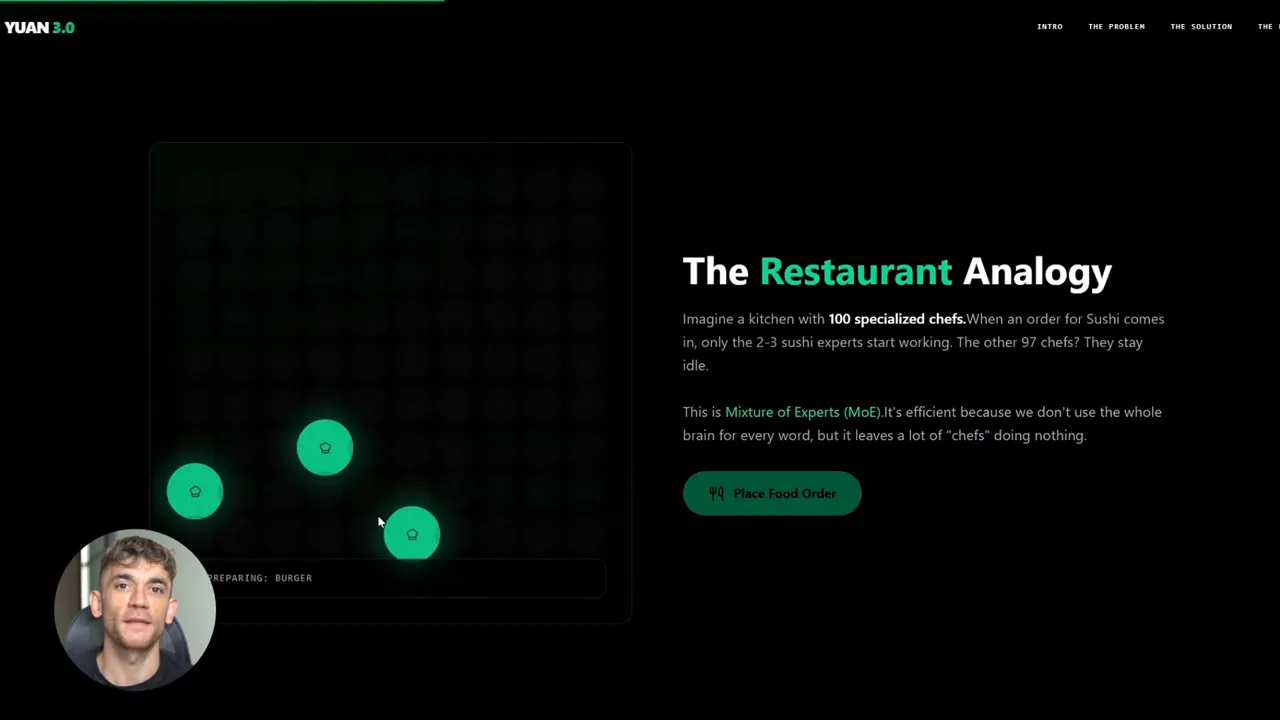
ผลคือความไม่สมดุลทั้งในมุมความสามารถและการใช้งานฮาร์ดแวร์: บางชิปต้องรับภาระหนัก ในขณะที่อีกชิปว่าง งานถึงช้าลงและใช้พลังงานมากขึ้น
การตัดแบบอัตโนมัติระหว่างฝึก (In-training pruning)
ความพิเศษของแนวทางนี้คือการตัดผู้เล่นที่ไม่ช่วยเหลือออกในระหว่างกระบวนการฝึก ไม่ใช่เพียงลบบทเรียนที่จบแล้ว แต่เป็นการให้โมเดลเรียนและเลือกตัดไปพร้อมกัน เหมือนต้นไม้ที่ค่อยๆ หลุดกิ่งแห้งออกขณะงอกกิ่งใหม่
จากการทดลอง ทีมเริ่มที่ 64 experts ต่อเลเยอร์ แล้วปล่อยให้ระบบตัดจนเหลือไม่เกิน 48 ตัว วิธีนี้ทำให้ขนาดโดยรวมลดลงอย่างมาก แต่ความสามารถกลับไม่ลดตาม ในหลายกรณีความแม่นยำกลับสูงขึ้น
การแก้ปัญหาคอขวดของฮาร์ดแวร์
เมื่อ MoE ทำงานจริง จะมีการแผ่กระจายของ expert ไปยังชิปหลายตัว หาก expert บางตัวได้รับความนิยมสูง ชิปที่รับผิดชอบ expert นั้นจะล้น ในขณะที่ชิปอื่นว่างเปล่า ทีมงานเพิ่มชั้นซอฟต์แวร์อีกชั้นเพื่อย้าย expert ไปมาระหว่างชิป ทำให้การใช้งานบาลานซ์กันมากขึ้นและลดเวลารอ
ระบบนี้ไม่ใช่การย้ายแบบคงที่ แต่เป็นการปรับแบบไดนามิก ขณะฝึกทำให้ทรัพยากรถูกใช้ได้เต็มที่ตลอดเวลา
ผลลัพธ์เชิงประสิทธิภาพ: เร็วขึ้นและแม่นขึ้น
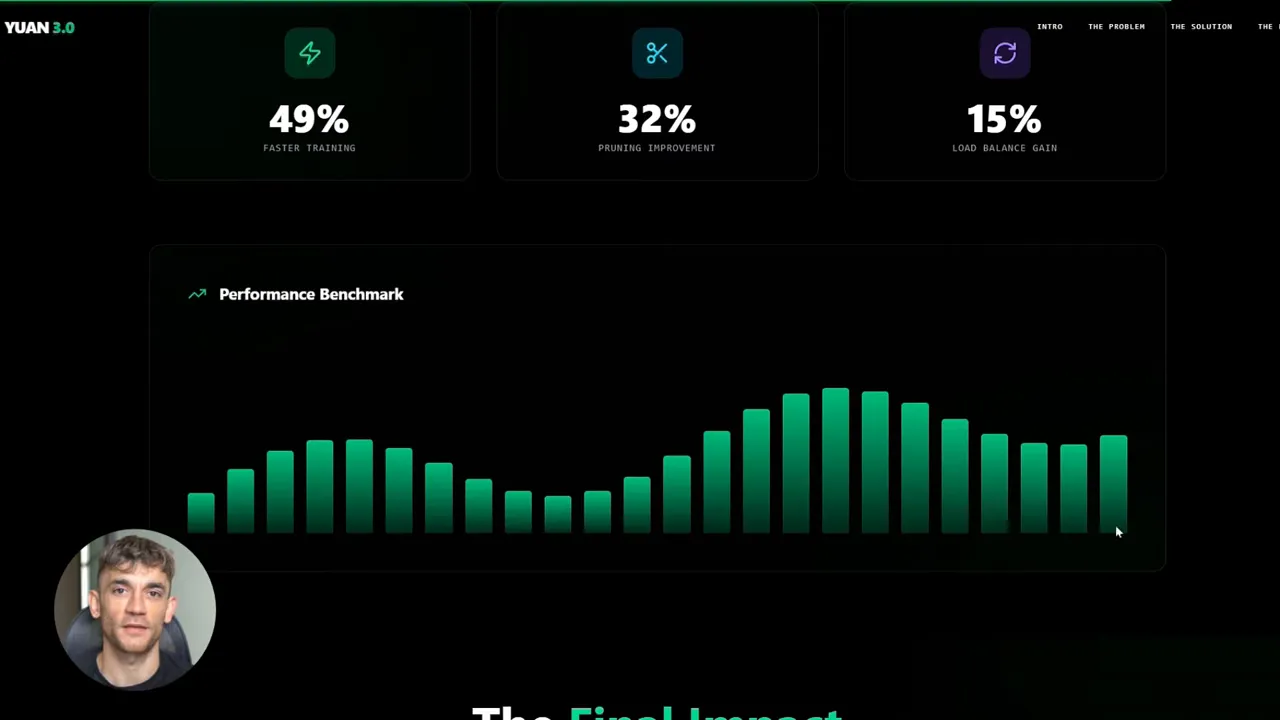
เมื่อรวมการตัดและการบาลานซ์เข้าด้วยกัน ผลที่รายงานคือความเร็วในการฝึกเพิ่มขึ้นประมาณ 49% การตัด alone ให้ประโยชน์ราว 32% และการกระจายโหลดเพิ่มอีก ~15% นั่นหมายความว่าโมเดลฝึกเสร็จเร็วขึ้น ใช้พลังงานน้อยลง และยังได้ผลลัพธ์ที่ดีขึ้น
การทดสอบแบบเป็นขั้นตอน: เริ่มจากรุ่นเล็กขึ้นไปรุ่นใหญ่
ทีมทดลองแนวทางนี้บนรุ่นเล็กก่อน เช่น โมเดลขนาด 10 พันล้านพารามิเตอร์ และ 20 พันล้านพารามิเตอร์ โดยตัดผู้เชี่ยวชาญจำนวนมาก ผลคือความแม่นยำแทบไม่ลด ในบางชุดข้อมูลโมเดลที่ถูกตัดแม้แต่ outperform รุ่นเต็ม
จากนั้นเพิ่มจำนวน experts เป็นสองเท่า สี่เท่า แล้วลองอีกครั้ง หลักการนี้ยังคงใช้ได้ผลเมื่อขนาดเพิ่มขึ้น แสดงให้เห็นว่าแนวทางการตัดขณะเรียนรู้มีความทนทานต่อการ scale
การแก้ปัญหา "คิดเยอะเกินไป" ในช่วงฝึกขั้นปลาย
หลังการฝึกหลัก ทีมเข้าสู่ช่วงที่เรียกว่า finishing school ซึ่งเป็นการฝึกปรับปรุงการให้เหตุผลและการตอบสั้นแต่ตรงประเด็น ปัญหาที่พบบ่อยคือโมเดลมักจะให้คำตอบยาวและมีเหตุผลมากจนเกินความจำเป็น—เหมือนคนที่ตอบเวลาแล้วเล่าย้อนประวัติของนาฬิกาทั้งหมด
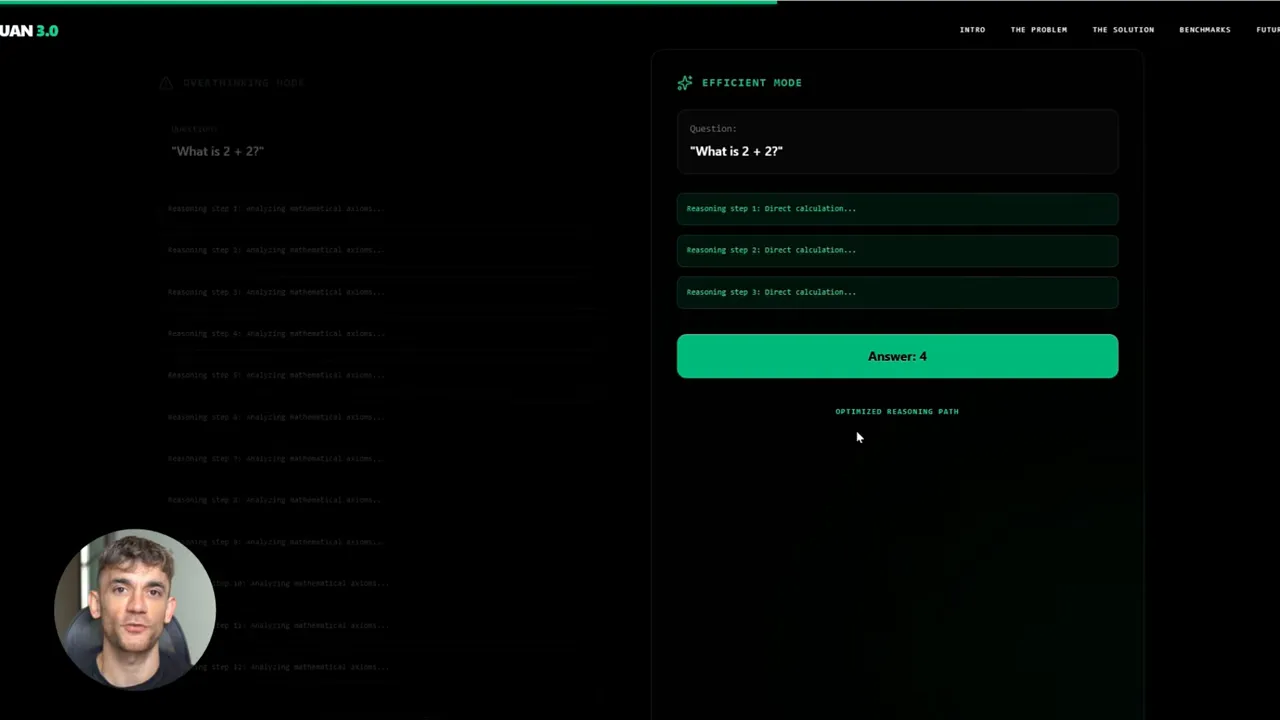
เพื่อแก้ ทีมสร้างระบบให้คะแนนที่ให้รางวัลกับการแก้ปัญหาในจำนวนก้าวที่น้อยลง หากโมเดลแก้คำถามในไม่กี่สเต็ปจะได้คะแนนสูง หากมากกว่า 3 รอบของการคิดตอบตัวเอง คะแนนจะลดลง บางครั้งอาจมีผลเป็นเชิงลบ มาตรการนี้ทำให้ความแม่นยำด้านการให้เหตุผลเพิ่มขึ้นราว 16% ขณะที่ความยาวเฉลี่ยของคำตอบลดลงประมาณ 14%
ตัวชี้วัดการเปรียบเทียบกับชื่อใหญ่ในวงการ
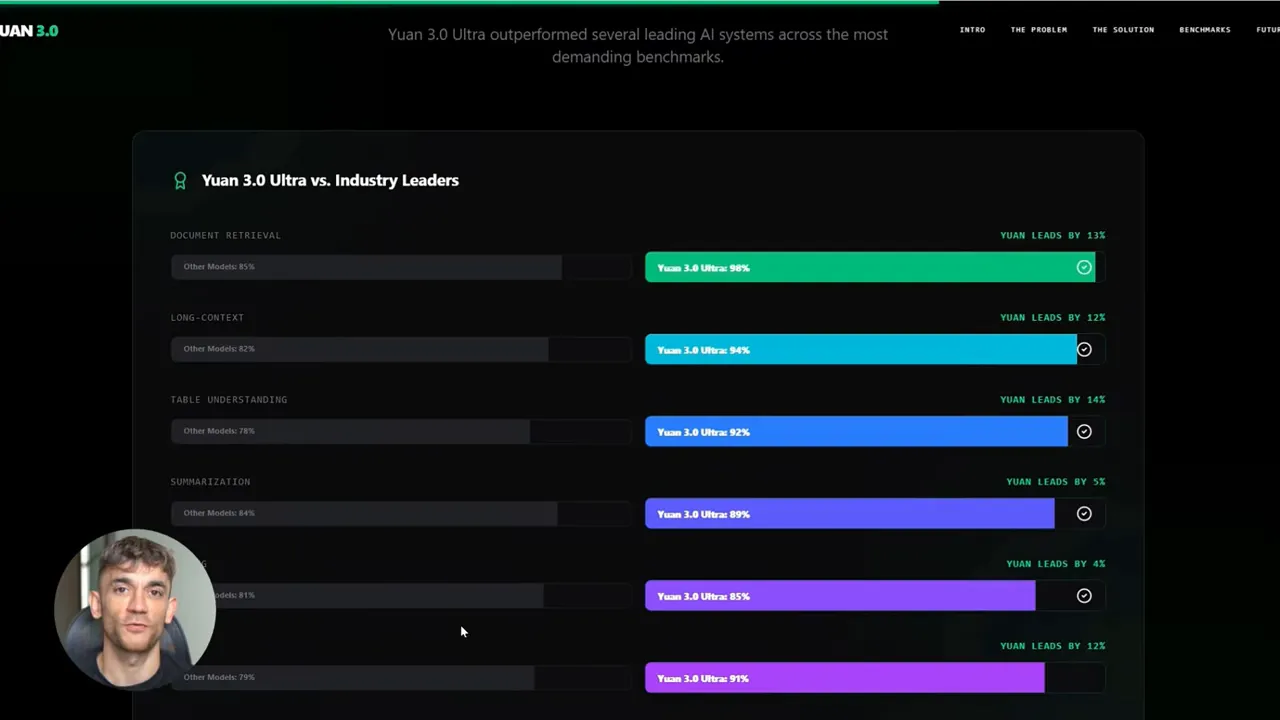
เมื่อทดสอบกับงานจริง Yuan 3.0 Ultra ทำคะแนนเหนือโมเดลใหญ่ๆ ในหลายด้าน ได้แก่
- การค้นหาเอกสาร (document retrieval): คะแนนสูงกว่า GPT, Claude และ Gemini
- การค้นหาเอกสารยาว (long-form retrieval): นำใน 9 จาก 10 งาน
- ความเข้าใจตารางและวิเคราะห์ข้อมูล: ดีกว่าในหลายชุดข้อมูลถึง 15 ชุด
- สรุปเนื้อหา (summarization), โค้ด, คณิตศาสตร์, คิวรีฐานข้อมูล: ผลแข็งแกร่งในหลายดัชนี
ตัวเลขเช่นกว่า 90% ในบางเบนช์มาร์กคณิตศาสตร์ และกว่า 80% ในการทดสอบโค้ด แสดงว่าการออกแบบใหม่ไม่ได้ลดความสามารถพื้นฐาน แต่เพิ่มความคมในการแก้โจทย์เฉพาะ
ทำไมแนวคิดนี้ถึงน่าสนใจและมีผลกระทบกว้าง
ประเด็นใหญ่ที่ต้องตั้งคำถามคือ: ถ้าแนวทางนี้แพร่หลาย เราอาจเห็นการเปลี่ยนแปลงในหลายส่วนของ ecosystem AI
- ค่าใช้จ่ายลดลง: ต้องการชิปน้อยลงและเวลาในการฝึกลดลง ส่งผลให้ต้นทุนรวมลด
- การเข้าถึงมากขึ้น: โมเดลที่ต้องการทรัพยากรน้อยลงช่วยให้บริการขนาดเล็กเข้าถึงความสามารถสูงได้
- การออกแบบเน้นคุณภาพไม่ใช่ปริมาณ: แข่งขันกันที่ความเฉียบคมของสถาปัตยกรรมและนโยบายการฝึกมากกว่าเพียงเพิ่มพารามิเตอร์
เราคิดว่าสิ่งนี้ทำให้การแข่งขันด้าน AI น่าสนใจขึ้น เพราะการเอาชนะอาจมาจากการออกแบบระบบที่คิดว่าอะไรควรอยู่และอะไรควรถูกตัด มากกว่าแค่การเพิ่มขนาด
ข้อควรระวังและคำถามที่ยังเปิดอยู่
แม้ผลลัพธ์จะน่าตื่นเต้น แต่ยังมีประเด็นที่ต้องพิจารณา:
- ความทนทานต่อสภาวะที่ไม่เคยเจอ: การตัดขณะเรียนรู้จะรักษาความสามารถในการ generalize อย่างไรเมื่อต้องรับมือข้อมูลใหม่ที่แตกต่างจากชุดฝึก
- ความเสี่ยงของการลบ expert ที่อาจมีประโยชน์ในอนาคต: อะไรเป็นเกณฑ์ที่ใช้ตัดและมีความเป็นไปได้ที่จะตัดสิ่งที่จำเป็นต่อการเรียนรู้พิเศษในภายหลัง
- ความโปร่งใสและการวัดผล: ต้องมีมาตรวัดชัดเจนเพื่อยืนยันว่า performance ดีขึ้นจริงในภารกิจหลากหลาย ไม่ใช่เพียงบางเบนช์มาร์ก
- ความปลอดภัยและการควบคุมพฤติกรรม: เมื่อโมเดลถูกปรับแต่งให้ตอบสั้นลง อาจทำให้รายละเอียดที่สำคัญหายไปในบางสถานการณ์
แนวทางการนำไปใช้ในธุรกิจและการพัฒนา
สำหรับทีมที่ต้องการนำหลักการนี้ไปใช้ มีแนวทางที่น่าเริ่มต้น:
- ทดลองกับรุ่นขนาดกลางก่อน เพื่อวัดผลกระทบของการตัด expert ต่อภารกิจสำคัญ
- พัฒนากลไกการตรวจสอบการตัดแบบอัตโนมัติ เพื่อย้อนคืนหรือเก็บ expert ที่อาจจำเป็นต่ออนาคต
- นำแนวคิด load balancing มาใช้กับคลัสเตอร์เพื่อปรับปรุงการใช้ทรัพยากรแบบเรียลไทม์
- ออกแบบ reward function สำหรับการให้เหตุผลที่สั้นและตรงจุด โดยทดสอบต่อเนื่องกับชุดคำถามจริงของผู้ใช้
ตัวอย่างเปรียบเทียบเชิงภาพ
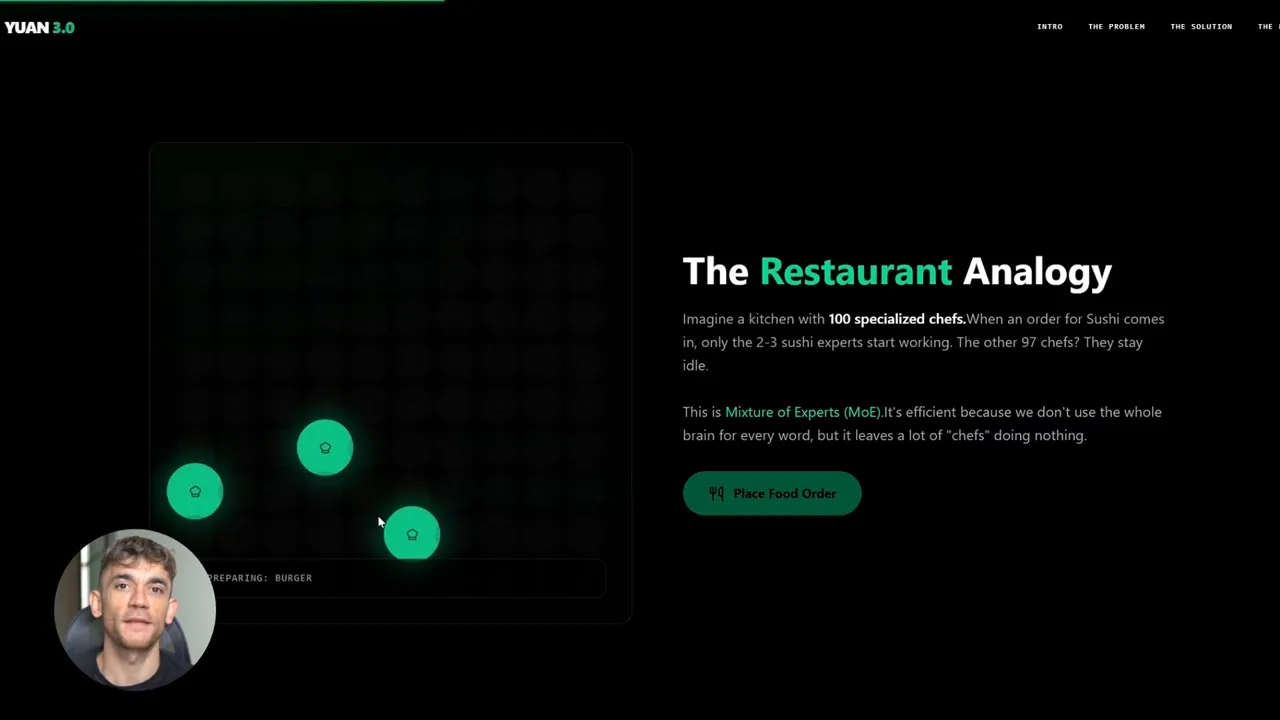
คิดภาพร้านอาหารที่มีเชฟ 100 คน เมื่อมีคำสั่งทำแซนด์วิช ไม่จำเป็นต้องให้ทุกคนร่วมทำ เชฟ 2-3 คนที่ถนัดแซนด์วิชจะทำงาน ส่วนที่เหลือรอ การตัด expert ก็คือการถอดคนที่ไม่เคยได้ส่วนร่วมออก ทำให้ครัวทำงานเร็วและไม่ติดขัด
คำศัพท์เฉพาะที่น่าสนใจ
รวบรวมคำศัพท์ที่ปรากฏและคำอธิบายสั้นเพื่อช่วยให้ผู้อ่านทั่วไปเข้าใจได้ง่ายขึ้น
- Yuan Lab AI: ห้องวิจัยในจีนที่พัฒนา Yuan 3.0 Ultra
- Yuan 3.0 Ultra: ชื่อรุ่นของโมเดลที่ใช้แนวทางตัด expert ระหว่างฝึก
- Parameter: ค่าภายในเครือข่ายประสาทที่โมเดลเรียนรู้
- Expert: โมดูลย่อยภายใน MoE ที่เฉพาะทาง
- Mixture of Experts (MoE): สถาปัตยกรรมที่มี expert หลายตัวและ router เลือกใช้งาน
- Pruning: การตัดส่วนที่ไม่ช่วยให้โมเดลทำงานดีขึ้นออก
- Load balancing: การกระจายงานให้ชิปแต่ละตัวไม่หนักหรือว่างเกินไป
- Document retrieval: งานค้นข้อมูลที่ต้องดึงข้อมูลเฉพาะจากเอกสารจำนวนมาก
- Reward system: ระบบให้คะแนนเพื่อแนะแนวทางการตอบที่ต้องการ เช่น ให้ตอบสั้นแต่ถูกต้อง
สิ่งที่ได้จากคลิปนี้
สรุปใจความสำคัญและมุมมองเชิงผู้เชี่ยวชาญ
- การออกแบบที่ฉลาดสามารถเอาชนะการเพิ่มขนาดเพียงอย่างเดียว
- การตัดขณะเรียนรู้ช่วยลดทรัพยากรและบ่อยครั้งเพิ่มความแม่นยำ
- การจัดการการใช้ฮาร์ดแวร์แบบไดนามิกช่วยแก้ปัญหาคอขวดที่ MoE มักเจอ
- Reward ที่เน้นการคิดสั้นช่วยลดการให้เหตุผลยืดยาวโดยไม่จำเป็น
- แนวทางนี้อาจเปลี่ยนรูปแบบการแข่งขันในวงการ AI จากการแข่งขันขยายขนาดไปสู่การแข่งขันออกแบบให้คม
อ้างอิงเพิ่มเติม: document retrieval