ถ่ายทอดจากคลิป Helena Liu และบทความต้นทางวันที่ 5 สิงหาคม 2026 เป็นเดโม VibeVoice-TTS และ community fork ที่ผู้สาธิตใช้ ไม่ใช่การรับรองคุณภาพภาษาไทย ความปลอดภัยของ fork หรือความพร้อมเชิงพาณิชย์ ผลเสียงและขั้นตอนยังไม่ได้ทดสอบซ้ำ ต้องใช้เสียงที่ได้รับอนุญาตและให้คนตรวจทุกครั้ง · วิดีโอต้นทาง
หมายเหตุจากแหล่งทางการ: Microsoft VibeVoice ระบุว่านำโค้ด VibeVoice-TTS ออกจาก repository เมื่อ 5 กันยายน 2025 หลังพบการใช้นอกวัตถุประสงค์ และไม่แนะนำการใช้งานจริงหรือเชิงพาณิชย์โดยไม่มีการทดสอบและพัฒนาต่อ เดโมในบทความนี้จึงควรอ่านเป็นกรณีทดลอง ไม่ใช่คู่มือรับรองการติดตั้งรุ่นทางการปัจจุบัน
เสียง AI ที่ฟังเป็นมนุษย์มากขึ้นไม่ได้แปลว่าแค่ต้นทุนผลิตคอนเทนต์ถูกลง แต่มันทำให้ทุกธุรกิจมี “ช่องทางเสียง” ของตัวเองได้ ตั้งแต่เสียงต้อนรับหลังลูกค้าสั่งซื้อ ไปจนถึงพอดแคสต์หลายผู้พูดโดยไม่ต้องจองสตูดิโอหรืออัดเสียงใหม่ทุกครั้ง
คลิปของ Helena Liu เล่าถึง VibeVoice โมเดลสร้างเสียงและโคลนเสียงที่นำไปรันบนคอมพิวเตอร์ของเราได้ โดยชี้ให้เห็นว่าคุณภาพเสียงใกล้เคียงบริการแบบเสียค่าสมาชิกรายเดือนหลายเจ้า สิ่งที่น่าสนใจกว่าคำว่า “ฟรี” คือโอกาสสร้าง workflow เสียงที่ธุรกิจควบคุมข้อมูล ต้นทุน และรูปแบบการใช้งานได้เอง
แต่เทคโนโลยีนี้มีอีกด้านที่ต้องพูดตรงๆ คือเมื่อเสียงสมจริงมาก การยืนยันตัวตน การขออนุญาต และการป้องกันการปลอมเสียงไม่ใช่เรื่องเลือกทำ บทความนี้จึงสรุปวิธีเริ่มต้น พร้อมวิเคราะห์ว่า VibeVoice เหมาะกับธุรกิจไทยตรงไหน และควรตั้งรั้วความปลอดภัยอย่างไรตั้งแต่วันแรก
สารบัญ
- Step 1: เข้าใจว่า VibeVoice ให้สิ่งใด และอะไรที่ไม่ควรเชื่อทันที
- Step 2: เลือกขนาดโมเดลให้เหมาะกับทรัพยากรของเรา
- Step 3: ทดสอบเสียงด้วยงานเล็ก ก่อนทำระบบอัตโนมัติ
- Step 4: ใช้หลายผู้พูดเพื่อเปลี่ยนเนื้อหาเดิมเป็นคอนเทนต์เสียง
- Step 5: โคลนเสียงเฉพาะเมื่อมีสิทธิ์และมีเป้าหมายชัดเจน
- Step 6: วางรั้วความปลอดภัยก่อนนำ AI Voice ไปใช้กับลูกค้า
- Step 7: เปลี่ยนเดโมให้เป็น workflow ที่วัดผลได้
- Actionable Insights: สิ่งที่เริ่มทำได้ทันที
- Troubleshooting: แก้ปัญหาที่มักเจอ
- การต่อยอด: จากเครื่องมือเสียงสู่สินทรัพย์ของธุรกิจ
- สรุป Checklist ทั้งหมด
Step 1: เข้าใจว่า VibeVoice ให้สิ่งใด และอะไรที่ไม่ควรเชื่อทันที
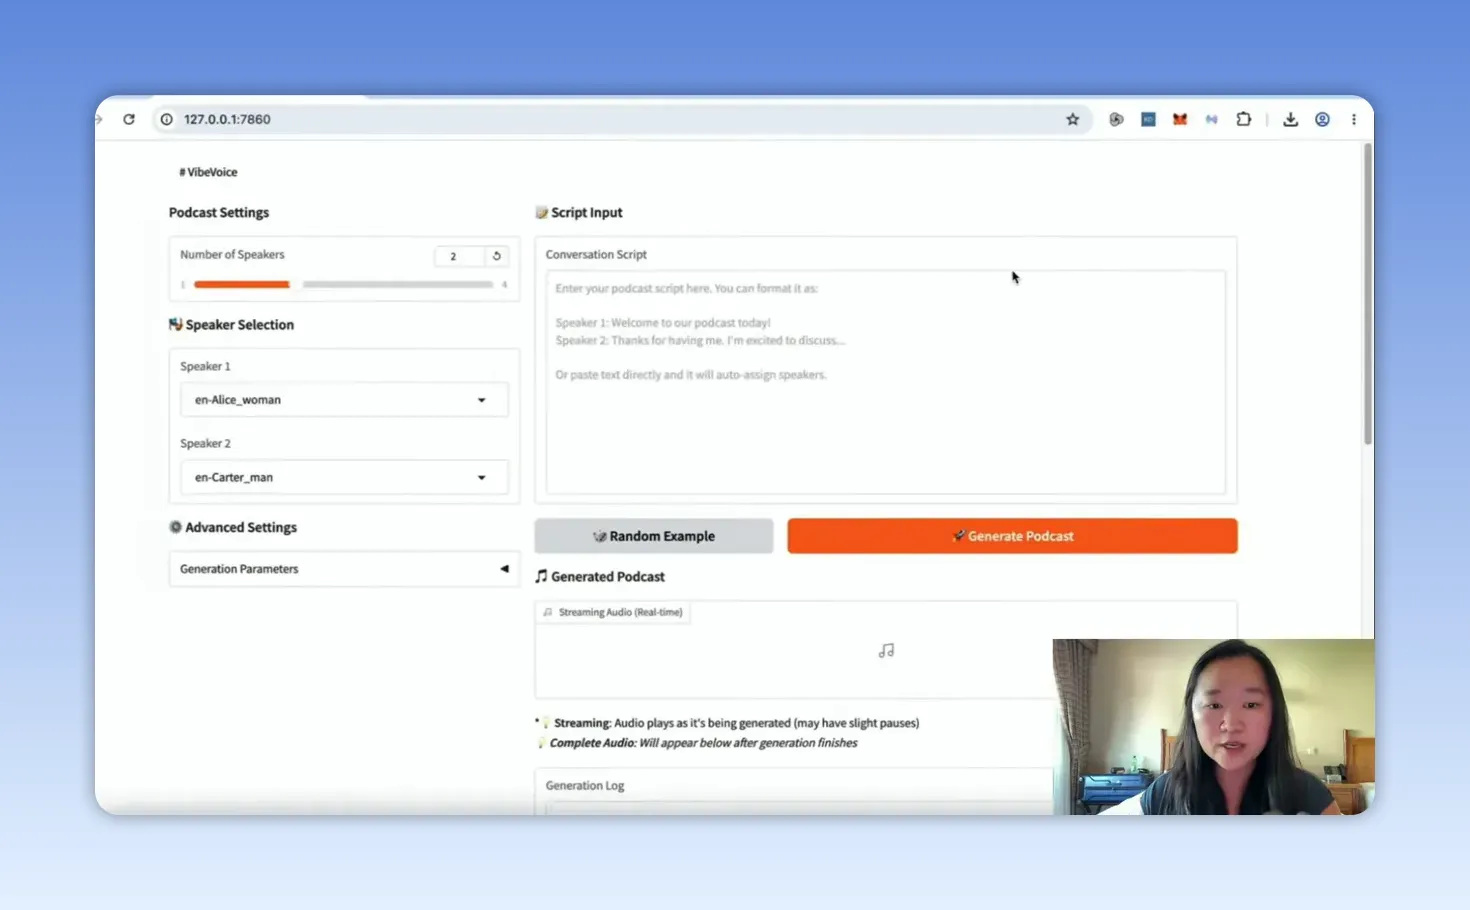
VibeVoice เป็นโมเดล text-to-speech ที่สร้างเสียงพูดจากข้อความ และรองรับการทำเสียงหลายผู้พูดในงานเดียวกันได้ Helena สาธิตว่าระบบมีเสียงสำเร็จรูปให้เลือกประมาณสิบกว่าเสียง เลือกผู้พูดได้สูงสุด 4 คน และมีตัวอย่างสำหรับสร้างบทสนทนาลักษณะพอดแคสต์
ในเดโม ผู้สาธิตรันไฟล์โมเดลและประมวลผลเสียงบนคอมพิวเตอร์ของตน การไม่ส่งข้อมูลออกไปจริงยังขึ้นกับ fork ตัวเชื่อมต่อ และการตั้งค่าที่ใช้ร่วมกัน นี่มีประโยชน์กับองค์กรที่ต้องระวังข้อมูลลูกค้า สคริปต์ภายใน หรือเสียงของผู้บริหาร
ในคลิปมีการอธิบายว่า Microsoft เคยเปิดโค้ด VibeVoice และภายหลังนำส่วนความสามารถ text-to-speech ออกจากเวอร์ชันทางการ เนื่องจากความกังวลเรื่อง deepfake จึงมีสำเนา repository ที่ชุมชนเก็บไว้ก่อนการเปลี่ยนแปลงนั้น ประเด็นนี้ต้องทำให้เราไม่มองเครื่องมือเป็น “ของฟรีที่ใช้ได้ตลอดไป” เพราะ repository แบบ community fork อาจหาย เปลี่ยนแปลง หรือมีความเสี่ยงด้านความปลอดภัยและลิขสิทธิ์ได้
มุมมองที่ควรยึดคือ VibeVoice เป็นเครื่องมือทดลองและสร้างระบบเสียงภายใน ไม่ใช่ใบอนุญาตให้ใช้เสียงใครก็ได้ ก่อนติดตั้ง ควรตรวจสอบแหล่งโค้ด ใบอนุญาตของโมเดล เงื่อนไขการใช้งาน และไฟล์ที่ดาวน์โหลดให้ชัดเจนเสมอ
Step 2: เลือกขนาดโมเดลให้เหมาะกับทรัพยากรของเรา
ในการสาธิตมีโมเดลให้เลือกอย่างน้อย 2 ขนาด คือ 1.5B และ 7B โดยเวอร์ชัน 1.5B มีขนาดเล็กกว่า ส่วน 7B ใช้พื้นที่และทรัพยากรเครื่องมากกว่า การเลือกไม่ควรเริ่มจากคำถามว่า “เอาตัวใหญ่สุดได้ไหม” แต่ควรเริ่มจากงานที่ต้องการสร้างจริง
- เริ่มจาก 1.5B หากต้องการทดลองทำเสียงแจ้งเตือน คลิปสั้น หรือพิสูจน์ว่าเสียง AI ช่วยงานทีมได้จริงหรือไม่
- พิจารณา 7B เมื่อเครื่องรองรับและธุรกิจต้องการเปรียบเทียบคุณภาพเสียงสำหรับงานที่มีผลต่อภาพลักษณ์ เช่น audiobook หรือคอนเทนต์ผู้บริหาร
- วัดเวลาสร้างเสียง ไม่ใช่ฟังแค่ความเพราะ เพราะงานที่ผลิตถี่อาจติดคอขวดจากเวลาประมวลผล
Helena ใช้ Claude Code รุ่น desktop เพื่อสั่ง clone repository ติดตั้งโปรเจกต์ ดาวน์โหลดโมเดล และเปิด local server แนวทางนี้ลดความยุ่งยากในการพิมพ์คำสั่งเอง แต่สำหรับคนทำธุรกิจต้องเข้าใจว่า “ไม่ต้องเขียนโค้ด” ไม่ได้แปลว่า “ไม่มีความเสี่ยง” เราไม่ควรวาง prompt ที่สั่งเครื่องมือให้เข้าถึงไฟล์ทั้งหมด หรืออนุญาตคำสั่งโดยไม่อ่านว่ากำลังติดตั้งอะไร
ทางที่ปลอดภัยกว่าคือใช้โฟลเดอร์โปรเจกต์แยกเฉพาะงานนี้ สำรองข้อมูลก่อนติดตั้ง และให้คนในทีมที่ดูแล IT ตรวจคำสั่งสำคัญ โดยเฉพาะเมื่อใช้ fork ที่ไม่ได้มาจากแหล่งทางการโดยตรง
Step 3: ทดสอบเสียงด้วยงานเล็ก ก่อนทำระบบอัตโนมัติ
หลังเปิด local web app เราสามารถกำหนดจำนวนผู้พูด เลือกเสียงของแต่ละคน วางข้อความ และสั่งสร้างเสียงได้ ผลลัพธ์ที่สาธิตมีจังหวะหยุด น้ำเสียงขึ้นลง และอารมณ์การพูดที่ฟังเป็นธรรมชาติกว่า text-to-speech แบบเดิม
อย่างไรก็ตาม เสียงที่ดีในเดโมภาษาอังกฤษไม่ใช่หลักฐานว่าเสียงภาษาไทยจะดีเท่ากันทุกสถานการณ์ ธุรกิจไทยควรทำชุดทดสอบของตัวเองก่อน โดยใช้ข้อความที่ใกล้งานจริง เช่น ชื่อสินค้า ชื่อจังหวัด ราคาที่มีตัวเลข วันที่ คำอังกฤษปนไทย และข้อความที่ต้องอ่านอย่างสุภาพ
เกณฑ์ทดสอบที่ควรใช้ก่อนเผยแพร่
- อ่านชื่อแบรนด์ ชื่อสินค้า และศัพท์เฉพาะได้ถูกต้องหรือไม่
- เว้นวรรคถูกตำแหน่ง ฟังแล้วไม่เหมือนอ่านข้อความติดกันหรือไม่
- ตัวเลข ราคา เบอร์โทรศัพท์ และวันที่สร้างความเข้าใจผิดหรือไม่
- น้ำเสียงเหมาะกับสถานการณ์ เช่น แจ้งสถานะสินค้า ขอโทษลูกค้า หรือเล่าเรื่องแบรนด์หรือไม่
- เสียงมีความเสถียรเมื่อสร้างข้อความหลายชุดหรือไม่
ควรเริ่มจากสคริปต์ยาวไม่เกิน 30 ถึง 60 วินาที แล้วฟังโดยทีมที่ไม่ได้เขียนสคริปต์ หากทีมยังสะดุดกับคำผิดหรือไม่มั่นใจว่าใครกำลังพูด อย่าเพิ่งนำไปใช้กับลูกค้าจริง การแก้สคริปต์และสร้างใหม่ในช่วงทดสอบถูกกว่าการแก้วิกฤตความน่าเชื่อถือภายหลังมาก
Step 4: ใช้หลายผู้พูดเพื่อเปลี่ยนเนื้อหาเดิมเป็นคอนเทนต์เสียง
ความสามารถหลายผู้พูดคือส่วนที่น่าต่อยอดมากที่สุด VibeVoice สร้างบทสนทนาระหว่างเสียง 2 คนหรือมากกว่านั้นได้ ในตัวอย่างมีการสลับบทสนทนาเหมือนรายการพอดแคสต์ และยังมีตัวอย่างข้อความหลายภาษา เช่น อังกฤษผสมจีน
สำหรับธุรกิจไทย วิธีใช้ที่มีเหตุผลไม่ใช่สร้างพอดแคสต์ยาวเพียงเพราะทำได้ แต่คือเปลี่ยนเนื้อหาที่มีอยู่แล้วให้เข้าถึงง่ายขึ้น ตัวอย่างเช่น ร้านขายอุปกรณ์สุขภาพมีบทความ “เลือกหมอนอย่างไรให้เหมาะกับท่านอน” อาจแปลงเป็นบทสนทนา 3 นาทีระหว่างผู้ดำเนินรายการกับผู้เชี่ยวชาญ จากนั้นตัดเป็นคลิปเสียงสั้นสำหรับ social media หรือแนบในหน้าสินค้า
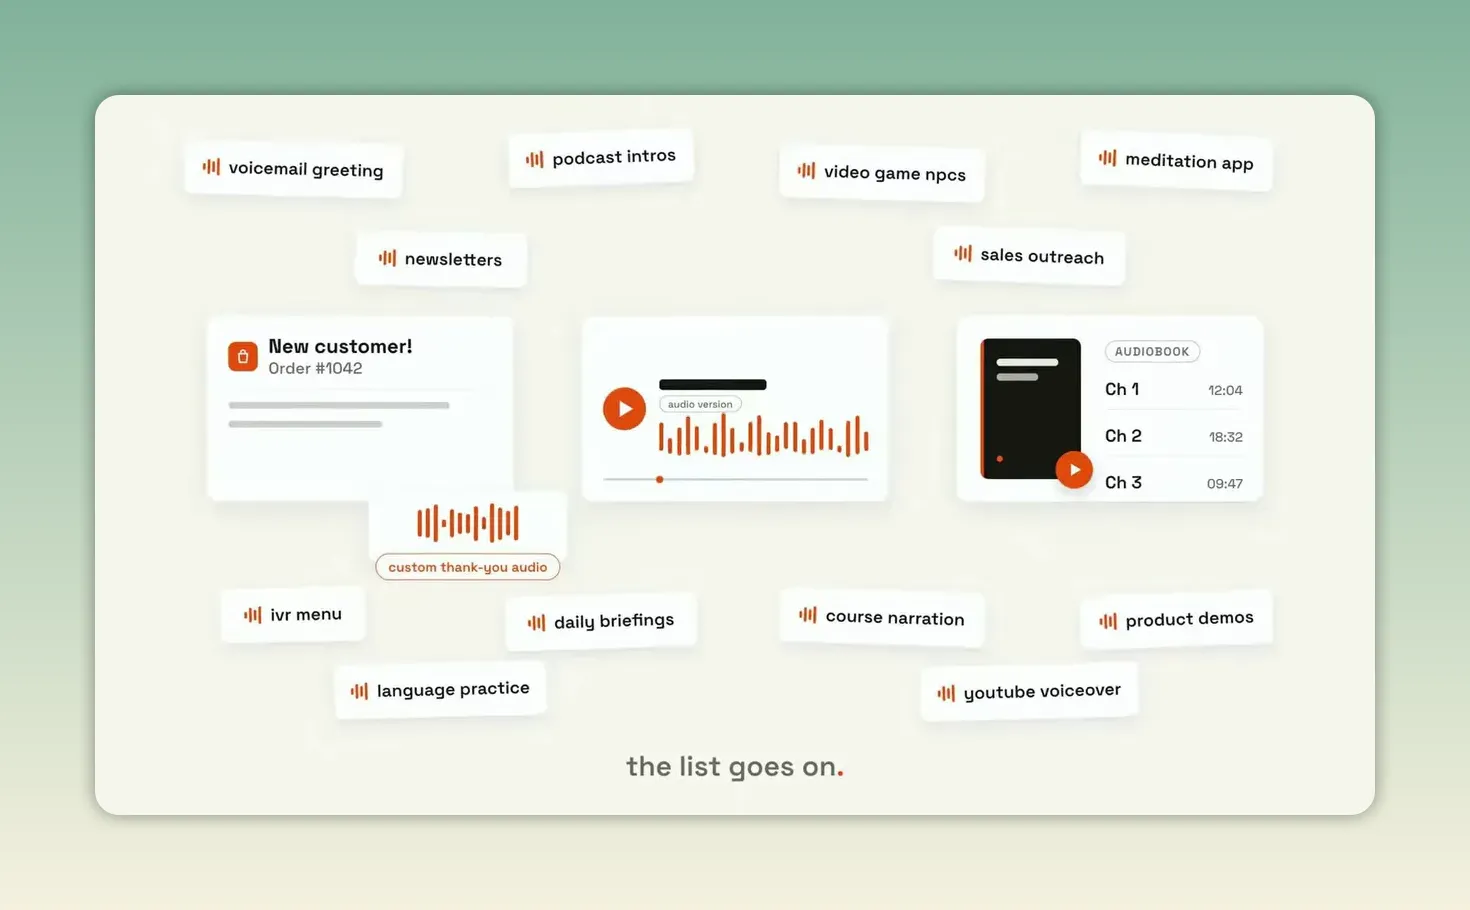
อีกทางหนึ่งคือใช้กับทีมขายและบริการลูกค้า เช่น ทำไฟล์เสียงอธิบายขั้นตอนการใช้งานสินค้า หรือข้อความต้อนรับหลังการสั่งซื้อ แต่ไม่ควรใช้เสียง AI ตอบปัญหาซับซ้อนแทนเจ้าหน้าที่โดยไม่มีช่องทางส่งต่อมนุษย์ เสียงที่ฟังเป็นธรรมชาติอาจทำให้ลูกค้าเข้าใจว่าได้คุยกับคนจริง และความคาดหวังนี้ต้องได้รับการจัดการอย่างโปร่งใส
Step 5: โคลนเสียงเฉพาะเมื่อมีสิทธิ์และมีเป้าหมายชัดเจน
ขั้นตอนโคลนเสียงในคลิปเริ่มจากอัดเสียงพูดอย่างน้อย 30 วินาทีในห้องเงียบ ผ่านแอป Voice Memos บน iPhone แล้วส่งไฟล์มายังคอมพิวเตอร์ จากนั้นแปลงไฟล์ให้เป็น WAV วางในโฟลเดอร์ที่ระบบต้องใช้ และรีสตาร์ต server เพื่อให้เสียงใหม่ปรากฏในรายการเลือกเสียง
ผลลัพธ์สาธิตใกล้เคียงกับต้นฉบับอย่างน่าทึ่ง นั่นทำให้ขั้นตอนนี้มีคุณค่าทางธุรกิจและมีความเสี่ยงสูงพอๆ กัน กติกาขั้นต่ำคือให้โคลนเฉพาะเสียงของเราเอง หรือบุคคลที่ให้ความยินยอมแบบเป็นลายลักษณ์อักษร ระบุขอบเขตการใช้ ระยะเวลา ช่องทางเผยแพร่ และผู้ที่เข้าถึงไฟล์ต้นฉบับได้
สำหรับเจ้าของกิจการ การโคลนเสียงเหมาะกับกรณีเช่น เจ้าของแบรนด์ต้องการบันทึกข้อความต้อนรับมาตรฐานหลายเวอร์ชัน หรือผู้สอนต้องการอัปเดตบทเรียนโดยไม่ต้องเข้าห้องอัดทุกครั้ง แต่ควรบอกให้ชัดว่าเนื้อหานั้นสร้างด้วย AI และห้ามใช้เพื่อยืนยันการโอนเงิน อนุมัติธุรกรรม หรือสื่อสารคำสั่งเร่งด่วนที่เสี่ยงต่อการหลอกลวง
Step 6: วางรั้วความปลอดภัยก่อนนำ AI Voice ไปใช้กับลูกค้า
การที่โมเดลนี้เคยถูกตั้งคำถามเรื่อง deepfake คือบทเรียนตรงที่สุดว่า คุณภาพเสียงไม่ควรเป็นเกณฑ์เดียวในการเลือกใช้ เราควรทำ policy เสียง AI ฉบับสั้นสำหรับทีมก่อนเริ่มผลิตงาน โดยระบุว่าใครอนุมัติสคริปต์ ใครอนุมัติเสียงต้นแบบ และไฟล์ทั้งหมดเก็บที่ใด
หลักที่แนะนำคือแยก “เสียงสร้างสรรค์” ออกจาก “เสียงยืนยันตัวตน” อย่างเด็ดขาด เสียง AI ใช้เล่าเรื่อง อธิบายสินค้า หรือทำสื่อการเรียนรู้ได้ แต่การอนุมัติเงิน การเปลี่ยนบัญชีรับเงิน หรือคำสั่งสำคัญต้องยืนยันซ้ำผ่านช่องทางอื่น เช่น ข้อความในระบบบริษัทหรือการโทรกลับไปยังเบอร์ที่ตรวจสอบแล้ว
หากเราต้องการแนวทางทั่วไปด้านการรับมือ deepfake สามารถศึกษาแหล่งข้อมูลจาก Microsoft Security เพื่อทำความเข้าใจรูปแบบความเสี่ยงเพิ่มเติมได้
Step 7: เปลี่ยนเดโมให้เป็น workflow ที่วัดผลได้
ความผิดพลาดที่พบบ่อยคือเริ่มจากติดตั้งเครื่องมือ แล้วค่อยคิดว่าจะสร้างอะไร วิธีที่คุ้มกว่าคือเริ่มจากงานเสียงหนึ่งชิ้นที่มีความถี่สูง ต้นทุนชัด และตรวจคุณภาพได้ เช่น เสียงแจ้งสถานะคำสั่งซื้อรายสัปดาห์ หรือสรุปบทความเด่นของบริษัทเดือนละ 4 ตอน
สร้าง workflow ง่ายๆ เป็น 5 จุด ได้แก่ เขียนสคริปต์, ตรวจข้อเท็จจริง, สร้างเสียง, ฟังตรวจคุณภาพ, อนุมัติและเผยแพร่ หากจุดใดผิด ให้ย้อนกลับไปแก้เฉพาะจุดนั้น แทนการสร้างทุกอย่างใหม่ การเก็บสคริปต์และไฟล์เสียงเป็นชุดยังช่วยให้ทีมเรียนรู้ว่าการเขียนแบบใดทำให้ AI ออกเสียงดีที่สุด
Actionable Insights: สิ่งที่เริ่มทำได้ทันที
- เลือก 1 งานเสียงที่ทำซ้ำ: เริ่มจากข้อความหลังลูกค้าสั่งซื้อ บทสรุปบทความ หรือคู่มือใช้งานสินค้า ไม่เริ่มจากโปรเจกต์ใหญ่
- ทำชุดทดสอบภาษาไทย: รวมคำแบรนด์ ชื่อสินค้า ตัวเลข และคำอังกฤษปนไทยอย่างน้อย 20 ประโยคก่อนตัดสินใจใช้จริง
- ใช้เสียงสำเร็จรูปก่อนโคลนเสียง: พิสูจน์คุณค่าของ workflow ให้ได้ก่อน แล้วค่อยเพิ่มความเป็นแบรนด์ด้วยเสียงเฉพาะ
- ทำเอกสารยินยอม: หากใช้เสียงพนักงาน ผู้บริหาร หรือ partner ต้องระบุวัตถุประสงค์ ช่องทาง และสิทธิ์ในการถอนความยินยอม
- ติดป้ายความโปร่งใส: แจ้งในจุดที่เหมาะสมว่าเสียงนี้สร้างหรือช่วยสร้างด้วย AI เพื่อไม่ให้ผู้รับสารเข้าใจผิด
Troubleshooting: แก้ปัญหาที่มักเจอ
- ปัญหา: ติดตั้งแล้วเปิดหน้าเว็บแอปไม่ได้
สาเหตุ: server ยังไม่ทำงาน หรือเปิด URL และพอร์ตไม่ตรงกับที่เครื่องมือสร้างไว้
วิธีแก้: ตรวจสถานะ server, คัดลอก URL จากหน้าคำสั่งโดยตรง, รีสตาร์ต server และตรวจว่า firewall ไม่บล็อกการเชื่อมต่อ - ปัญหา: โมเดลดาวน์โหลดนานหรือพื้นที่เครื่องไม่พอ
สาเหตุ: โมเดลขนาดใหญ่ใช้พื้นที่และเวลาโหลดมาก
วิธีแก้: เริ่มจากโมเดล 1.5B, ตรวจพื้นที่ว่างก่อนดาวน์โหลด และเก็บโปรเจกต์ไว้ในไดรฟ์ที่มีพื้นที่เพียงพอ - ปัญหา: เสียงโคลนไม่ปรากฏในรายการเลือกเสียง
สาเหตุ: ไฟล์อยู่ผิดโฟลเดอร์ ใช้นามสกุลไม่รองรับ หรือ server ยังไม่รีสตาร์ต
วิธีแก้: แปลงไฟล์เป็น WAV, ตรวจชื่อและตำแหน่งไฟล์ตามโครงสร้างโปรเจกต์ แล้วรีสตาร์ต server อีกครั้ง - ปัญหา: เสียงโคลนฟังไม่เหมือนต้นฉบับหรือมีเสียงรบกวน
สาเหตุ: ตัวอย่างเสียงสั้นเกินไป มีเสียงแอร์ เสียงสะท้อน หรือพูดไม่ชัด
วิธีแก้: อัดใหม่ในห้องเงียบ พูดต่อเนื่องด้วยระดับเสียงธรรมชาติ และทดสอบด้วยข้อความสั้นก่อนสร้างงานยาว - ปัญหา: เสียงภาษาไทยอ่านชื่อเฉพาะหรือราคาเพี้ยน
สาเหตุ: การออกเสียงหลายภาษาและตัวเลขยังต้องอาศัยรูปแบบสคริปต์ที่เหมาะสม
วิธีแก้: เขียนคำอ่านกำกับในสคริปต์ แยกตัวเลขเป็นคำ ทดสอบทีละประโยค และให้คนในทีมฟังก่อนเผยแพร่
การต่อยอด: จากเครื่องมือเสียงสู่สินทรัพย์ของธุรกิจ
- คลังเสียงแบรนด์: สร้างชุดเสียงสำหรับงานขาย บริการลูกค้า และความรู้ โดยกำหนดน้ำเสียงและคำต้องห้ามของแบรนด์ให้เป็นมาตรฐานเดียวกัน
- แปลงคลังคอนเทนต์เดิม: นำบทความ FAQ คู่มือ และสคริปต์อบรมที่มีอยู่แล้วมาทดลองเป็น audio series เพื่อเพิ่มช่องทางการเข้าถึงโดยไม่ต้องผลิตเนื้อหาใหม่ทั้งหมด
- ระบบอนุมัติเนื้อหา: เชื่อม workflow เสียงเข้ากับขั้นตอนตรวจสคริปต์และอนุมัติโดยมนุษย์ เพื่อให้ขยายปริมาณคอนเทนต์ได้โดยไม่เสียการควบคุม
สรุป Checklist ทั้งหมด
- ☐ กำหนด use case เสียงหนึ่งงานที่วัดผลได้
- ☐ ตรวจแหล่ง repository ใบอนุญาต และความน่าเชื่อถือก่อนติดตั้ง
- ☐ เลือกโมเดล 1.5B หรือ 7B ตามทรัพยากรเครื่องและเป้าหมายงาน
- ☐ แยกโฟลเดอร์โปรเจกต์และสำรองข้อมูลก่อนใช้เครื่องมือ local
- ☐ เปิด local web app และทดสอบเสียงสำเร็จรูปก่อน
- ☐ ทำชุดทดสอบภาษาไทยที่มีคำแบรนด์ ตัวเลข และศัพท์เฉพาะ
- ☐ ใช้หลายผู้พูดกับเนื้อหาที่มีโครงสร้างบทสนทนาจริง
- ☐ โคลนเฉพาะเสียงที่เราได้รับสิทธิ์ใช้งานอย่างชัดเจน
- ☐ เก็บเอกสารยินยอมและจำกัดสิทธิ์เข้าถึงไฟล์เสียงต้นฉบับ
- ☐ ห้ามใช้เสียง AI เป็นหลักฐานยืนยันธุรกรรมหรือคำสั่งการเงิน
- ☐ ให้มนุษย์ตรวจเสียงและข้อเท็จจริงก่อนเผยแพร่ทุกครั้ง
- ☐ แจ้งการใช้ AI อย่างโปร่งใสเมื่อมีโอกาสทำให้ผู้รับสารเข้าใจผิด
VibeVoice ทำให้การสร้าง AI Voice และการโคลนเสียงเข้าถึงได้มากขึ้น แต่คุณค่าของมันไม่ได้อยู่ที่การสร้างเสียงได้ไม่จำกัด คุณค่าอยู่ที่การเลือกงานที่เหมาะ วาง workflow ที่ตรวจสอบได้ และปกป้องความน่าเชื่อถือของแบรนด์ไปพร้อมกัน ธุรกิจที่เริ่มจาก use case เล็ก วัดผลจริง และใช้เสียงอย่างรับผิดชอบ จะได้ประโยชน์จากเทคโนโลยีนี้มากกว่าธุรกิจที่ไล่ตามความสมจริงเพียงอย่างเดียว