วันที่บทความต้นทางใน VTB: 9 กันยายน 2026 (2026-09-09) · วันที่อัปโหลดวิดีโอยังไม่ได้รับการยืนยัน
ถ่ายทอดจากบทความต้นทางและคลิป It’s Tokens All The Way Down: How RLMs are Different — Kevin Madura, AlixPartners ของ AI Engineer รายละเอียดเครื่องมือ ตัวเลข และข้อสังเกตเป็นข้อมูลที่แหล่งต้นทางกล่าวถึงในขณะนั้น ไม่ใช่ผลทดสอบอิสระหรือการยืนยันสถานะล่าสุด ตัวอย่างและข้อเสนอแนะสำหรับธุรกิจไทยคงจากบทความต้นทาง
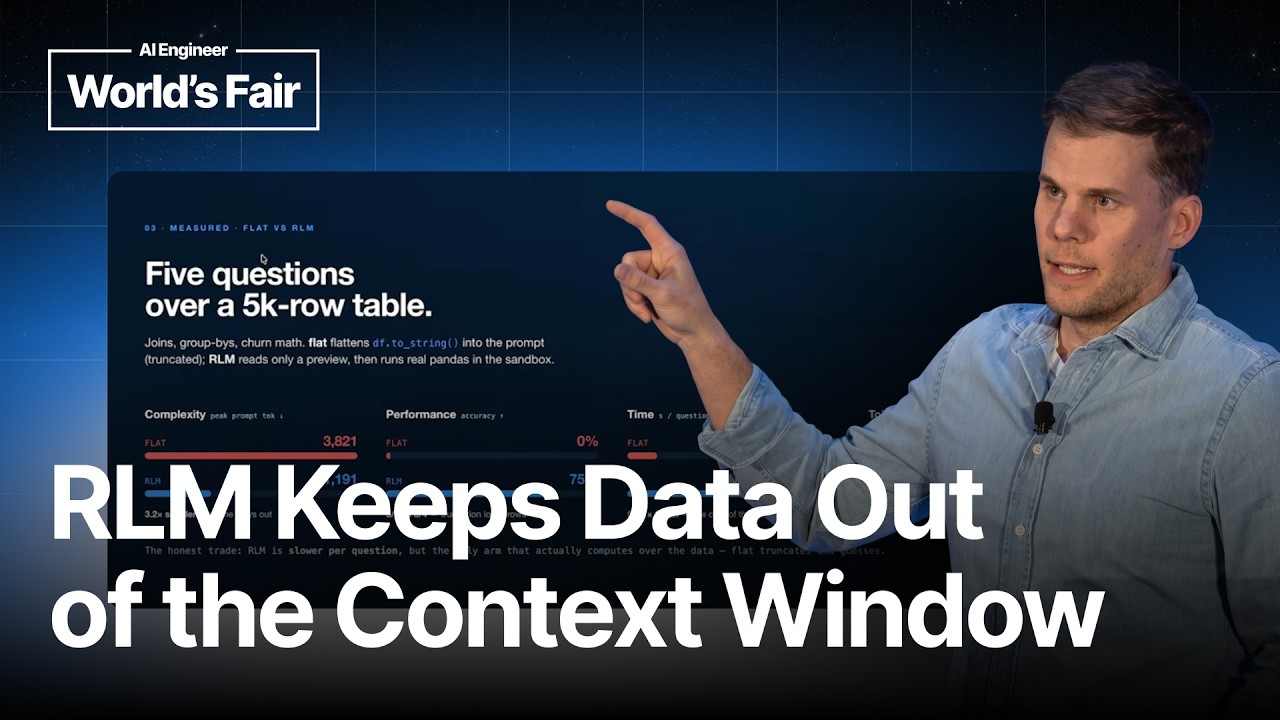
Kevin Madura อธิบาย RLM ผ่านตัวอย่างทดลองและเดโมของเขา ผลเปรียบเทียบในคลิปไม่ใช่ benchmark ที่บทความทดสอบซ้ำ และผู้บรรยายเองระบุว่าบางการเปรียบเทียบยังต้องศึกษาเพิ่มเติม
หลายธุรกิจเริ่มเจอปัญหาเดียวกันเมื่อใช้ AI กับงานจริง: เอกสารมีหลายร้อยหน้า ข้อมูลลูกค้ามีหลายไฟล์ และ log ระบบยาวเกินกว่าจะโยนเข้า prompt เดียวได้ ผลลัพธ์จึงช้า แพง และบางครั้งผิดในจุดสำคัญ ทั้งที่ AI ดูเหมือนอ่านข้อมูลครบแล้ว
คลิปจาก Kevin Madura แห่ง AlixPartners บนช่อง AI Engineer เสนอแนวทางที่น่าสนใจชื่อว่า Recursive Language Model หรือ RLM แก่นของมันไม่ใช่การเพิ่ม context window ให้ยาวขึ้น แต่เป็นการเปลี่ยนวิธีที่ AI เข้าถึงข้อมูล จากเดิมที่ต้องพยายามจำทุก token มาเป็นการเปิดให้ AI จัดการข้อมูลเป็นวัตถุ ใช้โค้ดสำรวจ คำนวณ แบ่งงาน และเรียก AI ย่อยเมื่อจำเป็น
สำหรับเจ้าของธุรกิจไทย นี่อาจยังไม่ใช่เทคโนโลยีที่ต้องรีบสร้างเองทันที แต่เป็นกรอบคิดสำคัญในการเลือก AI platform และออกแบบ workflow ที่ต้องทำงานกับข้อมูลขนาดใหญ่
สารบัญ
- Step 1: เข้าใจว่า RLM เปลี่ยน AI จากคนอ่านเป็นคนลงมือวิเคราะห์
- Step 2: แยกให้ออกระหว่าง RLM, RAG, agent และ tool calling
- Step 3: เลือกงานธุรกิจที่ RLM มีโอกาสคุ้มค่า
- Step 4: ออกแบบ deterministic shell ก่อนปล่อยให้ AI ทำงาน
- Step 5: มอง use case ที่ผู้บรรยายนำมาเป็นตัวอย่าง
- Step 6: Actionable Insights ที่เริ่มทำได้ในองค์กร
- Step 7: แก้ปัญหาที่มักเจอเมื่อใช้ AI วิเคราะห์ข้อมูลขนาดใหญ่
- Step 8: ต่อยอดจากรายงานสู่ AI workflow ที่ตรวจสอบได้
- Step 9: สรุป Checklist ทั้งหมดก่อนเริ่มใช้ RLM
Step 1: เข้าใจว่า RLM เปลี่ยน AI จากคนอ่านเป็นคนลงมือวิเคราะห์
RLM ย่อมาจาก Recursive Language Model หรือโมเดลภาษาที่แก้ปัญหาแบบแตกงานซ้ำเป็นชั้นๆ ความต่างหลักอยู่ที่การเก็บข้อมูลต้นทาง เช่น PDF, spreadsheet, ตารางข้อมูล หรือข้อความยาวมาก ไว้เป็นตัวแปรในสภาพแวดล้อมสำหรับรันโค้ด เช่น Python REPL
AI จึงไม่จำเป็นต้องรับข้อมูลทั้งหมดเข้ามาใน context พร้อมกัน แต่เลือกสำรวจเฉพาะส่วนที่ต้องใช้ได้ เช่น ค้นหาชื่อสินค้า กรองเฉพาะใบแจ้งหนี้เดือนล่าสุด รวมยอดในคอลัมน์ หรือเปรียบเทียบข้อมูลระหว่างหลายตาราง
ลองเทียบภาพง่ายๆ หากเราส่งสัญญาหลายร้อยหน้าให้ AI แบบปกติ AI ต้องอ่านข้อความจำนวนมากและพยายามเชื่อมทุกส่วนในคราวเดียว แต่ RLM ทำหน้าที่คล้ายทีมวิเคราะห์ที่มีไฟล์งานอยู่ตรงหน้า สามารถค้นคำสำคัญ เปิดเฉพาะหน้าเกี่ยวข้อง คำนวณตัวเลข และสรุปเฉพาะประเด็นกลับมา
ส่วนคำว่า recursive หมายถึง AI หลักสามารถมอบหมายงานย่อยให้ AI อีกตัวได้ รวมถึงเรียกตัวเองด้วยโจทย์ย่อยที่ชัดกว่า ตัวอย่างเช่น งานใหญ่คือ “วิเคราะห์สาเหตุที่ลูกค้าซื้อซ้ำน้อยลง” งานย่อยอาจแยกเป็นการวิเคราะห์ cohort, ตรวจส่วนลด, หาความเปลี่ยนแปลงของสินค้า และสรุปคำร้องเรียน จากนั้นจึงนำผลลัพธ์ที่ผ่านการคัดแล้วกลับมาสังเคราะห์เป็นข้อเสนอเดียว
Step 2: แยกให้ออกระหว่าง RLM, RAG, agent และ tool calling
RLM ไม่ได้ทำให้ RAG หรือ agent หมดความหมาย แต่เหมาะกับปัญหาคนละประเภท การแยกความต่างให้ชัดช่วยให้เราไม่ลงทุนผิดจุด
- RAG: ค้นส่วนของเอกสารที่น่าจะเกี่ยวข้อง แล้วส่งข้อความเหล่านั้นเข้า context ของโมเดล เหมาะกับระบบถามตอบจากคลังความรู้ที่คำตอบมักอยู่ในข้อความบางส่วน
- Agent และ tool calling: AI เรียกเครื่องมือภายนอกและส่งผลกลับไปมักในรูปแบบข้อความหรือ JSON เหมาะกับงานที่ต้องค้นเว็บ เรียก CRM ส่งอีเมล หรืออัปเดตระบบ
- RLM: เก็บข้อมูลขนาดใหญ่เป็นตัวแปร แล้วให้ AI เขียนโค้ดเพื่อค้น กรอง คำนวณ และแตกงาน โดยนำกลับเข้ามาเฉพาะผลที่จำเป็นต่อการตัดสินใจ
ข้อจำกัดของแนวทางเดิมคือเมื่อยัดข้อความเข้า context มากขึ้น คุณภาพการตอบอาจเริ่มเสื่อม ปรากฏการณ์นี้มักเรียกว่า context rot โมเดลอาจพลาดข้อความสำคัญ สับสนกับรายละเอียดที่คล้ายกัน หรือเสียต้นทุนกับข้อมูลที่ไม่เกี่ยวกับคำถาม
RLM ลดปัญหานี้ด้วยการไม่บังคับให้โมเดลหลัก “สนใจ” ทุก token ตลอดเวลา ข้อมูลยังอยู่ใน environment แต่โมเดลเลือกหยิบใช้เท่าที่จำเป็น แนวคิดนี้ต่างจากการส่ง JSON ไปมา เพราะตรรกะ การรันงาน และผลลัพธ์อยู่ใกล้กันมากกว่า
มุมมองที่ควรระวังคือ RLM ไม่ใช่สูตรวิเศษสำหรับทุกงาน หากโจทย์เป็นการตอบ FAQ สั้นๆ หรือค้นหานโยบายบริษัทเพียงหนึ่งย่อหน้า RAG ที่ออกแบบดีอาจเรียบง่ายกว่า ถูกกว่า และดูแลง่ายกว่า
Step 3: เลือกงานธุรกิจที่ RLM มีโอกาสคุ้มค่า
Kevin Madura เสนอเกณฑ์ชัดเจนว่า RLM เหมาะเมื่อ input หรือ output มีขนาดใหญ่ งานสามารถแตกเป็นส่วนย่อยได้ และกระบวนการมีระยะเวลาทำงานนานพอสมควร ขณะเดียวกัน ไม่เหมาะกับงานที่ข้อมูลพอดีกับ context อยู่แล้ว งานที่ต้องตอบแทบจะทันที หรือสถานการณ์ที่โมเดลยังเขียนโค้ดได้ไม่ดีพอ
สำหรับธุรกิจไทย งานที่มีลักษณะใกล้เคียงมีดังนี้
- รวมข้อมูลจากใบแจ้งหนี้ ใบเสนอราคา และไฟล์ Excel หลายแหล่ง เพื่อสร้างรายงานยอดซื้อหรือสต๊อกกลาง
- วิเคราะห์ข้อมูลยอดขายและสมาชิก เพื่อหา cohort ที่กลับมาซื้อน้อยลง
- อ่านสัญญา คู่มือ และเอกสารจัดซื้อจำนวนมาก เพื่อดึงเงื่อนไขที่ต้องตรวจทานต่อ
- ค้นหารูปแบบผิดปกติจาก log การใช้งาน ระบบชำระเงิน หรือข้อความร้องเรียนลูกค้า
- สร้างรายงานสรุปจากชุดข้อมูลที่คนทำงานต้องเสียเวลาคัดกรองด้วยมือเป็นวัน
ตัวอย่างหนึ่งที่ชัดมากคือการหาผลรวมของตัวเลข 12 ค่า ซึ่งกระจายอยู่ในข้อความยาว 30,000 token ถ้าสั่งโมเดลให้หาและบวกเอง โมเดลอาจพลาดได้ แต่ RLM สามารถเขียน regex หรือโค้ดสั้นๆ เพื่อดึงตัวเลขตามเงื่อนไข แล้วให้โปรแกรมคำนวณอย่างตรงไปตรงมา
บทเรียนสำหรับงานธุรกิจคือ อย่าบังคับ AI ให้ทำสิ่งที่คอมพิวเตอร์ทำได้แน่นอนกว่า AI ควรใช้ตีความโจทย์ เลือกวิธีวิเคราะห์ และอธิบายความหมายของผลลัพธ์ ส่วนการนับ การรวม การกรอง และการตรวจรูปแบบ ควรให้โค้ดหรือระบบฐานข้อมูลช่วยทำ
Step 4: ออกแบบ deterministic shell ก่อนปล่อยให้ AI ทำงาน
แนวคิดที่มีประโยชน์ที่สุดจากคลิปนี้คือการสร้าง deterministic shell หรือกรอบงานที่ควบคุมได้ แล้วเปิดพื้นที่ให้ AI ตัดสินใจเฉพาะส่วนกลางของงาน
ในภาษาคนทำธุรกิจ เราไม่จำเป็นต้องกำหนดทุกคลิกให้ AI แต่ต้องกำหนดให้ชัดว่าอะไรเข้า อะไรออก และอะไรห้ามผิด ตัวอย่าง workflow วิเคราะห์ยอดขายควรกำหนดอย่างน้อย 4 เรื่อง
- ข้อมูลนำเข้า: ไฟล์ยอดขาย ลูกค้า และสินค้าชุดใด ใช้ช่วงเวลาใด และคอลัมน์ใดเป็นแหล่งอ้างอิง
- เป้าหมายธุรกิจ: ต้องการหาอะไร เช่น เหตุผลที่รายได้จากลูกค้าเดิมลดลง หรือรายการสินค้าที่ควรเติมสต๊อก
- รูปแบบคำตอบ: ต้องการตารางสรุป ข้อค้นพบ 5 ข้อ ความเสี่ยง และข้อเสนอแนะที่จัดลำดับตามผลกระทบ
- รั้วความปลอดภัย: จำกัดจำนวนรอบการวิเคราะห์ กำหนดสิทธิ์เข้าถึงข้อมูล และบังคับให้แนบหลักฐานจากแถวข้อมูลที่เกี่ยวข้อง
ตัวอย่าง cohort retention ในคลิปใช้ data frame 3 ชุด กำหนดว่าต้องวิเคราะห์อะไรและต้องส่งผลลัพธ์ชนิดใด จากนั้น RLM สำรวจข้อมูลใน REPL เขียนโค้ดตรวจสอบผลลัพธ์เป็นลำดับ และส่งคำตอบสุดท้ายเมื่อประเมินว่างานเสร็จ โดยสามารถกำหนดเพดานจำนวนรอบ เช่น 10 หรือ 100 รอบได้
จุดที่เราเห็นด้วยเพียงบางส่วนคือ การยกระดับ abstraction ช่วยลดภาระ context engineering จริง แต่ไม่ได้แปลว่าไม่ต้องออกแบบอะไรเลย เป้าหมายที่กำกวม ข้อมูลสกปรก หรือ KPI ที่ไม่ตรงกัน จะทำให้ AI วิเคราะห์ได้ผิดทิศทางเร็วขึ้น ไม่ใช่ช้าลง
Step 5: มอง use case ที่ผู้บรรยายนำมาเป็นตัวอย่าง
ตัวอย่าง use case ในคลิปมีตั้งแต่งานเอกสารไปจนถึงความปลอดภัยของซอฟต์แวร์ สิ่งที่เชื่อมทุกกรณีคือข้อมูลมีขนาดใหญ่ โครงสร้างไม่สม่ำเสมอ และต้องอาศัยการค้นหาแบบวนซ้ำ
การรวมใบแจ้งหนี้เป็น inventory กลาง เป็นกรณีที่ใกล้ตัวธุรกิจที่สุด เอกสารแต่ละเจ้ามักใช้รูปแบบต่างกัน บางชุดยาวมาก และมีหลายรายการต่อหน้า RLM สามารถไล่อ่านไฟล์เหล่านี้ ดึงชื่อสินค้า ปริมาณ และราคา ก่อนทำรายการรวมได้ โดยในตัวอย่างที่ผู้บรรยายยกมา ช่วยลดภาระการออกแบบการแบ่งเอกสารและทำ embedding เองตั้งแต่ต้น
กรณีอื่นคือการใช้ข้อมูล log เพื่อหาเหตุการณ์ผิดปกติ และการวิเคราะห์ trace ของ agent เพื่อเสนอวิธีปรับปรุง harness หรือโครงสร้างควบคุม agent เอง แม้เรื่องหลังจะเป็นงานเทคนิคมากกว่า แต่เจ้าของธุรกิจควรสนใจในฐานะเครื่องมือควบคุมต้นทุนและความน่าเชื่อถือของ AI workflow
อีกตัวอย่างคือการสแกน codebase ขนาดประมาณ 500,000 บรรทัดเพื่อสร้างรายงานความปลอดภัย โดยอ้างอิงแอปที่ตั้งใจสร้างให้มีช่องโหว่จาก OWASP ตามที่ผู้บรรยายอธิบาย กรณีนี้ไม่ควรตีความว่า AI แทนผู้ตรวจความปลอดภัยได้ แต่แสดงให้เห็นศักยภาพของ RLM ในการช่วยคัดจุดที่ควรส่งต่อให้ผู้เชี่ยวชาญตรวจละเอียด
สำหรับบริษัทที่ยังไม่มีทีม data หรือ engineering ขนาดใหญ่ ทางเลือกที่เหมาะกว่าการสร้าง RLM เอง คือเลือก platform หรือผู้ให้บริการที่มีความสามารถวิเคราะห์ไฟล์ ตาราง และเอกสารขนาดใหญ่ พร้อม trace ตรวจสอบย้อนหลังได้ สิ่งที่ต้องลงทุนก่อนจึงไม่ใช่โค้ด แต่คือการจัดระเบียบไฟล์ นิยามข้อมูล และเกณฑ์ตัดสินใจของธุรกิจ
Step 6: Actionable Insights ที่เริ่มทำได้ในองค์กร
- เริ่มจากงานที่คนใช้เวลาเกิน 2 ชั่วโมงต่อสัปดาห์: เลือกงานวิเคราะห์เอกสารหรือ spreadsheet ซ้ำๆ ที่มีผลลัพธ์ตรวจได้
- เขียนผลลัพธ์ปลายทางก่อนเลือกเครื่องมือ: ระบุว่าต้องได้ตาราง รายงาน หรือรายการตรวจสอบอะไร ไม่ใช่เริ่มจากคำว่า “อยากใช้ AI”
- แยกงานตีความออกจากงานคำนวณ: ให้ AI สรุปและตั้งสมมติฐาน แต่ให้ระบบคำนวณยอด ตัวเลข และกฎตรวจสอบ
- บังคับให้ผลลัพธ์ย้อนกลับไปหาหลักฐานได้: ทุกข้อค้นพบสำคัญควรระบุไฟล์ หน้า แถวข้อมูล หรือช่วงเวลาที่เกี่ยวข้อง
- วัดต้นทุนต่อผลลัพธ์: เปรียบเทียบเวลา ค่าใช้จ่าย และอัตราความผิดพลาดกับวิธีเดิมก่อนขยาย workflow
Step 7: แก้ปัญหาที่มักเจอเมื่อใช้ AI วิเคราะห์ข้อมูลขนาดใหญ่
- ปัญหา: AI สรุปดูน่าเชื่อถือ แต่ยอดรวมไม่ตรง
สาเหตุ: โมเดลอ่านตัวเลขจากข้อความแทนการคำนวณจากข้อมูลต้นทาง
วิธีแก้: แยกขั้นตอนดึงข้อมูล คำนวณ และสรุปผลออกจากกัน แล้วตรวจยอดรวมกับสูตรที่กำหนดไว้ - ปัญหา: คำตอบแต่ละครั้งไม่เหมือนกัน
สาเหตุ: โจทย์และรูปแบบผลลัพธ์เปิดกว้างเกินไป
วิธีแก้: กำหนด schema ของคำตอบ เช่น ตัวชี้วัด หลักฐาน ความมั่นใจ และข้อเสนอแนะให้ตายตัว - ปัญหา: ค่าใช้จ่ายเพิ่มขึ้นเมื่อใช้ข้อมูลมากขึ้น
สาเหตุ: ส่งเอกสารหรือข้อมูลทั้งหมดเข้า context ซ้ำในทุกคำถาม
วิธีแก้: ใช้ workflow ที่เลือกอ่านเฉพาะส่วนเกี่ยวข้อง จำกัดจำนวนรอบ และบันทึกผลการวิเคราะห์ที่ใช้ซ้ำได้ - ปัญหา: ทีมไม่กล้าใช้ผลลัพธ์ในการตัดสินใจ
สาเหตุ: มองไม่เห็นว่า AI ใช้วิธีใดและใช้ข้อมูลส่วนไหน
วิธีแก้: เลือกเครื่องมือที่แสดง trace ของขั้นตอน พร้อมให้คนตรวจจุดสำคัญก่อนนำผลไปใช้งาน - ปัญหา: ระบบเข้าถึงเอกสารสำคัญมากเกินจำเป็น
สาเหตุ: ออกแบบสิทธิ์การเข้าถึงตามความสะดวกแทนความเสี่ยง
วิธีแก้: แบ่งชุดข้อมูลตามหน้าที่ ปกปิดข้อมูลส่วนบุคคล และกำหนดผู้อนุมัติสำหรับงานที่กระทบการเงิน กฎหมาย หรือข้อมูลลูกค้า
Step 8: ต่อยอดจากรายงานสู่ AI workflow ที่ตรวจสอบได้
แนวคิด RLM เปิดทางให้เราต่อยอดได้หลายแบบ โดยไม่ต้องเริ่มจากโครงการใหญ่
- ศูนย์รวมเอกสารจัดซื้อ: รับใบเสนอราคา ใบแจ้งหนี้ และสัญญา แล้วให้ AI ทำตารางเปรียบเทียบ พร้อมปักธงเงื่อนไขหรือราคาที่ผิดปกติ
- ผู้ช่วยประชุมผู้บริหาร: รวมยอดขาย สต๊อก แคมเปญ และข้อร้องเรียนเป็นชุดข้อมูลเดียว ให้ระบบเตรียมข้อค้นพบพร้อมหลักฐานก่อนประชุม
- ระบบตรวจสุขภาพ workflow: เก็บ trace ของ AI ที่ใช้อยู่ แล้ววิเคราะห์ว่างานส่วนใดวนซ้ำ ใช้ token สูง หรือควรเปลี่ยนเป็นขั้นตอนคำนวณที่ชัดเจนกว่า
ภาพอนาคตที่ Kevin Madura ชี้ไว้คือโมเดลที่ถูก post-train ให้เข้าใจวิธีใช้ RLM โดยตรง เมื่อถึงจุดนั้น AI อาจจัดการการค้นหา เขียนโค้ด แตกงาน และประเมินว่าเมื่อใดควรหยุดได้ดีขึ้นมาก แต่สำหรับตอนนี้ ความได้เปรียบขององค์กรไม่ได้อยู่ที่การรอ model รุ่นใหม่ อยู่ที่การมีข้อมูลพร้อม เป้าหมายชัด และ workflow ที่วัดผลได้
Step 9: สรุป Checklist ทั้งหมดก่อนเริ่มใช้ RLM
- ☐ ระบุงานที่ข้อมูลยาว ซับซ้อน และต้องทำซ้ำ
- ☐ ตรวจว่างานนั้นต้องใช้ RLM จริง หรือ RAG และ automation ปกติก็เพียงพอ
- ☐ กำหนดข้อมูลนำเข้า เจ้าของข้อมูล และสิทธิ์เข้าถึง
- ☐ เขียนเป้าหมายธุรกิจและรูปแบบผลลัพธ์ให้ชัด
- ☐ แยกงานคำนวณที่ต้องแม่นยำออกจากงานตีความของ AI
- ☐ กำหนดเพดานรอบการทำงาน ต้นทุน และเวลารอผลลัพธ์
- ☐ บังคับให้รายงานอ้างอิงหลักฐานจากข้อมูลต้นทางได้
- ☐ ให้คนตรวจผลลัพธ์ก่อนใช้กับการเงิน กฎหมาย หรือการตัดสินใจสำคัญ
- ☐ วัดเวลา ต้นทุน และความผิดพลาดเทียบกับกระบวนการเดิม
- ☐ เริ่มจาก pilot ขนาดเล็ก แล้วค่อยขยายไปยังเอกสารและข้อมูลชุดอื่น
RLM คือแนวทางที่พา AI ออกจากการอ่านข้อความยาวๆ แล้วเดาคำตอบ ไปสู่การทำงานกับข้อมูลแบบเป็นระบบมากขึ้น สำหรับธุรกิจไทย จุดเริ่มต้นที่ถูกต้องจึงไม่ใช่ “จะใช้ RLM อย่างไร” แต่คือ “งานวิเคราะห์ใดที่เราต้องการให้ AI ช่วยคิด โดยยังตรวจสอบคำตอบได้ทุกขั้นตอน”