เรียบเรียงจากคลิปต้นทางของ Julian Goldie SEO และบทความ VideoToBlog วันที่ 2026-08-06 (วันที่แสดงในต้นทาง ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว) ชื่อรุ่น สเปก ตัวเลขจากผู้พัฒนา และความเห็นต่อผลทดสอบเป็นข้อมูลที่ต้นทางรายงาน ยังไม่ได้ตรวจยืนยันกับผู้ให้บริการหรือทดสอบซ้ำ ภาพเกมและหน้าเว็บเป็นผลงานตัวอย่างในคลิป ไม่ใช่หลักฐานว่าโมเดลใดชนะทุกงาน · วิดีโอต้นทาง
ปัญหาใหญ่ของการใช้ AI ในธุรกิจไม่ใช่การมี model ให้เลือกน้อยเกินไป แต่คือการหยิบ model ตัวเดียวไปฝืนทำทุกงาน แล้วสรุปว่า AI ยังทำงานไม่ได้จริง
คลิปจากช่อง Julian Goldie SEO เปรียบเทียบ Qwen 3.8-Max, Claude Fable 5 และ GPT-5.6 Sol ด้วย prompt เดียวกันแบบไม่มีรอบแก้ ตั้งแต่เกม Flappy Bird, เกม Tetris ไปจนถึง landing page ที่ใช้กับธุรกิจจริง ข้อสรุปที่น่าสนใจกว่าอันดับผู้ชนะ คือเราไม่ควรเลือก AI จากชื่อที่ดังที่สุด แต่ควรสร้างระบบเลือก AI ตามประเภทของงาน
สำหรับเจ้าของธุรกิจและคนทำงานไทย นี่คือแนวคิดที่นำไปใช้ได้ทันที เพราะงานอย่างทำหน้าเว็บ เขียนแผนงาน สรุปข้อมูล สร้างคอนเทนต์ หรือแก้ปัญหา workflow ล้วนต้องการจุดแข็งของ AI คนละแบบ
สารบัญ
- Step 1: เลิกถามว่า AI ตัวไหนเก่งที่สุด
- Step 2: ทำความเข้าใจจุดเด่นของ AI ทั้งสามตัว
- Step 3: แยกเกมทดสอบออกจากงานที่สร้างรายได้
- Step 4: ใช้ landing page เป็นบททดสอบ AI ที่ใกล้งานธุรกิจจริง
- Step 5: สร้างระบบ route งาน ไม่ใช่ระบบเชียร์ค่าย
- Step 6: เปลี่ยนแนวคิดเป็น Actionable Insights
- Step 7: แก้ปัญหาที่มักเจอเมื่อใช้ AI หลาย model
- Step 8: การต่อยอดหลังเลือก AI ได้แล้ว
- Step 9: สรุป Checklist ทั้งหมดสำหรับเลือก AI ให้ตรงงาน
Step 1: เลิกถามว่า AI ตัวไหนเก่งที่สุด
การแข่งขันครั้งนี้ตั้งโจทย์ชัดเจนว่า AI ทั้งสามตัวต้องรับ prompt เดียวกัน และทำงานให้เสร็จตั้งแต่รอบแรก การทดสอบแบบนี้มีประโยชน์ เพราะโลกการทำงานไม่ได้เปิดโอกาสให้เราแก้ prompt สิบรอบเสมอไป
แต่สิ่งที่ควรระวังคือ คำถามว่า “ตัวไหนเก่งที่สุด” มักพาเราไปผิดทาง งานหนึ่งอาจวัดความสวยของหน้าเว็บ อีกงานวัดตรรกะของระบบ อีกงานต้องการการวางแผนยาวและใช้เครื่องมือหลายขั้นตอน การให้ AI ทุกตัวแข่งกันด้วยคะแนนเดียว จึงเหมือนเลือกพนักงานด้วยข้อสอบชุดเดียวแล้วให้ทำทุกตำแหน่ง
มุมมองสำคัญ: ธุรกิจที่ใช้ AI ได้ผล ไม่ได้ชนะเพราะสมัคร tool มากที่สุด แต่ชนะเพราะรู้ว่างานไหนควรส่งให้ AI ประเภทใด และกำหนดเกณฑ์ตรวจงานก่อนเริ่ม
Step 2: ทำความเข้าใจจุดเด่นของ AI ทั้งสามตัว
Qwen 3.8-Max: เด่นด้านงานหน้าเว็บและงานระยะยาว
Qwen 3.8-Max จาก Alibaba เป็น mixture of experts model ที่มีพารามิเตอร์รวม 2.4 ล้านล้านตัว แต่เปิดใช้งานราว 95 พันล้านตัวต่อครั้ง จุดนี้มีเป้าหมายเพื่อรักษาความเร็วในการทำงาน รองรับข้อความ รูปภาพ และวิดีโอ พร้อม context ขนาด 1 ล้าน token
จุดขายหลักคือการทำงานต่อเนื่องกับโปรเจกต์ที่ยาวและยุ่ง โมเดลถูกวางตำแหน่งให้ทำงานเหมือนเพื่อนร่วมงานที่เดินงานต่อได้ ไม่ใช่ตอบคำถามแล้วจบ ข้อมูลจาก Alibaba ระบุว่ามันเคยทำโปรเจกต์ coding ต่อเนื่องเกิน 10 วัน และทำผลงานได้เหนือทีมมนุษย์จำนวนมากในการแข่งขัน 24 ชั่วโมง
อย่างไรก็ตาม ตัวเลขเหล่านี้มาจากผู้พัฒนาเอง จึงควรมองเป็นสัญญาณเชิงบวก ไม่ใช่ข้อพิสูจน์สุดท้ายจนกว่าจะมีการทดสอบจากหน่วยงานภายนอก
หากนำมาใช้กับธุรกิจไทย Qwen 3.8-Max น่าสนใจสำหรับงานที่ต้องการหน้าตาและโครงสร้างพร้อมใช้ เช่น หน้าโปรโมชัน หน้ารับสมัครสมาชิก dashboard เบื้องต้น หรือชุด mockup สำหรับเสนอไอเดียให้ทีม
Claude Fable 5: เด่นด้านตรรกะและงานวิศวกรรมที่ซับซ้อน
Claude Fable 5 ถูกนำเสนอว่าแข็งแรงกับงาน software engineering ที่ยาก โดยเฉพาะโจทย์ที่ยาวขึ้นและมีเงื่อนไขเชื่อมกันหลายชั้น จุดแข็งคือความเป็นระเบียบของ logic และความน่าเชื่อถือเมื่องานมีรายละเอียดที่พลาดไม่ได้
จุดนี้สำคัญแม้เราไม่ใช่ developer เพราะงานธุรกิจจำนวนมากก็มี “ตรรกะ” ซ่อนอยู่ เช่น ออกแบบ flow รับลูกค้าใหม่ กำหนดเงื่อนไขตอบแชต วางระบบคัดกรอง lead สรุป policy ภายใน หรือเปลี่ยนกระบวนการทำงานที่กระจัดกระจายให้เป็นขั้นตอน
ถ้างานมีเงื่อนไขมาก เช่น “ลูกค้ากลุ่ม A ได้ข้อเสนอหนึ่ง ลูกค้ากลุ่ม B ต้องส่งต่อฝ่ายขาย และกรณีร้องเรียนต้องแจ้งผู้จัดการ” AI ที่รักษา logic ได้ดีมีค่ามากกว่า AI ที่ตอบได้สวยเพียงอย่างเดียว
GPT-5.6 Sol: เด่นด้านแผนงาน เครื่องมือ และ agentic workflow
GPT-5.6 Sol ถูกวางเป็น model ระดับสูงของสาย GPT-5.6 สำหรับการวางแผน การใช้ tools และงาน command line ที่ใช้เวลานาน มี reasoning mode และ ultra mode ที่ให้ helper agents ช่วยแบ่งงานย่อย
ในมุมคนทำธุรกิจ จุดเด่นนี้แปลได้ว่า Sol เหมาะกับโจทย์ที่ยังไม่ชัดเจน และต้องแตกงานก่อนลงมือ เช่น วางแผนเปิดตัวสินค้า สร้างรายการงานสำหรับทีม แปลงเป้าหมายยอดขายเป็นแผนรายสัปดาห์ หรือจัดโครงสร้างข้อมูลก่อนเริ่มทำรายงาน
Sol ยังไม่ได้เป็นตัวเลือกเดียวในสายนี้ เพราะมี Terra สำหรับงานทั่วไปที่สมดุล และ Luna สำหรับงานที่ต้องการความเร็ว สาระสำคัญคือแม้ภายในค่ายเดียวกัน ก็ยังต้องเลือก model ตามระดับความยากของงาน
Step 3: แยกเกมทดสอบออกจากงานที่สร้างรายได้
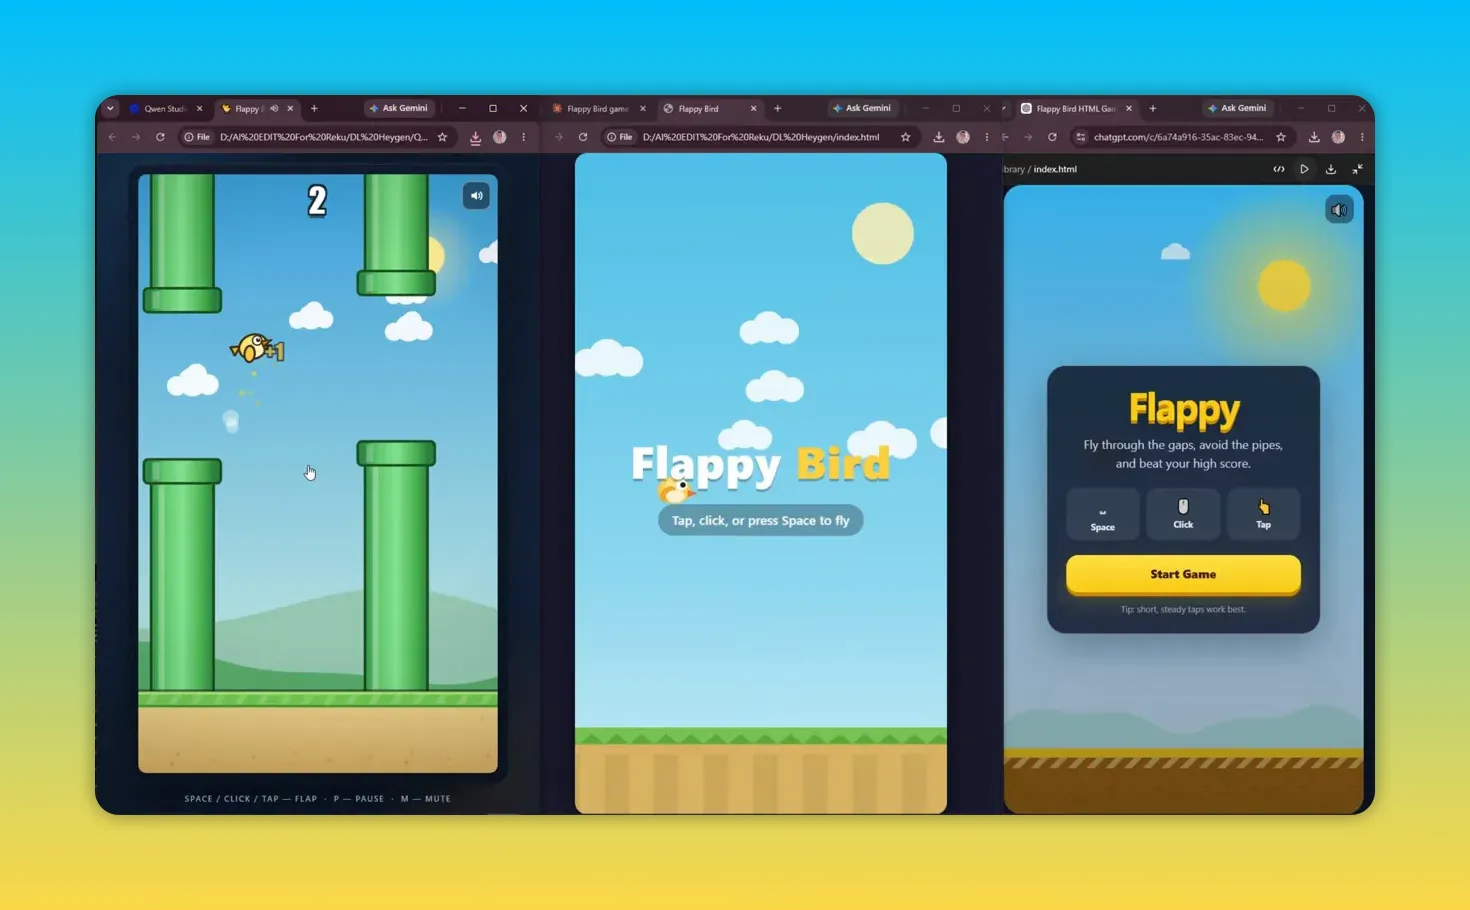
โจทย์แรกคือสร้าง Flappy Bird ในไฟล์ HTML เดียว ต้องมีแรงโน้มถ่วง การกระโดด ท่อเคลื่อนที่ คะแนน การชน เสียง หน้าเริ่ม และหน้าเกมจบ โดยไม่ใช้ library หรือรูปภาพภายนอก
มาตรฐานนี้ยังมีประโยชน์ในการดูว่า AI สร้างงานครบแค่ไหนในครั้งแรก แต่สำหรับ model ระดับ frontier เกมหนึ่งไฟล์กลายเป็นงานพื้นฐานไปแล้ว สิ่งที่น่าดูจริงคือความลื่นไหล ความครบของรายละเอียด และคุณภาพงานที่พร้อมใช้งาน
การทดสอบ Tetris ยากขึ้น เพราะต้องมีชิ้นส่วนหล่น การหมุน การลบแถว การเพิ่มความเร็ว และระบบคะแนน งานลักษณะนี้ทำให้เห็นว่าตรรกะภายในเกมเชื่อมกันดีเพียงใด ถ้า model อ่อน จุดผิดพลาดมักเกิดในจังหวะหมุนชิ้นส่วนหรือลบแถว
ผลจากการเปรียบเทียบสะท้อนบุคลิกของแต่ละตัวชัดขึ้น Fable 5 มีแนวโน้มคุม logic ของงานซับซ้อนได้ดี Qwen 3.8-Max ทำงานด้านหน้าตาและความรู้สึกของ interface ได้โดดเด่น ส่วน Sol ดูเป็นนักวางแผนที่คิดโครงก่อนเริ่มสร้าง
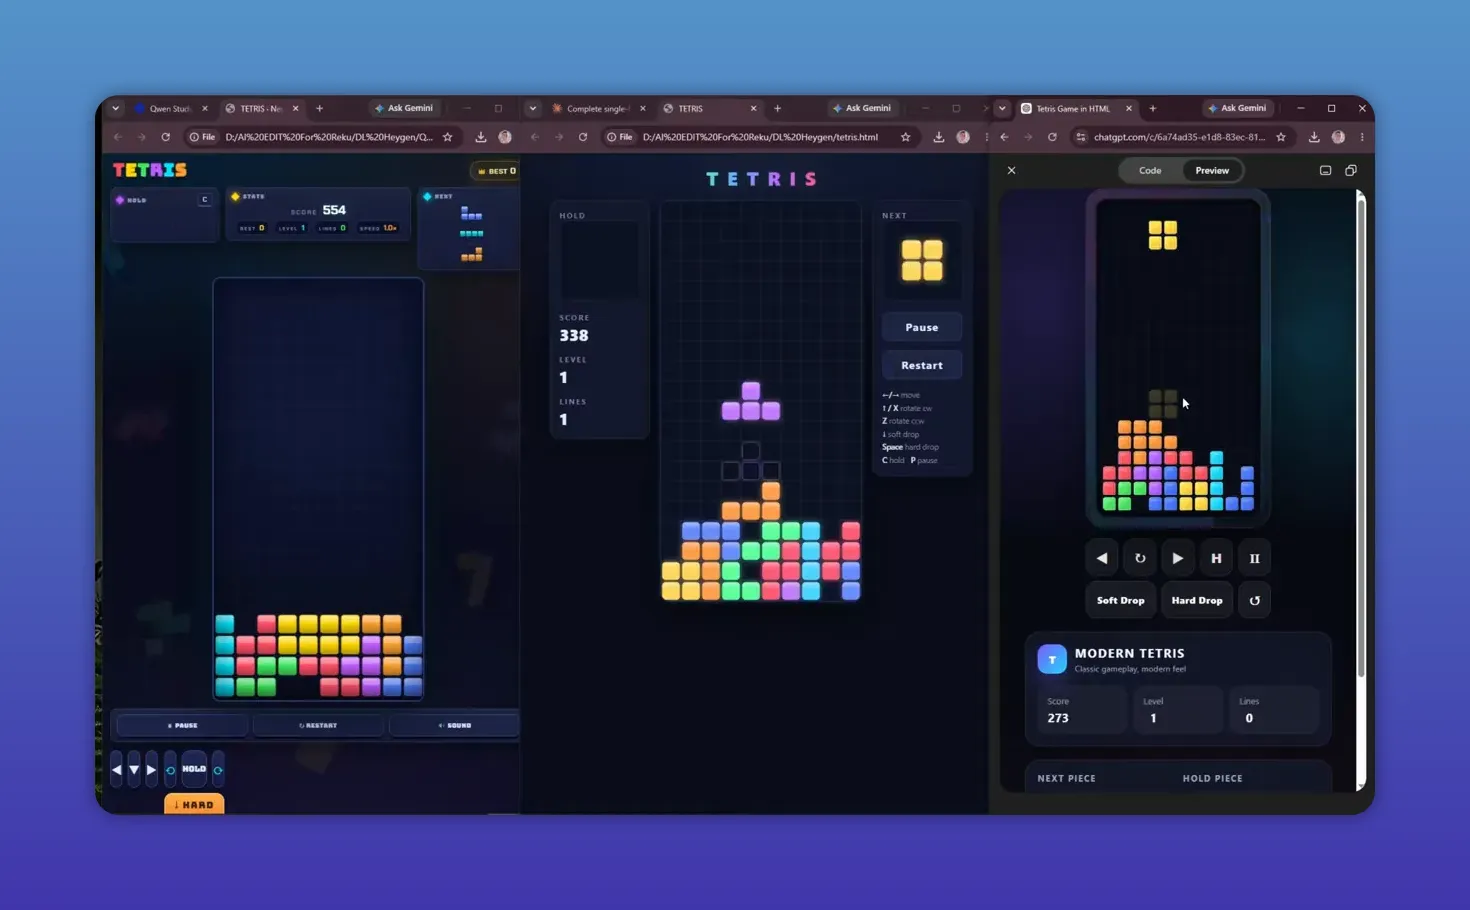
ข้อควรจำ: เกมเป็นเพียงแบบทดสอบ ไม่ใช่ตัวชี้วัด ROI ของธุรกิจ เราไม่ควรตัดสินว่าจะซื้อ AI ตัวไหนจากเกมที่มันสร้างได้ แต่ควรให้มันทำงานที่องค์กรมีแผนจะใช้งานจริง
Step 4: ใช้ landing page เป็นบททดสอบ AI ที่ใกล้งานธุรกิจจริง
โจทย์ที่มีความหมายที่สุดคือการสร้าง landing page สำหรับ AI Profit Boardroom จาก brief สั้น ๆ หน้าเว็บที่ดีต้องดูพรีเมียม อ่านง่าย รองรับมือถือ สื่อสารความน่าเชื่อถือ และพาคนไปสู่ call to action ได้ชัดเจน
นี่คือจุดที่การเขียน code ให้ “รันได้” ไม่พอ งานต้องมีลำดับเนื้อหา หัวข้อที่สื่อประโยชน์ ส่วนประกอบที่ไม่รก และบรรยากาศที่สอดคล้องกับแบรนด์ Qwen 3.8-Max อยู่ระดับบนของงาน front-end, Fable 5 ทำหน้าเว็บและแอปที่ดูขัดเกลาได้ดี ส่วน Sol ให้โครงสร้างที่มั่นคงสำหรับหน้าเว็บหนึ่งหน้า
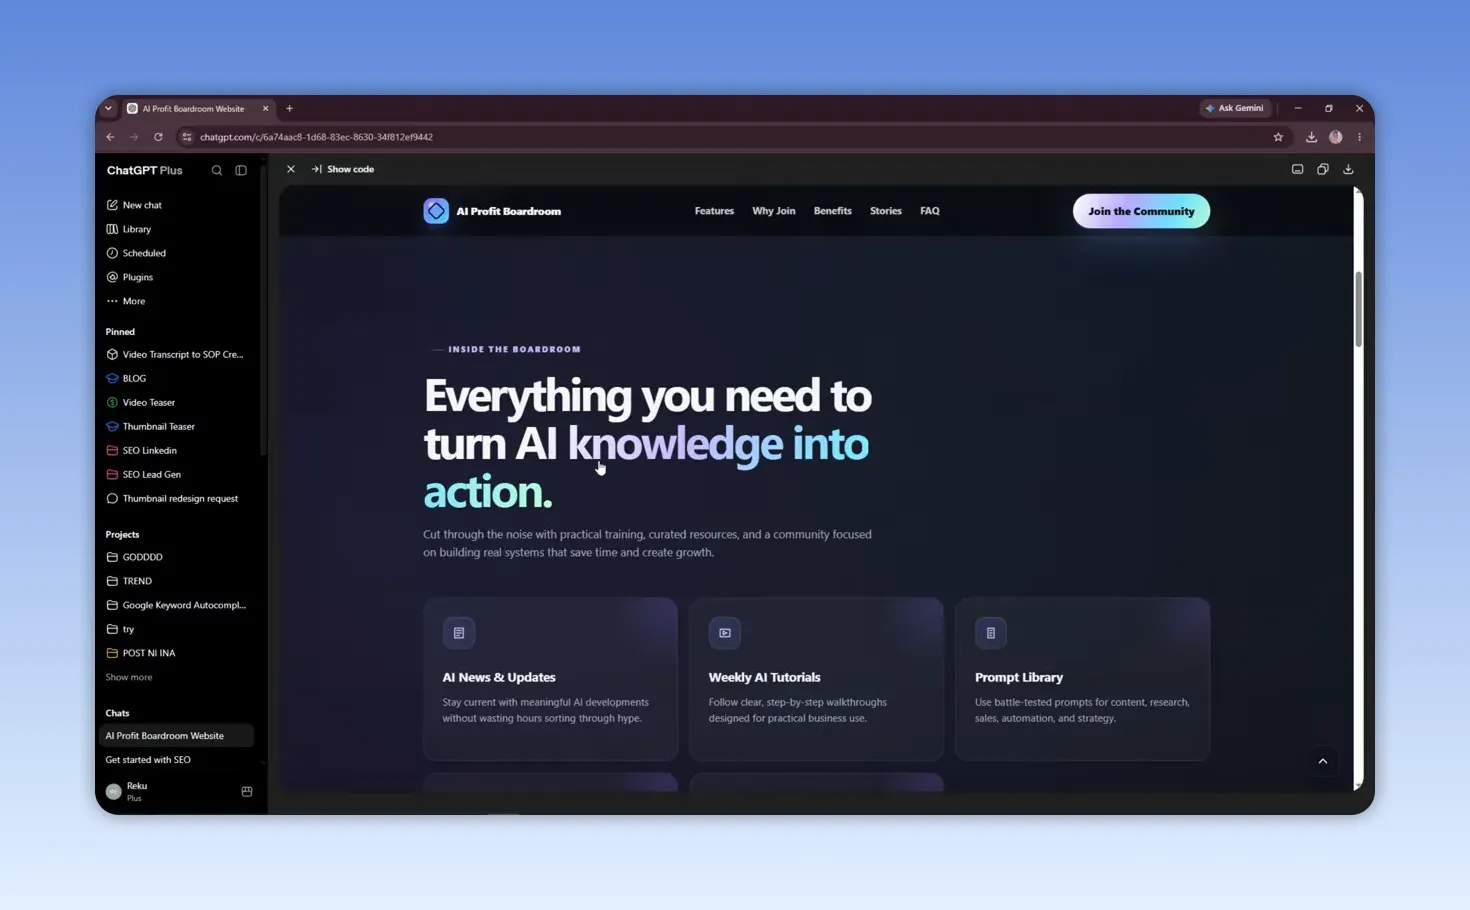
สำหรับธุรกิจไทย เราสามารถแปลงบททดสอบนี้เป็นงานที่วัดผลได้จริง เช่น ให้ AI สร้างหน้าโปรโมชันคอร์ส หน้ารับจองบริการ หน้าเปิดตัวสินค้า หรือหน้าเก็บ lead แล้วประเมินด้วยเกณฑ์เดียวกัน ได้แก่ ความชัดของข้อความ ภาพลักษณ์แบรนด์ การแสดงผลบนมือถือ และความสะดวกในการนำไปแก้ต่อ
จุดที่ควรเห็นต่างกับความตื่นเต้นเรื่อง one-shot คือ หน้าเว็บที่ออกมาดูดีครั้งแรกยังไม่เท่ากับหน้าเว็บที่ขายได้จริง การตัดสินใจซื้อขึ้นอยู่กับ offer หลัก ราคา หลักฐานความน่าเชื่อถือ และความเข้าใจลูกค้า AI ช่วยสร้างร่างที่ดีได้ แต่ทีมธุรกิจยังต้องรับผิดชอบเรื่องกลยุทธ์และการอนุมัติข้อความ
Step 5: สร้างระบบ route งาน ไม่ใช่ระบบเชียร์ค่าย
ข้อสรุปของการเปรียบเทียบนี้ชัดเจน ไม่มีผู้ชนะเพียงรายเดียว Qwen 3.8-Max เหมาะเมื่ออยากได้ front-end ที่ดูขัดเกลา หรืองานยาวที่ต้องเดินต่อเอง Fable 5 น่าใช้กับโจทย์ที่ซับซ้อนและต้องการตรรกะที่แน่น ส่วน GPT-5.6 Sol เหมาะกับการวางแผน งานเครื่องมือ และงาน agentic ที่ต้องแตกงานย่อย
Qwen ยังมีประเด็นที่อาจเปลี่ยนการตัดสินใจขององค์กร คือ Alibaba ระบุว่าจะเปิดเป็น open weights พร้อมรุ่น 27B ที่มีความเป็นไปได้มากกว่าในการรันเอง ขณะที่ Fable 5 และ Sol ยังอยู่ในระบบปิดของบริษัทผู้พัฒนา
สำหรับองค์กรที่กังวลข้อมูลภายใน การมีทางเลือก open weights อาจสำคัญกว่าคะแนน benchmark แต่การรัน model เองก็มีต้นทุนด้านเครื่อง ระบบดูแล ความปลอดภัย และคนที่รับผิดชอบ จึงไม่ควรเลือกเพียงเพราะคำว่า “เปิด” หรือ “ควบคุมได้”
Step 6: เปลี่ยนแนวคิดเป็น Actionable Insights
- เลือก 3 งานจริง เช่น ร่างหน้าโปรโมชัน สรุปรายงานประชุม และออกแบบ flow ตอบลูกค้า แล้วให้ AI หลายตัวทำงานเดียวกัน
- ตั้งเกณฑ์ก่อนเทียบ ระบุว่าต้องดูความถูกต้อง ความเร็ว ความชัดเจนของภาษา ความสวย หรือจำนวนรอบแก้
- แบ่ง model ตามบทบาท ให้ตัวหนึ่งเน้นวางแผน อีกตัวเน้นสร้างหน้าตา และอีกตัวตรวจตรรกะหรือความครบถ้วน
- เก็บ prompt ที่ชนะ เมื่อได้ผลลัพธ์ดี ให้บันทึก prompt พร้อมตัวอย่างผลลัพธ์และเงื่อนไขใช้งานเป็น SOP ของทีม
- ตรวจงานก่อนเผยแพร่เสมอ โดยเฉพาะราคา ข้อเสนอ เงื่อนไขบริการ ตัวเลข และข้อความที่กระทบภาพลักษณ์แบรนด์
Step 7: แก้ปัญหาที่มักเจอเมื่อใช้ AI หลาย model
- ปัญหา: เปิดหลาย AI แล้วตัดสินใจไม่ถูกว่าจะใช้ตัวไหน
สาเหตุ: ไม่มีตารางจับคู่งานกับ model
วิธีแก้: สร้างรายการงานประจำ 5 ถึง 10 งาน แล้วระบุ model หลักและ model สำรองสำหรับแต่ละงาน - ปัญหา: ผลลัพธ์ดูดี แต่ใช้จริงไม่ได้
สาเหตุ: prompt ระบุแค่หน้าตาผลลัพธ์ ไม่ได้ระบุเป้าหมาย ข้อจำกัด และเกณฑ์สำเร็จ
วิธีแก้: เพิ่มข้อมูลลูกค้า เป้าหมายธุรกิจ รูปแบบผลลัพธ์ ตัวอย่างโทนภาษา และรายการสิ่งที่ห้ามพลาด - ปัญหา: ทีมเสียเวลาลอง tool ใหม่ทุกสัปดาห์
สาเหตุ: ติดตามข่าวมากกว่าทดสอบกับงานจริง
วิธีแก้: กำหนดรอบประเมินเป็นรายเดือนหรือรายไตรมาส แล้วเปลี่ยน tool เฉพาะเมื่อผลทดสอบกับงานจริงดีขึ้นชัดเจน - ปัญหา: AI สร้างหน้าเว็บได้สวย แต่ข้อความขายไม่ตรงกลุ่มลูกค้า
สาเหตุ: ให้ AI ออกแบบโดยไม่มีข้อมูล offer และ pain point
วิธีแก้: เตรียม brief ที่มีสินค้า กลุ่มเป้าหมาย ปัญหาหลัก หลักฐานความน่าเชื่อถือ และ call to action ก่อนสั่งสร้างหน้าเว็บ - ปัญหา: เชื่อผล benchmark จนเกินไป
สาเหตุ: benchmark วัดงานเฉพาะทาง และบางส่วนมาจากผู้พัฒนา model เอง
วิธีแก้: ใช้ benchmark เป็นข้อมูลคัดกรองเบื้องต้น แล้วให้คะแนนจากงานขององค์กรเป็นตัวตัดสินสุดท้าย
Step 8: การต่อยอดหลังเลือก AI ได้แล้ว
แนวคิดแรกคือสร้าง AI routing board แบบง่ายใน Notion, Google Sheets หรือ platform ที่ทีมใช้อยู่ กำหนดคอลัมน์เป็นประเภทงาน model ที่แนะนำ prompt มาตรฐาน และคนตรวจงาน ระบบนี้ช่วยให้คนในทีมเริ่มทำงานได้ทันทีโดยไม่ต้องทดลองใหม่ทุกครั้ง
แนวคิดที่สองคือใช้ AI สองตัวทำงานต่อกัน ตัวแรกสร้างร่างหน้า sales page หรือแผนงาน ตัวที่สองตรวจ logic ช่องโหว่ และคำถามที่ลูกค้าอาจสงสัย การแยกบทบาทช่วยลดความเสี่ยงจากการเชื่อคำตอบของ model เดียว
แนวคิดที่สามคือสร้างคลัง “งานที่ผ่านจริง” เช่น landing page ที่เก็บ lead ได้ดี โครงร่างข้อเสนอที่ฝ่ายขายใช้ได้ หรือ prompt สรุปประชุมที่ทีมยอมรับ เมื่อมีตัวอย่างจริงสะสมมากขึ้น AI จะกลายเป็นระบบทำงานขององค์กร ไม่ใช่ของเล่นทดลองรายบุคคล
Step 9: สรุป Checklist ทั้งหมดสำหรับเลือก AI ให้ตรงงาน
- ☐ ระบุงานจริงที่ต้องการให้ AI ช่วยก่อนเลือก model
- ☐ แยกงานที่ต้องการหน้าตา ตรรกะ และการวางแผนออกจากกัน
- ☐ ทดสอบ AI อย่างน้อย 2 ถึง 3 ตัวด้วย prompt เดียวกัน
- ☐ ตั้งเกณฑ์วัดผลก่อนเริ่ม เช่น ความถูกต้อง ความเร็ว คุณภาพภาษา และจำนวนรอบแก้
- ☐ ใช้ Qwen 3.8-Max กับงาน front-end และงานยาวที่ต้องการความต่อเนื่อง
- ☐ ใช้ Fable 5 กับงานที่มีเงื่อนไขซับซ้อนและต้องคุมตรรกะ
- ☐ ใช้ GPT-5.6 Sol กับงานวางแผน ใช้ tools และแตก workflow หลายขั้นตอน
- ☐ อย่ายึดติดกับ benchmark หรือประกาศเปิดตัวเพียงอย่างเดียว
- ☐ ให้คนตรวจผลลัพธ์ก่อนส่งต่อลูกค้าหรือเผยแพร่
- ☐ บันทึก prompt และผลลัพธ์ที่ใช้ได้จริงเป็น SOP ของทีม
ท้ายที่สุด การเลือก Qwen 3.8-Max, Fable 5 หรือ GPT-5.6 Sol ไม่ใช่การหา AI ที่เหนือกว่าทุกด้าน แต่คือการจัดวาง AI ให้รับงานที่มันทำได้ดีที่สุด เมื่อเราทำได้ ทีมจะลดเวลาลองผิดลองถูก และเปลี่ยน AI จากเครื่องมือสร้างคำตอบ ให้กลายเป็นกำลังช่วยงานที่นำไปใช้ต่อได้จริง