วันที่บทความต้นทางใน VideoToBlog: 2026-03-19 ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว สเปก ความเร็ว2.2เท่า เวลาเริ่มใช้และราคาฟรีเป็นคำรายงานหรือภาพตามต้นทาง ไม่ใช่ผลทดสอบอิสระหรือข้อเสนอปัจจุบัน ตัวเลขความเร็วขึ้นกับคู่เทียบ ฮาร์ดแวร์และงาน จึงไม่เท่ากับข้อความมากกว่า50%ในภาพโดยอัตโนมัติ บริบท1ล้านโทเคนไม่รับประกันว่าจะจำทุกข้อมูลได้ถูกต้อง ภาพตัวอย่างหลายใบแสดงการพิมพ์พรอมป์ ยังไม่ยืนยันการทำงานหลายเอเจนต์สำเร็จครบวงจร · แหล่งอ้างอิงในบทความต้นทาง
มีความเปลี่ยนแปลงบางอย่างเกิดขึ้นกับ AI ที่สายทำระบบอัตโนมัติรอคอยมานาน จุดเปลี่ยนไม่ได้อยู่แค่ “คำตอบเก่งขึ้น” แต่คือการทำให้โมเดลกลายเป็นแกนหลักของ AI agents ที่วางแผน ลงมือทำ และเชื่อมข้อมูลหลายชั้นได้ต่อเนื่องโดยไม่สะดุดจากขีดจำกัดความจำ
ในคลิปนี้มีการพูดถึง NVIDIA Nemotron 3 Super ซึ่งถูกออกแบบมาสำหรับงานที่ไม่ใช่แค่แชท แต่เป็นงานเชิงเวิร์กโฟลว์จริง เราจะทำความเข้าใจสเปกสำคัญของมันก่อน แล้วค่อยไล่ดูว่าแนวคิดเรื่องบริบทระดับ 1 million token, สถาปัตยกรรม Mixture of Experts, และการทำงานแบบ multi-token prediction ส่งผลต่อการสร้างระบบอัตโนมัติอย่างไร จากนั้นจะลงตัวอย่างการใช้งานแบบเป็นขั้นตอนที่นำไปต่อยอดได้จริง
ทำไม Nemotron 3 Super ถึง “เปลี่ยนกติกา” ของ AI agents
AI รุ่นส่วนใหญ่ที่เจอในตลาดมักเก่งในบทบาท “ตอบคำถาม” ถ้าสื่อสารด้วยวิธีถามแล้วได้คำตอบ มันก็ทำงานได้ดี แต่ปัญหาเริ่มเมื่อย้ายจากงานคำถาม ไปสู่งานที่ต้อง ทำหลายขั้นตอน ภายในกระบวนการเดียว
งานแบบ agent ในโลกธุรกิจ มักมีลักษณะต่อไปนี้
- ต้องอาศัยบริบทตั้งแต่ต้นจนจบ เช่น เงื่อนไข ขั้นตอน ข้อมูลที่ใช้ตัดสินใจ และเป้าหมาย
- ต้อง “จำรายละเอียด” จำนวนมากพร้อมกัน เช่น เอกสารนโยบาย, โครงสร้างระบบ, ข้อเท็จจริงจากแคตตาล็อก, ประวัติการคุย, โค้ดเบส
- ต้องเร็วพอจะรันเป็นรอบ ๆ หรือรันพร้อมกันจำนวนมาก ไม่ใช่รันแล้วค้างเป็นนาที
ในคลิประบุชัดว่า Nemotron 3 Super ถูกออกแบบมาเพื่อโจทย์แบบนี้ และจุดชูโรงคือ 3 เรื่องใหญ่ ได้แก่ context window 1 million token, สถาปัตยกรรมแบบ Mixture of Experts, และความเร็วจาก multi-token prediction
แกะสเปกหลักของ Nemotron 3 Super แบบเข้าใจง่าย
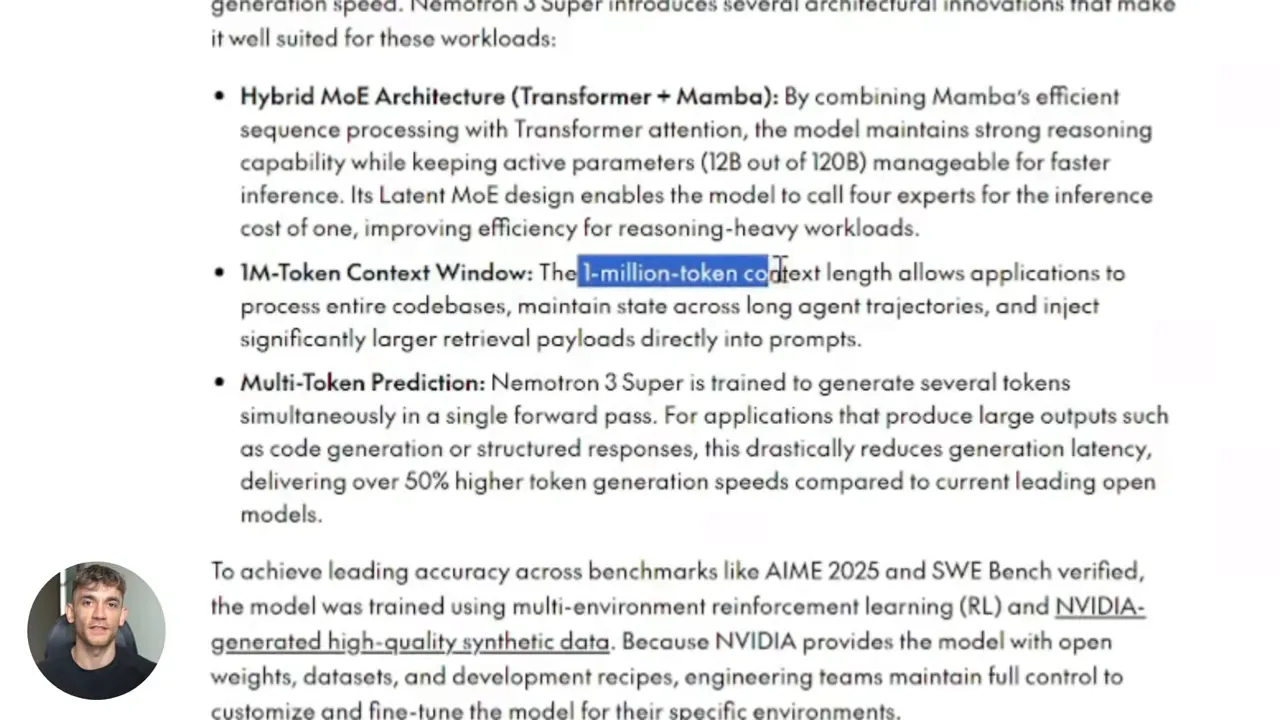
1) Context window 1 million tokens: จำทั้งระบบได้จริง
สเปกที่คนพูดถึงมากสุดคือ 1 million token context window เมื่อเทียบกับโมเดลทั่วไปที่มักอยู่แถว ๆ 128k หรือ 200k tokens แล้วจะเกิดอาการ “หลุดโฟกัส” หรือ “เริ่มลืม” เพราะบริบทถูกบีบให้ไม่พอสำหรับงานที่ยาว
สำหรับ agent นี่คือความต่างแบบจับต้องได้ ถ้าเรามีทั้งเอกสารธุรกิจ, โค้ด, อีเมลประวัติ, FAQ, SOP, หรือแม้กระทั่ง transcript เก่า ๆ จำนวนมาก เราต้องการให้โมเดล “เห็นภาพรวม” ตอนวางแผนและตอนลงมือทำ
แนวคิดจากคลิปคือการป้อนข้อมูลจำนวนมหาศาลเข้าไปใน หนึ่ง prompt แล้วให้มันใช้เหตุผลข้ามข้อมูลเหล่านั้นในคราวเดียว ไม่ต้องแบ่งเป็นรอบ ๆ ไม่ต้องรีสตาร์ทงานเพราะบริบทถูกตัด
2) 120B parameters แต่เปิดใช้แค่ 12B: Mixture of Experts
ตัวโมเดลมี 120 billion parameters แต่จะ activate แค่ 12 billion ในแต่ละรอบงาน ด้วยโครงสร้างที่เรียกว่า Mixture of Experts (MoE)
ถ้าให้อธิบายแบบภาพในหัว MoE คือการมี “ทีมผู้เชี่ยวชาญหลายคน” และสำหรับงานแต่ละแบบ ระบบจะเรียกผู้เชี่ยวชาญที่เหมาะกับงานนั้นจริง ๆ ไม่ได้ดึงพลังทั้งหมดตลอดเวลา
ผลที่เกิดคือ
- อินเฟอเรนซ์เร็วขึ้น
- ใช้ทรัพยากรคำนวณน้อยลง
- คุณภาพการให้เหตุผลยังดี
สำหรับสายทำ automation ที่ต้องรันหลายรอบหรือรันพร้อมกัน ความคุ้มค่าแบบนี้มีผลต่อทั้งต้นทุนและความเสถียร
3) Hybrid architecture: Mamba + Transformer
คลิปพูดถึงสถาปัตยกรรมแบบผสม Mamba transformer โดยส่วนของ Mamba layers ช่วยจัดการ long sequences ได้ดี ขณะที่ transformer layers ช่วยในด้าน deep reasoning และ retrieval
ภาพรวมคือพยายามให้ได้ทั้งความเร็วและ “ความคิดลึก” แบบไม่แลกกันจนเกินไป
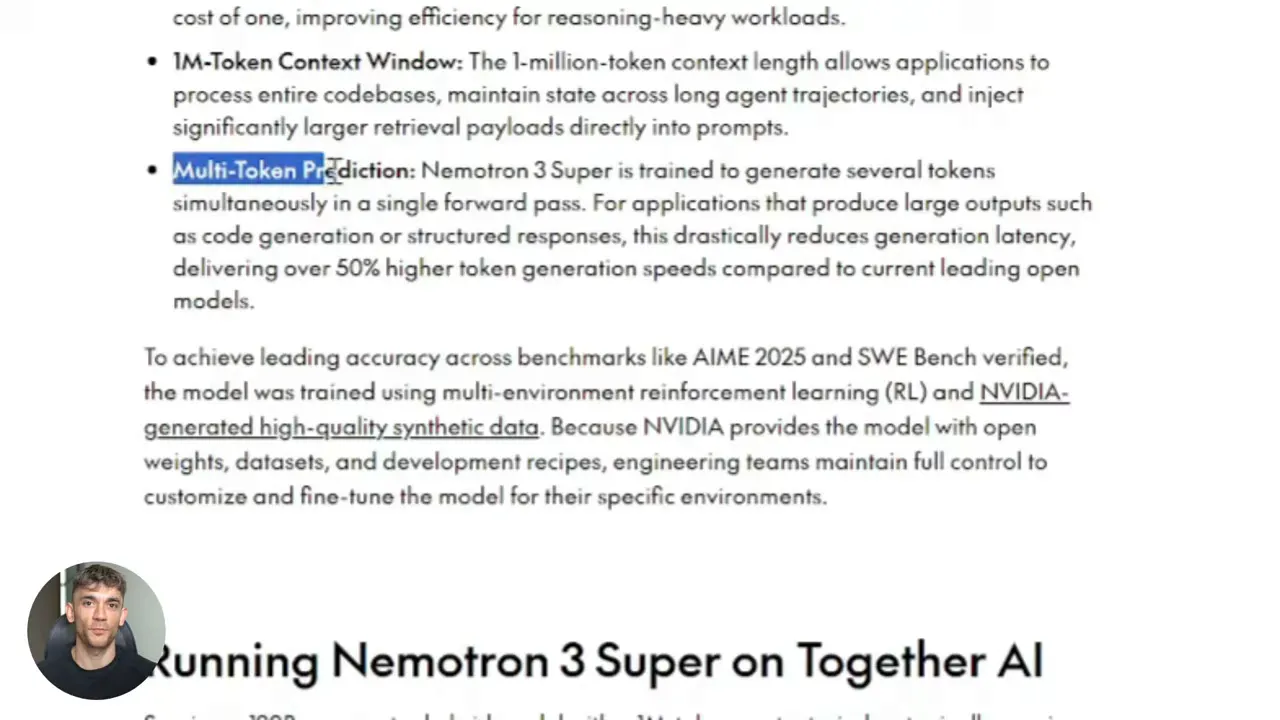
4) Multi-token prediction: เร็วขึ้นเพราะทำนายหลาย token พร้อมกัน
ความเร็วของการทำงานไม่ได้มาจากแค่ฮาร์ดแวร์ แต่ยังมาจากวิธีการ generate คำถัดไป คลิประบุว่า Nemotron 3 Super ใช้ multi-token prediction คือ generate หลาย token พร้อมกัน แทนการทำนาทีละ token แบบดั้งเดิม
ผลคือความเร็วที่รายงานในคลิปอยู่ที่ 2.2 เท่าของความเร็ว เมื่อเทียบกับโมเดล open ที่เทียบเคียงได้
และสำหรับงาน agent ที่มีหลายขั้นตอน ความเร็วแบบนี้อาจหมายถึงการที่ pipeline ทำงานจบภายในเวลาที่ธุรกิจรับได้ และทำให้รันตามรอบ (เช่น รายวัน รายสัปดาห์) ได้จริง
5) Open weight: โหลดมารันเองได้
อีกประเด็นที่สำคัญสำหรับองค์กรคือ fully open weight ในคลิประบุว่าเปิดน้ำหนัก เปิดข้อมูลชุดฝึก และเปิด recipe ทำให้ผู้ใช้งานสามารถดาวน์โหลดและรันได้เองหรือเข้าผ่าน API
ข้อดีเชิงระบบคือการควบคุมมากขึ้น เรื่องความเป็นส่วนตัวของข้อมูล การกำหนดสภาพแวดล้อม และการลด vendor lock-in
จาก “แชทบอท” สู่ “โครงสร้างของ agent”: สถาปัตยกรรมต้องรองรับงานจริง
ประโยคที่ควรจับไว้คือ Nemotron 3 ไม่ได้เป็นแค่ “อัปเกรดแชท” แต่ถูกมองว่าเป็น โครงสร้างพื้นฐานสำหรับ AI agents
สิ่งที่แชทบอทมักทำได้ดีคือการตอบคำถามแบบทันที ในขณะที่ agent จะต้องทำงานเป็นสายพ่วง
ในสายงาน automation เรามักเจอสถานการณ์แบบนี้
- ให้คำสั่งเริ่ม แต่ระหว่างทำต้องอ้างอิงข้อกำหนดหลายส่วน
- ต้องปรับแผนเมื่อข้อมูลใหม่โผล่
- ต้องทำ output หลายรูปแบบ เช่น ข้อความสั้น, โครงร่างเอกสาร, โค้ด, และแผนปฏิบัติ
ดังนั้นความสามารถแบบ “จำข้อมูลทั้งหมดแล้วใช้เหตุผลร่วมกันใน prompt เดียว” จึงช่วยลดความจำเป็นที่ต้องออกแบบระบบซับซ้อนเพื่อชดเชยข้อจำกัดเดิม
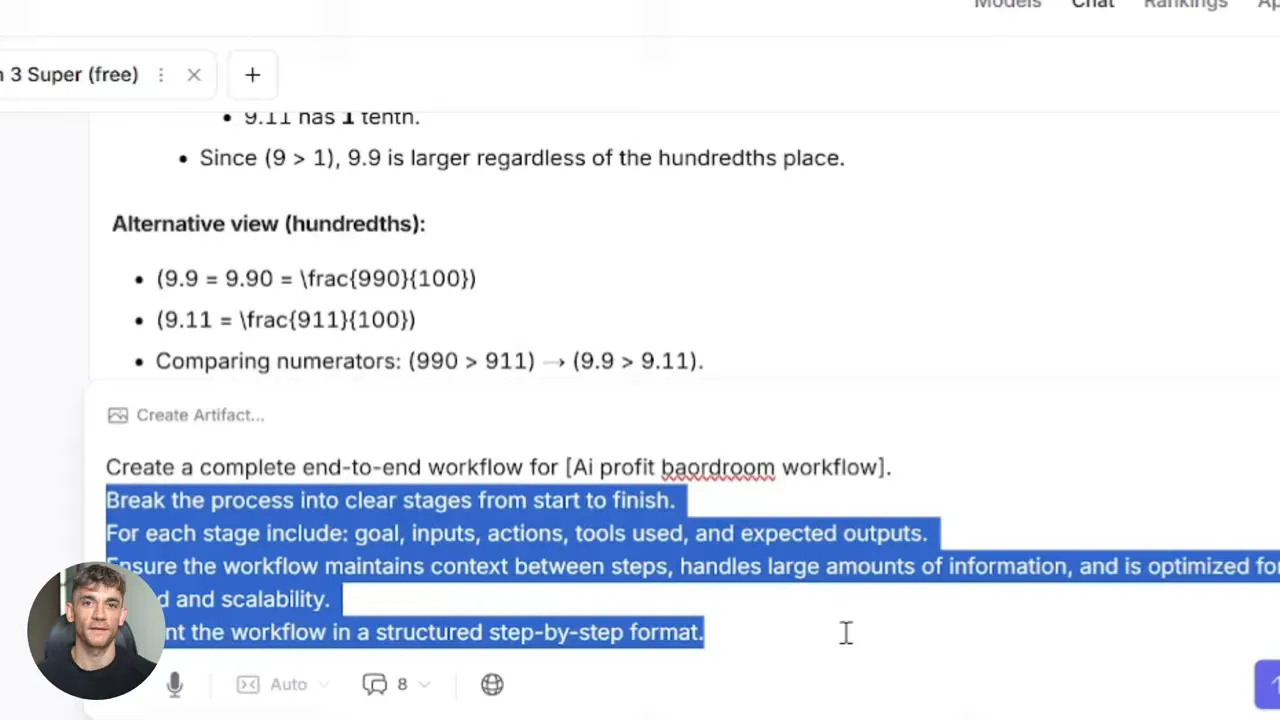
4 use cases ที่เชื่อมจากสเปกสู่การใช้งานจริง
คลิปมีตัวอย่างการใช้งาน 4 แบบ โดยใช้กรอบคิดของ “การสร้างระบบให้ชุมชน” เป็นภาพแทน ก่อนจะชวนให้เอาแนวคิดไปใช้กับธุรกิจของตัวเอง
1) AI research agent: รายงานวิจัยและมุมมองเฉพาะกลุ่มจากข้อมูลทั้งหมด
โจทย์คือทำให้ชุมชนได้รับเนื้อหาที่ทันกระแสทุกสัปดาห์ แบบไม่ต้องเริ่มคิดใหม่ตั้งแต่ศูนย์
แนวทางที่คลิปยกขึ้นคือให้ Nemotron 3 ทำหน้าที่วิจัยแล้วสรุปเป็นรายงาน โดยระบุสิ่งที่ต้องทำ เช่น ค้นหาเทรนด์, สรุป key points, อธิบายว่าทำไมมันสำคัญต่อคนทำธุรกิจ และเสนอมุมมองของคอนเทนต์
จุดที่ทำให้แตกต่างคือเราใส่ “ข้อมูลของเรา” เข้าไปใน context window แบบกว้างมาก เช่น transcript วิดีโอเก่า, FAQ ของชุมชน, ข้อมูลวิจัยผู้ชม โมเดลจึงสามารถ tailor ให้เข้ากับกลุ่มเป้าหมายเฉพาะเจาะจง
มุมมองเชิงปฏิบัติคือ agent แบบนี้ลดภาระงานของทีม เพราะไม่ต้องให้คนไปไล่อ่านข้อมูลเก่า แล้วเขียนแนวคิดใหม่จากศูนย์ทุกครั้ง เราอาจเก็บ “ความรู้ขององค์กร” ไว้ในรูปเอกสาร แล้วให้โมเดลทำหน้าที่ synthesize ให้แทน
2) Content repurposing pipeline: ให้วิดีโอหนึ่งชิ้นแตกเป็นหลายแพลตฟอร์ม
แทนที่จะทำคอนเทนต์หลายรูปแบบด้วยมือ คลิปยกภาพ “ป้อน transcript จาก YouTube” แล้วให้โมเดลสร้าง output แยกหลายประเภท เช่น
- Twitter/X thread
- ส่วนหนึ่งของ newsletter
- LinkedIn post
- script สำหรับ short-form video
หลักคิดคือ “One input, five outputs” ในเชิงระบบ นี่คือขั้นตอนที่ควรทำเป็น pipeline ไม่ใช่ทำตามอารมณ์ เพราะเมื่อวาง pipeline แล้วงานจะสม่ำเสมอและวัดผลได้ง่ายขึ้น
ความเห็นส่วนตัวจากมุมการทำงานคือ นี่ไม่ใช่แค่ความสามารถของโมเดล แต่เป็นการออกแบบ “สัญญา” ระหว่างโมเดลกับ workflow เช่น ต้องรักษา brand voice, ต้องรักษาโครงสร้าง, และต้องกำหนดรูปแบบ output ให้พร้อมใช้
3) Coding agent: สร้างฟีเจอร์ใหม่โดยอ่าน codebase ทั้งก้อน
coding agent มักติดปัญหาเวลาโมเดลจำไม่ได้ว่าก่อนหน้านี้โค้ดเป็นอย่างไร เพราะบริบทถูกตัดหรือไม่ได้ป้อนโครงสร้างให้ครบ แต่ด้วย context window ขนาดใหญ่ Nemotron 3 Super ทำให้แนวคิด “อ่านทั้งระบบแล้วต่อยอด” เป็นภาพที่เป็นไปได้มากขึ้น
คลิปยกตัวอย่างการทำ onboarding flow สำหรับสมาชิกใหม่ โดยมีเงื่อนไขให้ถามเป้าหมาย แล้วแนะนำเครื่องมือและทรัพยากรที่เหมาะสมจาก library
แนวคิดสำคัญคือการป้อน code base ทั้งหมดและให้โมเดลเข้าใจโครงสร้าง แล้วสร้าง feature ใหม่แบบต่อเนื่องในบริบทเดียว
สิ่งที่ควรระวังคือการนำโค้ดไปใช้จริงยังต้องมีขั้นตอนตรวจสอบ เช่น ลองรันเทสต์, ตรวจ security, และทบทวนตรรกะทางธุรกิจ แต่การที่โมเดลอ่าน “บริบทจริง” ทำให้โอกาสที่ระบบพังจากความไม่สอดคล้องลดลง
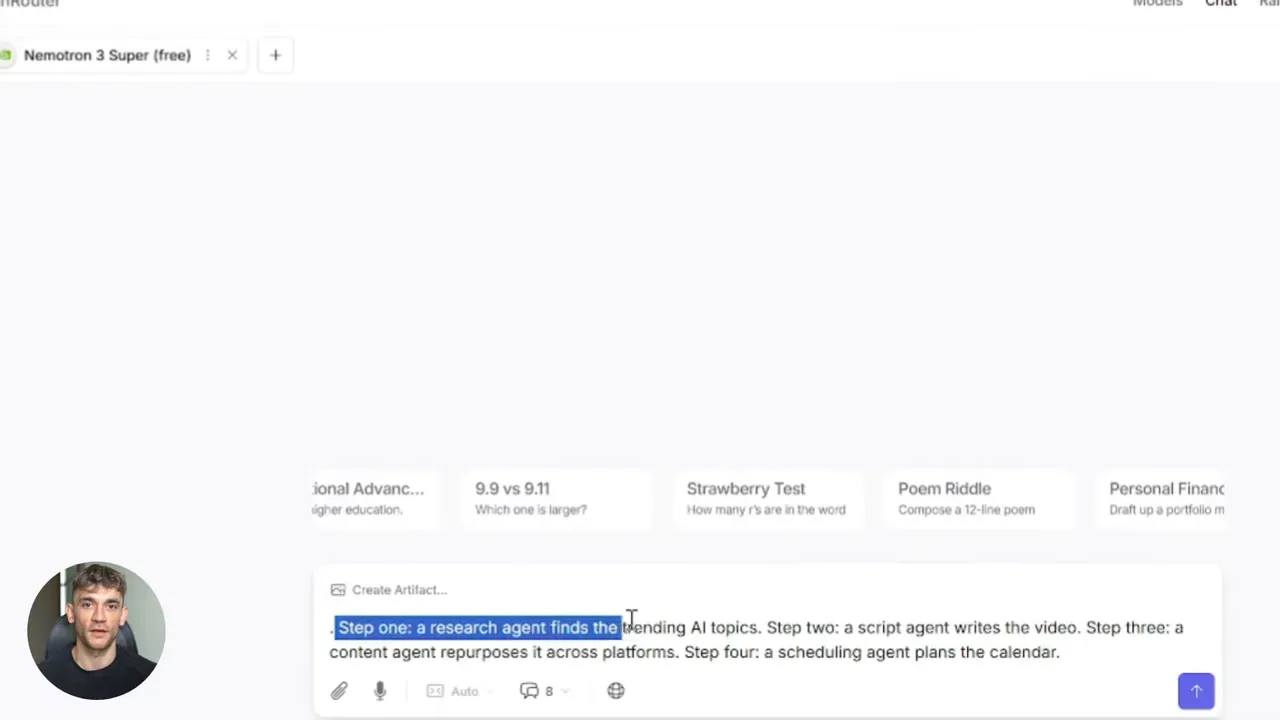
4) Multi-agent chain: วิจัย เขียน ทำซ้ำ และจัดตารางงานแบบต่อเนื่อง
เมื่อพูดถึง agent chain คลิปชี้ไปที่ลำดับงานที่เชื่อมกัน
- Research agent: หา trending topics
- Script agent: เขียนสคริปต์วิดีโอ
- Content agent: repurpose ไปหลายแพลตฟอร์ม
- Scheduling agent: วางปฏิทินการโพสต์
นี่คือภาพของ multi-agent systems ในการทำงานจริง ไม่ใช่เพียง “ลองคุยหลายคน” แต่คือแบ่งบทบาทตามหน้าที่ให้ workflow
มุมมองที่น่าสนใจคือ multi-agent chain ไม่ได้เกิดมาเพื่อความเท่ แต่มันช่วยลดภาระของ agent ตัวเดียว เพราะแต่ละ agent โฟกัสงานเฉพาะด้าน การ debug ก็ง่ายขึ้น และการวัดผลแยกส่วนได้
แนวทางเริ่มต้นใช้งาน: สามช่องทางที่คลิปเสนอ
คลิประบุ 3 วิธีหลักในการเริ่มต้นใช้งาน Nemotron 3 Super
1) OpenRouter: เริ่มทดสอบเร็วสุด
สำหรับคนส่วนใหญ่ การเริ่มผ่าน OpenRouter ถูกมองว่าเร็วที่สุด เพราะสมัครแล้วค้นหารุ่นที่ถูกระบุเป็น NVIDIA Nemotron 3 Super 120b A12b จากนั้นเริ่มเรียก API
คลิปบอกว่าใช้เวลาประมาณ 5 นาที ในการเริ่ม call แรก ซึ่งเหมาะกับการทดลองแนวคิดหรือทำ prototype
2) Hugging Face: โหลดน้ำหนักไปทำ local deployment
หากมีฮาร์ดแวร์พร้อม วิธีนี้จะทำให้ควบคุมสภาพแวดล้อมได้มากขึ้น เหมาะกับองค์กรหรือทีมที่ต้องจัดการข้อมูลภายในอย่างเข้มงวด
3) NVIDIA enterprise options: NIM และ NEMO
สำหรับการใช้งานระดับองค์กรที่ต้องการความเสถียรและการจัดการที่เป็นระบบ คลิปกล่าวถึงแนวทางของ NVIDIA ในเชิง enterprise ผ่าน NIM และ NEMO
จุดนี้มักไม่ใช่สำหรับการทดลอง แต่สำหรับการ scale งานจริงที่ต้องการ SLA และรองรับปริมาณเรียกสูง
ตัวอย่าง prompt พร้อมใช้: จาก pain points ไปสู่ nurture sequence
คลิปมี prompt ตัวอย่างที่สามารถคัดลอกไปใช้กับ Nemotron 3 Super ผ่าน OpenRouter ได้ทันที โดยตั้งบทบาทให้เป็น “AI automation system” สำหรับการเติบโตของคอมมูนิตี้
แนวคิดของ prompt คือบังคับให้ agent ทำงานเป็น 4 ขั้นตอน ตั้งแต่ระบุ pain points ไปจนถึงสร้างวิดีโอ hooks และ sequence แบบอีเมล
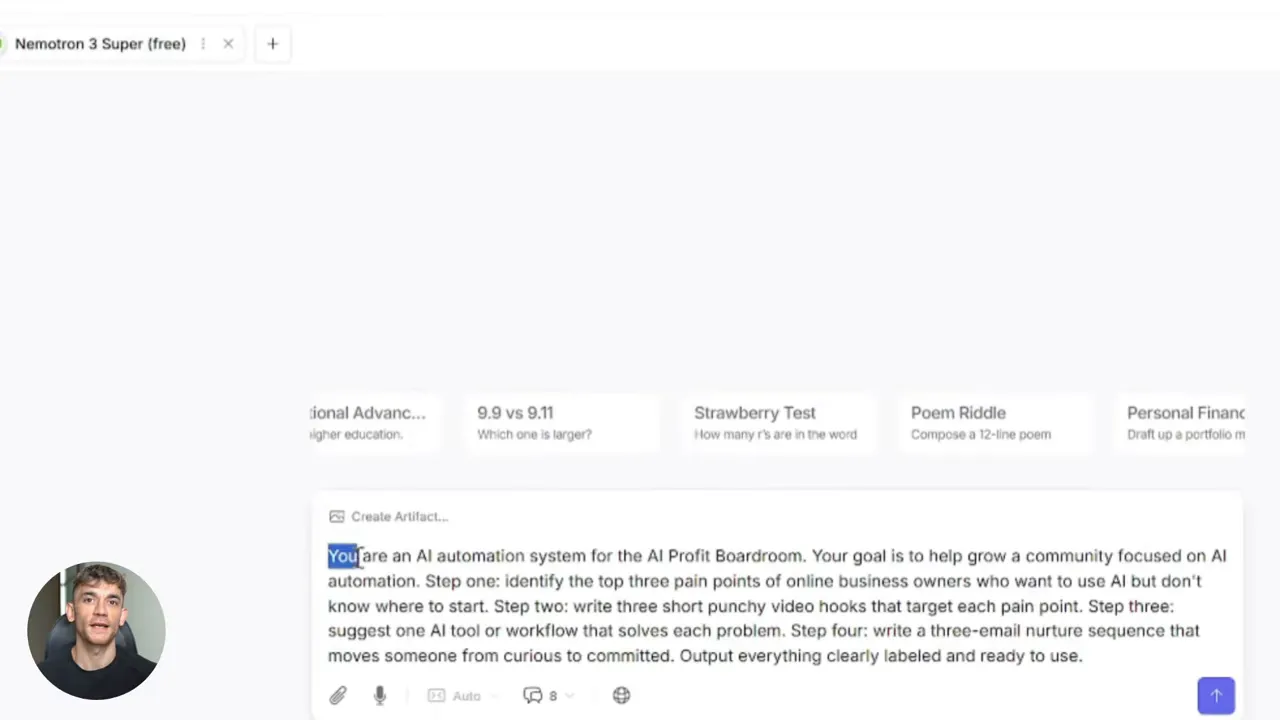
ตัวอย่าง prompt:
You are an AI automation system for the AI Profit Boardroom.
Your goal is to help grow a community focused on AI automation.

Step 1. Identify the top three pain points of online business owners who want to use AI but don't know where to start.

Step 2. Write three short punchy video hooks that target each pain point.

Step three, suggest one AI tool or workflow that solves each problem.

Step four, write a three-email nurture sequence that moves someone from curious to committed, output everything clearly labeled and ready to use.
ความน่าสนใจของ prompt แบบนี้คือมัน “บังคับโครงงาน” ให้ผลลัพธ์ใช้งานได้จริง ไม่ใช่แค่คำตอบเชิงความคิด แล้วค่อยให้มนุษย์เอาไปจัดรูปใหม่
การออกแบบ workflow ให้เวิร์กกับ context 1 million tokens
หลายคนเห็น 1 million tokens แล้วรู้สึกว่า “ป้อนทุกอย่าง แล้วให้โมเดลคิดเอง” แต่การทำงานจริงควรมีกลยุทธ์ ไม่งั้น output อาจยาวเกินควบคุม หรือรายละเอียดกระจัดกระจาย
แนวทางที่ใช้ได้กับงาน agent ส่วนใหญ่คือทำ “แพ็กเกจข้อมูล” ก่อนส่งเข้าพรอมต์ เช่น แยกเป็นหมวดชัดเจน
- ข้อมูลแบรนด์: brand voice, ตัวอย่างโพสต์เก่า
- ข้อมูลผลิตภัณฑ์หรือบริการ: คำอธิบาย, ราคา, ข้อจำกัด
- ข้อมูลผู้ชม: FAQ, pain points ที่เคยถามบ่อย, สไตล์การตอบ
- โครงงาน: โครงร่าง workflow ที่ต้องทำทีละขั้น
- ข้อกำหนด output: รูปแบบที่ต้องส่ง เช่น จำนวนบรรทัด, ความยาว, โทนภาษา
แล้วค่อยให้ agent รวมข้อมูลเหล่านั้นในการตัดสินใจและสร้าง output ภายใต้ constraint ที่กำหนด
ความเห็นส่วนตัวคือ context window ขนาดใหญ่ทำให้เรามี “สิทธิ์” ที่จะออกแบบงานแบบเป็นหน่วยความรู้ขององค์กรได้มากขึ้น จากเดิมที่ต้องอาศัย retrieval และ memory store ซับซ้อนเพื่อชดเชยข้อจำกัด โมเดลที่เห็นข้อมูลเยอะขึ้นทำให้ระบบมีโอกาสง่ายขึ้น แต่ก็ยังต้องจัดระเบียบให้ดี ไม่เช่นนั้นความฉลาดจะกระจาย
ข้อควรระวังในการทำ agent systems จริง
แม้ Nemotron 3 Super จะถูกออกแบบมาสำหรับ agent แต่การใช้งานในธุรกิจต้องจัดการความเสี่ยง เช่น
- ความถูกต้อง: output อาจมีข้อผิดพลาด ควรมีการตรวจทานหรือขั้นตอนยืนยัน (validation)
- ความสอดคล้องกับนโยบาย: งานประชาสัมพันธ์และงานขายมีข้อจำกัด ต้องกำหนดให้ชัดใน prompt
- ความปลอดภัยข้อมูล: แม้ open weight จะให้ควบคุมได้ แต่ข้อมูลที่ป้อนควรจัดการสิทธิ์และการเข้ารหัสตามมาตรฐาน
- ต้นทุนการรัน: แม้โมเดลเร็วขึ้น แต่ pipeline ที่ทำหลาย agent พร้อมกันก็ยังต้องคุมงบและจำนวนรอบ
สิ่งเหล่านี้ไม่ได้ทำให้โมเดลไม่คุ้ม แต่เป็นเหตุผลว่าทำไมต้องมอง agent เป็นระบบ ไม่ใช่แค่ “ลองกดปุ่มแล้วหวังผล”
สิ่งที่ได้จากคลิปนี้
Takeaway ที่น่าสนใจจาก Nemotron 3 Super คือเราเริ่มเห็นแนวโน้มว่า AI agent จะเดินออกจากกรอบแชท และกลายเป็นโครงสร้างงานจริงมากขึ้น องค์ประกอบที่สำคัญคือ
- Context 1 million tokens ทำให้ agent เข้าใจบริบทได้กว้างพอสำหรับงานที่ยาวและมีหลายส่วน
- Mixture of Experts ช่วยให้ความเร็วและต้นทุนไม่พัง แม้ต้องทำงานซ้ำ ๆ
- Multi-token prediction เพิ่มความเร็วในการ generate ซึ่งส่งผลต่อ pipeline ที่มีหลายขั้น
- Open weight เปิดทางให้ทั้งการทดลองและการใช้งานแบบควบคุมภายใน
แล้วเราจะทำอย่างไรดี? คำตอบที่เป็นรูปธรรมคือเริ่มจาก workflow ที่มีอินพุตและเอาต์พุตชัดเจน เช่น การสรุปงานวิจัย การ repurpose คอนเทนต์ หรือการร่าง nurture sequence จาก pain points จากนั้นค่อยต่อเป็น multi-agent chain เมื่อแน่ใจว่า output ตรงเป้าและระบบไม่พังเมื่อข้อมูลเพิ่มขึ้น
รู้สึกว่านี่มันน่าลองนะ เพราะถ้า context ของโมเดล “กว้างพอ” และความเร็ว “พอสำหรับงานจริง” สิ่งที่เคยเป็นงานเชิง manual จะค่อย ๆ กลายเป็นงานเชิงระบบที่ทำซ้ำได้ และวัดผลได้ ไม่ใช่แค่พรสวรรค์ของคนทำคอนเทนต์หรือทีมวิจัยอีกต่อไป
คำศัพท์เฉพาะที่น่าสนใจ
1) AI agents
ระบบ AI ที่ไม่ได้หยุดแค่ตอบคำถาม แต่ทำงานเป็นขั้นตอน เช่น วางแผน ค้นข้อมูล ออกแบบผลลัพธ์ และส่งต่อให้กระบวนการถัดไป
2) Context window
ขอบเขตของข้อมูลที่โมเดลสามารถ “อ่านและใช้คิด” ในรอบเดียว ยิ่งมากยิ่งเก็บรายละเอียดได้เยอะในงานที่ซับซ้อน
3) Mixture of Experts (MoE)
สถาปัตยกรรมที่มีผู้เชี่ยวชาญหลายชุด และเลือกเรียกชุดที่เหมาะกับงานนั้น ช่วยให้เร็วและคุ้มค่า
4) Mamba + Transformer (สถาปัตยกรรมผสม)
การรวมโมดูลที่ช่วยจัดการลำดับยาว (long sequences) กับส่วนที่เน้นการให้เหตุผลและการดึงข้อมูล
5) Multi-token prediction
วิธีการสร้างข้อความที่ทำนายได้หลาย token พร้อมกัน ทำให้ได้ผลลัพธ์เร็วขึ้น