ถ่ายทอดจากคลิป: บทความนี้อ้างอิง NEW Fugu Max and Fugu Ultra v2 Just Dropped! ของ Julian Goldie SEO ชื่อรุ่น ความสามารถ และผล benchmark เป็นสิ่งที่ผู้บรรยายนำเสนอ ไม่ใช่การตรวจยืนยันสถานะบริการปัจจุบัน วันที่ 17 กันยายน 2026 เป็นวันที่ในรายการบทความต้นทาง ไม่ใช่วันอัปโหลดวิดีโอที่ยืนยันแล้ว ตัวอย่างงานธุรกิจไทย การแบ่งประเภทงาน และเช็กลิสต์คงมาจากบทความเดิมในฐานะแนวทางทดลอง ไม่ใช่ผลลัพธ์ที่รับประกัน
การเลือกว่าจะใช้ Claude, GPT หรือ Gemini อาจไม่ใช่คำถามสำคัญที่สุดของธุรกิจอีกต่อไป เพราะแนวคิดใหม่คือให้ AI เลือกเครื่องมือที่เหมาะกับงานแทนเราเอง
คลิปจากช่อง Julian Goldie SEO หยิบ Fugu Max และ Fugu Ultra v2 ของ Sakana AI มาวิเคราะห์ โดยประเด็นที่น่าสนใจกว่าเรื่องคะแนน benchmark คือการเปลี่ยนมุมมองจาก “หา model ที่เก่งที่สุด” ไปสู่ “สร้างระบบที่ส่งงานไปให้ model ที่เหมาะที่สุด” ซึ่งมีนัยต่อเจ้าของธุรกิจไทยและทีมงานที่ต้องการใช้ AI ลดงานซ้ำ เพิ่มความเร็ว และควบคุมต้นทุน
สิ่งที่ควรโฟกัสจึงไม่ใช่การไล่ตามชื่อ model รายเดือน แต่คือการออกแบบ workflow ที่ชัดเจน มีคนตรวจจุดสำคัญ และรู้ว่าเมื่อไรควรใช้ระบบแบบประหยัด กับเมื่อไรควรยอมจ่ายเพื่อให้งานยากออกมารอบคอบกว่า
ทำความเข้าใจก่อนว่า Fugu คือผู้ประสานงาน ไม่ใช่ AI ตัวเดียว
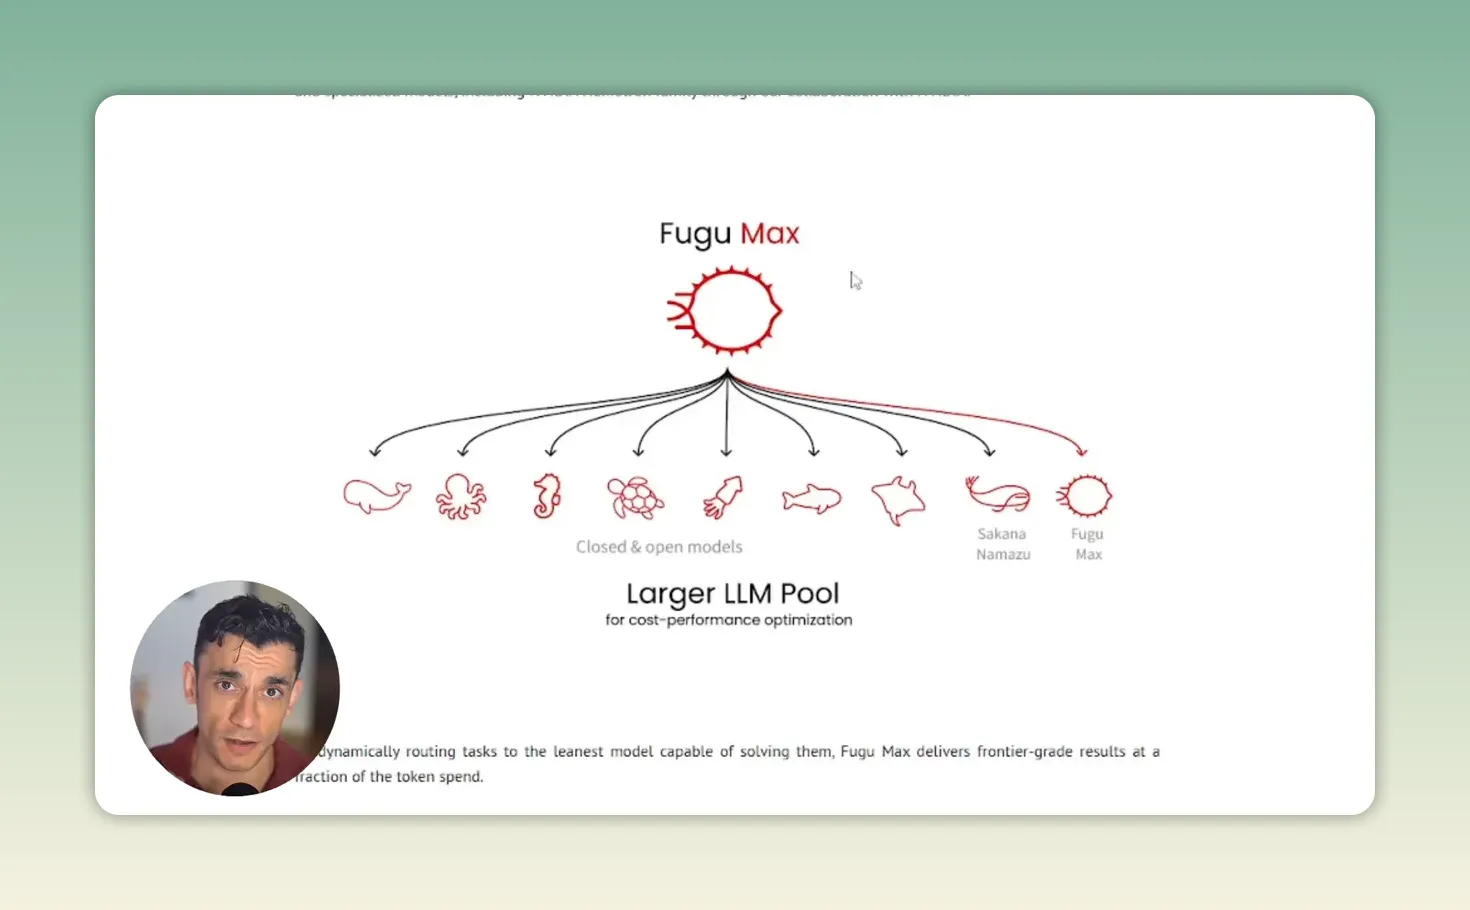
Fugu ของ Sakana AI ถูกนำเสนอในคลิปว่าเป็นระบบ multi-agent orchestration กล่าวง่าย ๆ คือเป็น “ผู้จัดการงาน AI” ที่รับโจทย์หนึ่งก้อน วิเคราะห์ว่าต้องใช้งานย่อยอะไรบ้าง แล้วเลือก agent หรือ model ที่ถนัดงานนั้นมาทำร่วมกัน
แทนที่จะบังคับให้ model เดียวทำทุกอย่าง ตั้งแต่วิเคราะห์ข้อมูล เขียนข้อความ ค้นคว้า จัดโครงสร้าง ไปจนถึงตรวจคำตอบ Fugu สามารถแบ่งงานและประกอบผลลัพธ์เป็นคำตอบเดียวได้ ระบบยังอาจเรียกใช้ตัวเองซ้ำในระหว่างกระบวนการ หากโจทย์ต้องแตกเป็นหลายชั้น
ภาพนี้เปลี่ยนวิธีคิดเรื่อง AI สำหรับธุรกิจได้มากพอสมควร เพราะธุรกิจไม่ได้จ้างพนักงานคนเดียวให้ทำบัญชี ขายของ เขียนโฆษณา และวางกลยุทธ์พร้อมกัน เราแบ่งงานให้คนที่มีความถนัดต่างกันอยู่แล้ว Fugu พยายามทำหลักการเดียวกันกับ model หลายตัว
แต่มีข้อควรระวังสำคัญ ระบบที่เลือก model ให้เองไม่ได้ทำให้เราหมดหน้าที่กำหนดโจทย์ หากเป้าหมายคลุมเครือ ข้อมูลตั้งต้นผิด หรือไม่มีเกณฑ์วัดคำตอบ ต่อให้มี agent หลายตัวก็อาจสร้างงานที่ดูครบแต่ใช้จริงไม่ได้
แยกงานประจำออกจากงานคิดหนัก แล้วเลือก Max หรือ Ultra v2
ตามคำอธิบายในคลิป Sakana AI แยก Fugu ออกเป็นสองแนวทาง ได้แก่ Fugu Max ที่เน้นสมดุลระหว่างคุณภาพและต้นทุน กับ Fugu Ultra v2 ที่เน้นงาน reasoning หลายขั้น งานค้นคว้าอิสระ และโจทย์ซับซ้อนมากกว่า
Fugu Max เหมาะกับงานปริมาณมาก
Fugu Max ใช้กลุ่ม agent ขนาดใหญ่ขึ้น และสามารถใช้ model เฉพาะทางจากหลายแหล่ง รวมถึง Nemotron ของ Nvidia ตามที่คลิปกล่าวถึง หัวใจของแนวคิดนี้คือ agent หนึ่งตัวไม่จำเป็นต้องชนะทุกงาน ขอเพียงทำงานที่ได้รับมอบหมายได้ดี เช่น งานโค้ด งานจัดข้อมูล หรืองานสรุปเอกสาร ก็มีคุณค่าในระบบรวม
สำหรับธุรกิจไทย Fugu Max น่าจะเหมาะกับงานที่ทำซ้ำ มีโครงสร้าง และต้องทำต่อเนื่อง เช่น
- สรุปคำถามลูกค้าจาก LINE, Facebook หรืออีเมลเป็นหมวดหมู่
- ร่างโพสต์สินค้าในหลายมุม พร้อมปรับโทนให้เข้ากับแต่ละช่องทาง
- สกัดประเด็นจากรีวิวลูกค้าและรายงานปัญหาที่พบซ้ำ
- สร้างอีเมลต้อนรับลูกค้าใหม่หรือข้อความติดตาม lead
- จัดกลุ่มรายชื่อลูกค้าเพื่อเตรียมแคมเปญสื่อสาร
คลิปชี้ว่าระบบ orchestration มีโอกาสก้าวข้าม trade-off แบบเดิมที่คุณภาพสูงขึ้นแล้วราคาต้องสูงขึ้นตาม หรือที่เรียกว่า Pareto frontier โดย Max มีผลทดสอบที่ Sakana AI รายงานว่าทำได้ดีในหลาย benchmark พร้อมต้นทุนต่ำกว่าระบบชั้นนำบางตัว
อย่างไรก็ตาม ตัวเลขเหล่านี้เป็นผลที่ผู้พัฒนารายงานเอง ไม่ใช่ฉันทามติจากการทดสอบอิสระ ธุรกิจไม่ควรแปลผลว่า Max จะถูกกว่าและดีกว่าเสมอในทุก workflow สิ่งที่ควรทดสอบคือ ต้นทุนต่อ “งานที่ผ่านเกณฑ์ใช้งานจริง” ไม่ใช่ต้นทุนต่อ token หรือคะแนนบนตารางเพียงอย่างเดียว
Fugu Ultra v2 กับโจทย์ซับซ้อนในคำอธิบายของผู้บรรยาย
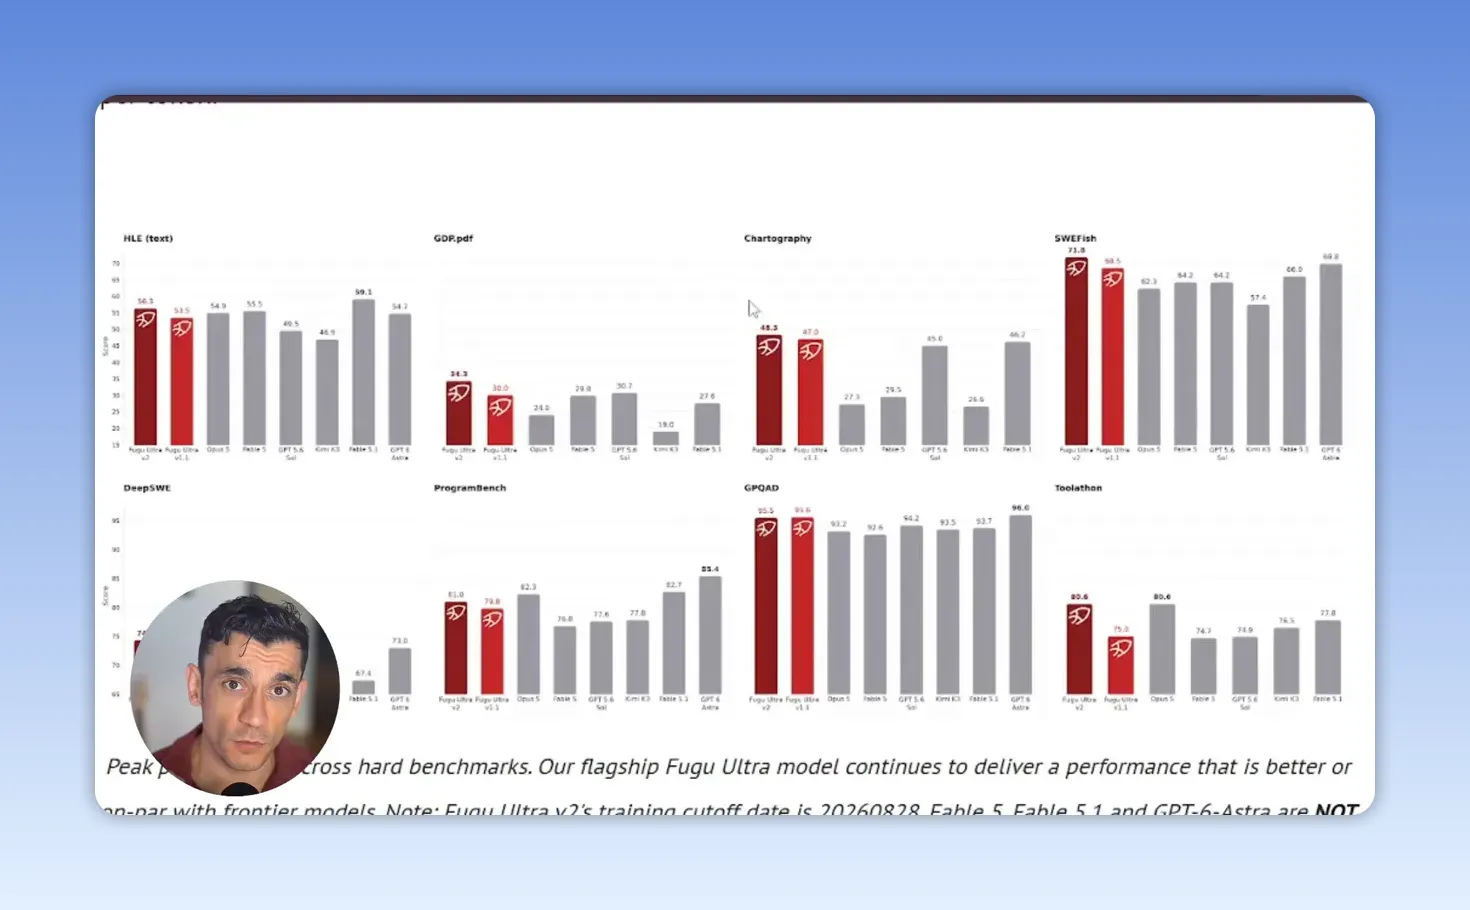
Fugu Ultra v2 ถูกออกแบบให้ทุ่มทรัพยากรกับโจทย์ยาก เช่น การให้เหตุผลหลายขั้น การค้นคว้า งานพัฒนาซอฟต์แวร์ และการวางแผนที่ต้องเชื่อมโยงข้อมูลหลายชุด คลิปยกผลบน benchmark ซึ่งกราฟต้นทางระบุชื่อว่า Chartography และแสดงคะแนน Fugu Ultra v2 ที่ 48.3 ชื่อ ChartQA ในบทความเดิมจึงถูกแก้ให้ตรงกับภาพ ผลนี้เป็นตัวเลขที่ผู้พัฒนารายงานและผู้บรรยายนำมาเล่า ไม่ใช่การทดสอบซ้ำของบทความนี้
ประเด็นธุรกิจไม่ใช่ว่า 48.3 ดีกว่า model อื่นกี่จุด แต่คือเราควรส่งงานแบบใดให้ระบบที่ใช้เวลาและต้นทุนสูงกว่า คำตอบคือ งานที่ต้องตัดสินใจจากหลักฐานหลายชิ้น และงานที่หากผิดแล้วสร้างต้นทุนจริง เช่น วิเคราะห์คู่แข่งก่อนเปิดตัวสินค้า วางแผนคอนเทนต์ 30 วัน หรือสรุปข้อเสนอจากเอกสารและความต้องการหลายฝ่าย
ไม่ควรใช้ Ultra v2 เพื่อเขียนแคปชันสั้น ๆ ทุกวัน เพราะงานนั้นไม่ได้ต้องการ reasoning ระดับสูง ความคุ้มค่าเกิดจากการจับคู่ระดับความยากของงานกับทรัพยากรที่ใช้ ไม่ใช่เลือกเครื่องมือที่ทรงพลังที่สุดให้ทุกเรื่อง
เปลี่ยน prompt เดียวให้เป็น workflow หลายบทบาท
ตัวอย่างที่ผู้บรรยายอธิบายช่วยให้เห็นแนวคิดของการสั่งระบบ multi-agent แต่ไม่ใช่ผลการตรวจสอบขั้นตอนภายในของแต่ละ agent หากต้องสร้างชุดอีเมลต้อนรับสมาชิกใหม่ เราอาจให้ Fugu Max แยกงานเป็น agent วิเคราะห์ความต้องการของสมาชิก agent เขียนข้อความ และ agent ตรวจความชัดเจนก่อนรวมเป็นลำดับอีเมลเดียว
หากขยับโจทย์เป็นแผนคอนเทนต์เต็มรูปแบบ ระบบระดับ Ultra v2 อาจรับผิดชอบงานที่กว้างขึ้น เช่น วิเคราะห์คู่แข่ง แบ่งกลุ่มเป้าหมาย วางแผนเปิดตัว 30 วัน และผูกคอนเทนต์รายวันเข้ากับผลลัพธ์ที่ธุรกิจต้องการ
เมื่อนำมาใช้กับธุรกิจไทย ลองนึกถึงร้านขายอุปกรณ์สุขภาพที่ต้องการเปิดตัวสินค้าใหม่ แทนการพิมพ์ว่า “ช่วยทำแผนการตลาด” ให้แตกโจทย์เป็น 5 บทบาทดังนี้
- นักวิเคราะห์ตลาด: สรุปคู่แข่ง ราคา จุดขาย และคำถามที่ลูกค้าพูดถึง
- นักวางกลยุทธ์: เลือกกลุ่มลูกค้าหลัก ข้อเสนอ และเป้าหมายแคมเปญ
- นักเขียนคอนเทนต์: ร่างหัวข้อโพสต์ อีเมล และข้อความแชต
- ผู้ตรวจแบรนด์: ตรวจน้ำเสียง คำกล่าวอ้างสินค้า และข้อความที่อาจเสี่ยง
- ผู้จัดการโครงการ: เรียงลำดับงานตามวัน ผู้รับผิดชอบ และตัวชี้วัด
นี่ไม่ได้หมายความว่าเราต้องสร้าง agent ห้าตัวทันที แต่เป็นวิธีคิดที่ช่วยให้ prompt ดีขึ้นตั้งแต่ยังใช้ AI chat ธรรมดา เพราะเรารู้ชัดว่าผลลัพธ์ต้องผ่านขั้นตอนใดก่อนนำไปใช้
วัดผลจากงานที่นำไปใช้ได้ ไม่ใช่จากความน่าตื่นเต้นของ benchmark
คลิปให้ความสำคัญกับแนวคิดที่ว่า Fugu สามารถเพิ่มคุณภาพโดยไม่เพิ่มต้นทุนตามสัดส่วน และ Fugu Ultra v2 ตั้งเป้ารักษาขีดความสามารถระดับแนวหน้า แต่สำหรับทีมธุรกิจ ตัวชี้วัดที่ควรใช้มีความเรียบง่ายกว่านั้นมาก
- เวลาที่ทีมใช้ต่อชิ้นงานลดลงกี่ชั่วโมง
- สัดส่วนงานร่างที่ผ่านการแก้ไขรอบแรกเพิ่มขึ้นหรือไม่
- จำนวนข้อผิดพลาดที่มนุษย์ตรวจพบอยู่ในระดับยอมรับได้หรือไม่
- ต้นทุน AI ต่อ lead ต่อบทความ หรือต่อเคสบริการลูกค้าลดลงหรือไม่
- งานที่ได้เชื่อมต่อกับยอดขาย ความเร็วในการตอบ หรือความพึงพอใจลูกค้าได้จริงหรือไม่
มุมที่เห็นต่างกับการนำเสนอแบบเน้น benchmark คือ งานจริงมีข้อมูลเฉพาะบริษัท ภาษาไทย การอนุมัติหลายชั้น และข้อจำกัดด้านข้อมูลส่วนบุคคล งานที่ชนะ benchmark จึงไม่รับประกันว่าจะเข้ากับเอกสารภายในหรือเสียงของแบรนด์เราได้ทันที
ทางออกคือทำ pilot เล็ก ๆ เลือก workflow เดียวที่มีปริมาณมากและวัดผลได้ เช่น การสรุป inquiry ลูกค้า 50 เคส หรือการร่างคอนเทนต์ 20 ชิ้น เปรียบเทียบก่อนและหลังใช้ AI แล้วค่อยตัดสินใจขยายผล
กำหนดจุดที่คนต้องอนุมัติก่อนปล่อยงานออกจากธุรกิจ
ความสามารถในการรวม agent หลายตัวไม่ได้เท่ากับความถูกต้อง 100% ความเสี่ยงยิ่งสูงเมื่อระบบทำงานหลายขั้น เพราะข้อผิดพลาดต้นทางอาจถูกส่งต่อและแต่งให้ดูน่าเชื่อถือขึ้นในผลลัพธ์สุดท้าย
ธุรกิจควรออกแบบ human-in-the-loop อย่างน้อยใน 4 จุด ได้แก่ ข้อความที่มีราคาหรือโปรโมชัน ข้ออ้างเกี่ยวกับสุขภาพหรือกฎหมาย ข้อมูลลูกค้า และการตัดสินใจที่มีผลต่อเงินหรือชื่อเสียงแบรนด์
กติกาที่ใช้ได้จริงคือ ให้ AI ทำหน้าที่รวบรวม ร่าง จัดลำดับ และชี้ประเด็นที่ควรตัดสินใจ ส่วนคนรับผิดชอบการยืนยันข้อเท็จจริง อนุมัติข้อเสนอ และรับผิดชอบผลลัพธ์ปลายทาง วิธีนี้ช่วยให้ทีมเร็วขึ้นโดยไม่ผลักความเสี่ยงให้ระบบอัตโนมัติทั้งหมด
นำแนวคิดไปใช้กับงานประจำ
- เริ่มจากงานเดียว: เลือกงานซ้ำที่กินเวลาอย่างน้อยสัปดาห์ละ 2 ถึง 3 ชั่วโมงก่อน ไม่เริ่มจากการทำ AI transformation ทั้งบริษัท
- เขียนผลลัพธ์ก่อนเลือก tool: ระบุว่าใครใช้ ผลงานหน้าตาแบบใด และวัดความสำเร็จอย่างไร แล้วค่อยเลือก Max, Ultra หรือ AI tool อื่น
- แยกงานถูกกับงานยาก: ใช้ระบบต้นทุนต่ำกับการจัดหมวด สรุป และร่างแรก ใช้ reasoning ที่หนักขึ้นเฉพาะงานวางแผน วิเคราะห์ หรือการตัดสินใจที่สำคัญ
- สร้างเกณฑ์ตรวจรับ: ระบุข้อเท็จจริงที่ต้องมี แหล่งข้อมูล น้ำเสียง และสิ่งที่ห้ามกล่าวไว้ใน prompt หรือ checklist ทุกครั้ง
- เก็บ prompt ที่ใช้แล้วเวิร์ก: จัดเป็นคลังตามงาน เช่น ตอบลูกค้า เขียนบทความ วิเคราะห์รีวิว และวางแผนแคมเปญ เพื่อไม่ให้ทุกคนเริ่มใหม่
Troubleshooting เมื่อ workflow AI ยังไม่ให้ผลตามคาด
- ปัญหา: ได้คำตอบยาวแต่จับไปทำงานไม่ได้
สาเหตุ: โจทย์บอกหัวข้อ แต่ไม่บอกผลลัพธ์ ผู้ใช้ และเกณฑ์ตัดสิน
วิธีแก้: ระบุรูปแบบส่งงาน เช่น ตาราง 30 วัน พร้อมหัวข้อ ช่องทาง CTA เจ้าของงาน และตัวชี้วัด - ปัญหา: AI เขียนไทยไม่ตรงเสียงแบรนด์
สาเหตุ: ระบบไม่มีตัวอย่างภาษาและคำที่ควรหลีกเลี่ยง
วิธีแก้: แนบตัวอย่างข้อความที่ผ่านการอนุมัติ 3 ถึง 5 ชิ้น พร้อมบอกคำต้องห้าม ระดับความเป็นทางการ และกลุ่มลูกค้า - ปัญหา: ทีมเชื่อผลลัพธ์ AI มากเกินไป
สาเหตุ: ไม่มีขั้นตอนตรวจข้อเท็จจริงหรือคนรับผิดชอบชัดเจน
วิธีแก้: ตั้งจุดอนุมัติสำหรับตัวเลข ราคา กฎหมาย สุขภาพ และข้ออ้างเกี่ยวกับสินค้า ก่อนเผยแพร่ทุกครั้ง - ปัญหา: ค่าใช้จ่ายสูง แต่ไม่ได้งานเพิ่ม
สาเหตุ: ใช้ model ระดับสูงกับงานง่าย หรือสั่งงานวนซ้ำโดยไม่มี template
วิธีแก้: แยก workflow ตามระดับความซับซ้อน ตั้งเพดานงบ และบันทึก prompt ที่ผ่านแล้วเพื่อนำกลับมาใช้ - ปัญหา: ข้อมูลจากหลายฝ่ายขัดกันจนคำตอบสับสน
สาเหตุ: เอกสารต้นทางไม่เป็นแหล่งเดียวกัน และไม่มีลำดับความน่าเชื่อถือ
วิธีแก้: กำหนด source of truth เช่น ไฟล์ราคาเวอร์ชันล่าสุด FAQ ที่อนุมัติแล้ว และรายชื่อลูกค้าที่อัปเดต ก่อนส่งข้อมูลเข้าสู่ workflow
การต่อยอดจาก AI chat สู่ระบบทำงานจริง
แนวคิดจาก Fugu ชวนให้ต่อยอดในทางที่จับต้องได้ โดยไม่จำเป็นต้องสร้างระบบ multi-agent ซับซ้อนตั้งแต่วันแรก
- สร้างศูนย์ความรู้ภายใน: รวม FAQ คู่มือขาย นโยบาย และข้อมูลสินค้า เพื่อให้ทีมร่างคำตอบจากข้อมูลเดียวกัน
- ทำ workflow ดูแล lead: ให้ AI สรุปแชต จัดระดับความสนใจ ร่างข้อความติดตาม และส่งต่อเฉพาะเคสที่พร้อมให้ทีมขายคุยต่อ
- ทำระบบคอนเทนต์แบบปิดวง: ใช้ข้อมูลคำถามลูกค้า รีวิว และยอดขายเป็น input ให้ AI เสนอหัวข้อ ร่างงาน แล้วให้ทีมวัดผลเพื่อนำข้อมูลกลับไปปรับรอบถัดไป
เป้าหมายไม่ใช่สร้างระบบที่ดูฉลาดที่สุด แต่คือสร้าง workflow ที่ทำให้ข้อมูลเดินจากจุดหนึ่งไปสู่อีกจุดหนึ่งได้ดีขึ้น ลดการคัดลอกงาน และทำให้คนในทีมใช้เวลากับงานที่ต้องอาศัยการตัดสินใจมากกว่า
เช็กลิสต์ก่อนทดลอง workflow หลาย agent
- ☐ เลือกงานซ้ำเพียงหนึ่งงานที่มีผลต่อเวลา ต้นทุน หรือรายได้
- ☐ กำหนดผลลัพธ์ปลายทาง ผู้ใช้ และตัวชี้วัดของงานนั้น
- ☐ แยกงานย่อยเป็นบทบาท เช่น วิเคราะห์ เขียน ตรวจ และจัดลำดับ
- ☐ เลือกงานทั่วไปให้ใช้ model หรือระบบที่เน้นต้นทุน และสงวนงานยากให้ระบบ reasoning สูง
- ☐ เตรียมข้อมูลต้นทางที่ถูกต้องและเป็นเวอร์ชันเดียวกัน
- ☐ สร้าง prompt template พร้อมตัวอย่างภาษาแบรนด์
- ☐ ตั้งจุดให้คนตรวจเรื่องราคา ข้อเท็จจริง กฎหมาย และข้อมูลลูกค้า
- ☐ ทดสอบกับงานชุดเล็กก่อน แล้ววัดเวลา คุณภาพ และต้นทุนจริง
- ☐ เก็บสิ่งที่ใช้ได้เป็นคลัง workflow ของทีม
- ☐ ขยายไปสู่งานถัดไปเมื่อ workflow แรกผ่านเกณฑ์ชัดเจน
Fugu Max และ Fugu Ultra v2 สะท้อนทิศทางที่น่าจับตา คือ AI จะไม่ได้แข่งขันกันแค่ว่า model ใดตอบเก่งที่สุด แต่แข่งขันกันว่าใครจัดสรร model หลายตัวให้ทำงานเป็นระบบได้ดีกว่า สำหรับธุรกิจไทย บทเรียนที่นำไปใช้ได้ทันทีคือ เลิกถามว่า AI ตัวไหนดีที่สุด แล้วเริ่มถามว่า workflow ไหนควรถูกออกแบบใหม่เพื่อให้คนและ AI ทำงานร่วมกันได้ดีขึ้น