ที่มา: บทความ VideoToBlog วันที่ 2026-07-08 และคลิปของ Julian Goldie SEO วันที่นี้เป็นวันที่บทความ ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยัน ผลลัพธ์ ตัวเลข และข้อเสนอเชิงธุรกิจเป็นคำกล่าวหรือภาพในต้นฉบับ ไม่ใช่ผลทดสอบซ้ำหรือคำรับรองผลในปัจจุบัน ตัวอย่างธุรกิจไทยเป็นการประยุกต์ตามต้นฉบับ · วิดีโอต้นทาง
ปัญหาของการเอา AI ไปใช้ทำงานจริง ไม่ได้อยู่ที่ model เก่งไม่เก่งอย่างเดียว แต่อยู่ที่ระบบหลังบ้านรกแค่ไหน เก็บงานย้อนกลับได้หรือเปล่า และเวลา workflow เริ่มเยอะขึ้น เรายังควบคุมมันได้อยู่ไหม คลิปจาก Julian Goldie SEO พูดถึงจุดนี้ชัดมาก ผ่านอัปเดตใหม่ของ Hermes ที่ดูเงียบๆ แต่กระทบกับการใช้งานจริงมากกว่าที่หลายคนคิด
สาระสำคัญของคลิปนี้มีอยู่ 2 ส่วน คือการจัดการ session ของ AI agent ให้เป็นระบบ และการทดลองใช้ HY3 โมเดลฟรีแบบ open source ที่เพิ่งเข้ามาใน Hermes ช่วงสั้นๆ สิ่งที่น่าสนใจคือคลิปนี้ไม่ได้ขายฝันว่าโมเดลใหม่จะเทพสุด แต่ชี้ให้เห็นตรงๆ ว่าตรงไหนใช้ได้ ตรงไหนยังตัน และถ้าเอามาคิดต่อในมุมเจ้าของธุรกิจไทย เราควรหยิบอะไรไปใช้ก่อน
สารบัญ
- Step 1: ทำความเข้าใจก่อนว่า Hermes คืออะไร และทำไมคนทำงานควรสนใจ
- Step 2: ใช้ฟีเจอร์ Export Session เพื่อเก็บ workflow ที่เวิร์กจริง
- Step 3: เคลียร์ session เก่าให้ workspace โล่งด้วย Prune และ Archive
- Step 4: รู้จัก HY3 ให้ตรงความจริง ก่อนรีบคาดหวังเกินไป
- Step 5: ดูผลทดสอบจริง แล้วแยกให้ออกว่า “ใช้ฟรีได้” ไม่เท่ากับ “ดีที่สุด”
- Step 6: เอาแนวคิดนี้มาปรับใช้กับธุรกิจไทยให้คุ้มที่สุด
- Actionable Insights
- Troubleshooting
- การต่อยอด
- Step 7: สรุปให้ชัดว่าอัปเดตนี้คุ้มกับใครที่สุด
- สรุป Checklist ทั้งหมด
Step 1: ทำความเข้าใจก่อนว่า Hermes คืออะไร และทำไมคนทำงานควรสนใจ
Hermes ถูกอธิบายว่าเป็น AI agent ที่อยู่ในเครื่องและช่วยลงมือทำงานจริงได้ ไม่ได้หยุดแค่ตอบแชต มันทำงานผ่าน terminal, desktop app และเชื่อมกับแอปสนทนาได้ รวมถึงเรียกใช้เครื่องมือ จำงานเก่า และทำงานต่อเนื่องหลายขั้นได้
มุมที่สำคัญสำหรับคนทำธุรกิจคือ Hermes ไม่ได้ผูกติดกับ model เดียว เราสลับ model ได้ตามงาน เช่น งานที่ต้องการ reasoning ยาวๆ อาจใช้ตัวหนึ่ง งานที่เน้นต้นทุนต่ำอาจใช้อีกตัว นี่เป็นแนวคิดที่ดีมาก เพราะในโลกจริงเราไม่ควรสร้างระบบที่ฝากชีวิตไว้กับ AI เจ้าเดียว
ถ้าเอามาแปลเป็นภาษาธุรกิจไทย Hermes คือผู้ช่วยที่ไม่ใช่แค่ตอบคำถาม แต่ช่วยทำงานเป็นชุด เช่น
- สรุปรายงานการประชุมแล้วจัดเก็บเป็นหมวด
- ร่างคอนเทนต์หลายชิ้นจากหัวข้อที่ทีมขายเจอบ่อย
- ช่วยค้นข้อมูลจากเอกสารยาวๆ แล้วสรุปเป็น action items
- เชื่อม workflow งานซ้ำๆ ให้เดินเองมากขึ้น
จุดที่เรามองว่าน่าสนใจกว่าคำว่า “ฉลาดขึ้น” คือคำว่า “จัดการได้ง่ายขึ้น” เพราะเวลาทีมเริ่มใช้ AI จริง ปัญหาจะไม่ใช่มี use case หรือไม่ แต่จะกลายเป็นตามไม่ทันว่าใครรันอะไรไปบ้าง ผลลัพธ์ชิ้นไหนควรเก็บ ชิ้นไหนควรทิ้ง
Step 2: ใช้ฟีเจอร์ Export Session เพื่อเก็บ workflow ที่เวิร์กจริง
ตามที่ผู้สร้างอธิบาย อัปเดตนี้เพิ่มการ export session หลายรูปแบบ เลือกปลายทางและจำนวน session ได้ พร้อมตัวเลือก scrub key หรือ token ภาพประกอบในบทความไม่ได้แสดงขั้นตอนนี้หรือยืนยันว่าลบข้อมูลลับได้ครบ จึงต้องตรวจไฟล์ที่ส่งออกด้วยตนเองและจำกัดผู้รับก่อนแชร์
ฟังเผินๆ อาจเหมือนเป็นฟีเจอร์เล็ก แต่จริงๆ มันสำคัญมากกับการใช้ AI ในองค์กร เพราะงานที่ทำกับ AI มักหายไปในแชตหรือกระจายอยู่หลายที่ พอจะย้อนกลับมาดูว่า prompt ไหนทำให้ได้ผลดีจริงก็มักหาไม่เจอ
ในคลิปมีการยกตัวอย่างการ export session ที่ใช้สร้างคอนเทนต์ทั้งหมดออกมาเป็นไฟล์ที่จัดระเบียบเรียบร้อย เพื่อย้อนมาดูว่าอะไรเวิร์กและอะไรไม่เวิร์ก นี่คือวิธีคิดที่ถูกต้องมาก เพราะถ้าเราอยากให้ AI ช่วยงานได้ดีขึ้น เราต้องสะสม “งานที่เคยทำได้ดี” ไว้เป็นทรัพย์สินของทีม
สำหรับธุรกิจไทย ฟีเจอร์นี้เอาไปใช้ได้หลายแบบ เช่น
- เก็บ prompt และผลลัพธ์ของแคมเปญโฆษณาที่ทำยอดขายดี
- เก็บ session ที่ใช้ตอบคำถามลูกค้าจนปิดการขายได้
- เก็บ workflow การสรุปเอกสารสัญญา หรือคู่มือภายใน
- เก็บต้นแบบการเขียนโพสต์, สคริปต์, หรืออีเมลที่ทีมใช้ซ้ำบ่อย
มุมวิเคราะห์ที่อยากเติมคือ หลายทีมรีบหา prompt ใหม่ตลอดเวลา ทั้งที่สิ่งที่ควรทำก่อนคือ สร้างคลังงานที่พิสูจน์แล้วว่าใช้ได้ ถ้าไม่มีระบบเก็บ session ต่อให้ใช้ model แพงแค่ไหน ความรู้ก็หายทุกวัน
ถ้าอยากออกแบบคลังความรู้ของทีมให้ต่อยอดง่ายขึ้น อาจดูแนวทางเรื่อง knowledge management เพิ่มจาก Atlassian ได้ เพราะหลักการเดียวกันนี้ใช้กับงาน AI ได้ดี
Step 3: เคลียร์ session เก่าให้ workspace โล่งด้วย Prune และ Archive
ผู้สร้างรายงานการ prune และ archive session ด้วยตัวกรอง เช่น วันที่ model โฟลเดอร์ หรือผู้ใช้ ก่อนใช้จริงต้องตรวจความหมายของแต่ละคำสั่ง สำรองข้อมูล และดูรายการที่จะได้รับผลกระทบหรือใช้ dry run หากรองรับ เพราะ prune อาจลบข้อมูลและไม่ควรถูกตีความว่าเหมือน archive
ความต่างที่ควรเข้าใจคือ archive ไม่ใช่ลบ ผู้สร้างอธิบายว่า archive ใช้ซ่อน session โดยยังเก็บไว้ แต่ต้องตรวจวิธีกู้คืนและพฤติกรรมของเวอร์ชันที่ใช้จริง ไม่ถือว่า prune หรือการล้างทุกแบบสามารถย้อนกลับได้
ในคลิปมีตัวอย่างการ archive session ทดสอบเก่าๆ ที่เคยใช้วาง onboarding flow แล้วดัน session ที่ใช้จริงขึ้นมาอยู่ด้านหน้า ผลคือพื้นที่ทำงานสะอาดขึ้นและหา session สำคัญเจอเร็วขึ้น
นี่เป็นประเด็นที่คนทำงานไทยมักมองข้าม เราชอบสนใจว่าตัว AI ทำอะไรได้ แต่ไม่ค่อยสนใจว่าระบบการจัดเก็บงานจะพังเมื่อไหร่ ซึ่งพอทีมเริ่มใช้ AI พร้อมกันหลายคน ปัญหาจะมาเร็วมาก เช่น
- มี session ทดสอบเต็มไปหมดจนแยกไม่ออกว่าอันไหนของจริง
- ทีมใช้ชื่อไฟล์และโฟลเดอร์ไม่เหมือนกัน
- model หลายตัวให้ผลต่างกัน แต่ไม่มีการแยกบันทึก
- งานดีถูกกลบด้วยงานทดลอง
ถ้าเรามอง AI เป็นระบบงาน ไม่ใช่ของเล่น ฟีเจอร์ archive นี่มีค่าไม่น้อยกว่า model ใหม่เลย เพราะมันช่วยลดต้นทุนทางความสับสนของทีม
ข้อเห็นต่างเล็กน้อยคือ ต่อให้มีฟีเจอร์กรองดีแค่ไหน ถ้าทีมไม่ตั้งกติกาการตั้งชื่อ project, folder หรือประเภทงานตั้งแต่ต้น ความรกก็จะกลับมาอีกอยู่ดี ดังนั้นเครื่องมือช่วยได้แค่ครึ่งเดียว อีกครึ่งคือวินัยของทีม
Step 4: รู้จัก HY3 ให้ตรงความจริง ก่อนรีบคาดหวังเกินไป
อัปเดตใหญ่สุดในคลิปคือการมาของ HY3 จาก Tencent Hunyuan ซึ่งผู้สร้างระบุว่าเปิดให้ใช้ฟรีชั่วคราวในเวลาที่บันทึกคลิป และกล่าวถึงสเปก 295B parameters กับ 21B active ตัวเลขเหล่านี้เป็นข้อมูลตามต้นฉบับ ไม่ยืนยันเงื่อนไขฟรีหรือประสิทธิภาพปัจจุบัน
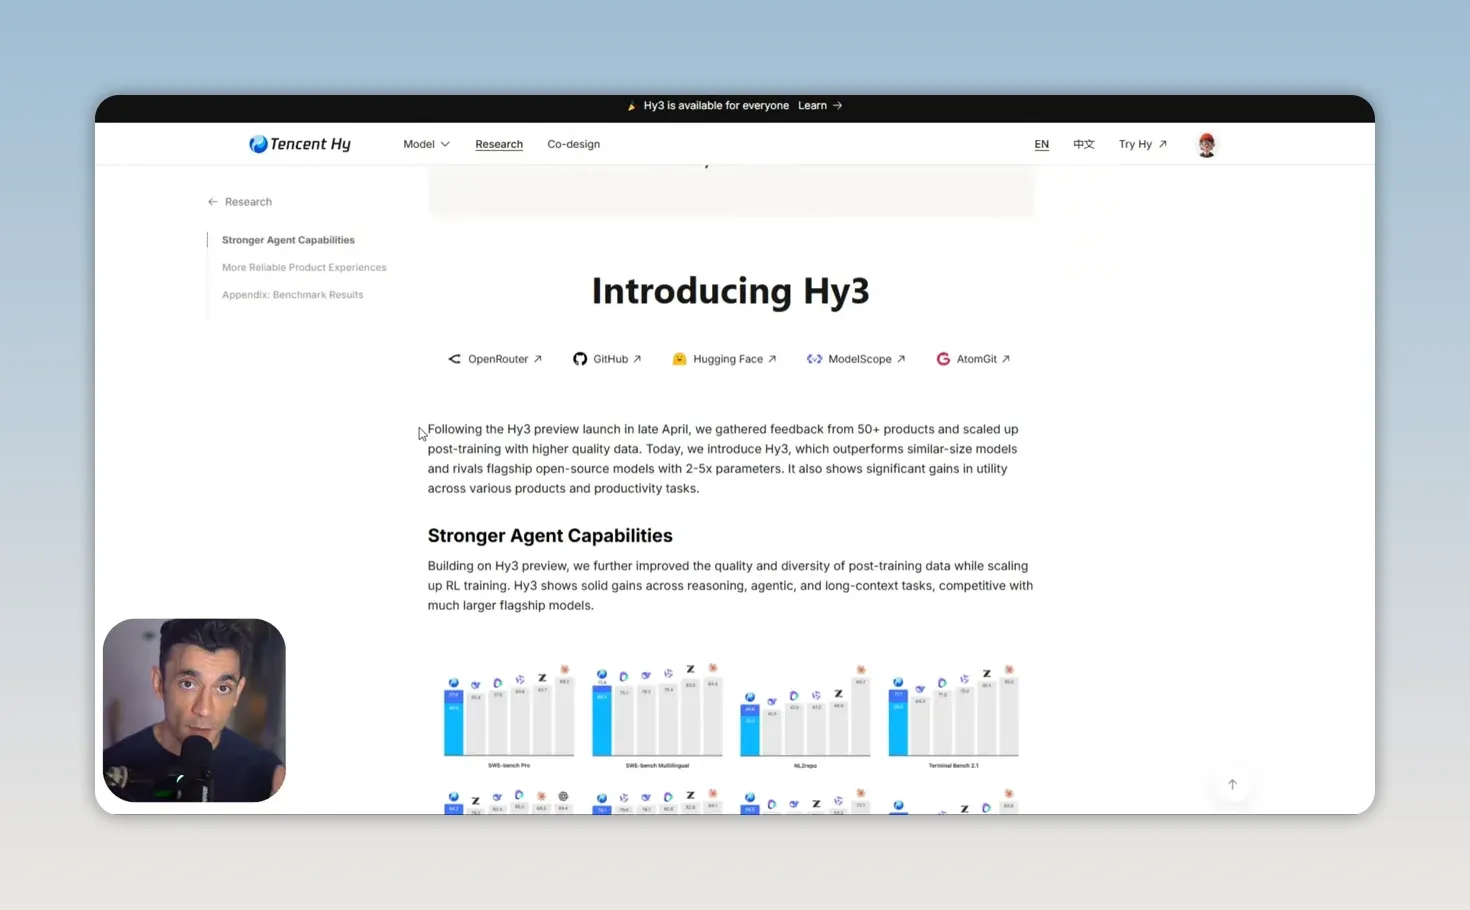
อีกจุดที่สำคัญคือ HY3 รองรับ context ได้ถึง 256,000 tokens เหมาะกับงานที่ต้องถือข้อมูลยาวๆ ไว้ในรอบเดียว เช่น เอกสารหลายหน้า สเปกงานยาว หรือ workflow หลายชั้น และถูกออกแบบมาสำหรับงานแบบ agent โดยเฉพาะ ทั้งด้าน coding, tool calling และ reasoning ระยะยาว
ในเชิงเทคนิค นี่ถือว่าน่าสนใจ แต่ถ้าแปลเป็นภาษาคนทำธุรกิจ ความหมายคือ
- ใส่งานยาวๆ เข้าไปได้มากขึ้นโดยไม่ต้องตัดทอนบ่อย
- เหมาะกับงานที่มีหลายขั้นตอนต่อเนื่อง
- เหมาะกับการทดลองสร้างระบบ AI ของตัวเองโดยไม่ต้องเริ่มจากต้นทุนสูง
ผู้สร้างไม่ได้เสนอว่า HY3 ดีที่สุดทุกงาน ส่วนคำว่าใช้ฟรีและ open source เป็นคำอธิบายในต้นฉบับ ต้องตรวจเงื่อนไขบริการและใบอนุญาตจริงก่อนใช้ ไม่ถือว่าให้ใช้ฟรีถาวรหรืออนุญาตทุกการใช้งาน
ถ้าอยากทำความเข้าใจภาพรวมเรื่องโมเดล open source เพิ่ม อาจอ่านข้อมูลพื้นฐานจาก Hugging Face เพื่อเห็นว่าตลาดนี้กำลังโตและมีตัวเลือกมากขึ้นเรื่อยๆ
Step 5: ดูผลทดสอบจริง แล้วแยกให้ออกว่า “ใช้ฟรีได้” ไม่เท่ากับ “ดีที่สุด”
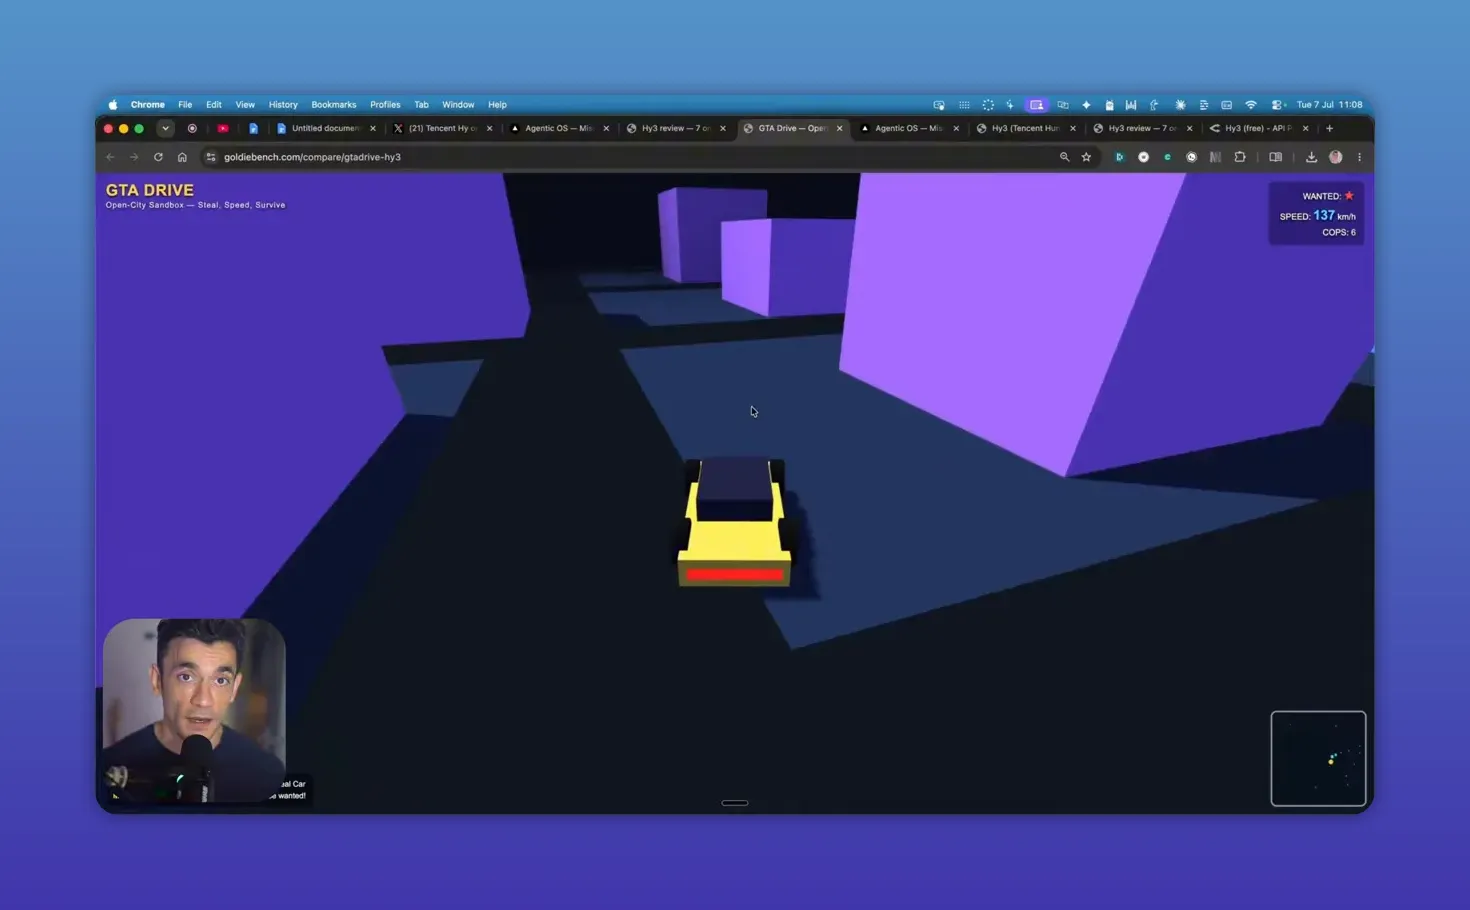
ผู้สร้างเล่าผลทดลอง HY3 กับหน้าเว็บและเกม เพื่อเทียบความคาดหวังกับผลที่ตนพบ ภาพนิ่งที่เก็บไว้ไม่ยืนยันการเล่น ความเสถียร หรือเวลาแก้ไข และไม่ใช่ benchmark ที่เว็บไซต์นี้ทดสอบซ้ำ
ตัวอย่างแรกคือการให้มันช่วยสร้าง landing page ภายใน Agent OS ผลออกมาถือว่าโอเค หน้าตาดูสะอาด ใช้งานได้ในระดับหนึ่ง เป็นสัญญาณที่ดีว่ามันพอรับงานสร้างหน้าเว็บเบื้องต้นได้
แต่พอเริ่มดันไปงานที่ซับซ้อนขึ้น เช่น เกมหรือฉาก 3D หลายแบบ ข้อจำกัดก็เริ่มโผล่ชัด ทั้งรายละเอียดภาพที่ยังพื้นๆ ความ glitch ระหว่างใช้งาน และคุณภาพที่ยังไม่เทียบชั้น model แถวหน้า
ในคลิปมีทั้งตัวอย่างตัวละครขนาดเพี้ยน ฉากเมืองที่ดูสนุกแต่ยังหยาบ เกมเครื่องบินที่ยังไม่ลงตัว และเกมร่มชูชีพที่พอเล่นได้แต่ยังไม่ถึงระดับที่หวังไว้ ที่สำคัญคือมีการลองปรับกลับไปกลับมาหลายชั่วโมงแล้วผลก็ยังไม่สุด
บทเรียนจากตรงนี้มีค่ามากสำหรับคนทำธุรกิจ เพราะมันย้ำว่า เราไม่ควรประเมิน AI จากเดโมที่สวยที่สุด แต่ควรดูว่าหลังลองแก้หลายรอบแล้ว มันยังพาเราไปต่อได้ไหม
มุมมองของเราคือ HY3 เหมาะกับงาน 2 กลุ่มมากกว่า
- งานใช้งานประจำวัน เช่น สรุปเอกสาร ร่าง outline ช่วยคิดโครงสร้างงาน เรียกใช้เครื่องมือ
- งานทดลองระบบ เช่น ลองสร้าง AI workflow ภายในโดยยังไม่อยากจ่ายแพง
แต่ถ้าหวังงานสร้างสรรค์ที่ต้องละเอียดมาก หรือผลลัพธ์ระดับ polished พร้อมใช้งานเลย เราอาจยังต้องเผื่องบให้ model ที่เก่งกว่า หรือใช้ HY3 แค่เป็นตัวช่วยร่างแรก
Step 6: เอาแนวคิดนี้มาปรับใช้กับธุรกิจไทยให้คุ้มที่สุด
ถ้ามองจากคลิปทั้งหมด สิ่งที่เอาไปใช้กับธุรกิจไทยได้ทันทีไม่ใช่แค่ HY3 แต่คือวิธีคิดเรื่อง AI operations หรือการจัดการงาน AI ให้เป็นระบบ
ตัวอย่างที่เห็นภาพชัดมีดังนี้
กรณีที่ 1: ทีมคอนเทนต์
ใช้ Hermes เก็บ session ที่เคยร่างโพสต์ขายดี สคริปต์วิดีโอที่คนอ่านต่อ หรืออีเมลที่เปิดสูง จากนั้น archive งานทดลองที่ไม่ใช้แล้ว เมื่อถึงเวลาทำแคมเปญใหม่ เราจะไม่เริ่มจากศูนย์
กรณีที่ 2: ทีมขายและบริการลูกค้า
เก็บ session ที่ใช้ตอบ objection ของลูกค้าได้ผล หรือสรุปคำถามซ้ำๆ แล้ว export ออกมาเป็น playbook ภายใน ช่วยให้ทีมใหม่เรียนรู้งานเร็วขึ้น
กรณีที่ 3: เจ้าของกิจการขนาดเล็ก
ใช้ HY3 ทดลองงานที่กินเวลา เช่น สรุปเอกสารยาว ร่างแผนคอนเทนต์ทั้งสัปดาห์ หรือจัดหมวด insight จากการคุยกับลูกค้า โดยยังไม่ต้องเริ่มจาก subscription แพง
หัวใจคืออย่ามอง AI เป็นเครื่องทำคำตอบ แต่มองเป็นระบบสะสมงานที่ดีขึ้นเรื่อยๆ ถ้าเราทำจุดนี้ได้ ต่อให้ model เปลี่ยนในอนาคต ทรัพย์สินจริงของเราก็ยังอยู่
Actionable Insights
- เริ่มจาก export session ที่ให้ผลดีที่สุด 10 ชิ้นแรก แล้วแยกเป็นหมวดงานขาย งานคอนเทนต์ และงานภายใน
- ตั้งกติกา archive งานทดสอบทุกสัปดาห์ เพื่อไม่ให้ session ใช้งานจริงจมหาย
- ลอง HY3 กับงานเอกสารยาวหรือ workflow หลายขั้นก่อน อย่าเริ่มจากงานที่ต้องภาพสวยหรือ polished มาก
- เปรียบเทียบผลลัพธ์ของ HY3 กับ model ที่ใช้อยู่ในงานเดียวกัน แล้ววัดจากเวลาและคุณภาพ ไม่ใช่ความตื่นเต้น
- สร้าง AI playbook ของทีมจาก session ที่ export ออกมา แทนการพึ่งความจำของแต่ละคน
Troubleshooting
- ปัญหา: หา session ดีๆ ไม่เจอ
สาเหตุ: ใช้งานสะสมมานานแต่ไม่ archive งานทดลอง
วิธีแก้: ตั้งรอบจัด session ทุกสัปดาห์ กรองตามวันที่และประเภทงาน แล้ว archive สิ่งที่ไม่ใช้ - ปัญหา: แชร์ session ให้ทีมไม่ได้เพราะมีข้อมูลลับปนอยู่
สาเหตุ: ใน session มี key, token หรือข้อมูลภายใน
วิธีแก้: ใช้ตัวเลือก scrub หากมี แล้วตรวจไฟล์ส่งออกเองทุกครั้งทั้ง key, token, ข้อมูลลูกค้า และข้อมูลภายใน แชร์เฉพาะผู้รับที่ได้รับอนุญาต ไม่ถือว่าการ scrub อัตโนมัติรับประกันว่าปลอดข้อมูลลับ - ปัญหา: HY3 ทำงานได้ แต่ผลลัพธ์ยังไม่เนียนพอ
สาเหตุ: model นี้เก่งระดับใช้งานได้ แต่ยังไม่ใช่แนว frontier model
วิธีแก้: ใช้มันสำหรับร่างแรก สรุปข้อมูล หรือโครงสร้างงาน แล้วค่อยให้ model อื่นเก็บรายละเอียด - ปัญหา: ลองแก้ prompt หลายรอบแล้วงานยังไม่ตรง
สาเหตุ: งานนั้นอาจเกินจุดแข็งของ model หรือโจทย์กว้างเกินไป
วิธีแก้: แยกงานเป็นขั้นย่อย ลดความกำกวม และทดสอบทีละส่วนแทนการสั่งยาวครั้งเดียว - ปัญหา: ทีมใช้ AI เหมือนกันแต่ต่อยอดกันไม่ได้
สาเหตุ: ไม่มีระบบเก็บ workflow กลาง
วิธีแก้: export session ที่ดีที่สุดไว้ในคลังกลาง และตั้งชื่อหมวดหมู่ให้ชัดตั้งแต่ต้น
การต่อยอด
- สร้าง library ของ prompt และ session ที่แยกตามหน่วยงาน เช่น การตลาด ฝ่ายขาย ฝ่ายปฏิบัติการ
- ทำคะแนนให้ session ที่ใช้ได้ผลจริง เพื่อให้ทีมรู้ว่า workflow ไหนควรนำกลับมาใช้ก่อน
- ทดลองใช้หลาย model ใน Hermes กับงานเดียวกัน แล้วออกแบบ routing ว่างานแบบไหนควรไปที่ model ไหน
Step 7: สรุปให้ชัดว่าอัปเดตนี้คุ้มกับใครที่สุด
ถ้าเราเป็นคนที่กำลังสร้างระบบ AI ใช้เอง อัปเดต Hermes ชุดนี้คุ้มมาก เพราะมันไม่ได้แค่เพิ่ม model ใหม่ แต่เพิ่มความเป็นระเบียบให้ทั้งระบบ โดยเฉพาะ export, prune และ archive ที่ช่วยให้การทำงานต่อเนื่องไม่พังเพราะความรก
ส่วน HY3 ควรมองแบบไม่อวยเกินจริง มันไม่ใช่โมเดลที่ดีที่สุดเท่าที่มี แต่เป็น โมเดลที่ผู้สร้างเสนอให้ทดลองภายใต้เงื่อนไขในเวลานั้น โดยเฉพาะกับงานทั่วไป งานเอกสารยาว งานที่ต้องเรียกใช้เครื่องมือ และการทดลองสร้าง agent workflow แบบต้นทุนต่ำ
ถ้าจะสรุปเป็นภาษาคนทำธุรกิจ อัปเดตนี้ไม่ได้ทำให้ AI เก่งขึ้นแบบมหัศจรรย์ แต่มันทำให้เรา ทำงานกับ AI ได้เป็นระบบขึ้น และนั่นมักมีค่ามากกว่าการไล่ตาม model ใหม่ทุกสัปดาห์
สรุป Checklist ทั้งหมด
- เข้าใจบทบาทของ Hermes ว่าเป็น AI agent สำหรับงานจริง ไม่ใช่แค่แชตบอต
- อัปเดต Hermes เพื่อเปิดใช้ฟีเจอร์ session tools ใหม่
- export session ที่ให้ผลดีที่สุดออกมาเก็บเป็นคลังความรู้
- ลบหรือซ่อนข้อมูลลับก่อนแชร์ session ออกนอกทีม
- prune และ archive session เก่าด้วยตัวกรองที่เหมาะกับงาน
- แยกงานทดสอบออกจากงานใช้งานจริงให้ชัด
- ทดลอง HY3 กับงานเอกสารยาว งานสรุป และ workflow หลายขั้น
- อย่าคาดหวังว่า HY3 จะชนะทุกงาน โดยเฉพาะงานที่ต้องความละเอียดสูงมาก
- เปรียบเทียบ HY3 กับ model อื่นจากผลลัพธ์จริงและเวลาที่ใช้
- สร้าง AI playbook ของทีมจาก session ที่พิสูจน์แล้วว่าใช้ได้
สรุปสุดท้ายจากคลิปของ Julian Goldie SEO คือ เรื่องที่เงียบที่สุดอาจเป็นเรื่องที่กระทบงานจริงที่สุด Hermes update ครั้งนี้ไม่ได้ขายความหวือหวา แต่มอบสิ่งที่คนทำงานกับ AI ต้องการจริง คือการเก็บงานเป็นระบบ จัดระเบียบได้ และทดลอง model ใหม่อย่าง HY3 โดยไม่ต้องแบกรับต้นทุนสูงตั้งแต่วันแรก