ที่มา: คลิป NEW GLM 5.3 is WILD! 😱 ของ Julian Goldie SEO และบทความ VideoToBlog วันที่ 2026-08-15 (วันที่แสดงในบทความต้นทาง ไม่ใช่วันที่อัปโหลดวิดีโอที่ตรวจยืนยันแล้ว) ชื่อรุ่น สเปก ราคา ความพร้อมใช้งาน และผลทดสอบเป็นสิ่งที่แหล่งต้นทางกล่าวไว้ในขณะนั้น ยังไม่ได้ทดสอบซ้ำหรือตรวจยืนยันสถานะล่าสุด ตัวอย่างสำหรับธุรกิจไทยเป็นการประยุกต์จากบทความต้นทาง · วิดีโอต้นทาง
จุดที่น่าสนใจกับ GLM 5.3 ไม่ใช่แค่ว่า AI รุ่นนี้เขียนโค้ดเก่งขึ้น แต่คือแนวคิดเบื้องหลัง: ทีมพัฒนาไม่ได้ทำ model ให้ใหญ่กว่าเดิม กลับฝึกให้ model เดิมรับมือกับงานยาว งานซับซ้อน และการแก้ความผิดพลาดของตัวเองได้ดีขึ้นมาก
คลิปจากช่อง Julian Goldie SEO ชี้ให้เห็นการเปลี่ยนผ่านจาก AI แบบ chatbot ไปสู่ AI worker ที่รับโจทย์ วางแผน ลงมือทำ ทดสอบ และวนกลับมาแก้งานได้เอง สำหรับเจ้าของธุรกิจไทย ประเด็นนี้สำคัญกว่าตัวเลข benchmark เพราะมันเปิดทางให้ธุรกิจขนาดเล็กสร้างเครื่องมือเฉพาะกิจ โดยไม่ต้องเริ่มจากการจ้างทีมพัฒนาเต็มรูปแบบ
แต่การตีความว่า AI จะทำทุกอย่างแทนคนได้ทันทีนั้นอันตรายกว่าเป็นประโยชน์ สิ่งที่ควรนำไปใช้คือแนวคิดการออกแบบงานใหม่ ให้ AI รับผิดชอบงานซ้ำและมีขอบเขตชัด ส่วนคนยังเป็นผู้กำหนดมาตรฐาน ตรวจผล และตัดสินใจเรื่องที่กระทบลูกค้าหรือรายได้
สารบัญ
- Step 1: เข้าใจว่าทำไม GLM 5.3 จึงน่าจับตา
- Step 2: มองบทเรียนสำคัญ คือฝึก AI ให้เก่งกว่าการขยายขนาด
- Step 3: เปลี่ยนจาก chatbot เป็น AI worker สำหรับงานธุรกิจ
- Step 4: เขียนโจทย์ให้ AI ทำงานเป็นขั้นตอนและตรวจผลได้
- Step 5: วัดความคุ้มค่า ไม่ใช่หลงกับความสามารถของ model
- Step 6: ตรวจความพร้อมใช้งานและข้อจำกัดก่อนตัดสินใจ
- Step 7: Actionable Insights สำหรับเจ้าของธุรกิจและคนทำงาน
- Step 8: Troubleshooting แก้ปัญหาที่มักเกิดเมื่อเริ่มใช้ AI worker
- Step 9: การต่อยอดหลังจาก workflow แรกเริ่มนิ่ง
- Step 10: สรุป Checklist ทั้งหมดก่อนใช้ GLM 5.3 และ AI worker
Step 1: เข้าใจว่าทำไม GLM 5.3 จึงน่าจับตา
GLM 5.3 ถูกนำเสนอว่าเป็น AI ที่ทำงานด้าน coding แบบ agentic ได้ดีขึ้น กล่าวคือ ไม่ได้เพียงเสนอ code บางส่วนตามคำสั่ง แต่สามารถมองงานทั้งก้อน แยกปัญหา แก้ไฟล์ที่เกี่ยวข้อง รันทดสอบ แล้วแก้ซ้ำเมื่อผลทดสอบยังไม่ผ่าน
ตัวชี้วัดที่ถูกยกมาในคลิปสะท้อนการกระโดดของความสามารถในงานที่ทำผ่าน terminal โดยคะแนน Terminal Bench เพิ่มจาก 4.6 เป็น 28.3 หรือราวหกเท่า ส่วน Deep SWE เพิ่มจาก 46.2 เป็น 66.9 คะแนน ผลลัพธ์เหล่านี้ไม่ได้แปลว่า GLM 5.3 เหนือกว่า AI ทุกตัวในทุกงาน แต่บอกได้ว่าความสามารถด้านงานหลายขั้นตอนกำลังโตเร็วมาก
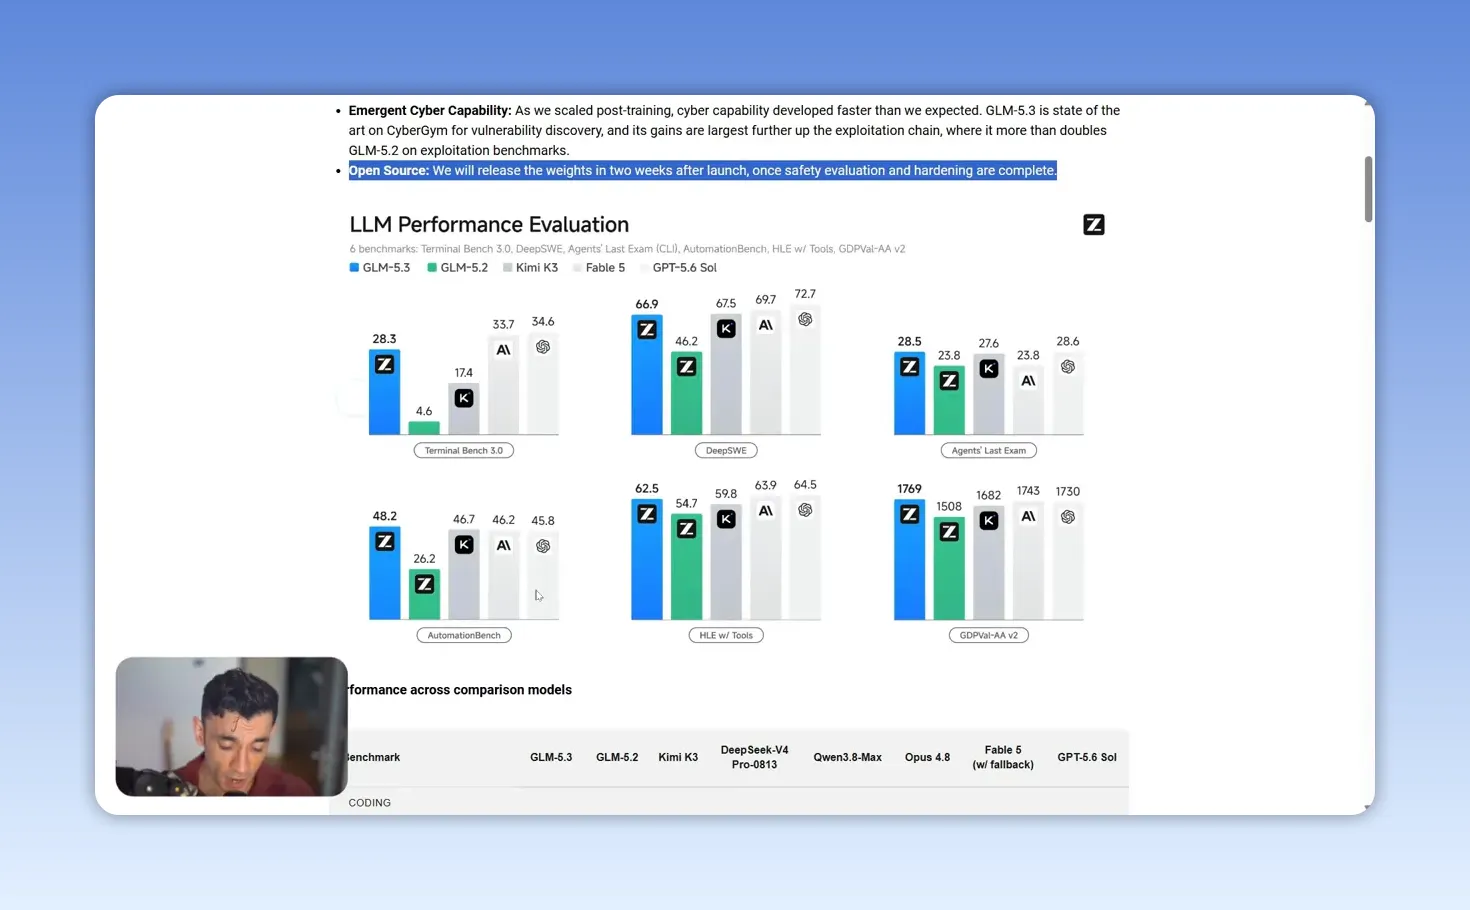
ตัวเลข benchmark ควรใช้เป็นสัญญาณตั้งต้น ไม่ใช่คำตัดสินสุดท้าย เพราะ benchmark วัดงานภายใต้เงื่อนไขจำกัด งานจริงของธุรกิจมักมีข้อมูลไม่ครบ ระบบหลายตัว และข้อยกเว้นที่ไม่ได้อยู่ในชุดทดสอบ แม้ตัวเลขของผู้พัฒนาระบุว่า model ดีขึ้นราว 50% ในการทดสอบภายใน ก็ยังควรรอการตรวจสอบจากแหล่งอิสระก่อนสรุปผลแรงเกินไป
แนวปฏิบัติที่รอบคอบคือศึกษาวิธีวัดผลของ Terminal Bench แล้วนำมาเปรียบเทียบกับงานที่ธุรกิจต้องการให้ AI ทำจริง เช่น ความถูกต้องของข้อมูล เวลาที่ใช้ จำนวนครั้งที่ต้องแก้ และผลกระทบเมื่องานผิดพลาด
Step 2: มองบทเรียนสำคัญ คือฝึก AI ให้เก่งกว่าการขยายขนาด
หัวใจของ GLM 5.3 คือแนวคิด “ฝึกให้ฉลาดขึ้น” แทนการเพิ่มขนาดของสมอง AI ทีมพัฒนาให้ model ฝึกในสถานการณ์จำลองจำนวนมาก ทั้งงาน coding ที่ยาว งานที่มีความยุ่งเหยิง และโจทย์ที่ต้องวางแผนล่วงหน้า จากนั้นปล่อยให้ลองผิดลองถูก ตรวจงานตัวเอง แล้วเรียนรู้จากรอบที่ล้มเหลว
เปรียบได้กับพนักงานที่มีความสามารถพื้นฐานดีอยู่แล้ว แต่ได้รับโจทย์จริงหลายพันรูปแบบ พร้อม feedback ที่ชัดเจน พนักงานคนนั้นย่อมจัดการงานได้ดีขึ้นโดยไม่จำเป็นต้องมีความรู้เพิ่มทุกเรื่อง
มุมนี้มีผลต่อคนทำงานมาก เพราะการใช้ AI ให้ได้ผลไม่ได้ขึ้นกับว่าเราเลือก model ที่ใหญ่ที่สุดเสมอไป แต่ขึ้นกับว่าเราออกแบบ workflow, ข้อมูลตัวอย่าง และเกณฑ์ตรวจงาน ดีเพียงใด ธุรกิจที่มีขั้นตอนงานชัดเจนจึงได้เปรียบ เพราะสามารถถ่ายทอดวิธีทำงานให้ AI ทำตามได้ง่ายกว่า
หากร้านค้าออนไลน์ต้องการให้ AI จัดหมวดคำถามจากลูกค้า การสั่งว่า “ตอบแชตลูกค้าให้หน่อย” มักกว้างเกินไป แต่ถ้ากำหนดตัวอย่างคำถาม ระดับความเร่งด่วน คำตอบที่อนุมัติได้ และกรณีที่ต้องส่งต่อคน AI จะทำงานใกล้เคียงมาตรฐานของทีมมากขึ้น
Step 3: เปลี่ยนจาก chatbot เป็น AI worker สำหรับงานธุรกิจ
ความแตกต่างระหว่าง chatbot กับ AI worker อยู่ที่ “ความต่อเนื่องของงาน” chatbot ตอบคำถามเป็นรอบๆ ส่วน AI worker ควรรับเป้าหมาย แล้วดำเนินชุดงานจนได้ผลลัพธ์ที่ตรวจสอบได้ เช่น อ่านข้อมูล จัดลำดับลูกค้า สร้างเอกสาร บันทึกผล และแจ้งคนที่เกี่ยวข้อง
ตัวอย่างในคลิปคือการสั่งให้สร้างเครื่องมือต้อนรับสมาชิกใหม่ เครื่องมือนั้นต้องทักทาย แนะนำคู่มือเริ่มต้น และชี้ไปยังตัวอย่าง automation ที่เป็นประโยชน์ แทนที่จะให้คนเขียนทุกหน้าจอและทุกกฎด้วยตนเอง AI สามารถช่วยวางโครงสร้าง เขียนส่วนประกอบ ทดสอบ และแก้ข้อบกพร่องเป็นรอบๆ ได้
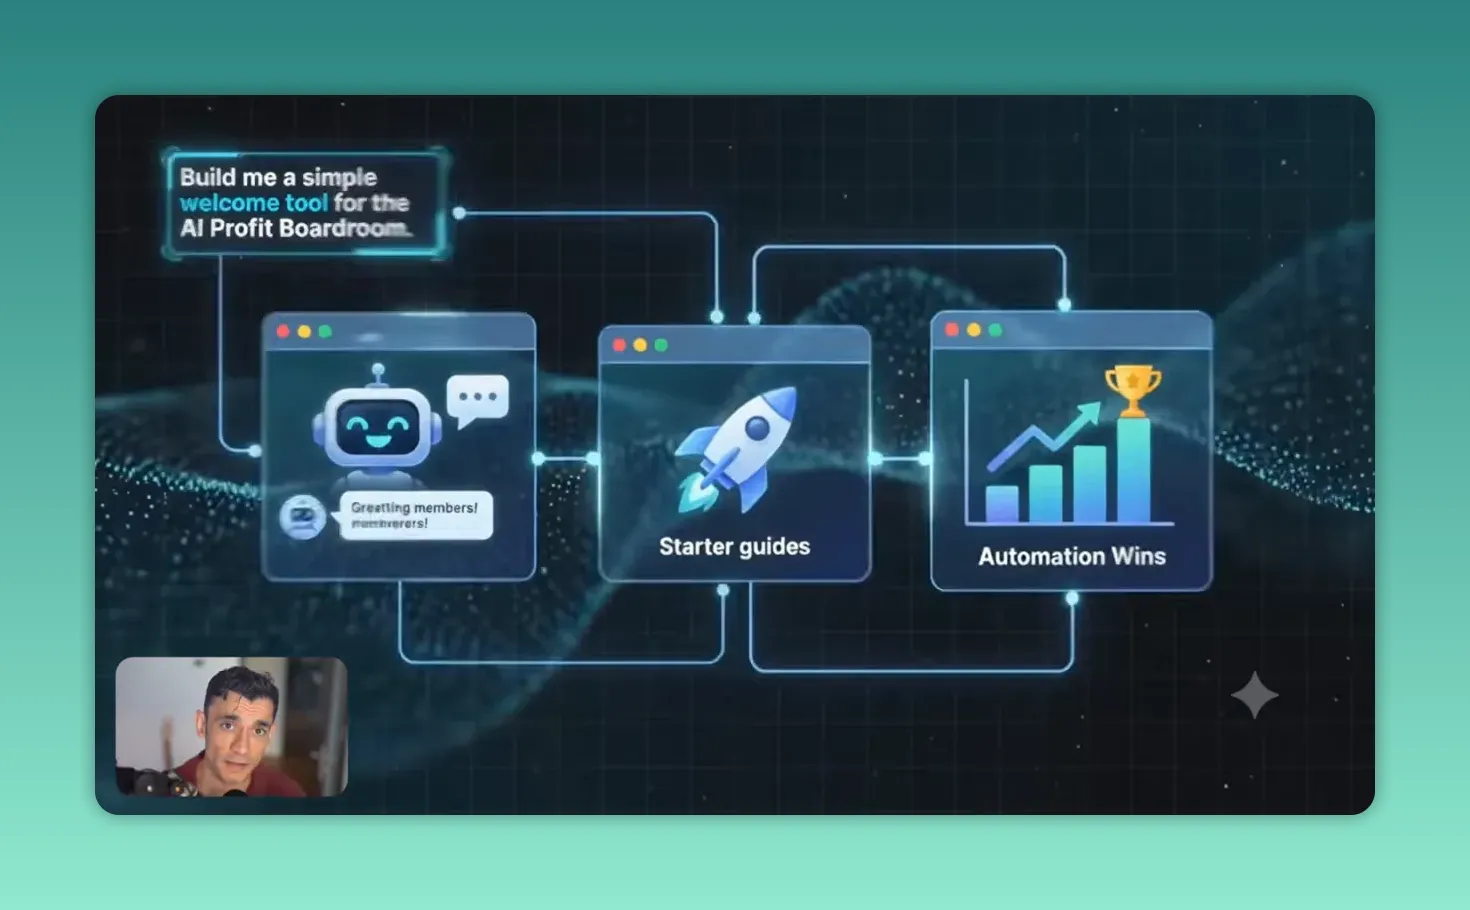
ถ้านำมาปรับใช้กับธุรกิจไทย งานที่เหมาะจะเริ่มก่อนมีลักษณะดังนี้
- ตอบคำถามที่พบบ่อยจาก LINE, Facebook หรือแบบฟอร์มติดต่อ โดยใช้คำตอบที่ผ่านการอนุมัติแล้ว
- คัดแยก lead ตามงบประมาณ ความต้องการ และความพร้อมซื้อ ก่อนส่งต่อให้ฝ่ายขาย
- สรุปคำสั่งซื้อ ปัญหาลูกค้า และประเด็นจากทีมขายเป็นรายวัน
- สร้างหน้า onboarding สำหรับสมาชิก คอร์สออนไลน์ หรือตัวแทนจำหน่ายรายใหม่
- ตรวจว่าข้อมูลในเอกสารหรือรายการสินค้ามีช่องว่าง ก่อนส่งให้ทีมรับผิดชอบแก้ไข
จุดที่ควรเห็นต่างกับภาพ “หนึ่ง prompt จบทุกอย่าง” คือ prompt เดียวอาจเหมาะกับการสร้างต้นแบบ แต่ระบบที่นำไปใช้จริงต้องมีสิทธิ์เข้าถึงข้อมูล การเชื่อมต่อเครื่องมือ เงื่อนไขอนุมัติ และทางออกเมื่อเกิดข้อผิดพลาด หากข้ามส่วนนี้ไป AI ที่ดูเก่งอาจกลายเป็นระบบที่สร้างงานแก้ให้ทีมมากกว่าเดิม
Step 4: เขียนโจทย์ให้ AI ทำงานเป็นขั้นตอนและตรวจผลได้
เมื่อ AI เริ่มทำงานหลายขั้นตอน คุณภาพของคำสั่งต้องเปลี่ยนจากการ “ขอคำตอบ” ไปเป็นการ “ระบุงาน” โจทย์ที่ดีไม่จำเป็นต้องเป็นภาษาเทคนิค แต่ควรชัดเรื่องเป้าหมาย ข้อมูลเข้า กฎตัดสินใจ ผลลัพธ์ที่ต้องการ และเงื่อนไขให้หยุดส่งต่อคน
โครงสร้างโจทย์สำหรับงานธุรกิจ
- เป้าหมาย: ต้องการลดงานใด หรือเพิ่มผลลัพธ์ใด
- ข้อมูลที่ใช้: ระบุแหล่งข้อมูลที่ AI อ้างอิงได้ และข้อมูลที่ห้ามเข้าถึง
- ขั้นตอน: บอกลำดับงาน เช่น รับข้อมูล คัดแยก ร่างคำตอบ บันทึกผล
- กติกา: กำหนดคำที่ห้ามใช้ วงเงินที่อนุมัติได้ หรือเงื่อนไขที่ต้องส่งต่อทีม
- เกณฑ์ตรวจ: บอกว่าอะไรคือผลลัพธ์ที่ถือว่าผ่าน เช่น ข้อมูลครบ ไม่มีการเดาราคา และมีรายการตรวจสอบท้ายงาน
ตัวอย่างโจทย์สำหรับธุรกิจบริการอาจเป็น: “จัดกลุ่ม lead ใหม่จากแบบฟอร์มตามความพร้อมซื้อเป็น สูง กลาง ต่ำ สรุปเหตุผลไม่เกินสามข้อ ร่างข้อความตอบกลับโดยไม่เสนอราคาเอง และส่งกรณีที่ถามเรื่องสัญญาหรือขอส่วนลดเกิน 10% ให้ผู้จัดการตรวจ”
คำสั่งแบบนี้สร้างรั้วให้ AI ไม่หลุดไปทำเรื่องที่ไม่ควรทำ และทำให้คนในทีมตรวจงานได้เร็วขึ้น โดยเฉพาะช่วงเริ่มต้นที่ยังต้องเก็บตัวอย่างความผิดพลาดเพื่อปรับ workflow
Step 5: วัดความคุ้มค่า ไม่ใช่หลงกับความสามารถของ model
อีกประเด็นจาก GLM 5.3 คือการทำงานแบบกระชับขึ้น ใช้คำอธิบายน้อยลงและไปถึงผลลัพธ์เร็วขึ้น สิ่งนี้มีความหมายเชิงธุรกิจ เพราะงาน agent ที่คิดและทำหลายรอบมีต้นทุนทั้ง token เวลา และความเสี่ยงจากการวนผิดทาง
อย่างไรก็ตาม “ตอบสั้น” ไม่เท่ากับ “ทำงานดี” สำหรับงานสำคัญ เราควรแยกสิ่งที่ต้องการเป็นสองส่วน ได้แก่ คำอธิบายสำหรับคน และหลักฐานการทำงานสำหรับตรวจสอบ ตัวอย่างเช่น AI อาจสรุปผลให้ทีมขายอ่านเพียงห้าบรรทัด แต่ต้องเก็บ log ว่าใช้ข้อมูลใด คัด lead ด้วยกฎอะไร และส่งรายการใดเข้าคิว
ให้เริ่มวัดจากตัวเลขที่จับต้องได้ก่อนใช้งานเต็มรูปแบบ:
- ชั่วโมงงานที่ทีมใช้ก่อนและหลังมี AI
- อัตราคำตอบผิด หรือรายการที่ต้องแก้
- เวลาตั้งแต่ lead เข้ามาจนมีการตอบกลับครั้งแรก
- จำนวน lead ที่ส่งถึงฝ่ายขายแล้วผ่านเกณฑ์จริง
- ต้นทุนต่อรายการงาน รวมค่าเครื่องมือและเวลาคนตรวจ
หาก AI ช่วยลดเวลางาน แต่เพิ่มความผิดพลาดในเรื่องสำคัญ เช่น ราคา นโยบายคืนสินค้า หรือข้อมูลส่วนบุคคล ระบบนั้นยังไม่พร้อมขยายผล ควรลดขอบเขตงานก่อน แล้วจึงเพิ่มอำนาจให้ AI ตามผลการทดสอบ
Step 6: ตรวจความพร้อมใช้งานและข้อจำกัดก่อนตัดสินใจ
GLM ถูกวางตำแหน่งเป็น open model แต่ในช่วงเวลาที่คลิปกล่าวถึง GLM 5.3 ยังไม่เปิดให้ดาวน์โหลดทันที เนื่องจากทีมต้องการตรวจสอบเพิ่มเติมก่อนเปิดใช้จริง ประเด็นนี้เตือนว่า ข่าวเปิดตัว AI กับความพร้อมใช้ในธุรกิจเป็นคนละเรื่องกัน
ก่อนลงทุนเวลาหรือเชื่อมข้อมูลธุรกิจกับ AI รุ่นใด ควรตรวจอย่างน้อยสี่เรื่อง: ช่องทางเข้าถึงที่เปิดให้ใช้จริง, เงื่อนไขข้อมูลและความเป็นส่วนตัว, ค่าใช้จ่ายตามปริมาณงาน, และวิธีถอยกลับสู่การทำงานโดยคนเมื่อระบบมีปัญหา
ธุรกิจที่ไม่ใช่ developer ไม่จำเป็นต้องดาวน์โหลด open model มารันเองตั้งแต่วันแรก ทางเลือกที่ปลอดภัยกว่าคือเริ่มจาก platform ที่ทีมใช้อยู่ แล้วออกแบบ workflow และมาตรฐานข้อมูลให้พร้อม เมื่อ model ที่เหมาะเปิดใช้จริง การย้ายเครื่องมือจะทำได้ง่ายกว่าการเริ่มคิดระบบทั้งหมดในวันนั้น
Step 7: Actionable Insights สำหรับเจ้าของธุรกิจและคนทำงาน
- เลือกงานหนึ่งงานก่อน: เริ่มจากงานที่เกิดซ้ำอย่างน้อยสัปดาห์ละหลายครั้ง และมีรูปแบบชัด เช่น คัดแยก lead หรือสรุปประชุม
- เก็บตัวอย่างงานดี 20 รายการ: รวบรวมคำตอบ เอกสาร หรือเคสที่ทีมทำได้ดี เพื่อใช้เป็นมาตรฐานให้ AI เรียนรู้รูปแบบงาน
- บังคับให้มีจุดส่งต่อคน: ตั้งเงื่อนไขชัดเจนสำหรับกรณีราคาพิเศษ ข้อร้องเรียน ข้อมูลอ่อนไหว และการตัดสินใจที่มีผลทางกฎหมาย
- ทดสอบด้วยข้อมูลเก่า: ให้ AI ทำกับเคสที่รู้คำตอบอยู่แล้วก่อน แล้วเทียบกับผลงานจริงของทีม
- รายงานผลทุกสัปดาห์: วัดเวลาที่ประหยัด จำนวนงานที่ผิด และผลต่อยอดขายหรือการบริการ ไม่ตัดสินจากความตื่นเต้นของ demo
Step 8: Troubleshooting แก้ปัญหาที่มักเกิดเมื่อเริ่มใช้ AI worker
- ปัญหา: AI ตอบได้ดีเป็นบางครั้ง แต่คุณภาพแกว่งมาก
สาเหตุ: คำสั่งกว้างเกินไป และไม่มีตัวอย่างผลลัพธ์ที่ต้องการ
วิธีแก้: ระบุรูปแบบคำตอบ เพิ่มตัวอย่าง 5 ถึง 10 เคส และกำหนด checklist ให้ AI ตรวจตัวเองก่อนส่งงาน - ปัญหา: AI จัดการลูกค้าผิดกลุ่ม หรือส่ง lead ที่ไม่พร้อมให้ฝ่ายขาย
สาเหตุ: นิยามคำว่า “พร้อมซื้อ” ยังเป็นความรู้ในหัวทีม ไม่ได้แปลงเป็นกติกา
วิธีแก้: เขียนเกณฑ์คะแนนจากงบ ความเร่งด่วน ประเภทความต้องการ และกำหนดคนตรวจผลในช่วงแรก - ปัญหา: ทีมไม่ไว้ใจผลลัพธ์และกลับไปทำงานเองทั้งหมด
สาเหตุ: ระบบไม่มีหลักฐานว่า AI ใช้ข้อมูลใดและตัดสินใจอย่างไร
วิธีแก้: ให้ AI ส่งสรุปเหตุผล แหล่งข้อมูล และสถานะความมั่นใจทุกครั้ง พร้อมเปิด log ให้ตรวจย้อนหลัง - ปัญหา: งานจบช้าและมีต้นทุนสูงเกินคาด
สาเหตุ: AI รับโจทย์ใหญ่เกินไปหรือวนซ้ำโดยไม่มีเงื่อนไขหยุด
วิธีแก้: แยกงานเป็นขั้นตอน จำกัดจำนวนรอบแก้ไข และส่งต่อคนทันทีเมื่อเกินเวลาหรือเกินจำนวนรอบที่กำหนด - ปัญหา: AI ให้ข้อมูลผิดแต่เขียนอย่างมั่นใจ
สาเหตุ: ไม่มีแหล่งอ้างอิงที่อนุมัติ หรือเปิดให้ AI เติมข้อมูลเอง
วิธีแก้: จำกัดข้อมูลที่ใช้ให้เป็นฐานความรู้ที่ตรวจแล้ว และกำหนดว่าเมื่อไม่พบข้อมูลต้องตอบว่าไม่พบ ไม่อนุญาตให้เดา
Step 9: การต่อยอดหลังจาก workflow แรกเริ่มนิ่ง
ต่อยอดเป็นระบบรับ lead ถึงนัดหมาย: หลังคัดแยก lead ได้แม่นพอ สามารถเชื่อมขั้นตอนตอบคำถามเบื้องต้น เตือนติดตาม และจัดคิวให้ทีมขาย โดยยังให้คนอนุมัติในจุดสำคัญ
ต่อยอดเป็นศูนย์ความรู้ภายใน: เปลี่ยนคู่มือกระจัดกระจายให้เป็นแหล่งข้อมูลที่ทีมค้นหาและสรุปขั้นตอนทำงานได้ ลดเวลาถามตอบเรื่องเดิมระหว่างแผนก
ต่อยอดเป็นระบบตรวจคุณภาพ: ใช้ AI ตรวจความครบถ้วนของใบเสนอราคา เนื้อหาแคมเปญ หรือข้อมูลสินค้า ก่อนงานไปถึงลูกค้า เป้าหมายไม่ใช่แทนคนอนุมัติ แต่ช่วยให้คนเห็นจุดผิดเร็วขึ้น
Step 10: สรุป Checklist ทั้งหมดก่อนใช้ GLM 5.3 และ AI worker
- ☐ เลือกงานซ้ำที่มีผลลัพธ์วัดได้เพียงหนึ่งงาน
- ☐ ระบุเป้าหมาย ข้อมูลเข้า ขั้นตอน กติกา และผลลัพธ์ที่ต้องการ
- ☐ รวบรวมตัวอย่างงานที่ทีมยอมรับเป็นมาตรฐาน
- ☐ กำหนดงานที่ AI ทำได้ และงานที่ต้องส่งต่อคน
- ☐ ทดสอบกับข้อมูลเก่าก่อนใช้กับลูกค้าจริง
- ☐ ตรวจความถูกต้อง ต้นทุน เวลา และจำนวนงานแก้
- ☐ เก็บ log และปรับคำสั่งจากข้อผิดพลาดที่เกิดซ้ำ
- ☐ ตรวจความพร้อมใช้งาน ความเป็นส่วนตัว และเงื่อนไขของ model ก่อนเชื่อมข้อมูลธุรกิจ
- ☐ ขยาย workflow เมื่อผลทดสอบผ่าน ไม่ใช่เพราะ benchmark ดูน่าตื่นเต้น
บทเรียนจาก GLM 5.3 คือการแข่งขันของ AI ไม่ได้วัดกันแค่ว่า model ใหญ่แค่ไหน แต่กำลังวัดกันที่ความสามารถในการทำงานยาว ตรวจตัวเอง และใช้ทรัพยากรอย่างคุ้มค่า สำหรับธุรกิจไทย ผู้ที่ได้ประโยชน์ก่อนอาจไม่ใช่ผู้ที่ใช้ AI รุ่นใหม่ที่สุด แต่คือผู้ที่รู้ชัดว่างานไหนควรให้ AI รับไปทำ และสร้างรั้วตรวจสอบที่คนในทีมเชื่อถือได้