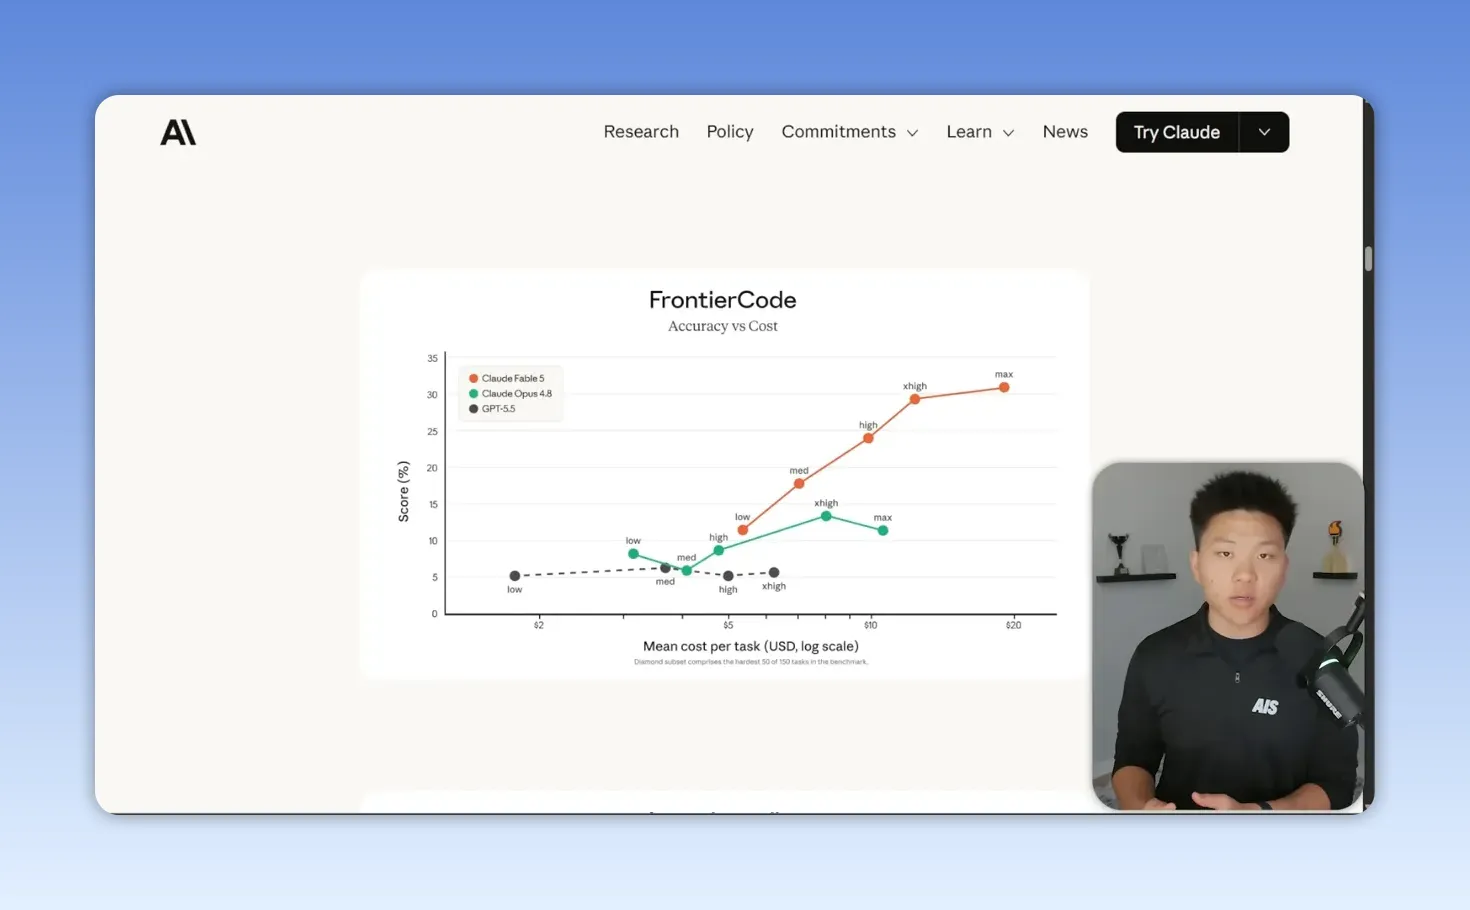
ที่มา: คลิป How I Make Opus Think Like Fable (5 easy steps) ของ Nate Herk | AI Automation และบทความ VideoToBlog วันที่ 2026-07-06 (วันที่บทความต้นทาง ไม่ใช่วันอัปโหลดวิดีโอที่ตรวจยืนยันแล้ว) Fable Mode เป็นแนวทางบันทึกขั้นตอนทำงานลง Skill ไม่ใช่การถ่ายทอดความสามารถของ model หรือการรับประกันคุณภาพเท่ากัน รุ่น ราคา กราฟเปรียบเทียบและผลประหยัดเป็นสิ่งที่ต้นทางรายงานในเวลานั้น ยังไม่ได้ทดสอบซ้ำ เอกสารที่อ้างว่าเป็น prompt หลุดยังไม่ได้ตรวจยืนยันความแท้ · วิดีโอต้นทาง
จุดที่หลายคนเข้าใจผิดเรื่อง AI คือคิดว่าแค่ได้ใช้ model ที่เก่งที่สุด ทุกอย่างจะดีเอง แต่คลิป How I Make Opus Think Like Fable (5 easy steps) จากช่อง Nate Herk | AI Automation ชี้ให้เห็นชัดว่า สิ่งที่สร้างความต่างจริงๆ ไม่ใช่ตัว model อย่างเดียว แต่คือวิธีสั่งงาน ระบบรอบข้าง และ workflow ที่เราสร้างขึ้นมา
มุมนี้สำคัญมากสำหรับเจ้าของธุรกิจและคนทำงานไทย เพราะงบ AI ไม่ได้ไม่มีที่สิ้นสุด ถ้าใช้ model แพงกับทุกงาน ต้นทุนจะบานเร็วมาก แนวทางในคลิปคือเก็บขั้นตอนทำงานเป็นกฎให้ model อื่นทำตาม ส่วนคุณภาพและต้นทุนที่ได้ต้องเปรียบเทียบกับงานจริง ไม่ควรสรุปว่าการใช้ Skill ทำให้ model ที่ถูกกว่ามีความสามารถเท่ารุ่นต้นแบบ บทความนี้สรุปและวิเคราะห์ 5 ขั้นที่เอาแนวคิดนั้นไปใช้จริงได้
สารบัญ
- Step 1: เริ่มจากความจริงก่อนว่า model ไม่ใช่ความได้เปรียบที่ยั่งยืน
- Step 2: ใช้ model เก่งเป็นครู ไม่ใช่ใช้เป็นแรงงานหลักทุกอย่าง
- Step 3: ถอดวิธีคิดของ model เก่งออกมาเป็นกฎการทำงาน
- Step 4: ปรับ effort level ให้เหมาะกับงาน แทนการเปิดสุดตลอด
- Step 5: สร้าง Fable Mode และทำ model routing ให้ถูกงาน
- Step 6: เปลี่ยนแนวคิดนี้ให้เป็น workflow ที่ใช้จริงในธุรกิจไทย
- Actionable Insights
- Troubleshooting
- การต่อยอด
- สรุป Checklist ทั้งหมด
Step 1: เริ่มจากความจริงก่อนว่า model ไม่ใช่ความได้เปรียบที่ยั่งยืน
แก่นของคลิปเริ่มจากประโยคที่คมมาก คือ model isn’t the moat หรือพูดแบบธุรกิจคือ ตัว model ไม่ใช่คูเมืองป้องกันธุรกิจของเรา
เหตุผลง่ายมาก ต่อให้คนเริ่มต้นได้ใช้ model ใหม่ที่ฉลาดกว่า แต่ถ้าอีกคนมีวิธีคิดเป็น รู้จักแตกงาน รู้จักตรวจคำตอบ และรู้จักสร้าง loop การทำงาน คนหลังมักได้ผลลัพธ์ดีกว่าอยู่ดี
นี่คือบทเรียนที่หลายทีมในไทยยังพลาดอยู่ เรามักถามว่า “ควรซื้อ model ไหน” มากกว่า “ควรออกแบบงานยังไง” ทั้งที่คำถามหลังส่งผลกับต้นทุนและคุณภาพมากกว่า
ถ้าเอาไปใช้กับธุรกิจไทย ภาพจะชัดมากในงานพวกนี้
- สรุปรายงานการประชุม
- ร่างโพสต์การตลาด
- วิเคราะห์รีวิวลูกค้า
- ทำ FAQ สำหรับทีมขาย
- สรุปคู่แข่งรายสัปดาห์
งานเหล่านี้ไม่จำเป็นต้องใช้ model แพงที่สุดทุกครั้ง สิ่งที่ควรลงทุนก่อนคือกรอบการทำงาน เช่น จะให้ AI ตรวจแหล่งข้อมูลไหม จะให้สรุปความไม่แน่ใจไหม จะให้เสนอทางเลือกกี่แบบ และจะให้ยืนยันผลก่อนส่งออกหรือไม่
Step 2: ใช้ model เก่งเป็นครู ไม่ใช่ใช้เป็นแรงงานหลักทุกอย่าง
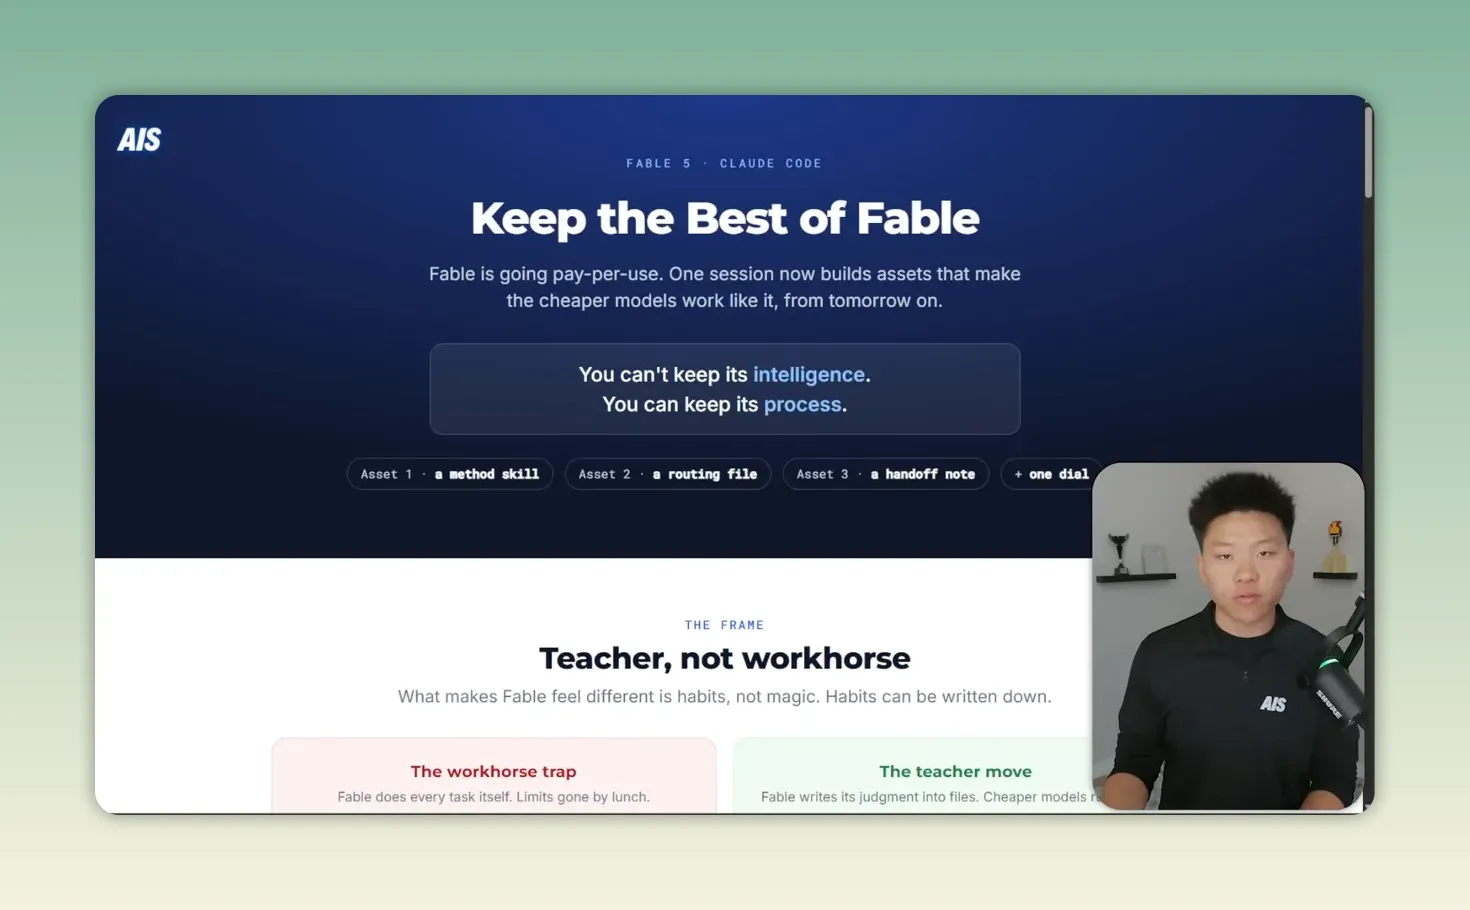
หนึ่งในมุมคิดที่น่าเอาไปใช้ต่อที่สุดคือการมอง Fable เป็น teacher, not workhorse หมายถึงไม่ต้องให้ model ตัวแพงลงมือทำทุกอย่างเอง แต่ให้มันช่วยออกแบบวิธีทำงานให้ model อื่น
วิธีนี้เหมือนเอาผู้บริหารหรือหัวหน้าทีมที่เก่งมาก มาวางมาตรฐานการคิด วางลำดับการทำงาน วางจุดตรวจ แล้วให้ทีมที่ต้นทุนต่ำกว่ารับช่วงต่อ
สำหรับธุรกิจ นี่เป็นแนวคิดที่คุ้มมาก เพราะช่วยแยกงานออกเป็น 2 ชั้น
- ชั้นคิด ใช้ model เก่งกว่าสำหรับวางแผน ตั้งเกณฑ์ และตัดสินใจกรณียาก
- ชั้นทำ ใช้ model ถูกกว่าสำหรับร่าง สรุป แยกข้อมูล จัดหมวด หรือทำงานซ้ำๆ
ตัวอย่างในธุรกิจไทย เช่น ร้านค้าออนไลน์ต้องทำหน้า product description จำนวนมาก แทนที่จะให้ model แพงเขียนทุกชิ้น เราอาจใช้ model เก่งหนึ่งครั้งเพื่อสร้าง rubric ว่าเนื้อหาที่ดีควรมีอะไรบ้าง เช่น จุดเด่นสินค้า โทนภาษา คำต้องห้าม วิธีเล่าประโยชน์ และเงื่อนไขการตรวจความจริง จากนั้นให้ model ถูกกว่าผลิตงานตาม rubric นั้น
ข้อดีคือคุณภาพสม่ำเสมอขึ้น และทีมไม่ต้องเริ่มสั่งงานใหม่ทุกครั้ง
Step 3: ถอดวิธีคิดของ model เก่งออกมาเป็นกฎการทำงาน
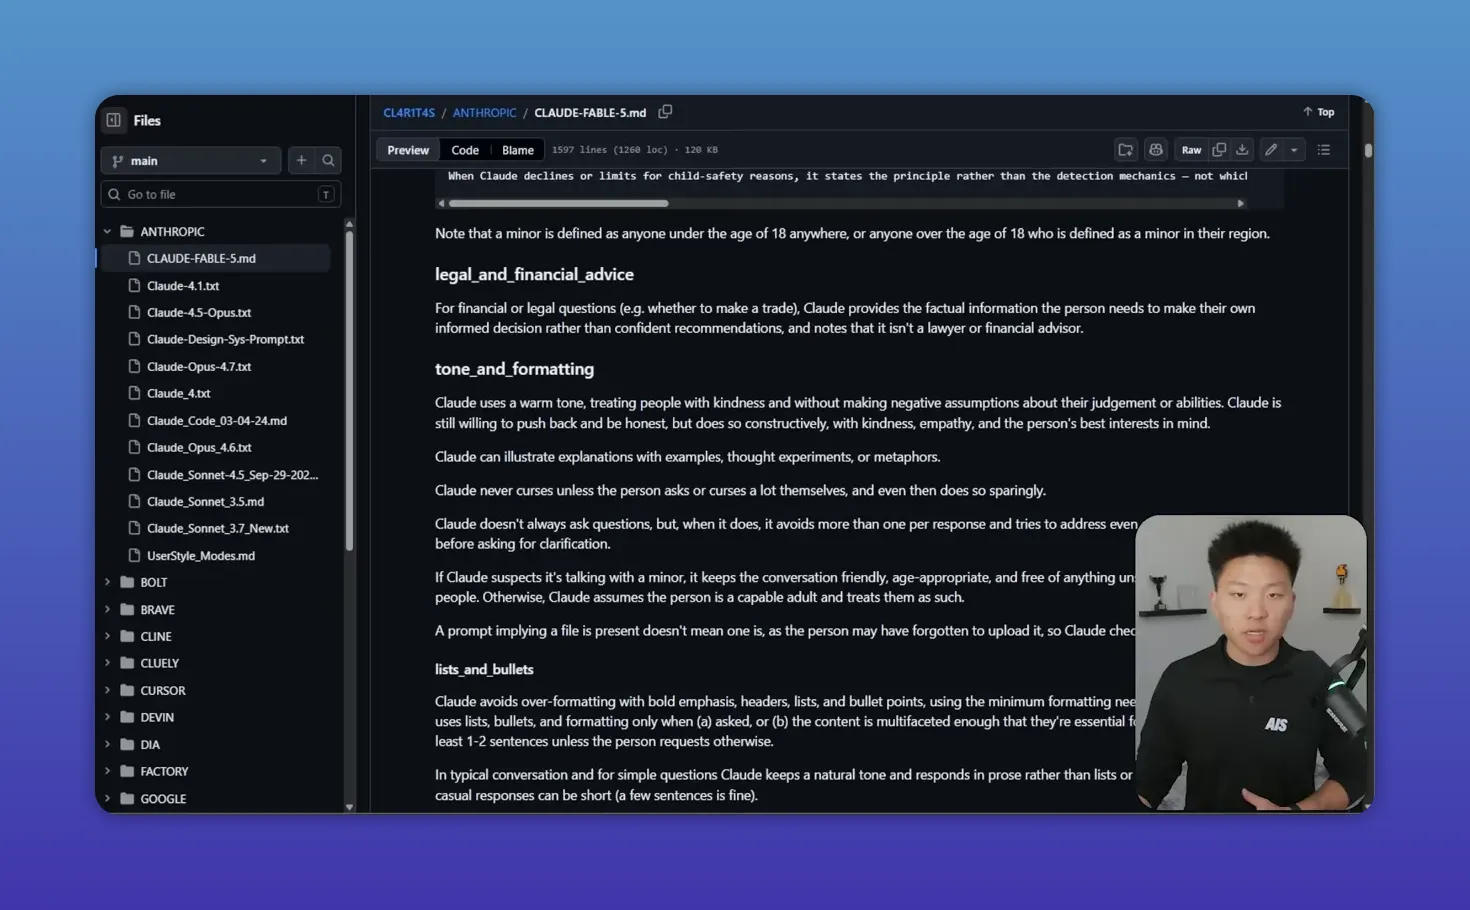
อีกจุดที่คลิปทำได้ดีคือการชี้ว่า model เก่งเองก็ทำงานตาม “กฎ” ชุดหนึ่ง ไม่ได้เสกคำตอบจากความฉลาดล้วนๆ ผู้สร้างคลิปเปิด repository ภายนอกที่อ้างว่าเก็บ system prompt แล้วนำข้อความมาสรุปเป็นแนวปฏิบัติ บทความนี้ยังไม่ได้ตรวจยืนยันว่าเอกสารนั้นเป็น prompt ของผู้พัฒนาจริง
หลักที่หยิบมาใช้ได้จริงมีหลายข้อ เช่น
- อย่าคิดว่าจำได้แล้วแปลว่าจริง ต้องตรวจสอบ
- ถ้ามีการอ้างว่ามีไฟล์หรือข้อมูลอยู่ ต้องเช็กก่อนว่ามีจริง
- แม้คำถามจะกำกวม ก็ควรช่วยตอบในส่วนที่ตอบได้ก่อน แล้วค่อยถามกลับเท่าที่จำเป็น
- ต้องยอมรับเมื่อมีอะไรผิดพลาด แล้วแก้ต่อ ไม่หลบปัญหา
- กำหนดระดับ effort ให้เหมาะกับงาน ไม่ใช่ทุ่มสุดทุกครั้ง
ถ้ามองในมุมองค์กรไทย กฎเหล่านี้แทบเท่ากับ SOP สำหรับ AI เลย ยิ่งใครให้ทีมใช้ ChatGPT, Claude หรือเครื่องมือคล้ายกันแบบกระจัดกระจาย ยิ่งควรเปลี่ยนจากการ “ใช้งานตามความรู้สึก” ไปเป็น “ใช้งานตามกติกากลาง”
มุมที่เราเห็นด้วยมากคือเรื่อง ตอบก่อน ถามทีหลังเท่าที่จำเป็น เพราะในการทำงานจริง คนส่วนใหญ่ไม่อยากได้ AI ที่เอาแต่ถามกลับ แต่ก็ไม่อยากได้ AI ที่มั่ว ทางกลางที่ดีคือช่วยเดินงานส่วนที่ชัดก่อน แล้วค่อยขอข้อมูลเพิ่มเฉพาะจุด
ถ้าจะต่อยอดเอง แนะนำให้เอาหลักคิดนี้ไปทำเป็นเอกสารสั้นๆ ชื่อประมาณ “วิธีที่ AI ของทีมเราต้องทำงาน” แล้วกำหนดไว้เลยว่า
- ห้ามเดาข้อมูลที่ตรวจได้
- ต้องบอกส่วนที่ไม่แน่ใจ
- ต้องแยกข้อเท็จจริงออกจากข้อเสนอแนะ
- ต้องเช็กไฟล์ เอกสาร หรือลิงก์ก่อนอ้างอิง
Step 4: ปรับ effort level ให้เหมาะกับงาน แทนการเปิดสุดตลอด
อีกประเด็นที่คนใช้ AI เชิงธุรกิจมองข้ามบ่อยคือ effort level หรือระดับความพยายามในการคิดของ model
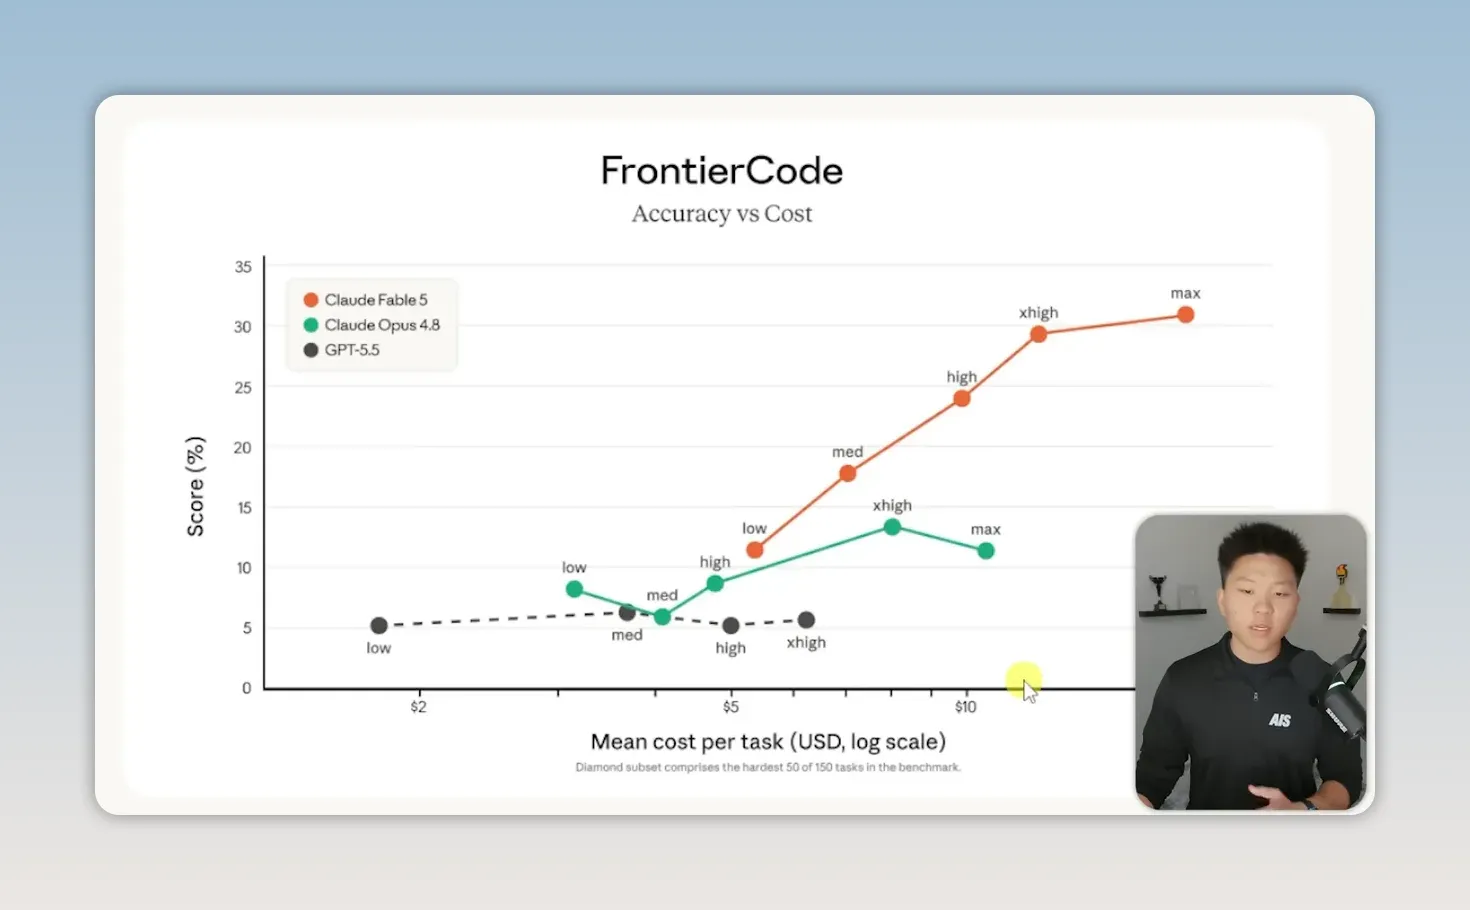
คลิปยกตัวอย่างว่า model แต่ละตัวไม่ได้มีแค่ความฉลาดต่างกัน แต่ยังมีโหมดการคิดที่ต่างกันด้วย บางครั้งการใช้โหมดสูงสุดไม่ได้ให้ผลดีที่สุดเสมอไป เพราะ model อาจคิดเยอะเกินไป ยืดยาวเกินไป และสุดท้ายคำตอบแย่ลง
นี่เป็น insight ที่ใช้จริงมาก โดยเฉพาะงานที่ต้องการความเร็ว เช่น
- สรุปอีเมล
- จัดหมวด leads
- ร่างข้อความตอบลูกค้า
- สรุปรายการประชุม
งานพวกนี้ไม่ต้องการ deep reasoning ระดับสูงสุด แต่ต้องการความเสถียรและเร็ว ถ้าเราเปิด effort สูงตลอด เราจะจ่ายแพงขึ้นโดยไม่คุ้ม
ฝั่งงานที่ควรใช้ effort สูงขึ้นจริงๆ มักเป็นงานแบบนี้
- เปรียบเทียบคู่แข่งหลายเจ้า
- ออกแบบแผนการตลาดหลายทางเลือก
- วิเคราะห์ปัญหาซับซ้อนในกระบวนการทำงาน
- ร่าง proposal ที่ต้องคิดเชิงกลยุทธ์
สิ่งที่เราชอบในคลิปคือไม่ได้พูดแบบสุดโต่งว่า model แพงไม่จำเป็น แต่พูดตรงๆ ว่า ต้องใช้ให้ถูกงาน ซึ่งเป็นมุมที่เจ้าของธุรกิจควรชอบที่สุด เพราะนี่คือเรื่อง unit economics ล้วนๆ
ถ้าอยากอ่านเรื่องการออกแบบระบบ AI แบบหลายชั้นเพิ่ม ลองดูแนวคิดเรื่อง routing และ orchestration จาก Anthropic และแนวทางการสร้าง prompt guideline ที่ OpenAI Prompt Engineering Guide
Step 5: สร้าง Fable Mode และทำ model routing ให้ถูกงาน
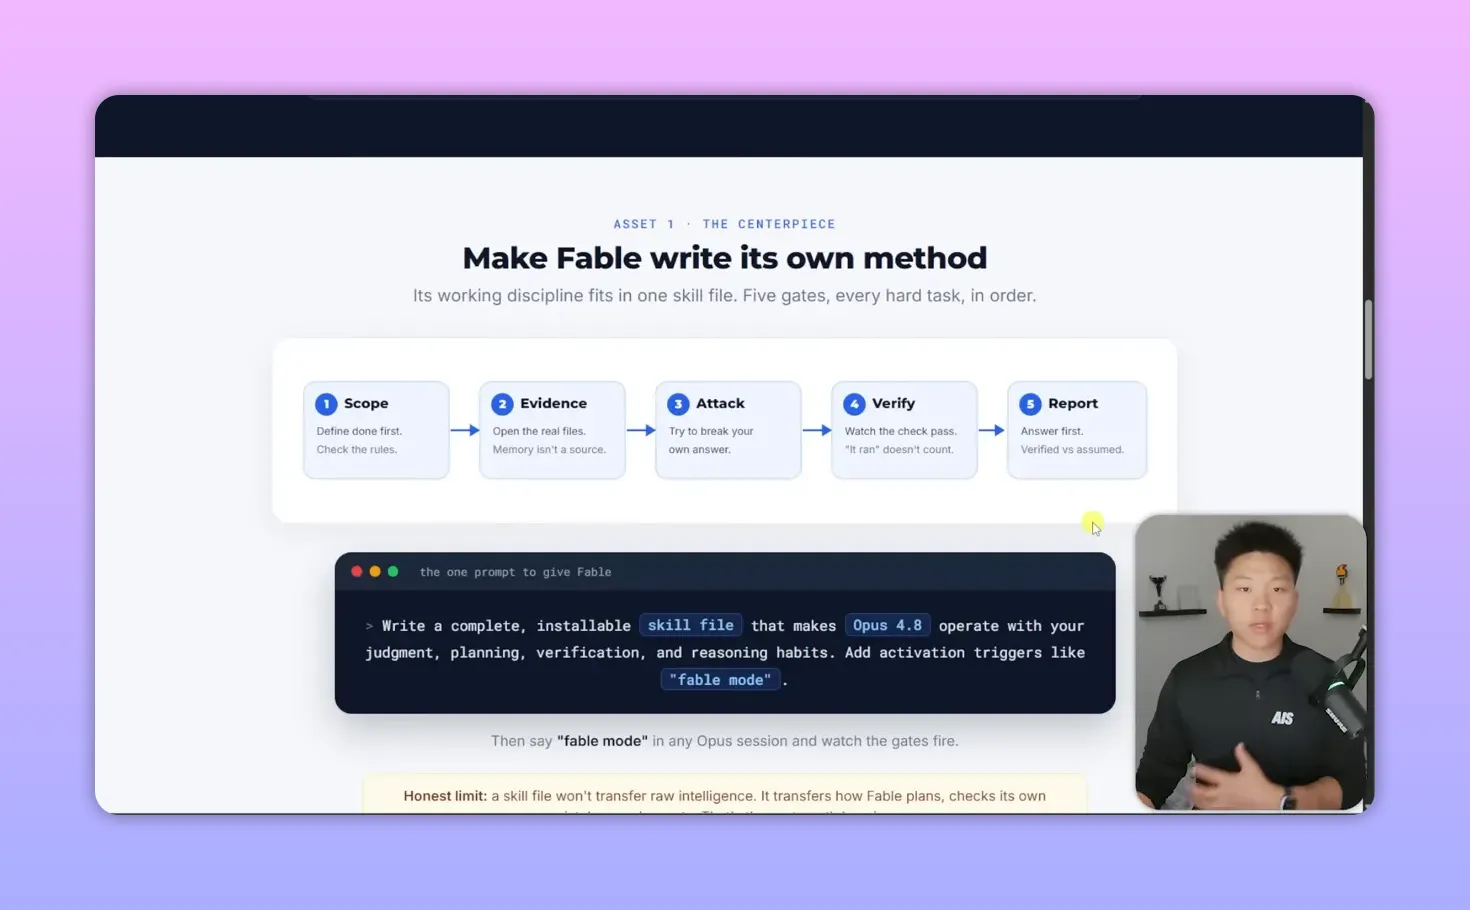
นี่คือหัวใจของคลิป ผู้สร้างคลิปเอาวิธีคิดของ Fable ไปแปลงเป็น skill ชื่อ Fable Mode เพื่อให้ Opus หรือ model อื่นทำงานตามวินัยเดียวกัน
framework นี้มี 5 gate หลัก
- Scoping กำหนดขอบเขตงานก่อนเริ่ม
- Evidence หาและยืนยันหลักฐานก่อนสรุป
- Attacking ท้าทายแผน คิดเผื่อสิ่งที่อาจผิดพลาด
- Verifying ตรวจคำตอบก่อนประกาศว่าจบ
- Reporting สรุปผลแบบพร้อมส่งต่องาน
จุดนี้สำคัญมาก เพราะคนส่วนใหญ่สั่ง AI แค่ว่า “ช่วยทำ X” แต่ไม่เคยบอกว่าต้องผ่านด่านคิดอะไรบ้างก่อนส่งคำตอบกลับมา พอไม่มีกระบวนการ งานจึงขึ้นอยู่กับดวงของ prompt
ถ้าเอา framework นี้มาใช้กับธุรกิจไทย จะปรับได้หลายแบบ เช่น
- Scoping ให้ AI ทวนเป้าหมายลูกค้า กลุ่มเป้าหมาย และข้อจำกัดก่อนเริ่ม
- Evidence ให้ดึงข้อมูลจากไฟล์ยอดขาย รีวิว หรือเอกสารที่แนบเท่านั้น
- Attacking ให้ชี้ 3 จุดที่ข้อเสนออาจใช้ไม่ได้จริง
- Verifying ให้ตรวจตัวเลข ชื่อสินค้า ราคา และลิงก์
- Reporting ให้สรุปผลเป็น bullet ที่ทีมอ่านต่อได้ทันที
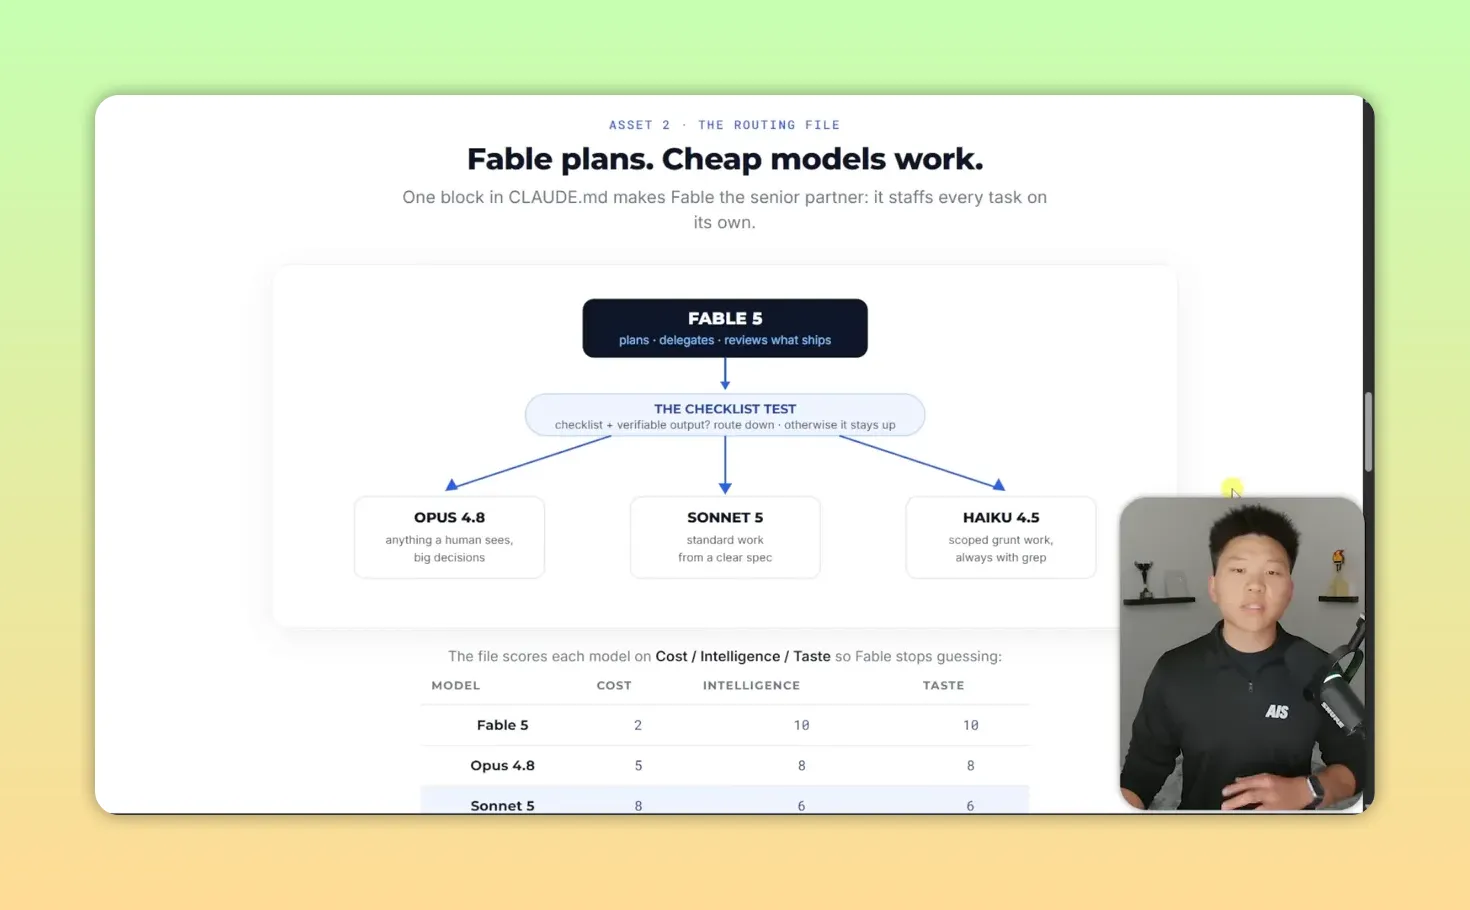
หลังจากมี Fable Mode แล้ว ขั้นต่อมาคือ model routing หรือการเลือกให้ model ที่เหมาะที่สุดรับงานแต่ละส่วน
คลิปเสนอให้เรามีตารางประเมิน model ใน toolkit ของตัวเองอย่างง่าย โดยดูอย่างน้อย 3 มิติ
- ต้นทุน
- ความฉลาด
- taste หรือความสามารถด้านความคิดสร้างสรรค์และรสนิยมงาน
มุมนี้น่าสนใจมาก เพราะคำว่า AI เก่ง ไม่ได้มีมิติเดียว บาง model อาจเหมาะกับการรีวิว บางตัวเหมาะกับงานสร้างสรรค์ บางตัวเหมาะกับงานสั้นๆ ปริมาณมาก
ตัวอย่าง routing ที่ธุรกิจใช้ได้จริง
- model A สำหรับวางแผนแคมเปญ
- model B สำหรับร่างข้อความหลายเวอร์ชัน
- model C สำหรับตรวจคำผิด สรุป และจัดรูปแบบ
- model D สำหรับเก็บงานสุดท้ายเมื่อมีความเสี่ยงสูง
ในคลิปมีตัวอย่างทดสอบที่ orchestrator ใช้ model หนึ่งควบคุม sub-agents หลายตัว และพบว่าการให้ worker ที่ถูกกว่าทำงานบางส่วน ให้ผลเท่ากันแต่ต้นทุนต่ำกว่าหลายเท่า ตรงนี้คือบทเรียนที่เจ้าของธุรกิจควรหยิบไปคิดต่อทันทีว่า งานไหนของเรากำลังใช้ model แพงเกินจำเป็น
Step 6: เปลี่ยนแนวคิดนี้ให้เป็น workflow ที่ใช้จริงในธุรกิจไทย
ถ้าจะสรุปให้จับต้องได้ที่สุด วิธีนำไปใช้ในทีมมีลำดับประมาณนี้
- เลือกงาน 1 งานที่ทำซ้ำทุกสัปดาห์ เช่น สรุปรีวิวลูกค้า หรือร่างคอนเทนต์ขาย
- ใช้ model ที่เก่งกว่าช่วยวิเคราะห์ว่า output ที่ดีต้องมีอะไรบ้าง
- เขียนกติกาเป็น skill หรือ prompt template กลาง
- แยกว่างานส่วนไหนต้องคิดหนัก และส่วนไหนเป็นงานทำซ้ำ
- ให้ model ถูกกว่ารับงานทำซ้ำ แล้วให้ model เก่งกว่าตรวจเฉพาะจุดสำคัญ
ข้อสังเกตของเรา คือหลายบริษัทไทยจะรีบ automate เร็วเกินไป ทั้งที่ยังไม่รู้เลยว่า output ที่ดีหน้าตาเป็นยังไง คลิปนี้เตือนแบบอ้อมๆ ว่า ก่อน scale เราต้อง “เก็บวิธีคิด” ให้ได้ก่อน
Actionable Insights
- เริ่มจากงานซ้ำๆ 1 งานก่อน แล้ววัดต้นทุนต่อชิ้นก่อนและหลังใช้ model routing
- ให้ model เก่งช่วยวิเคราะห์งานที่ดีที่สุดของทีม แล้วถอดเป็น checklist กลาง
- ตั้งกฎว่า AI ต้องแยกข้อเท็จจริง ข้อสันนิษฐาน และสิ่งที่ยังไม่แน่ใจทุกครั้ง
- ทดสอบ effort level 2 ถึง 3 ระดับกับงานเดิม อย่าใช้ค่า default แบบไม่เปรียบเทียบ
- ทำตาราง model toolkit ของทีม แยกว่าใครเหมาะกับงานคิด งานเขียน งานตรวจ และงานสรุป
Troubleshooting
ปัญหา: ได้คำตอบดีบ้างแย่บ้าง ทั้งที่ใช้ prompt เดิม
สาเหตุ: prompt บอกเป้าหมาย แต่ไม่ได้บอกกระบวนการคิดและจุดตรวจ
วิธีแก้: เพิ่ม gate แบบ scoping, evidence, verifying และบังคับให้สรุปสิ่งที่ตรวจแล้วทุกครั้ง
ปัญหา: ค่าใช้จ่าย AI สูงเร็วมาก
สาเหตุ: ใช้ model แพงกับทุกงาน รวมถึงงานง่ายๆ ที่ model ถูกกว่าทำได้
วิธีแก้: แยกงานเป็นชั้นคิดกับชั้นทำ แล้วทำ model routing table สำหรับทีม
ปัญหา: AI ตอบเหมือนมั่นใจ แต่ข้อมูลผิด
สาเหตุ: ไม่มีขั้นตอนยืนยันข้อมูลหรือเช็กไฟล์ก่อนอ้างอิง
วิธีแก้: ตั้งกฎให้ AI ตรวจแหล่งข้อมูลก่อนสรุป และระบุจุดที่ยังยืนยันไม่ได้
ปัญหา: ใช้ effort สูงสุดแล้วงานกลับยืดและไม่คม
สาเหตุ: model overthink งานง่ายเกินความจำเป็น
วิธีแก้: ทดลอง low, medium, high กับงานเดียวกัน แล้วเทียบทั้งคุณภาพ เวลา และต้นทุน
ปัญหา: ทีมใช้ AI คนละแบบ ผลงานไม่สม่ำเสมอ
สาเหตุ: ไม่มีมาตรฐานกลางในการสั่งงาน
วิธีแก้: ทำ prompt template หรือ skill กลางของบริษัท และปรับจากงานจริงทุกสัปดาห์
การต่อยอด
- สร้าง AI playbook ของทีม แยกตามแผนก เช่น การตลาด ขาย บริการลูกค้า และ back office
- ทำระบบ review 2 ชั้น โดยให้ model ถูกกว่าร่างก่อน แล้วให้ model เก่งตรวจเฉพาะชิ้นที่เสี่ยง
- เริ่มเก็บคลังตัวอย่าง output ที่ดีที่สุด เพื่อใช้ฝึก prompt และ workflow รุ่นถัดไป
สรุป Checklist ทั้งหมด
- ☐ ยอมรับก่อนว่า model อย่างเดียวไม่ใช่ข้อได้เปรียบ
- ☐ เลือกงานซ้ำๆ ที่ต้องการเอา AI ไปช่วย 1 งาน
- ☐ ใช้ model เก่งวิเคราะห์ว่า output ที่ดีต้องมีอะไรบ้าง
- ☐ ถอดวิธีคิดนั้นออกมาเป็นกฎหรือ skill กลาง
- ☐ ใส่ 5 gate ได้แก่ scoping, evidence, attacking, verifying, reporting
- ☐ ทดลอง effort level หลายระดับกับงานเดียวกัน
- ☐ ทำตาราง model routing แยกตามต้นทุน ความฉลาด และ taste
- ☐ ให้ model แพงทำหน้าที่คิด วางแผน และตรวจงานยาก
- ☐ ให้ model ถูกกว่ารับงานทำซ้ำและงานปริมาณมาก
- ☐ วัดผลจากต้นทุน เวลา และคุณภาพ ไม่ใช่ดูแค่ความรู้สึก
สรุปสุดท้ายของคลิปนี้ชัดมาก สิ่งที่เราไม่ได้เป็นเจ้าของคือ model แต่สิ่งที่เราเป็นเจ้าของได้คือ process, system, methodology ถ้าทีมไหนเก็บสามอย่างนี้ได้ ต่อให้ platform เปลี่ยน model เปลี่ยน หรือราคาเปลี่ยน ทีมก็ยังเดินต่อได้
สำหรับเจ้าของธุรกิจและคนทำงาน นี่น่าจะเป็นมุมที่สำคัญกว่าการไล่ตาม model ตัวใหม่ทุกสัปดาห์ เพราะสุดท้ายคนที่ชนะไม่ใช่คนที่ใช้ model แพงที่สุด แต่คือคนที่ออกแบบงานให้ AI ทำได้คุ้มที่สุด