หมายเหตุ: บทความนี้สรุปวิดีโอของ Nate Herk | AI Automation ที่ฝังไว้ในบทความ โดยรายการใน VideoToBlog ลงวันที่ 1 กันยายน 2026; ราคา คุณสมบัติ และผลทดลองเป็นข้อมูลที่แหล่งต้นทางรายงานในขณะนั้น · วิดีโอต้นทาง
การแข่งขันของ AI ไม่ได้วัดกันที่คำว่า “ฉลาดกว่า” เพียงอย่างเดียวอีกต่อไป แต่กำลังวัดกันที่ว่าโมเดลทำงานเดิมได้ดีขึ้นด้วย token น้อยลง ใช้เงินน้อยลง และนำไปอยู่ใน workflow จริงขององค์กรได้หรือไม่
คลิปจาก Nate Herk | AI Automation สรุปการเปิดตัว Claude Fable 5.1 และ Mythos 5.1 พร้อมทดลองสร้างชิ้นงาน 3D จาก prompt เดียวกันเพื่อเทียบกับ Fable 5 รุ่นก่อน ประเด็นที่น่าสนใจที่สุดสำหรับเจ้าของธุรกิจไทยไม่ใช่โมเดลวาดหมีปั่นจักรยานได้สวยแค่ไหน แต่คือการลดต้นทุนต่อชิ้นงาน การจัดการข้อมูล และวิธีทดสอบให้รู้ว่า AI รุ่นใหม่คุ้มกับงานของเราจริงหรือไม่
บทความนี้แปลงสิ่งที่เกิดขึ้นในการเปิดตัวให้เป็นแนวทางตัดสินใจสำหรับทีมธุรกิจ การตลาด เอเจนซี และคนทำงานความรู้ที่ต้องการใช้ AI ให้เกิดผลลัพธ์ที่วัดได้
สารบัญ
- Step 1: แยกให้ออกว่า Fable 5.1 เปลี่ยนอะไรจากรุ่นเดิม
- Step 2: อ่าน benchmark เป็นสัญญาณ ไม่ใช่คำตัดสิน
- Step 3: ให้ความสำคัญกับต้นทุนรวมของงาน ไม่ใช่ราคา token
- Step 4: ตรวจเรื่องข้อมูลและสิทธิ์เข้าถึงก่อนนำไปใช้
- Step 5: ทำ pilot แบบเล็กก่อนตัดสินใจย้าย workflow
- Step 6: เปลี่ยนข้อค้นพบเป็น Actionable Insights
- Step 7: Troubleshooting เมื่อผลทดสอบ AI ไม่เป็นอย่างที่คิด
- Step 8: ต่อยอดจากการเทียบโมเดลครั้งแรก
- Step 9: สรุป Checklist ทั้งหมดก่อนใช้ Claude Fable 5.1
Step 1: แยกให้ออกว่า Fable 5.1 เปลี่ยนอะไรจากรุ่นเดิม
Claude Fable 5.1 ถูกวางตำแหน่งเป็นโมเดลสำหรับงานเขียนโค้ดและงานความรู้ที่ซับซ้อน โดยยังคงราคา API พื้นฐานที่ 10 ดอลลาร์ต่อหนึ่งล้าน input tokens และ 50 ดอลลาร์ต่อหนึ่งล้าน output tokens เท่าเดิม จุดขายจึงไม่ใช่การลดราคาป้าย แต่เป็นการใช้ token โดยรวมน้อยลงในการทำงาน
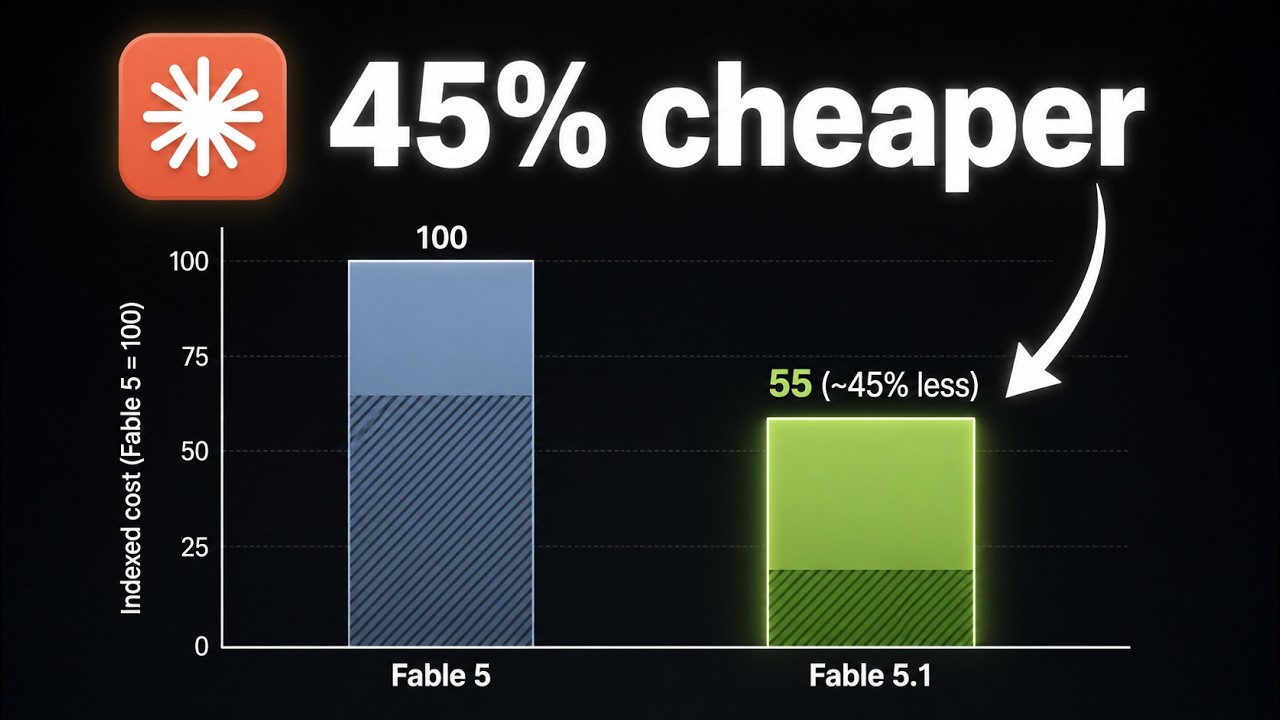
ผู้พัฒนาระบุว่าค่าใช้จ่ายในงานทั่วไปอาจลดลงราว 25% และงานแบบ agentic ที่ AI ต้องทำหลายขั้นตอนต่อเนื่องอาจลดได้มากกว่านั้นถึงประมาณ 45% ส่วนหนึ่งมาจากการลดราคาของ cache reads หรือการอ่านข้อมูล input ที่ระบบประมวลผลและเก็บไว้แล้ว
ความหมายสำหรับธุรกิจคือ หาก workflow เดิมต้องส่งคู่มือสินค้า รายละเอียดแบรนด์ กฎการตอบแชต หรือเอกสารนโยบายเดิมเข้า AI ซ้ำๆ การใช้ cache อาจลดต้นทุนได้มากกว่างานถามตอบครั้งเดียว แต่ถ้าเราใช้ AI สรุปอีเมลสั้นๆ แบบครั้งต่อครั้ง ผลต่างด้านต้นทุนอาจไม่ได้เด่นชัดนัก
จุดที่ควรจำคือ การอ้างว่าถูกลงไม่เท่ากับใบเสร็จของธุรกิจเรา ค่าใช้จ่ายจริงขึ้นกับความยาว prompt, จำนวนรอบแก้ไข, การให้ AI เรียกเครื่องมือ และคุณภาพของคำตอบครั้งแรก หากคำตอบดีขึ้นจนทีมแก้น้อยลง นั่นต่างหากคือการลดต้นทุนที่ธุรกิจควรสนใจ
Step 2: อ่าน benchmark เป็นสัญญาณ ไม่ใช่คำตัดสิน
ผล benchmark ในการเปิดตัวแสดงภาพว่า Fable 5.1 ทำคะแนนเหนือ Fable 5 ในงานใช้เหตุผลหลายสาขา งานเขียนโค้ดแบบ agentic และงานผ่าน terminal อีกทั้งระดับ effort ที่ต่ำของรุ่นใหม่ยังถูกนำไปเปรียบเทียบว่าทำผลงานได้เหนือกว่าการตั้ง effort สูงของรุ่นเดิมในบางกราฟ
ภาพนี้มีนัยสำคัญ เพราะองค์กรไม่ได้เลือก AI จากความเก่งสูงสุดเสมอไป หากงานที่ต้องทำ 500 ครั้งต่อเดือนใช้ระดับ effort ต่ำแล้วได้คุณภาพผ่านเกณฑ์ ต้นทุนและเวลารวมอาจดีกว่าการเปิดโหมดหนักทุกครั้ง
แต่ benchmark มีข้อจำกัดชัดเจน ผลทดสอบมักเป็นโจทย์ที่ออกแบบมาเฉพาะ มีเกณฑ์ตรวจคำตอบชัด และอาจไม่สะท้อนภาษาไทย ข้อมูลภายในองค์กร น้ำเสียงแบรนด์ หรือข้อยกเว้นจำนวนมากในงานจริง เราจึงไม่ควรเลือกโมเดลเพราะกราฟเดียว โดยเฉพาะเมื่องานนั้นเกี่ยวข้องกับราคา สัญญา การเงิน หรือการสื่อสารกับลูกค้า
สำหรับธุรกิจไทย วิธีอ่าน benchmark ที่ถูกต้องคือใช้เป็นเหตุผลให้เริ่มทดลอง ไม่ใช่เป็นเหตุผลให้ย้ายระบบทั้งหมดทันที ควรสร้างชุดทดสอบจากงานจริงของทีม เช่น 20 แชตที่ซับซ้อน 10 บรีฟคอนเทนต์ 10 เคสสรุปรายงาน หรือ 5 หน้าเว็บไซต์ที่ต้องการให้ AI ช่วยร่าง แล้วเปรียบเทียบผลด้วยเกณฑ์เดียวกัน
Step 3: ให้ความสำคัญกับต้นทุนรวมของงาน ไม่ใช่ราคา token
การทดลองในคลิปใช้ prompt เดียวกันคือให้สร้างหมีการ์ตูน 3D ขี่จักรยานแบบหมุนได้ Fable 5 สร้างชิ้นงานที่ดูสีสันสดกว่า ส่วน Fable 5.1 สร้างผลลัพธ์ที่ดูมีมิติขึ้น เงาและลักษณะทางกายภาพดูสมจริงกว่า อีกทั้งตั้งชื่อหมีว่า Barnaby และสร้างเป็น live artifact ที่โต้ตอบได้
ผลนี้ยังไม่ใช่การทดสอบเชิงวิทยาศาสตร์ เพราะ prompt เปิดกว้างมากและเป็นเพียงตัวอย่างเดียว แต่ผลต้นทุนให้ข้อมูลที่จับต้องได้ Fable 5.1 ใช้เวลาประมาณ 6 นาที 34 วินาที มีค่าใช้จ่าย 4.53 ดอลลาร์ ส่วน Fable 5 มีค่าใช้จ่าย 5.41 ดอลลาร์และเสร็จเร็วกว่าเล็กน้อย
ดังนั้นรุ่นใหม่ถูกกว่าราว 0.88 ดอลลาร์ในโจทย์นี้ แต่ช้ากว่าเล็กน้อย นี่คือบทเรียนสำคัญมาก เพราะคำว่า “ดีกว่า” มีอย่างน้อยสี่มิติ ได้แก่ คุณภาพ ความเร็ว ต้นทุน และจำนวนครั้งที่คนต้องกลับมาแก้
หากเอามาใช้กับธุรกิจไทย ลองนึกถึงเอเจนซีที่สร้าง landing page ให้ลูกค้า 30 งานต่อเดือน สมมติรุ่นใหม่ช่วยลดค่า AI ต่อชิ้นงานได้ และทำให้ดีไซน์รอบแรกใกล้เคียงบรีฟกว่า ต้นทุนจริงที่ลดลงอาจไม่ได้มีแค่ค่า API แต่รวมถึงเวลาของนักออกแบบและคนประสานงานด้วย แต่ถ้างานต้องส่งด่วนภายในไม่กี่นาที ความเร็วอาจสำคัญกว่าค่าใช้จ่ายที่ลดลงเล็กน้อย
ก่อนขยายการใช้งาน ควรบันทึกผลอย่างน้อย 4 ช่องต่อเคส ได้แก่ ค่าใช้จ่าย เวลา คุณภาพตามเกณฑ์ และเวลาที่คนใช้แก้ไข วิธีนี้ทำให้การตัดสินใจเรื่อง AI เปลี่ยนจากความรู้สึกเป็นข้อมูล
Step 4: ตรวจเรื่องข้อมูลและสิทธิ์เข้าถึงก่อนนำไปใช้
การเปิดตัวครั้งนี้มีประเด็นด้านองค์กรอยู่สองเรื่อง เรื่องแรกคือระบบ EFS ที่เปิดทางให้ลูกค้าองค์กรเลือกใช้แนวทางไม่เก็บข้อมูลไว้ตามนโยบายที่ระบุไว้ เรื่องที่สองคือการปรับ safeguards เพื่อลด false positives หรือกรณีที่ระบบปฏิเสธคำขอที่จริงๆ แล้วควรทำได้
สำหรับธุรกิจ เรื่องนี้สำคัญกว่าความสามารถสร้างภาพ 3D มาก ทีมขาย ฝ่ายบุคคล บัญชี และฝ่ายบริการลูกค้ามักต้องทำงานกับข้อมูลที่ไม่ควรส่งออกไปอย่างไร้ขอบเขต ต่อให้เครื่องมือประกาศเรื่องการไม่เก็บข้อมูล เราก็ยังต้องตรวจเงื่อนไขแพ็กเกจ การตั้งค่าที่เปิดใช้จริง สิทธิ์ของผู้ใช้ และนโยบายภายในบริษัทก่อนเสมอ
แนวทางพื้นฐานคือแบ่งข้อมูลเป็นสามระดับ
- ข้อมูลสาธารณะ: รายละเอียดสินค้า บทความ และคำถามทั่วไป สามารถเริ่มทดลองได้ง่าย
- ข้อมูลภายใน: รายงานยอดขาย แผนการตลาด หรือคู่มือปฏิบัติงาน ควรจำกัดสิทธิ์และระบุผู้รับผิดชอบ
- ข้อมูลอ่อนไหว: ข้อมูลลูกค้า ข้อมูลการเงิน สัญญา และข้อมูลบุคลากร ควรผ่านการอนุมัติจากผู้ดูแลข้อมูลก่อนส่งเข้า AI
ส่วน Mythos 5.1 มีความสามารถแกนเดียวกับ Fable 5.1 แต่ใช้ safeguards ที่ผ่อนปรนกว่า สำหรับบุคคลและองค์กรที่ผ่านการตรวจสอบในโปรแกรมด้าน cybersecurity และ life sciences เท่านั้น จึงไม่ใช่โมเดลที่ธุรกิจทั่วไปจะเปิดใช้แทน Fable ได้ทันที และไม่ควรมองว่า “ข้อจำกัดน้อยกว่า” แปลว่าเหมาะกับทุกงาน
Step 5: ทำ pilot แบบเล็กก่อนตัดสินใจย้าย workflow
Fable 5.1 เปิดให้ใช้ผ่าน Claude API รวมถึงช่องทางบน Amazon Web Services, Google Cloud และ Microsoft Azure ขณะเดียวกันก็ใช้ผ่านแอปเดสก์ท็อปและ terminal ได้ ความพร้อมใช้งานหลายช่องทางทำให้ทีมเลือกตามระบบที่มีอยู่ แต่สำหรับคนทำธุรกิจ จุดเริ่มต้นไม่จำเป็นต้องเป็นการเชื่อม API
ทางเลือกที่เหมาะกว่าคือเลือกงานซ้ำๆ หนึ่งงานที่มีเจ้าของชัด ผลลัพธ์วัดได้ และความเสี่ยงต่ำ ตัวอย่างเช่น ร่างคำตอบลูกค้าจากฐานคำถามที่อนุมัติแล้ว สรุปรายงานประชุมให้อยู่ในรูปแบบมาตรฐาน หรือแปลงบรีฟสินค้าสู่โครงร่างแคมเปญ
จากนั้นให้ Fable 5 และ Fable 5.1 ทำงานจาก prompt และข้อมูลชุดเดียวกัน ทีมควรปิดชื่อโมเดลระหว่างให้คะแนนถ้าทำได้ เพื่อลดอคติ แล้วตรวจว่าเวอร์ชันใดได้ผลดีกว่าในมาตรฐานที่เราตกลงกัน ไม่ใช่ในมาตรฐานของผู้ผลิตโมเดล
เกณฑ์ pilot ที่ใช้งานได้จริง
- คำตอบถูกต้องและครบตามข้อมูลต้นทางหรือไม่
- ภาษาและโทนเสียงนำไปใช้ต่อได้มากน้อยแค่ไหน
- ทีมต้องแก้ไขกี่รอบก่อนอนุมัติ
- งานหนึ่งชิ้นใช้เวลาและงบประมาณเท่าไร
- มีข้อมูลใดที่ไม่ควรอยู่ใน workflow นี้หรือไม่
Step 6: เปลี่ยนข้อค้นพบเป็น Actionable Insights
- เลือกงานที่มีการใช้ข้อมูลเดิมซ้ำ: งานตอบคำถามจากคู่มือสินค้า หรือ workflow ที่ป้อนเอกสารเดิมบ่อยครั้ง มีโอกาสเห็นประโยชน์จาก cache มากกว่างาน prompt สั้นแบบครั้งเดียว
- วัดต้นทุนต่อผลลัพธ์: เก็บค่า API พร้อมเวลาคนแก้ไขเสมอ เพราะงานที่ AI ตอบดีตั้งแต่รอบแรกอาจคุ้มกว่าแม้ใช้เวลาประมวลผลนานขึ้น
- กำหนดเกณฑ์ผ่านก่อนเริ่ม: ระบุว่าคำตอบต้องถูกต้องกี่เปอร์เซ็นต์ ใช้เวลาตรวจไม่เกินเท่าไร และเคสใดต้องส่งต่อให้คนอนุมัติ
- เริ่มจากข้อมูลความเสี่ยงต่ำ: ทดสอบกับข้อความสาธารณะหรือข้อมูลจำลองก่อน แล้วค่อยเพิ่มข้อมูลภายในเมื่อระบบสิทธิ์และนโยบายพร้อม
- อย่าตั้ง effort สูงเป็นค่าเริ่มต้น: ทดลองระดับต่ำและสูงกับงานจริง เพื่อหาระดับที่คุณภาพผ่านเกณฑ์โดยไม่ใช้ token เกินจำเป็น
Step 7: Troubleshooting เมื่อผลทดสอบ AI ไม่เป็นอย่างที่คิด
- ปัญหา: ค่าใช้จ่ายจริงไม่ลดลงแม้เปลี่ยนเป็น Fable 5.1
สาเหตุ: prompt ยาวขึ้น มีการถามแก้หลายรอบ หรือไม่ได้ใช้ข้อมูลเดิมซ้ำมากพอ
วิธีแก้: แยกบันทึก input, output, จำนวนรอบแก้ และค่าใช้จ่ายต่อเคส แล้วตัดข้อความซ้ำใน prompt ก่อนประเมินใหม่ - ปัญหา: ผล benchmark ดูดี แต่ผลงานภาษาไทยยังต้องแก้เยอะ
สาเหตุ: ชุด benchmark ไม่ตรงกับน้ำเสียง คำเฉพาะ หรือรูปแบบเอกสารของทีม
วิธีแก้: สร้างชุดทดสอบจากงานไทยจริง 10 ถึง 20 เคส พร้อมตัวอย่างคำตอบที่ทีมยอมรับเป็นมาตรฐาน - ปัญหา: ทีมรู้สึกว่า AI ช้ากว่ารุ่นเก่า
สาเหตุ: โมเดลอาจใช้เวลามากขึ้นเพื่อสร้างผลลัพธ์ที่ละเอียดกว่า หรือ workflow มีหลายขั้นเกินจำเป็น
วิธีแก้: แยกงานด่วนออกจากงานที่ต้องการคุณภาพสูง และเลือกโมเดลหรือระดับ effort ให้ตรงกับเวลาส่งงาน - ปัญหา: ทีมกังวลว่าจะเผลอส่งข้อมูลสำคัญเข้า AI
สาเหตุ: ยังไม่มีรายการข้อมูลต้องห้ามและไม่มีขั้นตอนอนุมัติ
วิธีแก้: ทำคู่มือหนึ่งหน้าระบุข้อมูลที่ส่งได้ ส่งได้เมื่ออนุมัติ และห้ามส่ง พร้อมกำหนดผู้ดูแล workflow - ปัญหา: ผลลัพธ์สร้างสรรค์ดูน่าประทับใจ แต่ใช้กับงานจริงไม่ได้ทันที
สาเหตุ: prompt เปิดกว้างเกินไปและไม่มีข้อกำหนดเรื่องแบรนด์ รูปแบบ หรือเกณฑ์รับงาน
วิธีแก้: เพิ่มเป้าหมาย กลุ่มลูกค้า น้ำเสียง ข้อห้าม รูปแบบผลลัพธ์ และตัวอย่างงานที่ต้องการลงใน prompt
Step 8: ต่อยอดจากการเทียบโมเดลครั้งแรก
เมื่อ pilot ให้ผลชัดแล้ว ธุรกิจสามารถต่อยอดได้สามทาง ทางแรกคือสร้าง prompt library ที่ทีมใช้ร่วมกัน แยกตามงานขาย การตลาด และบริการลูกค้า เพื่อไม่ให้ทุกคนเริ่มจากหน้ากระดาษเปล่า
ทางที่สองคือออกแบบ workflow ที่มีคนตรวจเฉพาะจุดเสี่ยง เช่น ให้ AI ร่างคำตอบและสรุปประเด็น แต่ให้ทีมอนุมัติข้อเสนอราคา เงื่อนไขสัญญา และข้อความที่กระทบชื่อเสียงแบรนด์
ทางสุดท้ายคือทำ dashboard ติดตามคุณภาพ ต้นทุน และเวลาส่งมอบรายเดือน เมื่อมีข้อมูลสะสมพอ เราจะเห็นว่าโมเดลไหนเหมาะกับงานประเภทใด แทนที่จะพยายามหาโมเดลเดียวมาทำทุกอย่าง
Step 9: สรุป Checklist ทั้งหมดก่อนใช้ Claude Fable 5.1
- ☐ เลือก workflow ที่ทำซ้ำและมีผลลัพธ์วัดได้
- ☐ ตรวจว่าข้อมูลที่จะใช้เป็นข้อมูลสาธารณะ ภายใน หรืออ่อนไหว
- ☐ กำหนดเกณฑ์คุณภาพ เวลา และงบประมาณก่อนทดสอบ
- ☐ เตรียมเคสจริงสำหรับเปรียบเทียบ Fable 5 กับ Fable 5.1
- ☐ ใช้ prompt และข้อมูลชุดเดียวกันในการทดสอบ
- ☐ บันทึกค่าใช้จ่าย เวลา จำนวนรอบแก้ และคะแนนคุณภาพ
- ☐ ตรวจผลจากคนทำงานจริง ไม่ตัดสินจาก benchmark เพียงอย่างเดียว
- ☐ แยกงานด่วนออกจากงานที่ต้องการคุณภาพสูง
- ☐ วางสิทธิ์เข้าถึงและข้อห้ามด้านข้อมูลให้ชัดเจน
- ☐ ขยายใช้งานเมื่อ pilot ให้ผลคุ้มค่าอย่างต่อเนื่อง
Claude Fable 5.1 น่าสนใจเพราะส่งสัญญาณว่า AI ระดับสูงกำลังพยายามทำงานได้ดีขึ้นด้วยต้นทุนที่ลดลง โดยเฉพาะ workflow ที่ซ้ำและต้องใช้ข้อมูลเดิมบ่อยครั้ง แต่ธุรกิจจะได้ประโยชน์หรือไม่ ไม่ได้ขึ้นกับการเปิดใช้โมเดลใหม่ก่อนใคร ขึ้นกับการเลือกงานที่เหมาะ วัดผลอย่างตรงไปตรงมา และวางกติกาข้อมูลให้รัดกุมก่อนขยายผล