ถ่ายทอดจากคลิปของ Julian Goldie SEO และบทความต้นทางวันที่ 9 สิงหาคม 2026 ตัวเลขการประหยัดและรายละเอียดเครื่องมือเป็นผลที่ผู้จัดทำคลิปรายงาน ไม่ใช่ผลทดสอบของเว็บไซต์หรือการรับประกันว่าจะได้ผลเท่ากัน และยังไม่ได้ยืนยันเงื่อนไขบริการล่าสุด · วิดีโอต้นทาง
ปัญหา Claude Code ใช้ token หมดไว ไม่ได้เกิดจากการพิมพ์ prompt ยาวเกินไปเสมอไป หลายครั้งสิ่งที่กินโควตาอยู่เงียบๆ คือ log ยาวๆ คำตอบที่เกริ่นเกินจำเป็น งานที่ AI สร้างเผื่อไว้มากเกินไป และการส่งงานง่ายไปให้ model ราคาแพง
คลิปจาก Julian Goldie SEO เสนอแนวคิด “อุดรูรั่ว token” ด้วยเครื่องมือฟรี 4 ตัว ได้แก่ RTK, Caveman, Ponytail และ OmniRoute พร้อมนิสัยใช้งานอีก 8 ข้อ จุดที่น่าสนใจสำหรับเจ้าของธุรกิจไทยไม่ใช่การติดตั้งเครื่องมือทั้งหมดทันที แต่คือการเปลี่ยนวิธีคิดว่า AI ควรใช้ทรัพยากรกับงานที่สร้างมูลค่าสูง ไม่ใช่เสียไปกับงานจุกจิกและข้อมูลซ้ำซ้อน
แนวทางนี้พูดถึง Claude Code เป็นหลัก ซึ่งเป็นเครื่องมือที่เหมาะกับงานที่ AI ต้องทำงานกับไฟล์ คำสั่ง หรือระบบงานมากกว่าการคุยทั่วไป อย่างไรก็ตาม หลักการลดข้อมูลส่วนเกิน วางแผนก่อนทำ และเลือก model ตามระดับความยาก นำไปใช้กับ workflow AI ของธุรกิจได้กว้างกว่านั้นมาก
สารบัญ
- Step 1: มองหา 4 จุดที่ token รั่วก่อนลดการใช้งาน AI
- Step 2: กรองผลลัพธ์จากคำสั่งด้วย RTK
- Step 3: ลดคำตอบฟุ่มเฟือยด้วย Caveman
- Step 4: หยุดให้ AI สร้างงานเกินความจำเป็นด้วย Ponytail
- Step 5: แยกงานง่ายไปใช้ model ฟรีด้วย OmniRoute
- Step 6: ใช้ 8 นิสัยลด AI Costs ในทุก workflow
- Step 7: นำไปใช้กับธุรกิจด้วย Actionable Insights
- Step 8: Troubleshooting เมื่อเริ่มลด token แล้วงานสะดุด
- Step 9: การต่อยอดจากการประหยัด token ไปสู่ระบบงานที่ดีขึ้น
- Step 10: สรุป Checklist ทั้งหมดสำหรับลด Claude Code Tokens
Step 1: มองหา 4 จุดที่ token รั่วก่อนลดการใช้งาน AI
ข้อผิดพลาดที่พบบ่อยคือ เมื่อใกล้ชน limit เรากลับถามน้อยลง พิมพ์สั้นลง หรือเลิกให้ AI ช่วยงาน ทั้งที่ prompt ของเราอาจเป็นสัดส่วนเล็กน้อยของ token ทั้งหมด ปัญหาหลักมักอยู่ในระบบหลังบ้านของการทำงาน
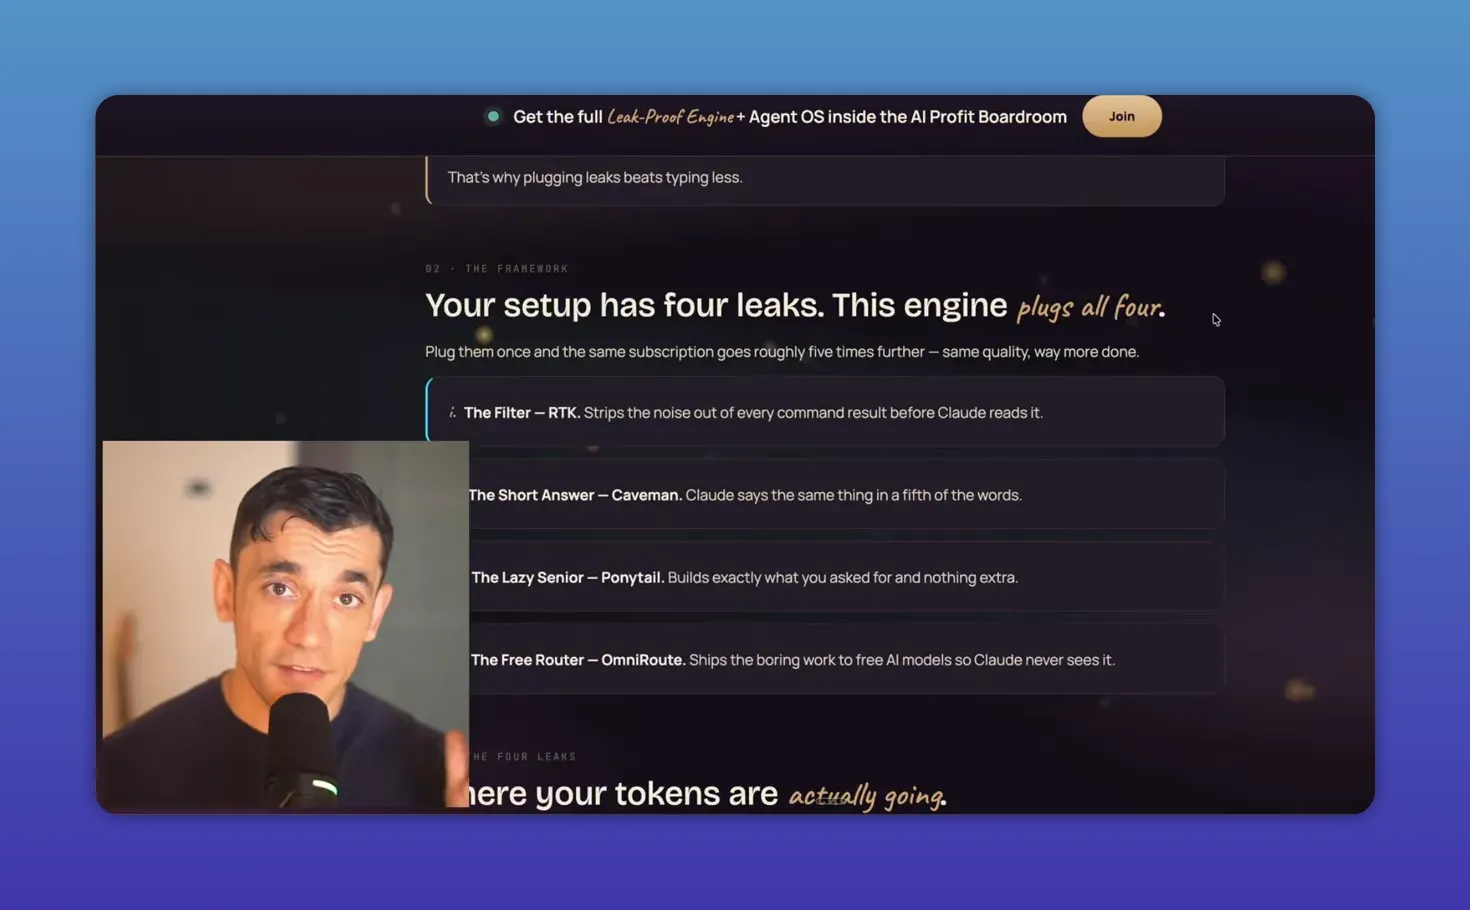
Julian Goldie แบ่งรูรั่วออกเป็น 4 จุดที่เข้าใจได้ง่ายดังนี้
- Tool output ที่ยาวเกินจำเป็น: เมื่อ agent รันคำสั่งกับไฟล์หรือระบบ ผลลัพธ์แบบ raw log จำนวนมากถูกส่งกลับเข้า context แม้ AI ต้องใช้จริงเพียงไม่กี่บรรทัด
- คำตอบที่ฟุ่มเฟือย: AI มักตอบด้วยคำทักทาย คำชม และเกริ่นนำ ก่อนให้คำตอบสั้นๆ ที่เราต้องการอยู่แล้ว
- การสร้างงานเกินโจทย์: เมื่อสั่งงานเรียบง่าย AI อาจสร้างโครงสร้าง ตัวเลือก หรือส่วนเสริมเพื่ออนาคต ทั้งที่ธุรกิจยังไม่ได้ต้องการ
- ใช้ model ระดับสูงกับงานระดับพื้นฐาน: งานอย่างเปลี่ยนชื่อไฟล์ สรุปข้อความสั้น ตรวจรูปแบบ หรือแก้คำเล็กน้อย ไม่จำเป็นต้องส่งให้ model ที่แพงที่สุดทุกครั้ง
ถ้าเทียบกับธุรกิจไทย เรื่องนี้เหมือนการใช้ผู้จัดการอาวุโสมานั่งจัดเอกสารแทนทีมแอดมิน ต้นทุนไม่ได้เกิดจากการมีคนเก่ง แต่เกิดจากการใช้คนเก่งผิดงาน Claude หรือ model ระดับสูงควรถูกเก็บไว้กับงานที่ต้องใช้เหตุผล การตัดสินใจ การวิเคราะห์ หรือการสร้างงานที่กระทบรายได้จริง
Step 2: กรองผลลัพธ์จากคำสั่งด้วย RTK
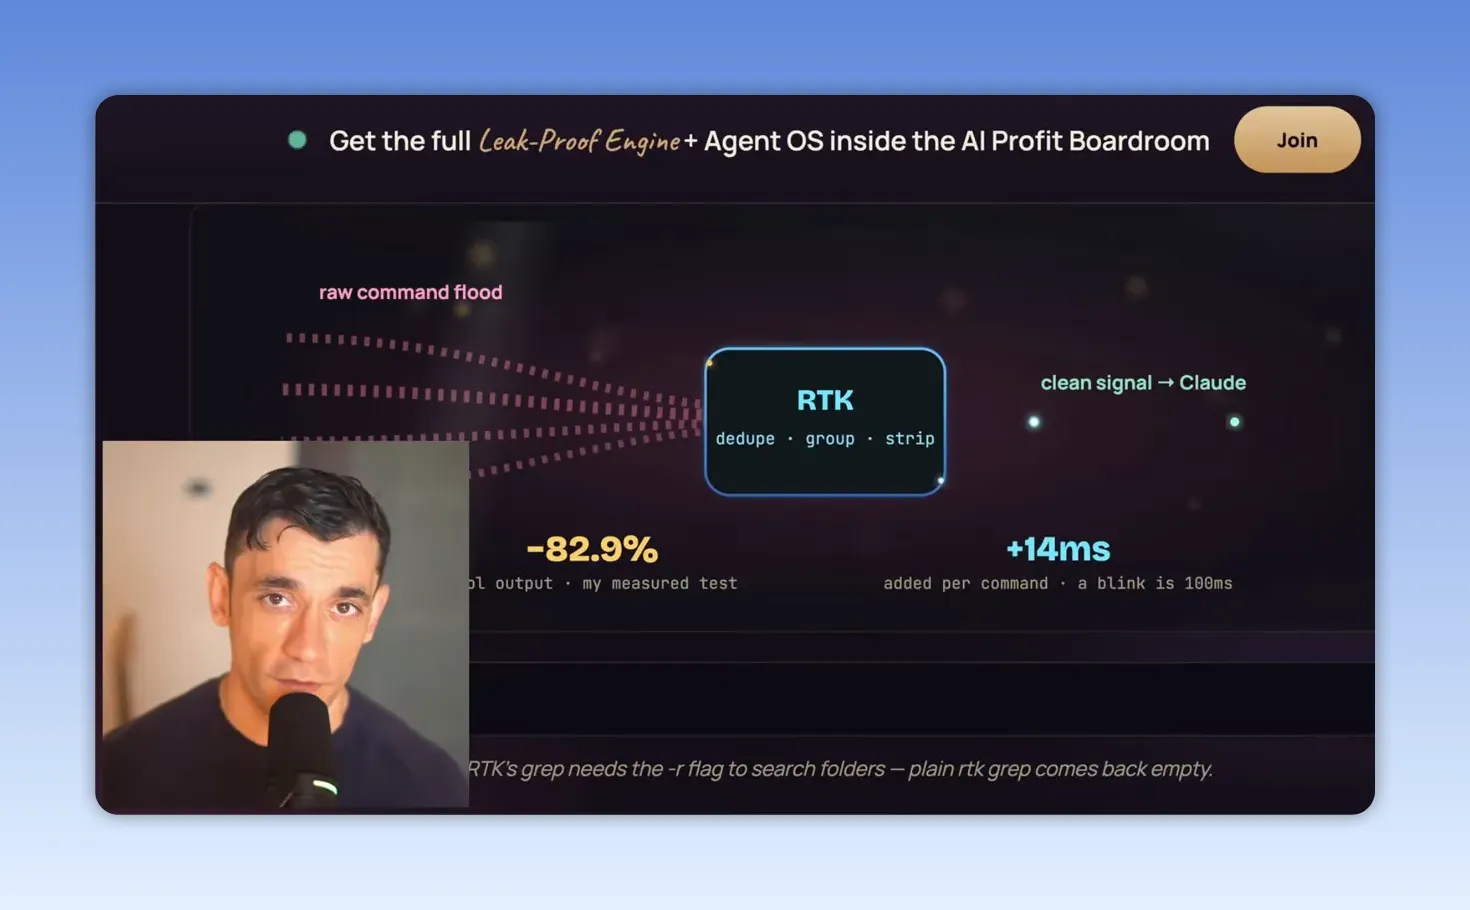
RTK ทำหน้าที่เป็นชั้นกรองระหว่าง AI agent กับคำสั่งที่รันบนเครื่อง เป้าหมายคือให้ AI ได้รับเฉพาะ “สัญญาณ” ที่จำเป็น แทนที่จะต้องอ่าน log ซ้ำ ข้อความสถานะ และข้อมูล padding จำนวนมาก
ในตัวอย่างของคลิป RTK ช่วยลด token จาก tool output ได้ 82.9% และเพิ่มความหน่วงราว 14 มิลลิวินาที ตัวเลขนี้เป็นผลทดสอบของผู้จัดทำคลิป ไม่ใช่ตัวเลขรับประกันสำหรับทุกงาน แต่แนวคิดมีน้ำหนักมาก โดยเฉพาะ workflow ที่ต้องค้นไฟล์ เช็กการเปลี่ยนแปลง รันคำสั่ง หรืออ่านผลจากระบบซ้ำๆ
สำหรับทีมธุรกิจที่ไม่ได้เขียนโค้ดเอง RTK อาจดูไกลตัว แต่หลักเดียวกันใช้ได้ทันทีในงานประจำ เช่น อย่าส่ง export รายการลูกค้าทั้งหมดให้ AI ถ้าต้องการเพียงยอดขายรายสัปดาห์ หรืออย่าโยนบทสนทนาแชตทั้งเดือนเพื่อถามว่าลูกค้าติดปัญหาอะไร ให้สรุปและคัดเฉพาะข้อมูลที่เกี่ยวข้องก่อน
มุมมองสำคัญ: การกรองต้องไม่ตัดข้อมูลที่มีผลต่อการตัดสินใจ งานที่เกี่ยวกับยอดเงิน ข้อกฎหมาย ข้อมูลลูกค้า หรือความปลอดภัย ควรมีวิธีตรวจสอบผลลัพธ์ต้นฉบับได้เสมอ
Step 3: ลดคำตอบฟุ่มเฟือยด้วย Caveman
Caveman คือแนวทางทำให้คำตอบของ Claude สั้น ตรง และตัดคำเกริ่นที่ไม่เพิ่มสาระออก คลิปยกตัวอย่างคำตอบปกติ 69 tokens เทียบกับคำตอบแบบกระชับ 19 tokens โดยยังให้ข้อมูลหลักเหมือนเดิม และรายงานว่าลด output tokens ได้ 69%
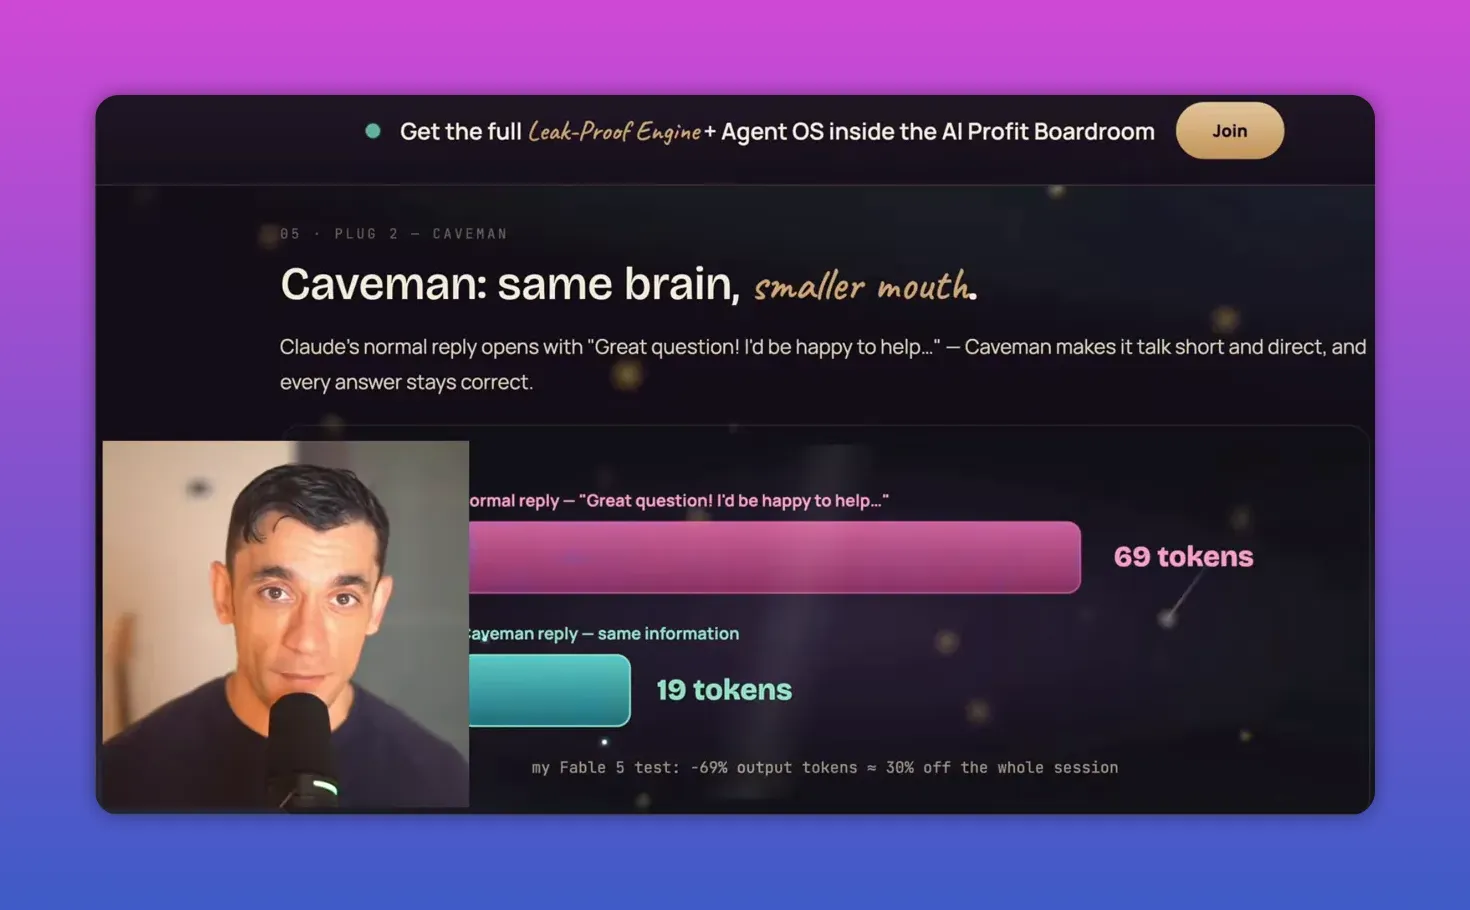
ธุรกิจไม่จำเป็นต้องทำให้ AI พูดสั้นตลอดเวลา งานเขียนโฆษณา อีเมลบริการลูกค้า หรือบทความแบรนด์ยังต้องมีน้ำเสียงที่ดี แต่สำหรับงานหลังบ้าน เช่น สรุปประชุม ตรวจรายการงาน สถานะโครงการ หรือการตอบกลับจาก agent หลายสิบรอบต่อวัน ความสุภาพที่ซ้ำเดิมกลายเป็นต้นทุนสะสม
วิธีเริ่มแบบไม่ต้องติดตั้งอะไร คือระบุใน prompt ว่า “ตอบเป็น bullet ไม่เกิน 5 ข้อ ไม่ต้องเกริ่น ไม่ต้องอธิบายสิ่งที่ทำได้” แล้วให้ทีมกำหนดรูปแบบคำตอบมาตรฐานร่วมกัน เช่น สถานะ, สิ่งที่พบ, สิ่งที่ต้องตัดสินใจ, งานถัดไป
Step 4: หยุดให้ AI สร้างงานเกินความจำเป็นด้วย Ponytail
Ponytail มุ่งแก้ปัญหา overbuilding หรือการสร้างสิ่งเกินโจทย์ คลิปอธิบายแนวคิดนี้ว่าให้ AI ทำงานแบบคนมีประสบการณ์ที่รู้เส้นทางสั้นที่สุดที่ยังปลอดภัย สร้างเฉพาะสิ่งที่จำเป็น ไม่สร้างระบบเผื่ออนาคตโดยไม่มีเหตุผล
ผลที่รายงานคือปริมาณ output ลดลงประมาณ 54% ต้นทุนลดราว 20% และงานเร็วขึ้นราว 27% แก่นของเรื่องไม่ได้อยู่ที่ “ทำงานลวก” แต่คือแยกให้ชัดระหว่างสิ่งจำเป็นกับสิ่งที่อาจมีประโยชน์ในอนาคต
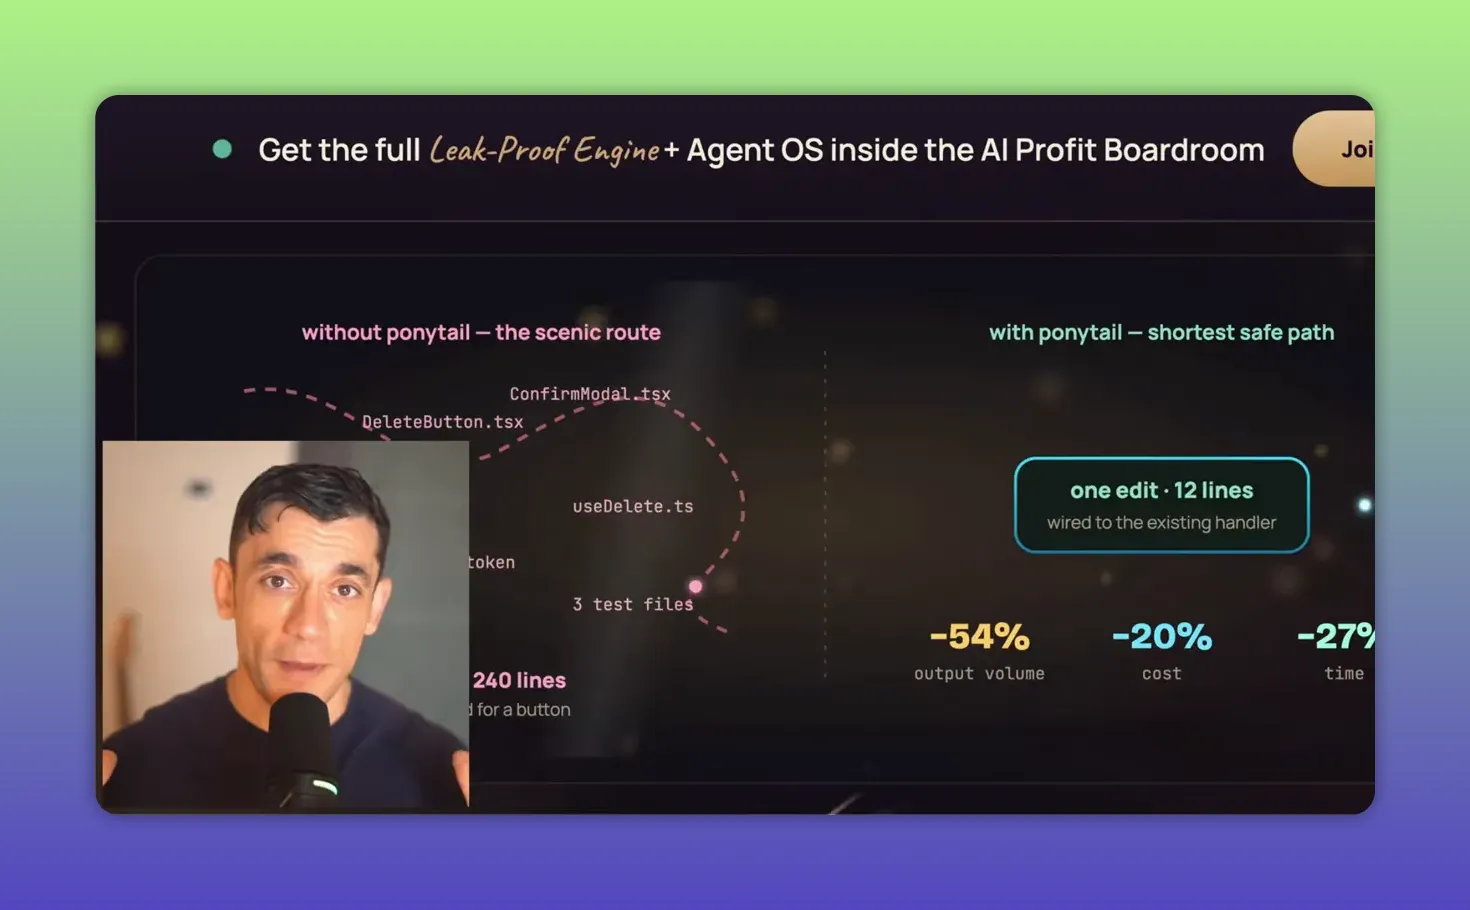
ตัวอย่างในธุรกิจไทยคือ หากเราขอให้ AI ช่วยทำระบบติดตามลีดสำหรับแคมเปญหนึ่งเดือน สิ่งที่ต้องการอาจเป็น Google Sheet โครงสร้างเดียว พร้อมสถานะและเจ้าของงาน ไม่ใช่ dashboard หลายหน้า ระบบสิทธิ์ผู้ใช้ และรายงานสิบรูปแบบตั้งแต่วันแรก
Prompt ที่ช่วยป้องกันงานบานปลายคือ “ทำเวอร์ชันใช้งานจริงขั้นต่ำก่อน ห้ามเพิ่มฟีเจอร์ที่ไม่ได้ระบุ อธิบายสิ่งที่ตัดสินใจไม่ทำไว้ท้ายคำตอบ” วิธีนี้ช่วยให้เราคุม scope ได้ ไม่ใช่แค่ลด token
Step 5: แยกงานง่ายไปใช้ model ฟรีด้วย OmniRoute
จุดที่คุ้มค่าที่สุดในแนวคิดนี้คือ routing หรือการเลือก model ตามระดับความยาก OmniRoute เป็น gateway ที่รันบนเครื่องและส่งงานจุกจิกไปยัง model ฟรีหรือ model ที่ต้นทุนต่ำกว่า ขณะที่งานยากยังอยู่กับ Claude
คลิประบุว่า OmniRoute รองรับ 93 models และรวมการบีบอัดแบบ RTK กับ Caveman ไว้ใน gateway ด้วย จึงช่วยลดปริมาณ request ได้อีก ข้อได้เปรียบสำคัญไม่ใช่แค่ประหยัดเงิน แต่ช่วยลดโอกาสชน rate limit ของ model ฟรี
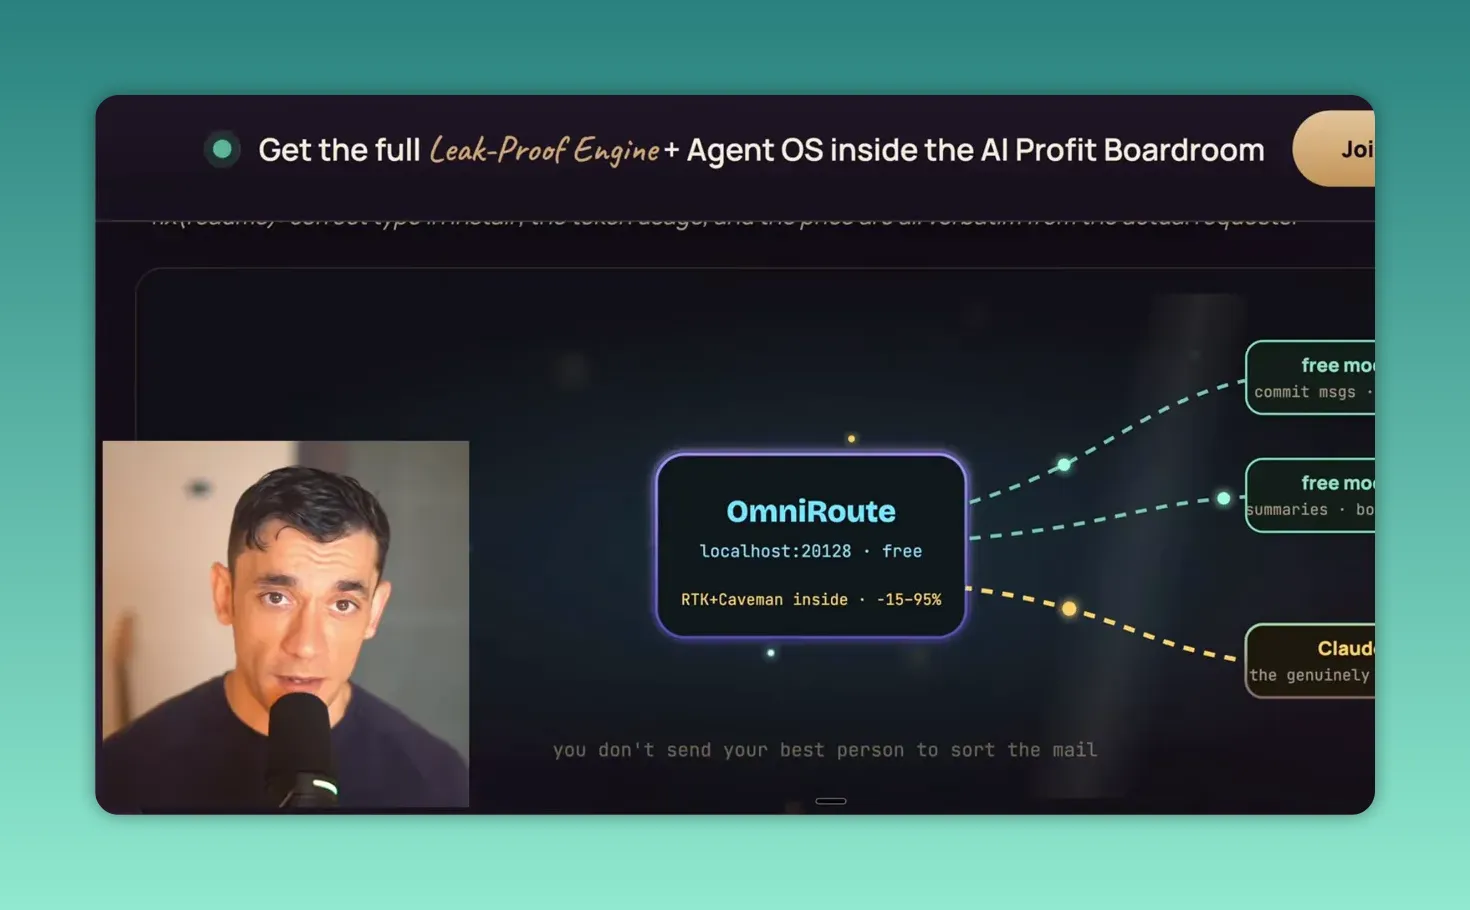
แนวคิด routing ใช้ได้แม้เราไม่ติดตั้ง OmniRoute ตัวอย่างการจัดงานของทีมการตลาดอาจเป็นดังนี้
- งานง่าย: จัดหมวดหมู่คอมเมนต์ สรุปรีวิว แปลงตารางเป็น bullet ตรวจคำผิด เปลี่ยนรูปแบบรายงาน
- งานระดับกลาง: ร่างคอนเทนต์หลายแบบ สรุป insight ยอดขาย หา theme จากเสียงลูกค้า
- งานยาก: วางกลยุทธ์ วิเคราะห์ข้อมูลสำคัญ ตัดสินใจ trade-off สร้างแผนที่ต้องอิงความรู้เฉพาะธุรกิจ
ข้อควรระวังคือ model ฟรีมีข้อจำกัดด้านความแม่นยำ ความเป็นส่วนตัว และความต่อเนื่องของบริการ เราไม่ควรส่งข้อมูลลูกค้า ข้อมูลการเงิน หรือข้อมูลภายในที่อ่อนไหวไปยัง model ใดๆ ก่อนตรวจนโยบายข้อมูลของผู้ให้บริการ และควรมีขั้นตอนตรวจงานก่อนนำไปใช้จริง
Step 6: ใช้ 8 นิสัยลด AI Costs ในทุก workflow
ต่อให้ไม่ใช้เครื่องมือทั้ง 4 ตัว เราก็ลด token ได้จากวินัยการทำงานที่คลิปเสนอไว้ นี่คือชุดนิสัยที่นำไปทำได้ทันทีใน Claude Code และประยุกต์ใช้กับ AI ตัวอื่นได้
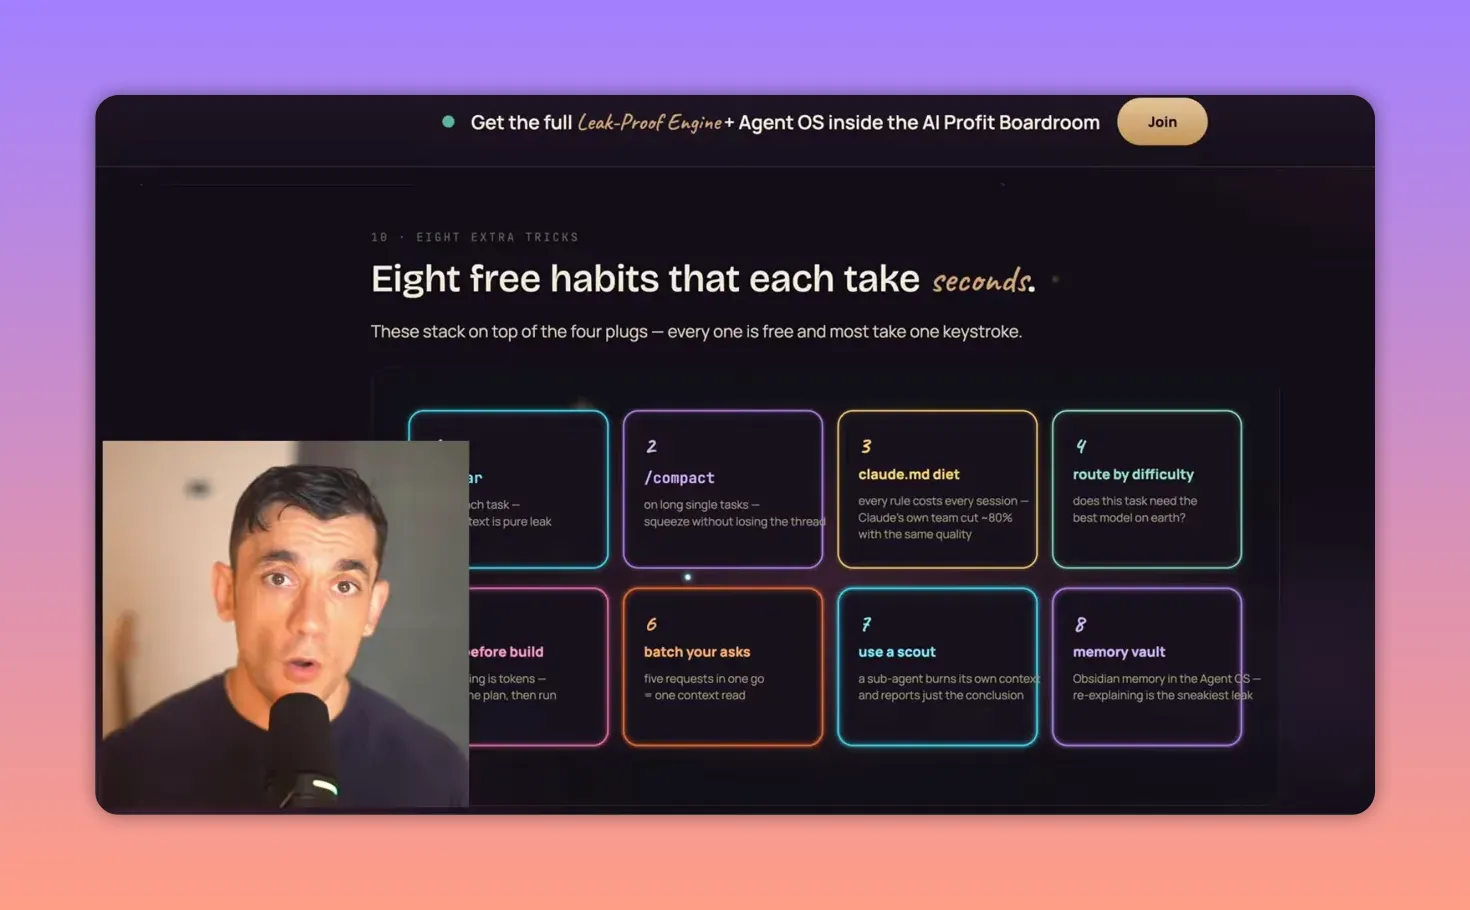
- เคลียร์ context เมื่อจบงาน: ใช้ /clear หลังปิดงาน เพื่อไม่ให้เรื่องเก่าติดไปกับงานใหม่
- ย่อ context ในงานยาว: ใช้ /compact เพื่อเก็บใจความแทนแบกบทสนทนาทั้งหมดต่อไป
- ลดไฟล์คำสั่งประจำ: ถ้าใช้ CLAUDE.md หรือชุดคำสั่งมาตรฐาน ให้ตัดกฎที่ซ้ำหรือไม่จำเป็น เพราะมันถูกอ่านซ้ำทุก session
- เลือก model ตามความยาก: อย่าให้ทุกงานวิ่งไปที่ model แพงที่สุดโดยอัตโนมัติ
- วางแผนก่อนลงมือ: ให้ AI สรุปแผนก่อน แล้วค่อยสั่งทำ ลดการหลงทางและการแก้หลายรอบ
- รวมคำขอที่เกี่ยวกัน: หากต้องถาม 5 เรื่องจากข้อมูลชุดเดียวกัน ให้ถามครั้งเดียวแบบมีรายการชัดเจน
- ใช้ scout แยกค้นข้อมูลใหญ่: ให้ agent ย่อยค้นเอกสารก้อนใหญ่ แล้วส่งเฉพาะข้อสรุปกลับมา
- สร้าง memory vault: เก็บข้อมูลธุรกิจที่ใช้ซ้ำ เช่น brand voice รายละเอียดสินค้า กลุ่มลูกค้า และกฎการทำงาน เพื่อไม่ต้องอธิบายใหม่ทุก session
สิ่งที่ควรเน้นคือ memory ไม่ได้แปลว่าป้อนข้อมูลทุกอย่างให้ AI จำ ยิ่งใส่มากโดยไม่จัดระเบียบ ยิ่งเพิ่ม token และเพิ่มโอกาสให้ AI หยิบข้อมูลผิด จุดที่ดีคือทำเอกสารสั้น ชัด อัปเดตง่าย และแยกตามงาน เช่น “ข้อมูลแบรนด์” “ข้อมูลสินค้า” “กติกาการตอบลูกค้า”
Step 7: นำไปใช้กับธุรกิจด้วย Actionable Insights
- ทำบัญชีงาน AI 1 สัปดาห์: จดทุกงานที่ใช้ AI แล้วติดป้ายว่า ง่าย กลาง หรือยาก ก่อนคิดเรื่องเปลี่ยน tool
- ตั้งรูปแบบผลลัพธ์ประจำทีม: กำหนดคำตอบแบบสั้นสำหรับสรุปงาน เช่น 3 ประเด็น, 3 ความเสี่ยง, 3 งานถัดไป
- เริ่มจาก workflow ที่มีข้อมูลซ้ำ: เช่น สรุปประชุม รายงานยอดขาย คัดคอมเมนต์ หรือจัดหมวดลีด เพราะเห็นผลจากการลด context ได้ชัด
- ตั้งเกณฑ์ส่งต่อคน: งานที่มีผลต่อราคา การเงิน สัญญา หรือข้อมูลลูกค้า ต้องมีคนอนุมัติก่อนเสมอ
- วัดผลจากงานที่เสร็จ ไม่ใช่ token ที่ถูก: token ลดลงแต่ต้องแก้เพิ่มหลายรอบไม่ใช่การประหยัด เป้าหมายคือรอบงานสั้นลงและคุณภาพยังอยู่
Step 8: Troubleshooting เมื่อเริ่มลด token แล้วงานสะดุด
- ปัญหา: คำตอบสั้นจนทีมทำงานต่อไม่ได้
สาเหตุ: ตั้งการตอบแบบกระชับกับงานที่ต้องใช้รายละเอียด
วิธีแก้: แยก mode งานเป็น “สรุปสั้น” และ “อธิบายเพื่อส่งต่องาน” จากนั้นระบุรูปแบบ output ที่ต้องการให้ชัด - ปัญหา: AI ทำงานไม่ครบเพราะตัด context มากไป
สาเหตุ: ใช้ /clear หรือการย่อข้อมูลก่อนเก็บข้อกำหนดสำคัญ
วิธีแก้: ทำ brief สั้นหนึ่งหน้า เก็บเป้าหมาย ข้อจำกัด ไฟล์ที่เกี่ยวข้อง และนิยามความสำเร็จก่อนล้าง context - ปัญหา: งานจาก model ฟรีคุณภาพไม่พอ
สาเหตุ: routing งานยากไปยัง model ที่เหมาะกับงานง่าย
วิธีแก้: ย้ายงานวิเคราะห์ ตัดสินใจ และงานที่กระทบลูกค้ากลับไปใช้ Claude หรือ model ระดับสูง แล้วใช้ model ฟรีกับงานจัดรูปแบบและคัดแยกเท่านั้น - ปัญหา: AI สร้างงานเกิน scope ซ้ำๆ
สาเหตุ: โจทย์ไม่ได้บอกสิ่งที่ “ห้ามทำ” และเกณฑ์จบงาน
วิธีแก้: ใส่ขอบเขตชัดเจนว่าให้สร้างอะไร ไม่ต้องสร้างอะไร และให้หยุดรออนุมัติก่อนเพิ่มส่วนใหม่ - ปัญหา: ติดตั้งเครื่องมือแล้วแต่ไม่มั่นใจเรื่องข้อมูล
สาเหตุ: ยังไม่ได้กำหนดนโยบายข้อมูลสำหรับ AI
วิธีแก้: แบ่งระดับข้อมูล ห้ามส่งข้อมูลอ่อนไหวออกนอกระบบ ตรวจนโยบายผู้ให้บริการ และทดสอบกับข้อมูลจำลองก่อน
Step 9: การต่อยอดจากการประหยัด token ไปสู่ระบบงานที่ดีขึ้น
ไอเดียที่หนึ่ง: สร้าง AI triage สำหรับทีม ให้ AI รับงานเข้ามาแล้วจัดระดับความยาก งานง่ายถูกสรุปหรือจัดหมวดทันที งานที่ซับซ้อนส่งต่อให้คนหรือ model ที่เก่งกว่า วิธีนี้ทำให้ทีมเห็นคอขวดจริงของงาน
ไอเดียที่สอง: ทำคลัง brief และ memory ของธุรกิจ รวมข้อมูลที่ต้องใช้บ่อยไว้ในเอกสารที่กระชับและมีเจ้าของข้อมูลชัดเจน ลดการบอก AI ใหม่ซ้ำๆ และทำให้คำตอบสม่ำเสมอขึ้น
ไอเดียที่สาม: วัดต้นทุนต่อผลลัพธ์ แทนที่จะถามว่าใช้ token เท่าไร ให้ติดตามว่า AI ช่วยลดเวลากี่ชั่วโมง ลดจำนวนรอบแก้กี่รอบ หรือช่วยให้ทีมทำแคมเปญได้เร็วขึ้นแค่ไหน นี่คือหน่วยวัดที่เจ้าของธุรกิจควรใช้ตัดสินใจ
Step 10: สรุป Checklist ทั้งหมดสำหรับลด Claude Code Tokens
- ☐ ตรวจว่า token หายไปกับ log คำตอบฟุ่มเฟือย งานเกินโจทย์ หรือ model ที่แพงเกินงานหรือไม่
- ☐ เริ่มจาก RTK หาก workflow มี tool output หรือ log จำนวนมาก
- ☐ ตั้งรูปแบบคำตอบสั้นตรงสำหรับงานหลังบ้านแบบ Caveman
- ☐ เขียน prompt กำหนด scope เพื่อลด overbuilding ตามแนวคิด Ponytail
- ☐ แบ่งงานง่าย กลาง และยาก ก่อนเลือก model หรือใช้ OmniRoute
- ☐ ใช้ /clear เมื่องานจบ และ /compact เมื่องานยาว
- ☐ ลดคำสั่งประจำที่ซ้ำซ้อนใน CLAUDE.md หรือเอกสาร prompt กลาง
- ☐ วางแผนก่อนสั่งทำ รวมคำถามที่ใช้ข้อมูลชุดเดียวกัน และแยก scout สำหรับงานค้นข้อมูล
- ☐ สร้าง memory vault ที่สั้น ชัด และไม่ใส่ข้อมูลอ่อนไหวเกินจำเป็น
- ☐ วัดทั้ง token คุณภาพงาน เวลา และจำนวนรอบแก้ก่อนตัดสินใจขยายระบบ
ข้อสรุปของคลิปนี้น่าเชื่อในเชิงหลักการ คือเราไม่ควรแก้ปัญหา limit ด้วยการใช้ AI น้อยลงเพียงอย่างเดียว แต่ควรหยุดจ่าย token ให้กับสิ่งที่ไม่สร้างมูลค่า ตัวเลขลดได้ 80% อาจไม่เกิดกับทุก workload โดยเฉพาะงานที่ต้องใช้ model ระดับสูงตลอดเวลา แต่การอุดรูรั่วทีละจุดยังช่วยให้ AI ทำงานได้มากขึ้นภายใต้งบและโควตาเดิม
สำหรับธุรกิจไทย จุดเริ่มต้นที่เหมาะที่สุดไม่ใช่การไล่ติดตั้งทุก repo แต่คือการถามให้ชัดว่า “งานไหนต้องใช้สมองระดับสูงของ AI จริงๆ” เมื่อเราแยกคำตอบได้ ระบบ AI จะคุ้มขึ้น ใช้งานง่ายขึ้น และไม่กลายเป็นต้นทุนที่พองตัวโดยไม่รู้ตัว