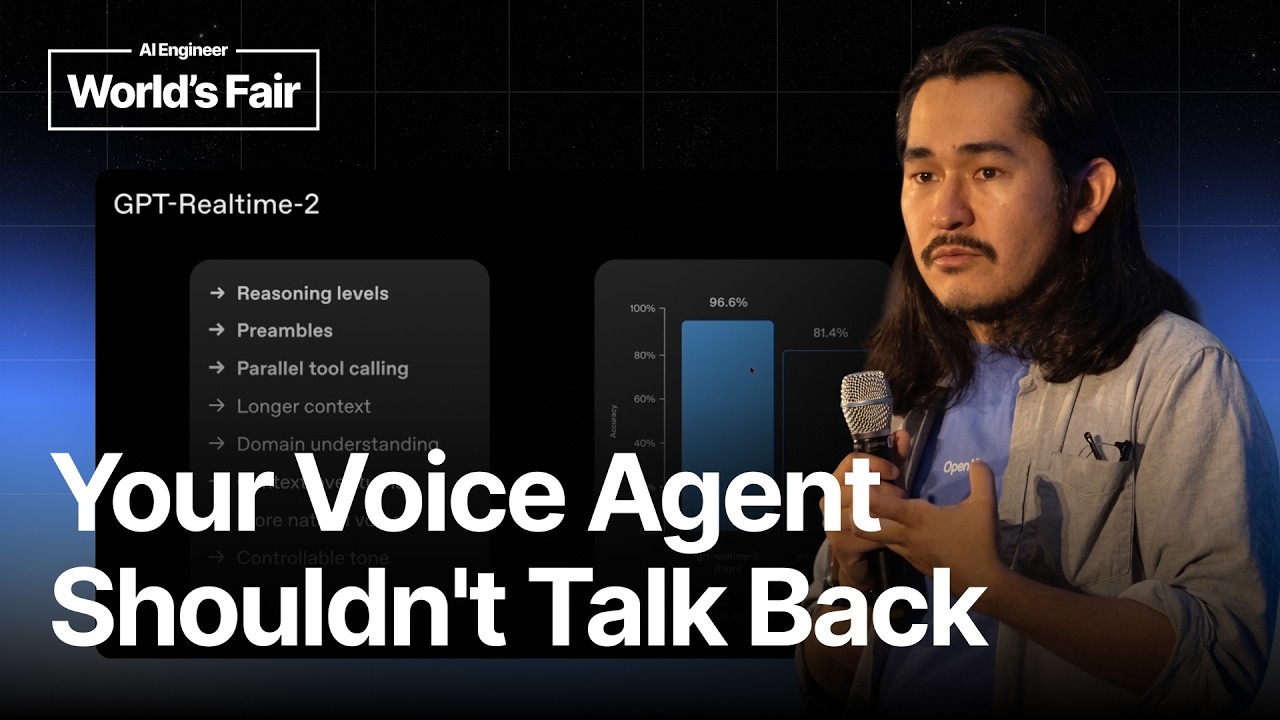
ถ่ายทอดจากบทความต้นทางลงวันที่ 15 กันยายน 2026 และคลิป Voice Agents Can Just Do Things โดย Charlie Guo ทีม Developer Experience ของ OpenAI บนช่อง AI Engineer เป็นกรอบออกแบบและตัวอย่างที่ผู้บรรยายเสนอ ไม่ใช่ผลทดสอบความสามารถของทุกระบบหรือการรับรองฟีเจอร์ปัจจุบัน ตัวอย่างธุรกิจไทยและแผนทดลองคงจากบทความเดิม วันที่นี้เป็นวันที่บทความต้นทาง ไม่ใช่วันอัปโหลดวิดีโอซึ่งยังไม่ทราบ
Charlie Guo เสนอให้ทบทวนการออกแบบ Voice Agent ที่ตั้งต้นว่า AI ต้องตอบกลับด้วยเสียงทุกครั้ง ผลลัพธ์จึงมักกลายเป็นแชตบอตที่เปลี่ยนจากพิมพ์เป็นพูดเท่านั้น ทั้งที่สิ่งที่ธุรกิจต้องการจริงๆ คือให้ AI ช่วยทำงานให้เสร็จ
จากคลิปของ Charlie Guo ทีม Developer Experience ของ OpenAI บนช่อง AI Engineer มีแนวคิดที่น่าสนใจมากว่า เสียงเป็นเพียง “ช่องทางรับคำสั่ง” ไม่ใช่ข้อบังคับว่า AI ต้องใช้เสียงเป็น “ช่องทางตอบกลับ” เสมอไป มุมนี้สำคัญต่อเจ้าของธุรกิจไทย เพราะเปิดทางให้เราออกแบบ AI ที่ลดงานซ้ำ ลดขั้นตอน และทำให้บริการเข้าถึงคนได้มากขึ้น
Step 1: เปลี่ยนโจทย์จาก “สร้าง Voice Agent” เป็น “เสียงมีบทบาทอะไร”
คำถามตั้งต้นที่ควรถามไม่ใช่ “เราจะทำ Voice Agent แบบไหน” แต่คือ เสียงช่วยให้คนทำงานหรือใช้บริการได้ดีขึ้นตรงไหน บางงานเหมาะกับการพูดคุย บางงานควรให้ AI ลงมือทำทันที และหลายครั้งคำตอบที่ดีที่สุดคือการเปลี่ยนหน้าจอ แสดงสถานะ หรือขอการยืนยัน แทนการพูดยาวๆ
Charlie ชี้ให้เห็นความเข้าใจผิดที่พบได้บ่อยว่า Voice Agent ต้องพูดตอบกลับ ทั้งที่ software มีวิธีสื่อสารอื่นมานานแล้ว เช่น แจ้งเตือน เปลี่ยนสีปุ่ม ไฮไลต์ข้อความ แสดง pop-up หรือเลื่อนเคอร์เซอร์เพื่อบอกว่าระบบกำลังทำอะไรอยู่
ถ้าเป็นธุรกิจไทย ลองนึกถึงระบบหลังบ้านร้านค้า พนักงานอาจพูดว่า “สร้างใบเสนอราคาให้ลูกค้าบริษัทเอ จำนวน 30 ชิ้น ส่งภายในวันศุกร์” ระบบไม่จำเป็นต้องอ่านใบเสนอราคาทั้งหมดกลับมา แต่อาจสร้างเอกสารให้ แสดงสรุปยอดบนหน้าจอ แล้วถามด้วยเสียงสั้นๆ เฉพาะเมื่อมีข้อมูลที่ต้องยืนยัน เช่น ราคา ส่วนลด หรือที่อยู่จัดส่ง
แก่นของการออกแบบจึงอยู่ที่การเลือกช่องทางที่เหมาะกับจังหวะงาน ไม่ใช่การใส่เสียงให้มากที่สุด เพราะเสียงที่ไม่จำเป็นสามารถรบกวนสมาธิและทำให้ประสบการณ์ใช้งานช้าลงได้
Step 2: เลือก 3 รูปแบบ Voice AI ให้ตรงกับปัญหาธุรกิจ
กรอบคิดหลักแบ่งรูปแบบการใช้งานเสียงออกเป็น 3 แบบที่นำมาผสมกันได้ ซึ่งไม่ใช่เทคโนโลยีใหม่ทั้งหมด ตัวอย่างเก่าอย่างสายโทรศัพท์แจ้งรอบหนังเป็น speech to speech และ GPS ในรถเป็น event to speech สิ่งที่เปลี่ยนไปคือ model ปัจจุบันเข้าใจภาษา น้ำเสียง และเชื่อมต่อเครื่องมือได้ดีขึ้นมาก
1. Speech to speech: พูดคุยเพื่อให้คำแนะนำ
รูปแบบนี้คือคนพูด แล้ว AI ตอบด้วยเสียง เหมาะกับงานที่คุณค่าหลักอยู่ที่การสนทนา เช่น ฝึกภาษา การโค้ช การแปลสด หรือบริการช่วยเหลือลูกค้า
สำหรับธุรกิจ รูปแบบนี้อาจใช้เป็นผู้ช่วยตอบคำถามสินค้าที่ต้องอธิบายละเอียด หรือช่วยพนักงานฝึกบทสนทนากับลูกค้า จุดแข็งของเสียงคือ AI รับรู้การเน้นคำ อารมณ์ และจังหวะการพูดได้ดีกว่าการอ่านข้อความล้วนๆ จึงเหมาะกับสถานการณ์ที่ “วิธีพูด” มีความหมายพอๆ กับ “สิ่งที่พูด”
แต่ไม่ควรเริ่มจากการแทนเจ้าหน้าที่ทุกกรณี ธุรกิจควรจำกัดขอบเขต เช่น ตอบคำถามสินค้า แจ้งสถานะเบื้องต้น หรือคัดกรองเรื่องก่อนส่งต่อคน เมื่อคำถามเกี่ยวกับการคืนเงิน เงื่อนไขสัญญา หรือข้อมูลอ่อนไหว ระบบควรส่งต่ออย่างชัดเจน
2. Speech to action: พูดแล้วให้ระบบทำงาน
นี่คือพื้นที่ที่น่าสนใจที่สุด AI รับคำสั่งเสียงแล้วเรียกใช้ tools เพื่อทำงาน เช่น กรอกฟอร์ม สร้างเอกสาร จัดการข้อมูล หรือควบคุม software ที่มีอยู่เดิม
ตัวอย่างที่ชัดเจนคือการกรอกฟอร์ม แทนที่จะเสียเวลาพิมพ์ข้อมูลเดิมซ้ำๆ คนอาจเล่าข้อมูลให้ AI ฟัง แล้วระบบกรอกให้ส่วนใหญ่ จากนั้นจึงเปิดหน้าสรุปให้ตรวจสอบก่อนส่ง วิธีคิดนี้นำมาใช้กับใบสมัคร แบบสอบถามลูกค้า รายงานไซต์งาน หรือบันทึกการประชุมได้
อีกกลุ่มคือเครื่องมือสร้างสรรค์ หลายคนมีภาพในหัวชัด แต่ไม่ชำนาญโปรแกรมออกแบบ ตัดต่อ หรือทำเพลง เสียงช่วยให้บอกความต้องการเชิงอารมณ์และสไตล์ได้ง่ายขึ้น เช่น ขอภาพโปรโมชันที่ดูอบอุ่น เรียบง่าย และเหมาะกับลูกค้าครอบครัว แม้ AI ยังไม่ควรแทนการตัดสินใจด้านแบรนด์ทั้งหมด แต่มันช่วยให้ทีมเริ่มงานเร็วขึ้นได้
3. Event to speech: ให้ระบบพูดเมื่อเหตุการณ์สำคัญเกิดขึ้น
รูปแบบนี้เริ่มจากเหตุการณ์ในระบบ แล้ว AI จึงพูดเพื่อแจ้งหรือเรียกความสนใจ ตัวอย่างคือแอปทำอาหารที่ให้คำแนะนำระหว่างมือเปื้อน หรือระบบที่แจ้งเตือนเมื่อเราไม่สามารถมองหน้าจอได้
สำหรับธุรกิจ อาจเป็นระบบคลังสินค้าที่แจ้งทีมงานเมื่อมีคำสั่งซื้อเร่งด่วน ระบบขนส่งที่บอกว่ามีเส้นทางล่าช้า หรือระบบขายที่เตือนว่าลูกค้ารายสำคัญยังไม่ได้รับการตอบกลับ อย่างไรก็ดี จุดที่ต้องระวังคือ ไม่ใช่ทุก event ควรเปลี่ยนเป็นเสียง หากระบบอ่านทุกแจ้งเตือนออกเสียง มันจะสร้างภาระใหม่แทนที่จะช่วยงาน
แนวทางที่ดีกว่าคือสร้างลำดับการแจ้งเตือน เริ่มจากเปลี่ยนสถานะบนหน้าจอ ต่อด้วย notification และใช้เสียงเฉพาะเหตุการณ์ที่เร่งด่วน สำคัญ หรือจำเป็นต้องตอบสนองทันที
Step 3: เริ่มจาก workflow เดิมที่มีคำกริยาชัดเจน
ธุรกิจไม่จำเป็นต้องรื้อระบบใหม่ทั้งหมดเพื่อเริ่มใช้ Voice AI เพราะระบบที่มีอยู่มักแยกงานเป็นคำกริยาอยู่แล้ว เช่น สร้างคำสั่งซื้อ ค้นหาลูกค้า เปลี่ยนสถานะ ออกใบกำกับ หรือตรวจสต็อก งานเหล่านี้สามารถถูกเปิดให้ model เรียกใช้เป็น tools ได้
ในมุมเจ้าของกิจการ สิ่งที่ต้องทำก่อนคุยเรื่อง model คือทำรายการงานซ้ำที่คนพูดอธิบายได้ง่าย แล้วจัดลำดับตามความเสี่ยง ตัวอย่าง workflow ที่เหมาะกับการเริ่มต้นมีดังนี้
- ค้นหาสถานะออเดอร์จากชื่อลูกค้าหรือเลขคำสั่งซื้อ
- สร้างร่างใบเสนอราคา แล้วให้คนตรวจทานก่อนส่ง
- สรุปยอดขายหรือสต็อกที่ต้องเติมจากข้อมูลในระบบ
- บันทึกข้อมูลหลังโทรหาลูกค้าเป็นโน้ตใน CRM
- เปิดหน้ารายการงานที่ต้องติดตาม โดยไม่แก้ไขข้อมูลใดๆ
ควรเริ่มจากงานที่ “ช่วยค้นหา ช่วยร่าง ช่วยบันทึก” ก่อนงานที่มีผลผูกพันทางการเงินหรือกฎหมาย เช่น การโอนเงิน การยกเลิกคำสั่งซื้อ หรือการอนุมัติส่วนลดระดับสูง งานเสี่ยงสูงต้องมี guardrails และจุดยืนยันจากคนเสมอ
Step 4: ออกแบบให้ AI ทำงานเงียบได้ และบอกสถานะเมื่อจำเป็น
ประสบการณ์ที่ดีไม่ได้แปลว่า AI ต้องเล่าทุกสิ่งที่กำลังทำ หากได้รับคำสั่งให้เช็กเที่ยวบินหรือค้นหาข้อมูล ระบบอาจต้องใช้เวลาสักครู่ การเงียบโดยไม่มีคำอธิบายทำให้คนรู้สึกว่าระบบค้าง แต่การพูดทุกขั้นตอนก็ทำให้รำคาญ
แนวคิดหนึ่งที่นำมาใช้ได้คือ preamble หรือประโยคเกริ่นสั้นๆ ก่อน AI เรียก tools เช่น “กำลังตรวจสอบราคาสินค้าให้ รอสักครู่” จากนั้นระบบทำงานเบื้องหลังและแสดงผลลัพธ์บนหน้าจอ วิธีนี้สร้างความมั่นใจโดยไม่ทำให้บทสนทนายืดเยื้อ
เทคโนโลยีเสียงแบบ native audio ยังช่วยให้ model ไม่ต้องแปลงเสียงเป็นข้อความก่อนทุกขั้นตอน จึงเก็บสัญญาณสำคัญได้มากกว่า ทั้งน้ำเสียง จังหวะ อารมณ์ การแทรก และเสียงแวดล้อม ข้อมูลเหล่านี้อาจมีประโยชน์ในงานบริการหรือการโค้ช แต่ต้องใช้ด้วยความระมัดระวัง โดยเฉพาะเรื่องความเป็นส่วนตัวและความยินยอม
สำหรับรายละเอียดผลิตภัณฑ์และแนวทางการสร้างแอปเสียง สามารถศึกษาเอกสารจาก OpenAI Realtime API ได้โดยตรง
Step 5: มอง Accessibility เป็นคุณค่าทางธุรกิจ ไม่ใช่ส่วนเสริม
เสียงไม่ได้มีประโยชน์แค่เรื่องความสะดวก Charlie ยกประเด็นสำคัญว่าเครื่องมือเสียงและ coding agent ช่วยให้คนที่สูญเสียความคล่องตัวของมือยังทำงานกับคอมพิวเตอร์ได้มากขึ้น
สำหรับธุรกิจไทย นี่หมายถึงการออกแบบบริการที่ไม่บังคับให้ทุกคนต้องพิมพ์ คลิก หรือมองจอขนาดเล็กตลอดเวลา ระบบรับคำสั่งด้วยเสียงควรมีทางเลือกเป็นข้อความและปุ่มควบคู่กัน เพื่อให้คนเลือกวิธีที่เหมาะกับตนเอง ไม่ควรทำให้เสียงกลายเป็นประตูบานเดียวของบริการ
นี่เป็นจุดที่ควรเห็นต่างกับกระแส “ทุกอย่างต้อง voice-first” เล็กน้อย เสียงมีข้อจำกัดในพื้นที่สาธารณะ สภาพแวดล้อมที่เสียงดัง และงานที่ต้องตรวจตัวเลขละเอียด การออกแบบที่ดีคือ multimodal คือผสมเสียง หน้าจอ และการยืนยันด้วยข้อความ ไม่ใช่แทนที่ทุกอย่างด้วยการพูด
Step 6: ใช้ Actionable Insights เริ่มทดลองภายใน 30 วัน
- เลือกงานเดียวที่เสียเวลาซ้ำ: เช่น พิมพ์โน้ตหลังคุยลูกค้า หรือค้นหาสถานะออเดอร์ แล้ววัดเวลาที่ใช้ก่อนเริ่มทดลอง
- แยกคำสั่งเป็น 3 ระดับ: ดูข้อมูลได้, สร้างร่างได้, และเปลี่ยนข้อมูลจริงได้ แต่ละระดับต้องมีสิทธิ์และการยืนยันต่างกัน
- ให้หน้าจอเป็นหลักฐาน: หลังรับคำสั่งเสียง ระบบควรแสดงสิ่งที่เข้าใจและสิ่งที่ทำแล้ว เพื่อให้เราตรวจได้ทันที
- กำหนดเสียงเฉพาะเรื่องเร่งด่วน: ตั้งเกณฑ์ว่าข้อความแบบไหนใช้ notification และเหตุการณ์แบบไหนจึงใช้เสียง
- เก็บคำสั่งที่ระบบเข้าใจผิด: นำมาปรับ prompt คำศัพท์สินค้า ชื่อลูกค้า และขั้นตอนถามกลับ ไม่ควรเดาว่าระบบแม่นเพียงพอจากการทดสอบไม่กี่ครั้ง
Step 7: แก้ปัญหาที่พบบ่อยก่อนขยายการใช้งาน
- ปัญหา: AI เข้าใจชื่อสินค้า ชื่อลูกค้า หรือคำเฉพาะผิด
สาเหตุ: คำศัพท์ธุรกิจมีการออกเสียงหลายแบบและเสียงแวดล้อมรบกวน
วิธีแก้: สร้างรายการคำสำคัญ ให้ระบบยืนยันชื่อหรือรหัสที่มีความเสี่ยง และแสดงข้อความที่ตีความก่อนสั่งงานจริง - ปัญหา: AI ทำรายการผิดจากคำสั่งที่กำกวม
สาเหตุ: คำสั่งเดียวอาจตีความได้หลายทาง เช่น “ยกเลิกออเดอร์ล่าสุด”
วิธีแก้: บังคับให้ระบบถามกลับเมื่อมีหลายตัวเลือก แสดงผลกระทบ และให้กดยืนยันก่อนดำเนินการ - ปัญหา: ระบบเงียบนานจนไม่แน่ใจว่าทำงานอยู่หรือไม่
สาเหตุ: การเรียก tools หรือค้นข้อมูลใช้เวลา
วิธีแก้: ใช้ preamble สั้นๆ ระบุว่ากำลังทำอะไร แล้วแสดงสถานะบนหน้าจอระหว่างรอ - ปัญหา: มีเสียงแจ้งเตือนมากเกินจนทีมปิดเสียงทั้งหมด
สาเหตุ: ไม่มีเกณฑ์จัดลำดับความสำคัญของ event
วิธีแก้: กำหนด escalation path ให้ชัด เริ่มจากสถานะบนหน้าจอ ตามด้วย notification และใช้เสียงเฉพาะกรณีฉุกเฉิน - ปัญหา: ทีมกังวลข้อมูลลูกค้าหลุดหรือสิทธิ์เข้าถึงกว้างเกินไป
สาเหตุ: นำ AI ไปเชื่อมระบบจริงก่อนกำหนดขอบเขต tools
วิธีแก้: จำกัดสิทธิ์ตามบทบาท บันทึกการทำงานของระบบ และเริ่มจากคำสั่งอ่านข้อมูลหรือสร้างร่างก่อน
Step 8: ต่อยอดจากผู้ช่วยเสียงสู่ workflow ที่ทำงานร่วมกัน
แนวคิดแรกคือสร้างผู้ช่วยฝ่ายขายที่รับเสียงเพื่อบันทึกความต้องการลูกค้า ค้นประวัติ และร่างข้อความติดตาม แต่ให้ทีมขายเป็นผู้กดส่ง ขั้นต่อไปจึงค่อยเชื่อมกับระบบสต็อกและใบเสนอราคา
แนวคิดที่สองคือผู้ช่วยหน้าร้านหรือคลังสินค้าแบบ hands-free ให้พนักงานถามตำแหน่งสินค้า เช็กจำนวนคงเหลือ หรือบันทึกงานระหว่างถือของอยู่ โดยใช้หน้าจอเป็นตัวตรวจคำตอบ
แนวคิดสุดท้ายคือระบบแจ้งเหตุเชิงรุกสำหรับผู้จัดการ เช่น สรุปเฉพาะความผิดปกติที่ควรตัดสินใจ ไม่ใช่อ่านรายงานทั้งหมดออกเสียง เป้าหมายไม่ใช่ทำให้ AI พูดเก่งที่สุด แต่ทำให้ข้อมูลสำคัญมาถึงเราในเวลาที่ควรมา
Step 9: สรุป Checklist การเริ่มใช้ Voice Agent ให้ทำงานแทนเรา
- ☐ ระบุปัญหางานจริงก่อนเลือกเทคโนโลยีเสียง
- ☐ เลือกรูปแบบให้เหมาะระหว่าง speech to speech, speech to action และ event to speech
- ☐ เริ่มจาก workflow ที่มีคำกริยาชัด เช่น ค้นหา สร้างร่าง หรือบันทึก
- ☐ แยกงานความเสี่ยงต่ำออกจากงานที่เปลี่ยนข้อมูลจริง
- ☐ ให้ AI แสดงผลบนหน้าจอ ไม่จำเป็นต้องพูดตอบทุกครั้ง
- ☐ ตั้งจุดยืนยันก่อนการเงิน การยกเลิก หรือการส่งข้อมูลสำคัญ
- ☐ ใช้ preamble เมื่อระบบต้องใช้เวลาคิดหรือเรียก tools
- ☐ จำกัดเสียงแจ้งเตือนให้เหลือเฉพาะเหตุการณ์ที่ต้องสนใจทันที
- ☐ ออกแบบให้มีทั้งเสียง ข้อความ และหน้าจอเพื่อรองรับ Accessibility
- ☐ เก็บข้อผิดพลาดจากการใช้งานจริง แล้วปรับคำศัพท์ prompt และกติกาการยืนยัน
Voice Agent ที่มีคุณค่าไม่ใช่ระบบที่พูดได้เหมือนคนที่สุด แต่คือระบบที่รู้ว่าเมื่อไรควรฟัง เมื่อไรควรลงมือทำ และเมื่อไรควรเงียบแล้วให้หน้าจอพิสูจน์ผลลัพธ์ การเริ่มจากงานเล็กที่ตรวจสอบได้ จะทำให้เราใช้ AI ลดภาระงานได้จริงโดยไม่เพิ่มความเสี่ยงเกินจำเป็น
แหล่งที่มา: Voice Agents Can Just Do Things — Charlie Guo, OpenAI · บทความต้นทาง