บทความย้อนหลังจาก VideoToBlog วันที่ 2026-03-20 สรุปข่าวและตัวอย่างทดสอบตามคลิปต้นทาง ไม่ใช่การยืนยันวันอัปโหลดวิดีโอหรือสถานะบริการปัจจุบัน การเปรียบเทียบภาพและตัวเลขประสิทธิภาพเป็นผลที่ผู้เล่าหรือผู้ให้บริการรายงาน ไม่ใช่การทดสอบอิสระของเรา ราคา โปรโมชัน การเปิดใช้ตามประเทศ แพ็กเกจ และขนาดบริบทอาจเปลี่ยนแปลง ภาพที่ 2 เป็นโฆษณา VPS ในต้นทาง เงื่อนไขคืนเงินเป็นข้อความในช่วงนั้น การแยกเอเจนต์ไป VPS ไม่รับประกันความปลอดภัยหรือความเป็นส่วนตัว ต้องจำกัดสิทธิ์และทบทวนผู้ให้บริการ/โมเดลที่รับข้อมูล ตัวอย่าง Stitch–AI Studio ยังคงมี design.md ที่ไม่รองรับและส่วน backend/dark mode ที่ไม่เสร็จตามที่บทความระบุ สำหรับตัวเลขยอดขาย NVIDIA ถึงปี 2027 และคำอธิบายเรื่องออเดอร์ ให้ถือเป็นรายงานคำกล่าวและการคาดการณ์ในคลิป ไม่ใช่รายได้ที่เกิดขึ้นแล้วหรือรายการสัญญาที่เราได้ตรวจสอบ · วิดีโอต้นทาง
สัปดาห์นี้มีประกาศจากหลายค่ายที่สะท้อนทิศทางของ AI แบบชัดเจน ทั้งด้านการสร้างภาพ การทำงานแบบเอเจนต์ การออกแบบและโค้ดที่รวดเร็วขึ้น รวมถึงสัญญาณทางธุรกิจจาก NVIDIA ผ่านงาน GTC ที่ดูเหมือนจะย้ำว่าโครงสร้างพื้นฐานสำหรับ AI กำลังขยายตัวอย่างต่อเนื่อง
บทความนี้สรุปประเด็นสำคัญแบบเป็นระบบ โดยคัด “สัญญาณ” ที่มีผลต่อการใช้งานจริงและแนวโน้มในตลาด พร้อมตัวอย่างการทดสอบที่สะท้อนข้อดีข้อจำกัดของแต่ละแพลตฟอร์ม
1) Midjourney V8: แม่นยำขึ้นเรื่องคำสั่ง แต่ความคมของข้อความยังเป็นจุดท้าทาย
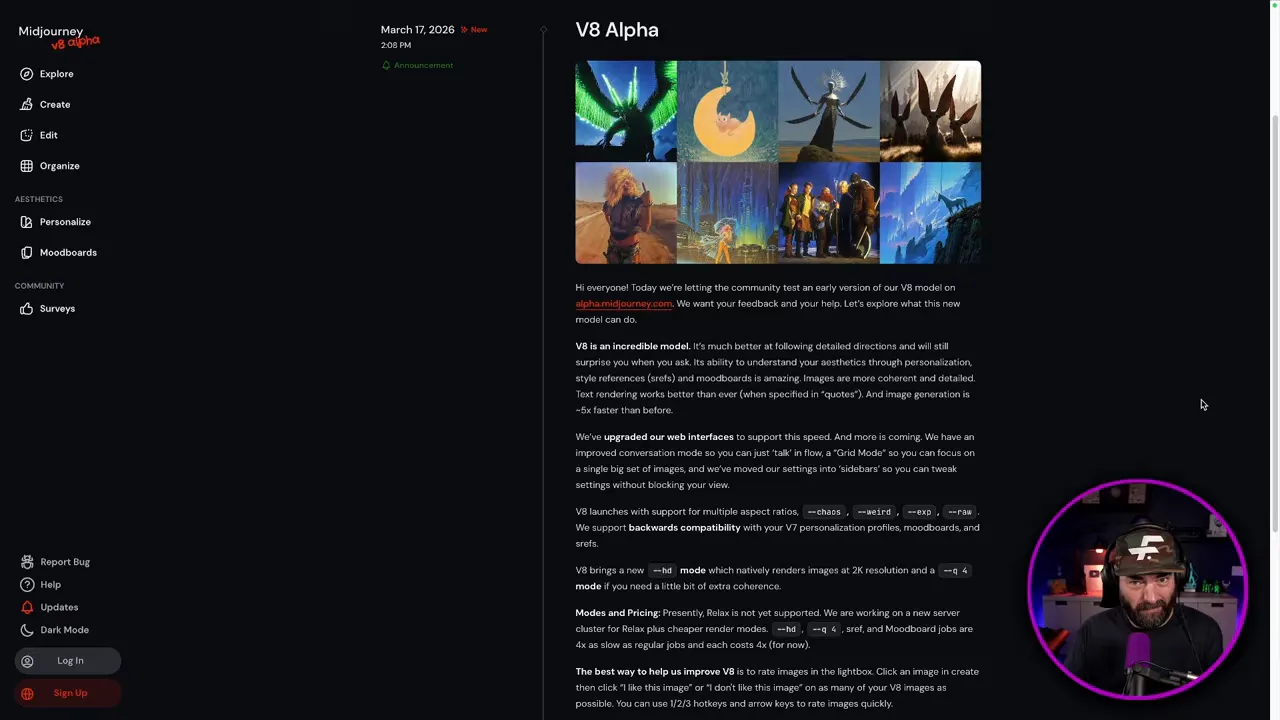
Midjourney ปล่อยเวอร์ชันที่ 8 ซึ่งทีมงานให้ความสำคัญกับการทำให้โมเดล “ทำตามคำสั่งละเอียด” ได้ดีขึ้น รวมถึงการปรับให้สอดคล้องกับรสนิยมผ่านการทำ personalization และ style references
จุดที่ถูกกล่าวถึงในประกาศ ได้แก่
- ตามคำสั่งได้ดีขึ้น: โดยเฉพาะ prompt ที่มีรายละเอียดเยอะ
- ภาพมีความสอดคล้องและรายละเอียดมากขึ้น: โครงสร้างภาพโดยรวมดูเป็นระเบียบขึ้น
- ข้อความ (text rendering) ดีขึ้น: แต่การใช้งานจริงยังมีข้อจำกัดอยู่
- โหมด HD: เรนเดอร์ภาพระดับประมาณ 2K และน่าจะเน้นงานสายสร้างสรรค์มากกว่างานสไตล์สมจริงแบบภาพถ่าย
- ปรับหน้าเว็บและพารามิเตอร์เดิม: ยังสามารถใช้พารามิเตอร์อย่าง chaos และ raw ได้ในระดับหนึ่ง
อย่างไรก็ตาม ผลตอบรับเชิงชุมชนไม่ได้ “เป็นบวกแบบเต็มร้อย” บางการเปรียบเทียบชี้ว่า V8 ยังมีปัญหาเช่นสัดส่วนมือ (เช่นจำนวนนิ้ว) และความผิดพลาดเชิงโครงสร้างเมื่อดูใกล้ ๆ
ทดสอบเพื่อดู 3 เรื่อง: ตามคำสั่ง, งานมือ, และงานตัวอักษร
แนวคิดการทดสอบที่สำคัญคือดูว่าโมเดลทำ “ตาม prompt” มากน้อยแค่ไหน
- Instruction following: แม้จะตอบสนองได้ดีในหลายภาพ แต่ยังพบเคสที่ “ออกมาแย่กว่าที่คาด” จนดูเหมือนระดับเก่ากว่า
- Text generation: คำที่ต้องการให้ขึ้นในภาพยังมีความพร่าและรายละเอียดตัวอักษรที่ “มั่ว” เช่น ถูกทำให้เบลอทั้งก้อน หรือจัดรูปทรงไม่ถูกต้อง
- ความชอบเชิงจินตนาการ: เมื่อให้ prompt ที่แปลกมาก เช่น “ช้างแก้วโปร่งใสเดินผ่านทะเลทรายที่เป็นหนังสือ” พร้อมรายละเอียดโลกเหนือจริง แต่ยังต้องมีแสงเงาที่สมจริง โมเดลกลับทำได้ดีในเชิงองค์ประกอบและความลื่นไหลของภาพรวม
ข้อสรุปเชิงแนวโน้ม: Midjourney V8 อาจดีขึ้นเรื่อง “การทำตามคำสั่งและความสอดคล้องของภาพ” แต่ถ้าต้องการความแม่นยำระดับงานออกแบบที่ต้องพึ่ง ตัวอักษรชัด หรือ รายละเอียดมือ แบบเป๊ะ ๆ ยังไม่ใช่ทางที่ดีที่สุดเมื่อเทียบกับโมเดลที่โฟกัสความสมจริงและข้อความโดยเฉพาะ
2) Microsoft MAI-Image 2: โฟกัสภาพสมจริงและข้อความในภาพทำได้ดีขึ้น
Microsoft เปิดตัว MAI Image 2 โดยวางตำแหน่งชัดเจนว่าเน้นภาพสมจริง (photo realism) สำหรับงานสร้างสรรค์ที่ต้องการแสงธรรมชาติ โทนผิวที่ถูกต้อง และฉากที่ดูเหมือนอยู่ในโลกจริง
สิ่งที่ประกาศและผลทดสอบที่สอดคล้องกัน ได้แก่
- ความสมจริงด้านแสงและน้ำ: เช่นการหักเหของแสงบนผิวหรือในน้ำ
- ไมโครดีเทล: มีรายละเอียดที่ดูเล็กแต่เห็นภาพรวมแล้ว “ไม่หลุด”
- ตามคำสั่งด้านองค์ประกอบได้: ภาพสามารถเก็บรายละเอียดตาม prompt ได้ดี
- Text ในภาพ: มีตัวอย่างแนว “ป้ายเมนูร้านกาแฟ” ที่ดูเหมือนทำได้ตามรายการค่อนข้างครบ
ตัวอย่าง prompt ที่สะท้อนจุดแข็ง
หนึ่งในเคสคือภาพผู้หญิงในป่าฝนช่วง golden hour โดยหน้าอยู่ในน้ำตื้นและแสงสะท้อนเป็นแพทเทิร์นแบบปริซึม รวมถึงแมลงเล็ก ๆ บินอยู่ด้านบน รวมถึงเส้นผมที่เปียกแนบใบหน้า จากนั้นตามด้วยเคสข้อความบนป้ายร้านกาแฟที่มีราคาหลายบรรทัดและบรรทัดท้ายอย่าง “Wi-Fi password stay curious”
เมื่อเทียบกับ Midjourney ในเชิงประสบการณ์จากการทดสอบเดียวกัน MAI Image 2 ดูจะ “ไปทางงานใช้ได้จริง” มากกว่า โดยเฉพาะหากต้องใส่ข้อความในภาพหรือใช้เพื่อทำงานที่ต้องการความตรงตาม prompt
3) เอเจนต์บน VPS: ทำให้ระบบทำงานต่อเนื่องโดยไม่กินเครื่องหลัก
นอกจากโมเดลภาพและโมเดลภาษา เรื่องที่หลายคนให้ความสำคัญคือ การทำงานของ AI agents แบบตลอดเวลา ไม่ใช่แค่ตอบแชทแล้วจบ
แนวทางที่ถูกย้ำคือการนำ agents ไปฝากรันบน VPS แทนการรันบนเครื่องส่วนตัว เพื่อให้ทำงาน 24/7 และลดความเสี่ยงเรื่องความปลอดภัยของไฟล์เอกสารภายใน
ตัวอย่างที่ถูกพูดถึงคือการใช้โฮสต์ที่มีโครงสร้างพร้อมใช้งานสำหรับรัน OpenClaw agents ผ่าน Docker template การตั้งค่า environment variables และการผูกการทำงานกับ WhatsApp ด้วย QR code เพื่อให้เอเจนต์เริ่มใช้งานได้หลัง deploy
แก่นสำคัญของประเด็นนี้คือ ถ้าเอเจนต์ต้องทำงานเบื้องหลัง (เช่นเรียกเครื่องมือ อ่านข้อมูล เรียนรู้ ทำงานตามตาราง) การแยกมันออกจากเครื่องส่วนตัวช่วยให้ทั้ง ความสะดวก และ ความปลอดภัย ดีขึ้น
4) Google Stitch: “Vibe designing” ด้วย AI-native design canvas และ design.md
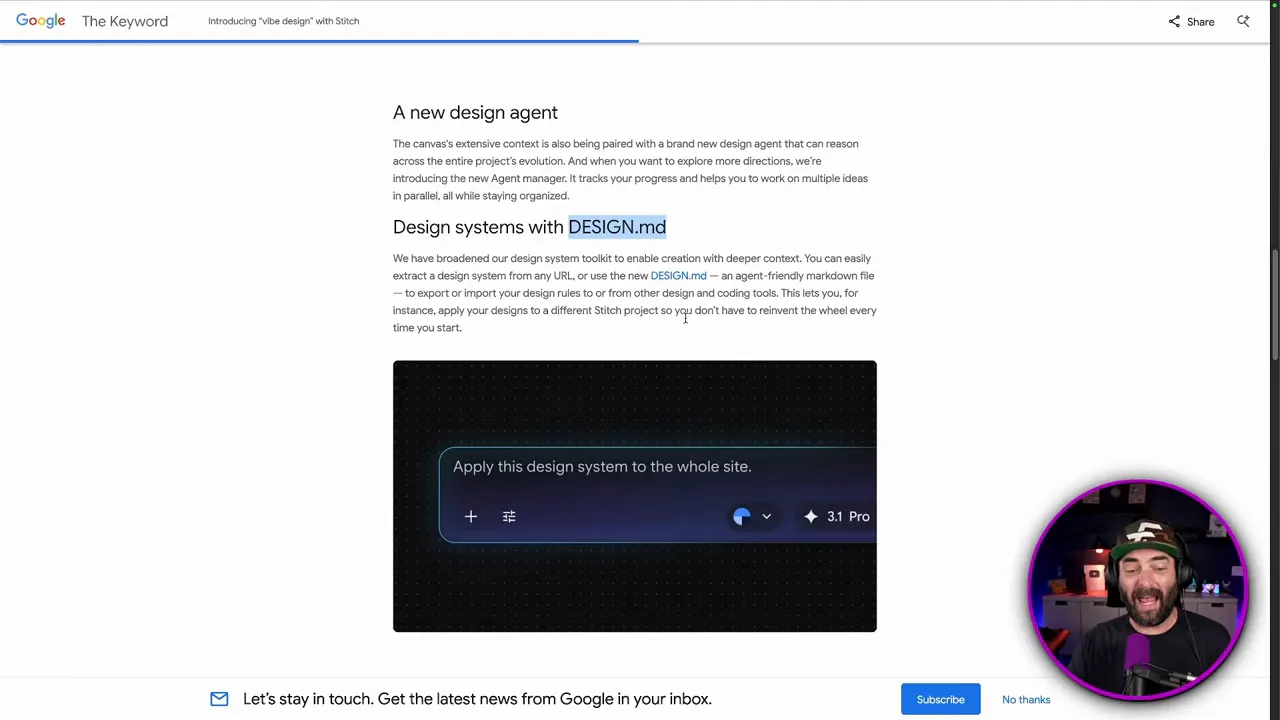
Google เปิดฟีเจอร์ในผลิตภัณฑ์ Stitch ที่เรียกแนวคิดแบบ “vibe designing” โดยนำเสนอ canvas สำหรับออกแบบที่เป็น AI-native และมีลักษณะคล้าย Figma ในเชิงอินเทอร์เฟซแบบ infinite canvas
จุดเด่นที่ทำให้เครื่องมือนี้ต่างจากการออกแบบแบบ prompt ทั่วไป คือมีแนวคิดเรื่องการ “รักษา design system” และสื่อสารกับเอเจนต์การออกแบบผ่านไฟล์
Components สำคัญ
- AI native design canvas: จากไอเดียเริ่มต้นไปถึงต้นแบบที่ใช้งานได้
- design MD: ไฟล์ markdown สำหรับถอด/ส่งออก design system จาก URL หรือใช้เพื่อแลกเปลี่ยนกฎการออกแบบกับเครื่องมืออื่น
- voice capabilities: พูดคุยกับ canvas เพื่อขอการปรับแบบทันที เช่น “ทำเมนู 3 แบบ” หรือ “แสดงหน้าจอเดียวกันในชุดสีต่างกัน”
- โครงสร้างรองรับแนว agent workflow: แนวคิดใช้ MCPs, skills และ markdown เพื่อให้เอเจนต์เข้ามาทำงานออกแบบได้เป็นลำดับ
ทดลองกับการออกแบบหน้าเว็บสำหรับคัดกรอง AI tools
ตัวอย่างการใช้งานที่ยกมาคือการให้ Stitch ออกแบบเว็บเพื่อช่วย curate และ filter เครื่องมือ AI คล้ายกับ futuretools.io โดยมีการเลือก model สำหรับการออกแบบและให้ระบบสร้างทั้งโทนสีและเลย์เอาต์ แล้วให้ผู้ใช้อนุมัติชุดสี ก่อนใช้งานต่อ
ผลที่น่าสนใจคือ Stitch สร้างได้หลาย variation ทั้งที่เป็น “เพียง color scheme” และ “เปลี่ยนดีไซน์ทั้งหน้า” ทำให้การทดลองไอเดียรวดเร็วขึ้นอย่างชัดเจน
5) Google AI Studio: Full-stack “vibe coding” ที่เอา design ไปต่อยอดเป็นโค้ดได้
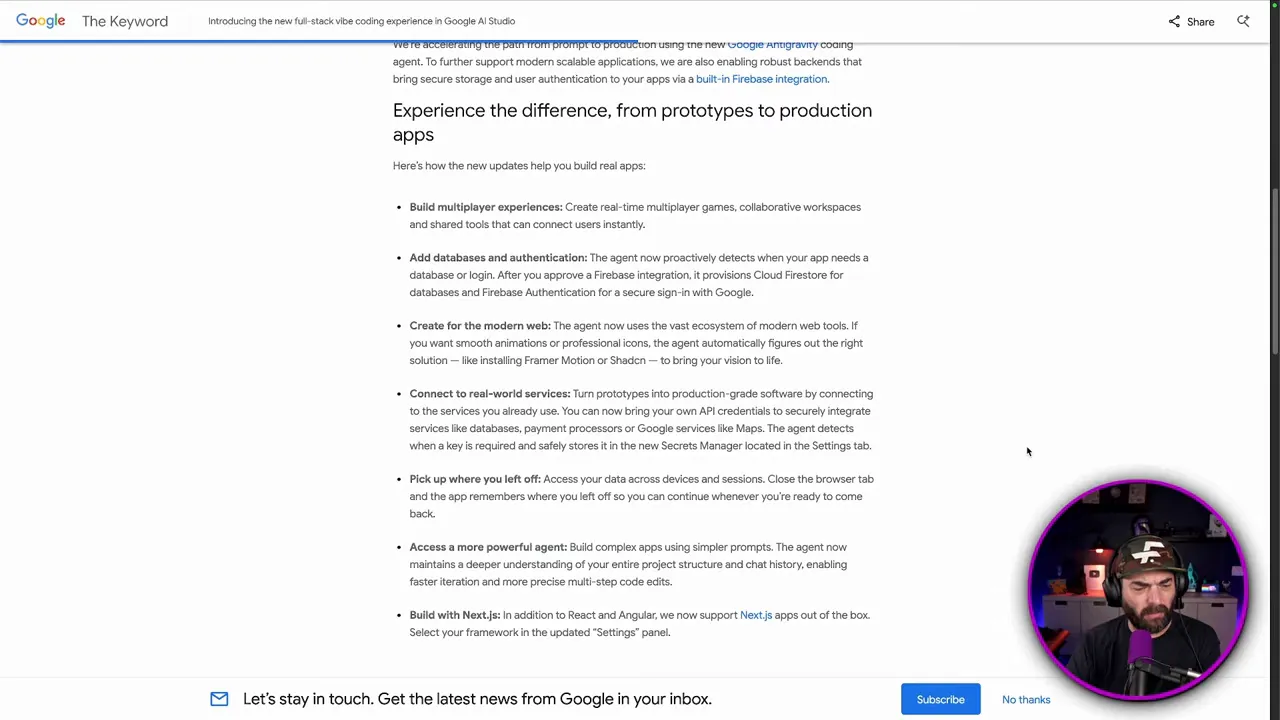
หลังประกาศ Stitch แนว vibe designing Google ต่อด้วยอีกฟีเจอร์ใน Google AI Studio สำหรับการทำ full-stack vibe coding กล่าวคือให้ Gemini สร้างโค้ดจากคำอธิบายและชุดไฟล์ออกแบบ
แนวคิดสำคัญคือการเชื่อมจาก “ดีไซน์” ไปสู่ “โค้ด” ในวงจรเดียวกัน
สิ่งที่ทำได้จริงจากการทดสอบ
- ดาวน์โหลดไฟล์จาก Stitch เช่น code.html, design.md, และ screen.png
- อัปโหลดไฟล์เข้าสู่ AI Studio แล้วขอให้ระบบ “build a functional version” ของเว็บ
- แม้จะมีประเด็นว่า design.md ระบุว่า unsupported แต่การสร้างยังคงเกิดขึ้นจากการใช้ไฟล์อื่น
- ได้หน้าเว็บที่มีแอนิเมชัน, hover effects และฟังก์ชันการกรอง (filters) จาก prompt
อย่างไรก็ตาม ยังมีข้อจำกัด เช่น dark mode ไม่ได้ถูกทำให้เสร็จ, การทำงานบางส่วนยังต้อง fleshing out เพิ่ม และปุ่ม submit หรือบางเมนูยังไม่เชื่อม backend
แม้ผลจะไม่สมบูรณ์ 100% แต่ภาพรวมสะท้อนวงจรการทำงานที่เร็วขึ้น: Stitch จัดการดีไซน์ให้เหมาะสม จากนั้น AI Studio เขียนโค้ดเป็นต้นแบบที่ “เริ่มใช้งานได้จริง” แล้วนำไปแก้ต่อจนสมบูรณ์
6) Personal Intelligence ขยายในบริการของ Google: เชื่อม Gmail, Photos, ปฏิทินเข้ากับ Gemini
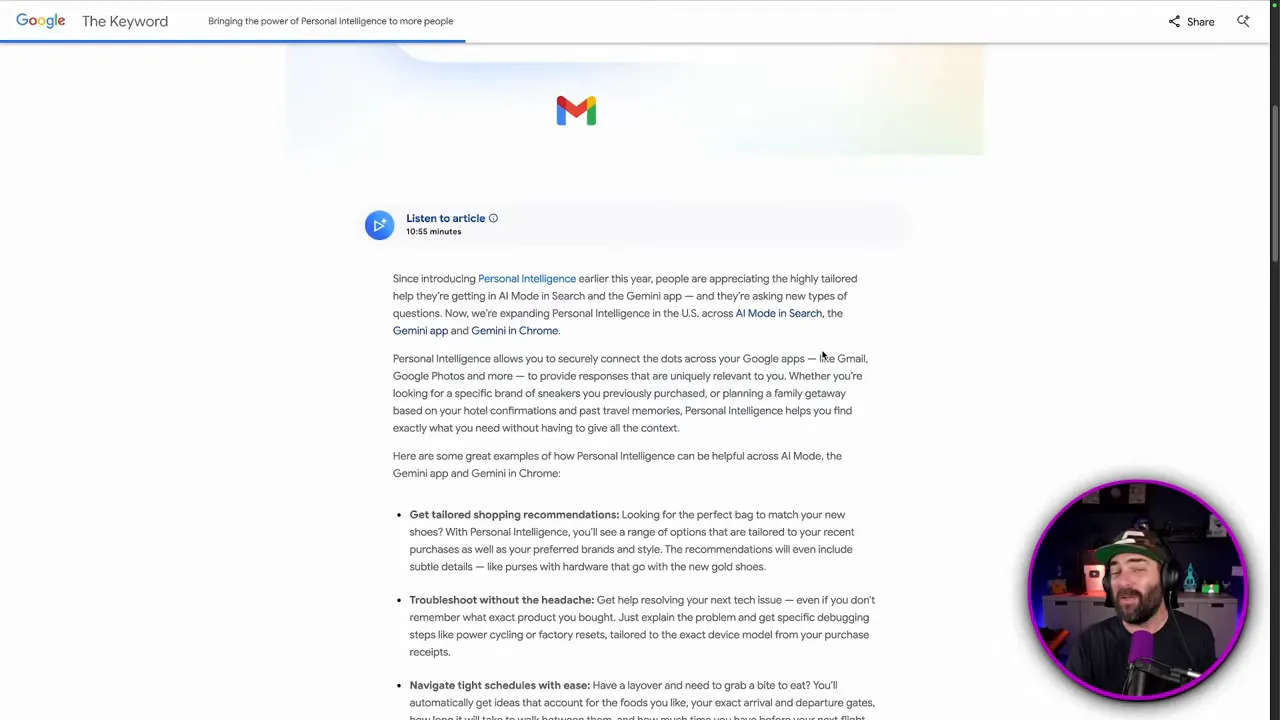
อีกประเด็นสำคัญจาก Google คือการขยายการเข้าถึง Personal Intelligence ทำให้การแชทกับ Gemini สามารถอ้างอิงข้อมูลในระบบ Google ของผู้ใช้ เช่น Gmail, Google Photos และปฏิทิน
เดิม Personal Intelligence อาจจำกัดอยู่ในบางแผนที่เสียค่าใช้จ่าย แต่มีการขยายให้ใช้ได้มากขึ้น โดยเริ่มจาก US สำหรับ AI mode ใน Search และเริ่ม roll out ในแอป Gemini และ Gemini ใน Chrome สำหรับ free tier
ผลกระทบเชิงการใช้งานคือผู้ใช้จะได้คำตอบที่ “เฉพาะบุคคล” มากขึ้น และเอื้อให้เกิดรูปแบบการช่วยงานที่นำบริบทจริงของชีวิตประจำวันมาใช้
7) NVIDIA GTC: NemoClaw, DLSS 5, แผน GPU สู่การใช้งานในอวกาศ และเป้ารายได้ GPU ขนาดใหญ่
ช่วงที่คนให้ความสนใจมากที่สุดคือ NVIDIA GTC เพราะเป็นงานที่สะท้อนทั้งเทคโนโลยีและทิศทางธุรกิจอย่างเป็นรูปธรรม
7.1 NemoClaw: จับ OpenClaw มาทำให้ติดตั้งง่ายขึ้นพร้อมชั้นความปลอดภัย
NVIDIA เปิดตัว NemoClaw ซึ่งเป็นเหมือนชุดเสริมสำหรับ OpenClaw ที่เพิ่ม:
- ชั้นความปลอดภัยและความเป็นส่วนตัว เพื่อลดความกังวลเรื่อง secure always-on AI assistance
- ความสามารถเชิง NVIDIA: รองรับการติดตั้ง Nemotron models จาก NVIDIA
- ติดตั้งง่าย: ใช้คำสั่ง terminal ไม่กี่ขั้น พร้อมชุด optimizations
ประเด็นที่น่าสนใจคือการวางตำแหน่งสำหรับทั้งรันบน cloud และ on-premises โดยรองรับอุปกรณ์อย่าง RTX PCs และแพลตฟอร์มตระกูล DGX
7.2 DLSS 5: เส้นแบ่งระหว่าง “อัปสเกล” และ “การควบคุมโดยเกมผู้พัฒนา”
NVIDIA ประกาศ DLSS 5 สำหรับนักพัฒนาเกม เพื่อช่วยเพิ่มคุณภาพภาพด้วย AI โดยมีการโต้เถียงในฝั่งผู้เล่นเกมเพราะมองว่าเป็นการ “ทำเหมือนกราฟิกเดิม” มากกว่าที่ผู้พัฒนาออกแบบ
อย่างไรก็ตาม Jensen ย้ำว่ามันไม่ใช่เพียงชั้นอัปสเกลทับของเดิม แต่เป็นส่วนที่ผู้พัฒนาเกมมีสิทธิ์กำหนดระดับการใช้งานและผู้ใช้ก็สามารถปิดได้
7.3 Nvidia Space Computing: GPU สำหรับใช้งานในอวกาศ แต่ยังติดเรื่องการระบายความร้อน
NVIDIA มีแผนเรื่อง “space computing” ด้วยโมดูลเชิง data center และ GPU ที่ออกแบบให้ใช้ในอวกาศ โดยไม่ประกาศไทม์ไลน์อย่างชัดเจน
เหตุผลหลักคือความร้อนจาก GPU ในสภาพแวดล้อมสุญญากาศ ซึ่งต้องพึ่งวิศวกรรมการระบายความร้อนที่ยังเป็นความท้าทาย
7.4 คาดการณ์ GPU sales ถึง 1 ล้านล้านดอลลาร์ภายในปี 2027
หนึ่งในประกาศที่เป็นประเด็นใหญ่ที่สุดคือการคาดการณ์ยอดขาย GPU ระหว่างปีถึง 2027 ที่อาจสูงถึง $1 trillion พร้อมอธิบายว่าเป็นตัวเลขจาก purchase orders ที่บริษัทต่าง ๆ ได้ระบุว่าพร้อมซื้อแล้ว
คำถามที่พบบ่อยใน Q&A คือที่มาของตัวเลขนี้ และคำตอบย้ำว่าเป็นพื้นฐานจากออเดอร์ที่มีจริง ซึ่งบ่งชี้ว่ายังมีแรงส่งต่อในอุตสาหกรรม
8) Rapid fire: โมเดลภาษา บริการเอเจนต์ และสัญญาณตลาดแรงงาน
นอกเหนือจากภาพและเครื่องมือออกแบบ-โค้ด สัปดาห์นี้ยังมีประกาศด้านโมเดลภาษาและระบบเอเจนต์อีกหลายรายการ
8.1 OpenAI: GPT-5.4 Mini และ Nano
OpenAI เปิด GPT-5.4 รุ่นเล็กลงเพื่อให้เร็วขึ้นและถูกลง แต่สติปัญญาลดลงเล็กน้อยเมื่อเทียบรุ่นใหญ่ โดยใช้สำหรับงานที่เน้นความคุ้มค่าและการใช้งานในระบบเอเจนต์ที่กิน token มาก
8.2 Anthropic: context window 1 ล้าน token
Claude เพิ่มความสามารถในการรองรับข้อมูลในแชทขนาดใหญ่ด้วย context window ระดับ 1 ล้าน token ซึ่งช่วยให้ผู้ใช้ยัดเนื้อหาปริมาณมากและคงบทสนทนาได้นานขึ้นโดยหมดบริบทช้าลง
8.3 Mistral Small 4 และ Cursor Composer 2: ตอบโจทย์ความคุ้มค่าในงานโค้ด
Mistral เปิดตัว Mistral Small 4 ที่เป็น open-weight และสามารถ fine-tune เองได้ ส่วน Cursor มี Composer 2 ที่ออกแบบมาเพื่อ coding โดยชูความคุ้มค่าต่อค่าใช้จ่ายในการเรียกใช้งาน
8.4 Minimax M2.7: self-evolving สำหรับเอเจนต์
Minimax เผย M2.7 ที่อ้างว่า self-evolving และทำกิจกรรมเช่น log reading, debugging, metric analysis ในสัดส่วนหนึ่งของ workflow รวมถึงการวนลูปปรับโค้ดจำนวนมาก
8.5 Mamba 3: เปลี่ยนสถาปัตยกรรมจาก transformer ไปเป็น state space model
Mamba 3 ไม่ใช้ transformer ตามแบบทั่วไป แต่ใช้ state space model ที่ทำหน้าที่สรุปด้วย “internal state snapshot” เพื่อลดต้นทุนเมื่อบทสนทนาเริ่มยาวขึ้น
8.6 Claude Co-work Dispatch และ Manus on your desktop
มีการพัฒนาฟีเจอร์แบบ “persistent conversation” และระบบที่ทำงานบนเครื่องผู้ใช้มากขึ้น เช่น Claude Co-work ที่เริ่มใกล้เคียงแนว OpenClaw-like มากขึ้น และ Manus บนเดสก์ท็อปที่สามารถรันคำสั่งและจัดการไฟล์ภายในเครื่อง
8.7 Job market visualizer และสัญญาณงานใหม่
มีเครื่องมือแสดงภาพแนวโน้มงานที่เสี่ยงจาก AI โดยบางงานที่เคยคิดว่าจะปลอดภัยอาจมีความเปลี่ยนแปลง และมีงานจำนวนมากที่ยังคงเพิ่มขึ้นมากกว่า ลดลงในภาพรวม
8.8 Uber, Rivian และ DoorDash Tasks: งานใหม่ที่เชื่อมกับข้อมูลโลกจริง
Uber ลงทุนในแผน robotaxi และ DoorDash เปิด “Tasks” ที่จ่ายให้คนทำกิจกรรมสั้น ๆ เช่น ถ่ายภาพอาหารหรือบันทึกตัวเองเพื่อช่วยให้ระบบ AI และหุ่นยนต์เข้าใจโลกจริงมากขึ้น
ประเด็นที่น่าสนใจคือการจ่ายเพื่อได้ข้อมูล (data) จาก “การกระทำในโลกจริง” ซึ่งอาจทำให้เกิดงานประเภทใหม่ และยังเป็นรากฐานสำคัญสำหรับการฝึกโมเดลที่ต้องใช้บริบทจริง
บทสรุป: เลือกเครื่องมือให้ถูกงาน และมองระบบ end-to-end
สัปดาห์นี้สะท้อนภาพใหญ่ 3 อย่าง
- ภาพ: Midjourney V8 ดีขึ้นในหลายมิติ แต่ถ้าต้องการข้อความในภาพชัดและความสมจริงสูง MAI Image 2 ดูโดดเด่นกว่าในเคสทดสอบ
- การออกแบบและโค้ด: Stitch และ Google AI Studio วาง “ลูป” ตั้งแต่ดีไซน์ไปเป็นโค้ดได้เร็วขึ้น แม้ยังต้องแต่งเพิ่มสำหรับฟีเจอร์ครบถ้วน
- เอเจนต์และโครงสร้างพื้นฐาน: ตั้งแต่การรันบน VPS ไปจนถึง NVIDIA ที่ทำให้การติดตั้งเอเจนต์ปลอดภัยขึ้น สัญญาณคือองค์กรต้องการระบบที่ใช้งานได้จริงและคุมความเสี่ยง
สำหรับคนทำงานจริง แนวคิดที่ควรยึดคือ เลือกโมเดลให้ตรงกับความต้องการหลัก เช่น “สมจริงและข้อความ” หรือ “งานจินตนาการและสไตล์” และมองระบบแบบ end-to-end ตั้งแต่ data, design, ไปถึงการรันเอเจนต์ที่ไม่หยุดทำงาน
หากบทความนี้มีประโยชน์ การอัปเดตถัดไปควรจับตา 2 เรื่องพร้อมกันคือ (1) ความแม่นยำด้านข้อความและรายละเอียดในงานภาพ และ (2) การเชื่อมเครื่องมือออกแบบกับการเขียนโค้ดที่ใช้งานได้จริงมากขึ้นแบบลดช่องว่างระหว่าง prototype และ production